Конспект лекции
БД 7.10 (целиком)
Организационные вопросы и порядок аттестации
Организационные вопросы: план занятий, экзамен и посещаемость
Отступление от темы
Лектор планирует направить план занятий до конца семестра с учетом прошедших переносов, чтобы студенты могли построить свои планы. Обсуждается вопрос о том, нужно ли заранее направлять список вопросов к экзамену или лучше сделать это ближе к концу. Лектор отмечает, что количество вопросов будет зависеть от тем, которые успеют пройти, так как материал излагается подробно, «с чувством, с толком, с расстановкой», без спешки. В итоге принято решение направить предварительный список планируемых тем, а окончательные вопросы к экзамену подготовить ближе к окончанию курса. Также лектор демонстрирует экран и делает организационные объявления о посещаемости и порядке приема экзамена. Отмечается посещаемость лекций: для получения права на полуавтомат (возможность защитить доклад или реферат и готовить один из вопросов) необходимо посетить и послушать 50% занятий и лекций. Будет вестись специальная табличка, где также фиксируется активность студентов — ответы на вопросы и интерактивная работа на лекциях, за что выставляются плюсики (от одного до трех), которые будут учитываться при приеме экзамена. При этом посещаемость не является строгим абсолютным требованием для успешной сдачи экзамена, и приоритет всегда отдается реальным знаниям студента, особенно если у него есть хороший бэкграунд в работе с базами данных и он блестяще отвечает на экзамене. В завершение организационной части лектор предлагает задать вопросы и переходит к демонстрации экрана и началу основной лекции. Видно ли демонстрацию экрана? Да, видно. Отлично, после этого начинается занятие.
Этапы создания и определение требований к базам данных
Вводная часть и тема лекции
Отступление от темы
видно. Видно? Да, видно. Отлично. Ну, давайте тогда потихоньку начнем. Лекция у нас сегодня достаточно планируется длительная. В какой-то момент, устану когда я говорить, сделаем перерыв. Небольшую паузу. И далее продолжим. Разделим, наверное, на две половинки, чтобы не рвать. У кого-то включен микрофон. И, соответственно, вот так вот замечательно провели время.
Лекция посвящена проектированию баз данных. На прошлом занятии было введение в базы данных: что это такое, откуда они появились, какая текущая ситуация на рынке баз данных, какие СУБД представлены на рынке, кто является лидером, и какие существуют популярности СУБД.
Тема проектирования баз данных является краеугольной. Если заниматься разработкой программного обеспечения по-серьезному в коммерческих организациях, становится очевидно, что никакая большая система не обходится без предварительного анализа. Без проектирования можно попытаться сделать идеальную систему или хотя бы базу данных, но в итоге допустить много ошибок и столкнуться с проблемами при дальнейшей реализации как в плане работоспособности, так и в плане проблемности реализации как таковой.
Закон систематики отражает эту мысль: сложная система, спроектированная наспех, никогда не работает, и исправить ее, чтобы заставить работать, невозможно. Не стоит быть слишком категоричными, но в результате получается плохая система, которая если и работает, то не так, как планировалось. Также высказывание исследователя в области стратегии Карла фон Клаузовица [неясный фрагмент: цитата про важность плана и стратегии]. Без должного планирования и проектирования, даже обладая какими-то мелкими успехами, результат все равно будет далеко не таким, как ожидается. Это показывает, насколько важно проектирование, и пренебрегать им точно не стоит.
Основные этапы создания базы данных
Первым этапом создания базы данных является определение требований. На этом этапе необходимо понять, что именно хотят от разрабатываемой системы и для чего она нужна, какие перед ней стоят задачи и каков её предполагаемый масштаб. Важно определить, как часто пользователи будут обращаться к базе данных, насколько производительной она должна быть, а также в каком количестве будут поступать запросы. Например, нагрузка может составлять как тысячу запросов в секунду, так и миллион, и все эти параметры напрямую влияют на дальнейшее проектирование.
После того как требования определены и зафиксировано понимание поставленных задач, следующим шагом идет выбор СУБД и описание структуры СУБД с учетом её специфики. Это достаточно важный этап, на котором легко допустить ошибку, поскольку в настоящее время существует множество систем управления базами данных, и каждая из них обладает собственными преимуществами и недостатками. Даже при идеальном описании требований и точных расчетах, неверный выбор СУБД на этом шаге может привести к достаточно печальному результату.
После успешного определения требований, их описания и правильного выбора СУБД следует этап реализации. На данном этапе возникают те же проблемы, что и при разработке обычного классического программного обеспечения.
Заключительным этапом является тестирование, разработка документации и сопровождение, включающее эксплуатацию того, что было спроектировано и реализовано. Всего при создании баз данных можно выделить такие четыре этапа.
Определение требований и моделирование данных
Начнем мы с вопросов проектирования баз данных, рассматривая их с вопросов моделирования. Один из краеугольных камней моделирования — это определение требований. На какие же вопросы мы должны здесь ответить? Мы должны понять, какие данные мы хотим хранить и какими эти данные должны быть.
Рассуждая о том, какие именно данные мы хотим хранить, можно отметить такие типы, как числа, строки, JSON или бинарные данные, а также то, какие типы данных мы используем. Большое значение имеют постоянность и временность данных.
Предметная область будет важна для нас, потому что она скорее будет определять вид связи между данными. Вид связи будет определять организацию данных, а также влиять на другие аспекты. Например, если у нас какая-то финансовая информация либо персональные данные, здесь могут возникать такие моменты, как защита данных, безопасность данных и надежность. Кроме того, во многих странах есть законы, что данные можно хранить только на определенной территории, то есть здесь влияет и физическое расположение базы данных.
Таким образом, вид данных, которые мы храним — это все многообразие, которое будет так или иначе влиять на те архитектурные требования, которым мы будем удовлетворять при проектировании наших комплексов. В качестве аналогии можно представить ситуацию: вчера мы засыпали, и у нас на счету был миллион, а проснулись — у нас 5 миллионов. Конечно, это нас обрадует, но, наверное, ненадолго. Так или иначе, мы должны всегда, когда мы проектируем базу данных, озадачиваться этими вопросами. Вопрос о том, какие данные мы хотим хранить, действительно важен, потому что от него уже отходят различные зависимости, которые будут выражены в каких-то, скорее всего, нефункциональных требованиях, или функциональных требованиях, если мы говорим про вещи, связанные с особенностями работы с определенными данными.
Учет пользовательских запросов, сущностей и ограничений
Связанные с особенностями работы с определенными данными вопросы заключаются в том, на какие вопросы пользователей к этим данным мы должны находить ответы. Здесь имеется в виду бизнес-логика приложения, а также то, что вообще пользователи могут с этими данными сделать и как они хотят их использовать. Возможно, они хотят их как-то объединять, группировать, агрегировать — все те вещи, которые будут изучаться далее. То есть это данные не ради данных, а данные для чего-то. При этом необходимо продумать все нюансы, связанные с возможностью использования этих данных конкретными пользователями. Например, если у нас есть условные 100-500 пользователей, они должны уметь одновременно работать с этими данными, если есть такое требование. Причем эта параллельная работа не должна каким-то образом блокировать использование данных другим пользователям, то есть один пользователь не должен влиять на другого. Если же влияние все-таки происходит, необходимо продумать, каким образом и в какой последовательности пользователи будут иметь доступ к данным. Уж точно не должно происходить ситуаций, когда один пользователь изменил определенные данные, второй пользователь тоже их изменил, и в итоге записался ответ только от изменения одного пользователя. На этапе определения требований возникает очень много вопросов, и это лишь пара из них, а на самом деле их гораздо больше.
Следующее, что нужно принять во внимание — это описание информационных объектов, понятие предметной области и связи между ними. Те, кто немножко знаком с теорией баз данных или работал с ними на практике, понимают, о чем идет речь. У нас есть какая-то сущность, причем сущностью не обязательно выступает какой-то предмет или что-то вещественное, это вполне может быть какой-то процесс или что-то абстрактное, но это тоже будет сущностью. Также важны связи между ними — то, какие отношения возникают и как несколько сущностей связаны друг с другом.
Еще мы должны принимать во внимание описание ограничений целостности, то есть требования к допустимым значениям данных и связи между ними. У нас не должно быть ситуации, когда столбец может хранить только числовые значения, а туда пытаются записать какую-нибудь стрингу или использовать какие-то другие невалидные варианты. То есть ограничения целостности для нас тоже важны. Мы только начали погружаться в проектирование баз данных, а уже столько вопросов у нас возникает, на которые мы должны ответить, и это опять же всего лишь небольшой круг вопросов просто для примера, чтобы было понятно, о чем идет речь.
Пример проектирования БД: Экзаменационная сессия
В качестве примера проектирования базы данных рассмотрим совокупность таблиц, составляющих информационную систему «экзаменационная сессия». В такой базе данных необходимо хранить распределение студентов по группам, информацию о студентах, включая ФИО, номера зачеток, группы и прочие данные, а также информацию о предметах, которые студенты будут сдавать на экзамене (например, курс по базам данных или современные СУБД), ФИО преподавателя и оценку за экзамен.
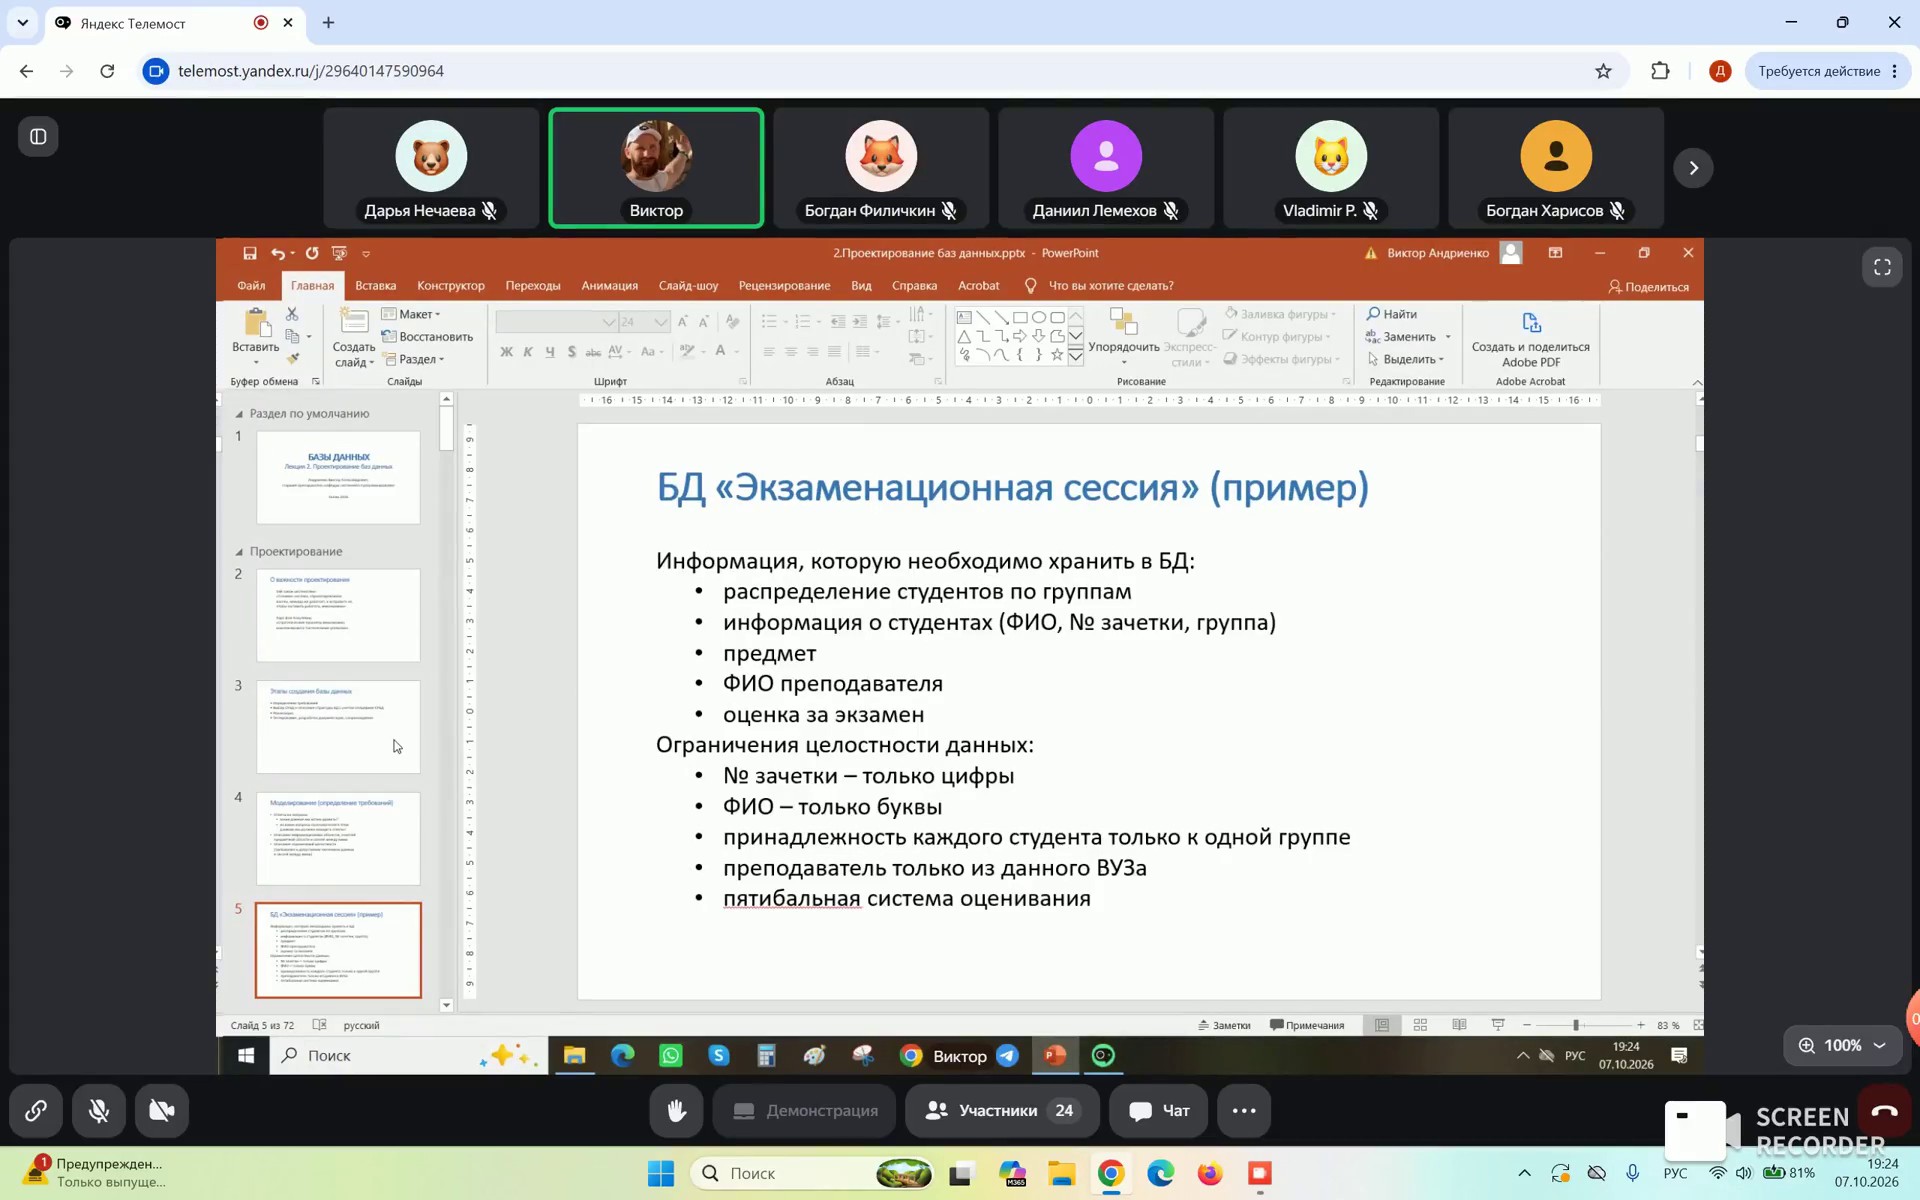
При проектировании такой базы данных возникают различные ограничения целостности данных. Например, для номера зачетки может быть задано условие использования только цифр, а для ФИО — только букв. Другим примером ограничения является правило, согласно которому каждый студент должен принадлежать только к одной группе, исключая ситуации, когда студент числится в нескольких группах одновременно. Если подобная ситуация все же допускается предметной областью, это необходимо уточнить на этапе определения требований у заказчиков или стейкхолдеров. Также можно выделить ограничения, касающиеся того, что преподаватель может быть только из данного вуза, или ограничения на систему оценивания, например, использование пятибалльной шкалы.
В процессе обсуждения возможных ограничений целостности для базы данных экзаменационной сессии можно предложить использование специальных типов данных или перечислений (enum), например, для оценок от A до F. Обсуждая уникальность студентов в группе, важно корректно формулировать требования. Если одновременно требовать уникальность по ФИО и номеру зачетки, это может оказаться избыточным. В реальной жизни возможна ситуация, когда два студента с абсолютно одинаковыми ФИО поступают в одну группу, и вероятность этого хоть и мала, но исключать ее полностью не стоит. Применение требования уникальности номера зачетки для каждого студента является вполне достаточным, так как это позволяет однозначно идентифицировать каждого отдельного студента.
При проектировании идентификации можно использовать не номер зачетки и не ФИО, а специальный уникальный идентификатор каждого студента, который присваивается независимо от номера зачетки. Однако с точки зрения практики эффективнее использовать уже существующий номер зачетки, чтобы не создавать избыточные сущности и идентификаторы. Если на начальных этапах обучения возникают вопросы или некорректно формулируются ограничения, это нормально — все пробелы постепенно устранятся на последующих лекциях и практических занятиях.
Трехуровневая архитектура баз данных
Трехуровневая архитектура проектирования баз данных
Трехуровневая архитектура баз данных рассматривается с точки зрения проектирования. Данная архитектура включает в себя инфологический, датологический и физический уровни и позволяет обеспечивать независимость хранимых данных от использующих их программ. Суть подхода заключается в том, что каждая СУБД может по-разному представлять различные модели, но на данном этапе происходит подъем на более высокий уровень абстракции с абстрагированием от конкретной реализации. Такой уровень абстракции позволяет спроектировать базы данных таким образом, чтобы они были переносимы между различными СУБД, по-разному реализующими каждую из этих моделей. Для лучшего понимания лектор приводит аналогию из реального программирования, где трехуровневую архитектуру можно отождествить с абстрактным классом или интерфейсом, который различным образом реализуется в конкретных классах.
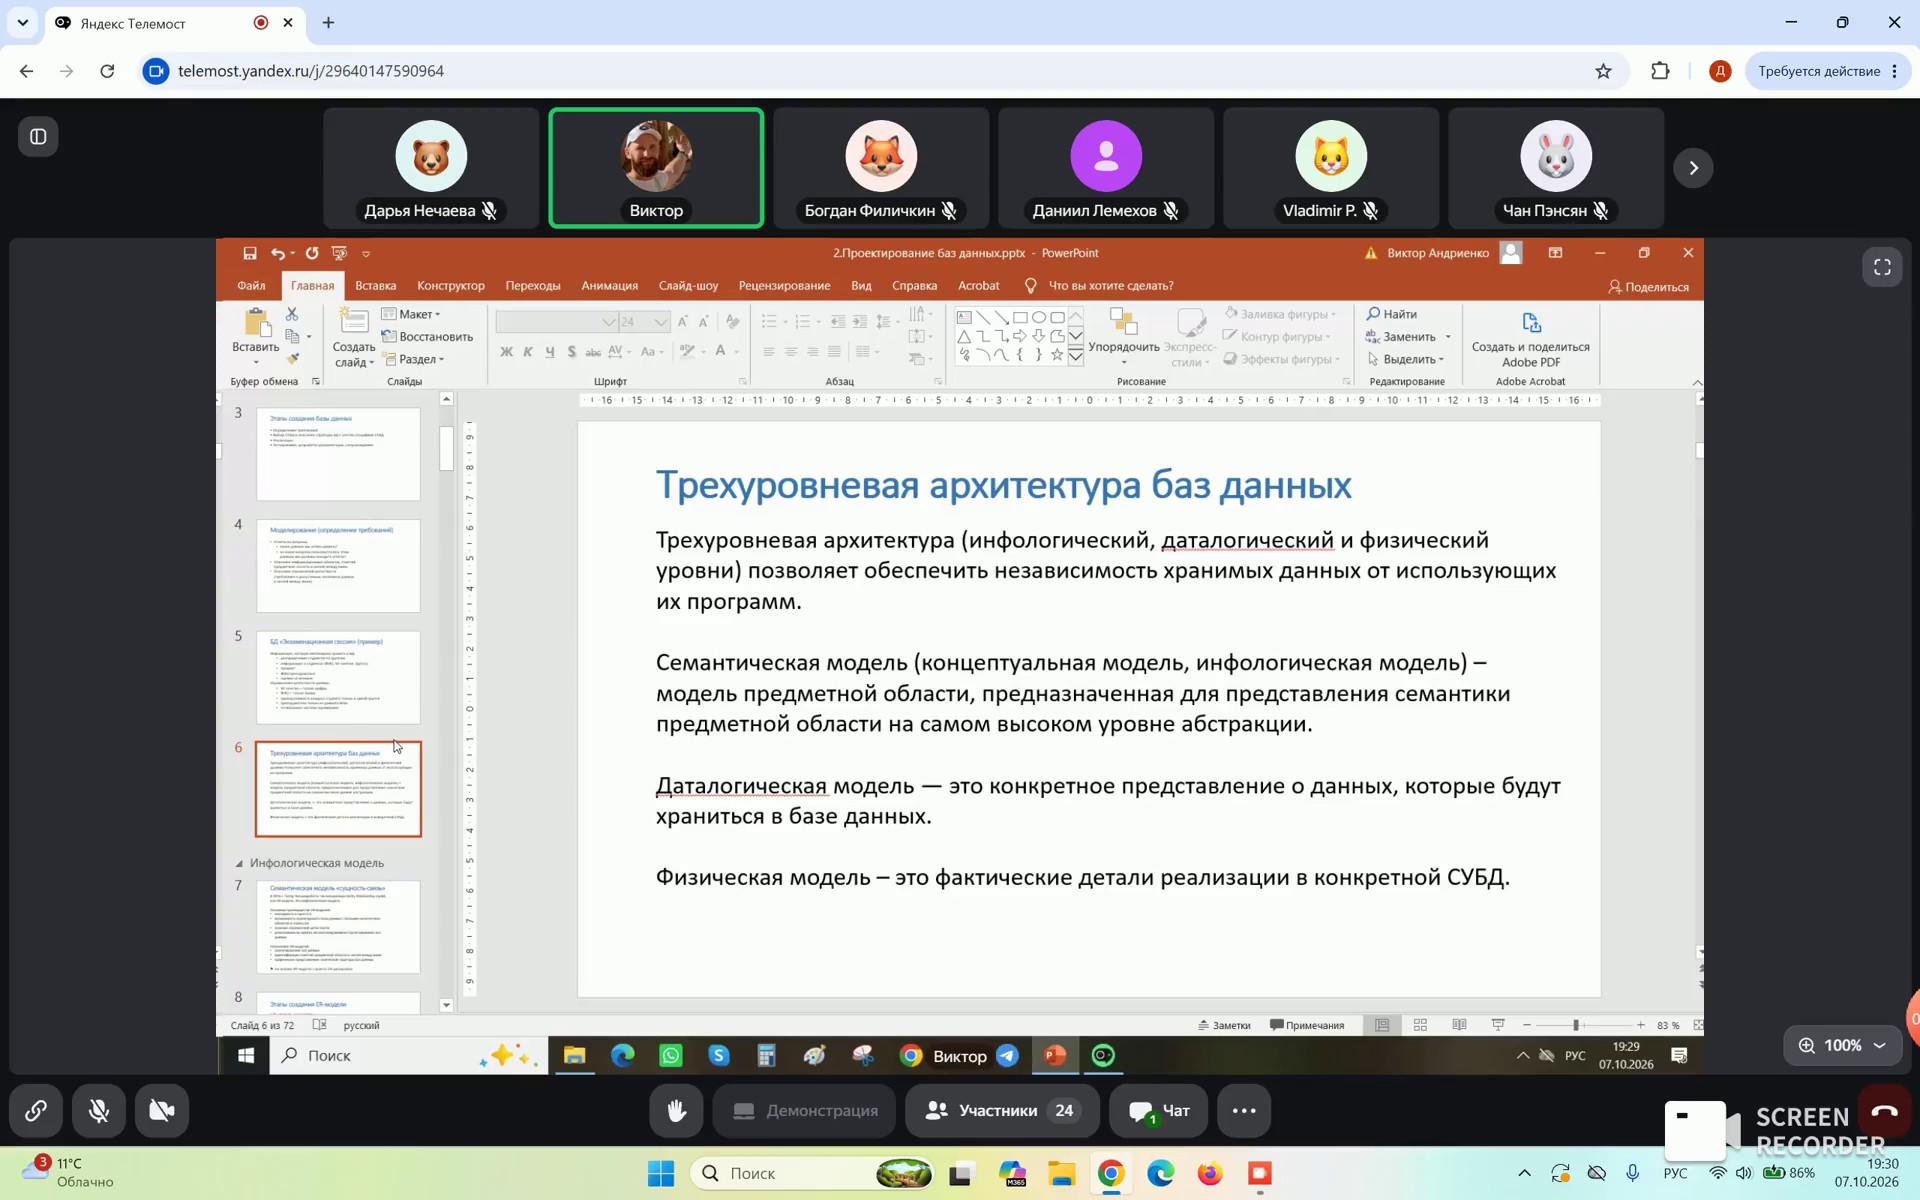
Семаническая модель, она же инфологическая модель, она же концептуальная модель. Слово «семантическая» в данном контексте означает смысловую модель, когда в неё вкладывается определенный смысл, в отличие от синтаксической модели, где интересует только синтаксис. Семантическая модель — это модель предметной области, предназначенная для представления семантики предметной области на самом высоком уровне абстракции. Иными словами, семантическая или инфологическая модель представляет собой перенос предметной области — будь то экзаменационная сессия, другие вещи из реальной жизни или абстрактные бизнес-процессы — на уровень абстрактных представлений, сущностей и связей между ними.
Датологическая модель представляет собой конкретное представление данных, которые будут храниться в базе данных, что означает спуск на уровень чуть пониже.
Когда дело доходит до физической модели, появляется осмысление того, как фактические детали реализации будут перенесены на конкретную СУБД. Таким образом, выделяются три уровня проектирования баз данных: инфологическая, датологическая и физическая модели.
Сущность ER-модели и её преимущества
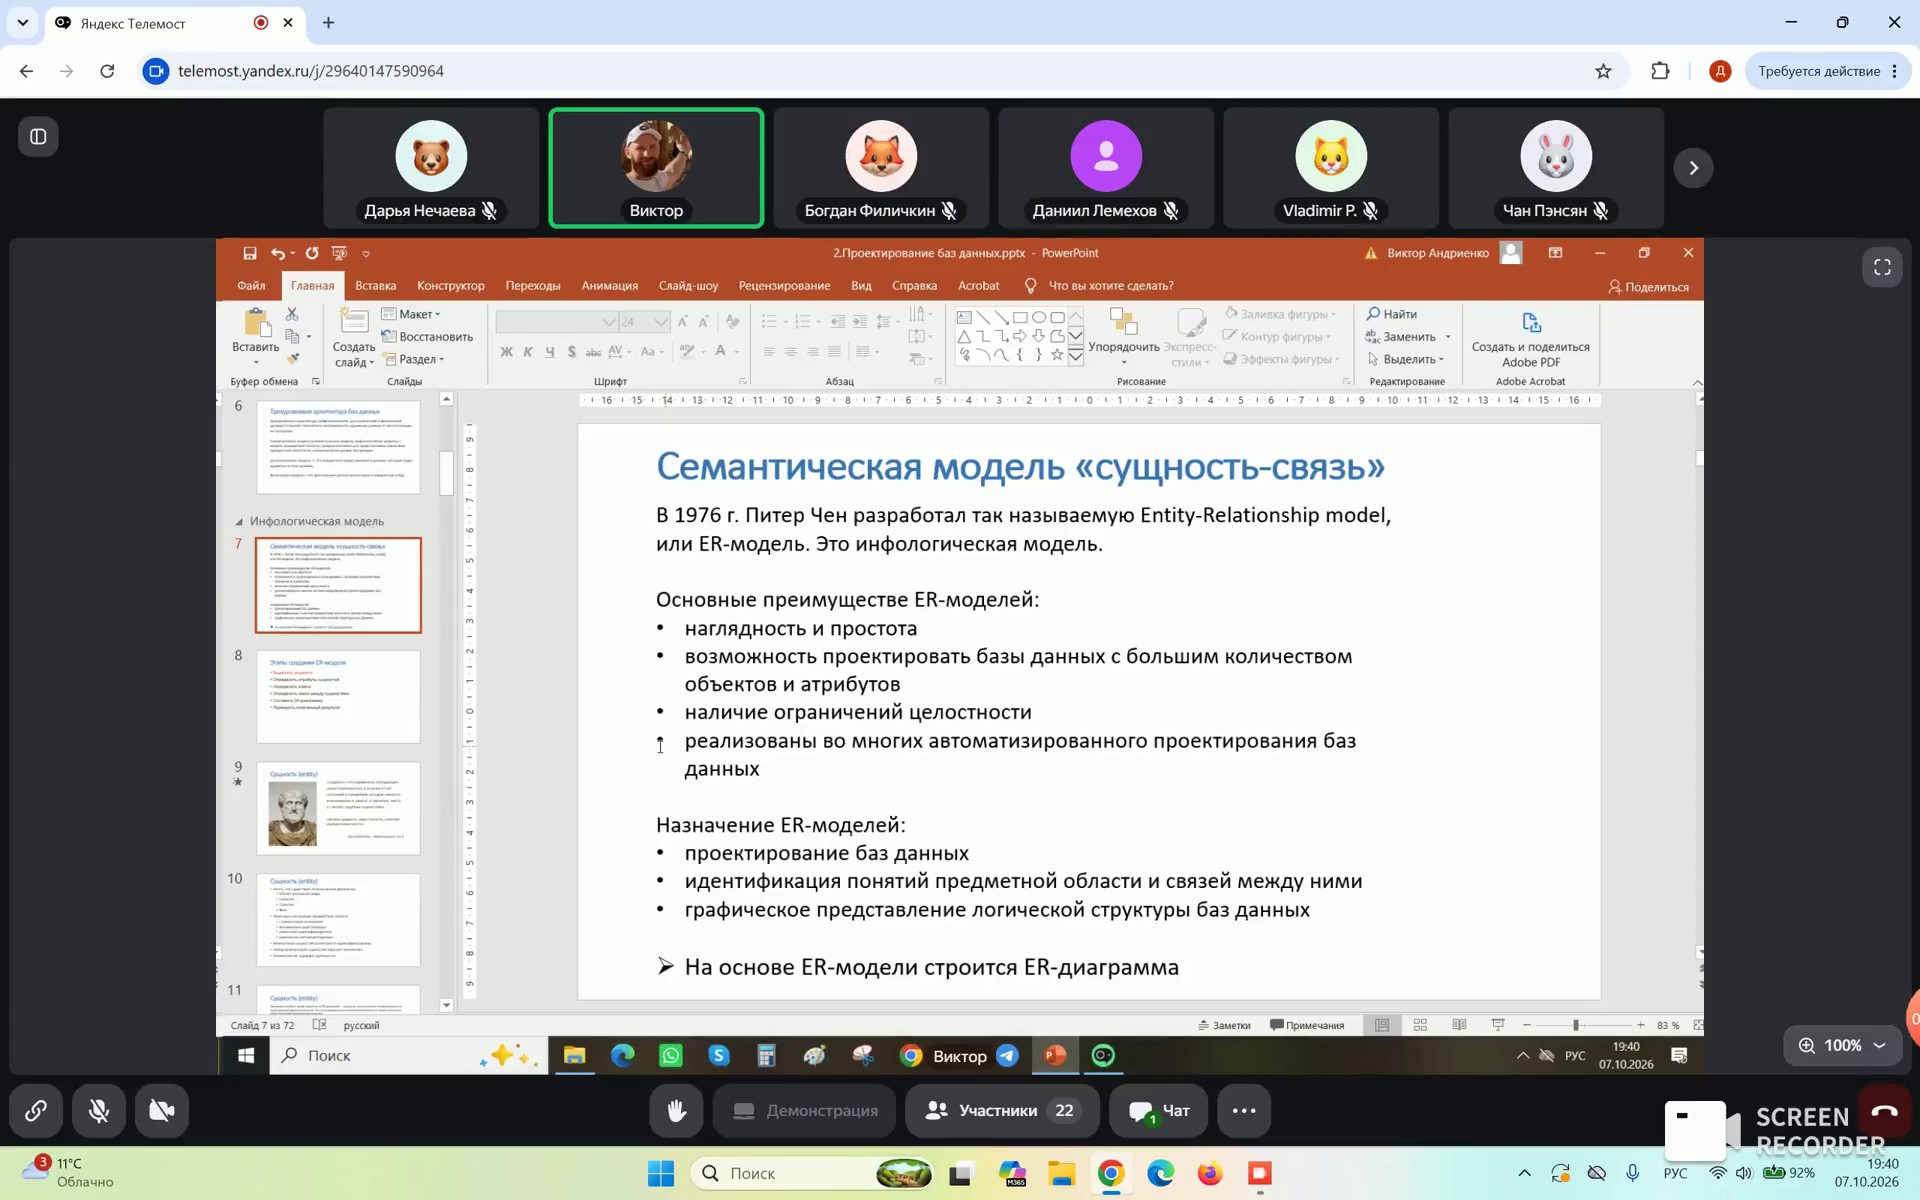
Семантическая ER-модель (модель «сущность-связь», Entity-Relationship Model) является инфологической моделью баз данных. В 1976 году Питер Чен разработал эту модель, которая сразу завоевала популярность благодаря своим замечательным свойствам, в первую очередь — наглядности и простоте. Вместо того чтобы пересказывать текстом или каким-то другим образом выражать отношения между объектами, например, связи одного человека с другим, всё это можно изобразить и наглядно представить.
Отступление от темы
Надо сказать, что 70-е годы XX века — это то время, когда все эти идеи насчет визуальных языков моделирования только появились. Даже не то чтобы появились, но были в таком не очень развитом состоянии, совсем не в том виде, в котором мы их знаем сейчас (в виде UML, например, и BPMN). То есть те идеи, которые для нас сейчас вполне естественны и не являются чем-то уникальным, в то время казались настоящими прорывами. И ER-модель, когда она появилась, тоже была чем-то вроде такого прорыва.
Среди других преимуществ ER-модели следует выделить возможность проектировать базы данных с большим количеством объектов и атрибутов, а также наличие ограничений целостности, которые можно выражать визуально. Во многих системах автоматизировано проектирование баз данных на основе таких моделей.
Основное назначение ER-моделей при проектировании баз данных заключается в идентификации понятий предметной области и связей между ними. При этом не обязательно всегда, когда строится ER-модель, речь идет непосредственно о проектировании баз данных. На самом деле в бизнес-анализе и системном анализе (по большей части в бизнес-анализе) ER-модель применяется для того, чтобы выражать понятия предметной области и связи между ними. То есть это не database-специфичный инструмент, а универсальное средство, которым пользуются и за пределами проектирования баз данных.
Еще одна возможность, которую дает использование ER-модели — это графическое представление логической структуры баз данных. Визуально-графическое представление очень помогает разобраться в том, какие в системе существуют сущности и какие между ними установлены связи. На основе ER-модели строится ER-диаграмма.
Различие ER-модели и ER-диаграммы
Отступление от темы
Прежде чем мы пойдем на следующий слайд, хотелось бы у вас спросить, а как вы понимаете отличие ER-модели от ER-диаграммы? В общем-то, оно, наверное, и так интуитивно. Давайте понятно, интуитивный вижн выразим формально. Чем отличается ER-модель от ER-диаграммы в вашем понимании? Ну, начнем, наверное, с того, что это не одно и то же. То есть есть ER-модель, а есть ER-диаграмма. В чем между ними может быть отличие? Давайте тогда я отвечу на этот вопрос, если мало ли вы стесняетесь. Опять же, я ценю всегда смелость и попытку высказать какие-то мысли. Это лучше, чем даже при ошибочном ответе. Всегда можно себя поправить, я вас поправлю. Ничего страшного в этом абсолютно нет. Поэтому, пожалуйста, отвечайте на вопросы и проявляйте активность.
ER-модель — это когда мы логически описываем предметную область в терминах сущностей, связи между ними, как они друг к другу соотносятся с атрибутами и со всеми этими вещами. Она может быть различным образом формализована, но это все-таки такое логическое описание.
Если говорить об ER-диаграмме, это больше графическое представление модели, то есть взяли модельку и как-то графически ее представили. Это делается потому, что нам так удобно обобщать, нам так удобно представлять, нам так удобно что-то объяснять другим людям, которые, может быть, нашу модельку видят первый раз.
Понятие сущности и ролей в базе данных
Всегда ли сущность будет физическим объектом? Это не всегда может быть автомобиль, вуз или студент. Сущностями могут являться, например, заказы. Заказ можно рассматривать как событие. Кроме того, если у вас есть синхронное взаимодействие между сервисами и реализован outbox паттерн, то сами события будут тоже складываться в базу данных. Мы можем придумать какие угодно уровни абстракции и записывать их в БД. Процесс регистрации, аутентификации, авторизации — всё это тоже можно отнести к сущностям. Таким образом, сущностью может быть что угодно, и не всегда это физический объект в чистом виде.
Может ли человек являться сущностью в базе данных? Сам по себе человек нет, он должен быть как-то дополнительно помечен, то есть должны быть определенные параметры. Примерами таких параметров являются ученик, учитель или работник.
Обычно при проектировании баз данных мы говорим о том, что сущностью становится не сам человек как отдельно взятый индивид, а роль, которую он в данной системе играет, то есть какую роль мы для него определяем. Например, существуют роли пользователя и суперпользователя. Или роль, которая может только читать информацию и не может ее изменять (с ограничением read-only). Это тоже пользователь, у которого есть определенные права, но мы разграничиваем этих пользователей по ролям.
После того как с этим разобрались, можно переходить к последовательным этапам создания ER-моделей, и первое, что нужно сделать — выделить сущности.
Сущности, атрибуты и ключи в ER-модели
Определение сущностей и взгляды на них
Последовательное рассмотрение этапов создания ER-моделей начинается с выделения сущностей. Для того чтобы выделить сущность, необходимо понять, что она собой представляет. Понятие сущности витает в воздухе, и ранее уже обсуждалось, что это такое. Существует определение Аристотеля, согласно которому сущность — это единичная, обладающая самостоятельностью вещь, в отличие от её состояний и отношений. Уже тогда Аристотель говорил про состояния и отношения, которые являются изменчивыми, зависят от времени, места и от связи с другими сущностями. Кроме того, всякая сущность, надо полагать, означает определенное нечто — как хочет, говорит Аристотель, так это и понимайте.
Если даже интуитивно или через определение непонятно, что такое сущность, то в процессе практической деятельности и проектирования — будь то баз данных или просто какая-то информационная система без учета баз данных — вы в скором времени набьете руку для того, чтобы правильно определять сущности. При этом нужно отличать сущности от атрибутов, так как одной из ошибок является обозначение какого-нибудь атрибута в качестве сущности. Это дело наживное, оно появляется с опытом и практикой, а пока нужно хотя бы разобраться в терминах.
Существуют различные взгляды на то, что такое сущность. Это нечто, что существует логически или физически, то есть либо какой-то физический предмет, либо какая-то абстракция. Сущность может быть объектом реального мира (например, событие вроде экзамена в университете, заказ в интернет-магазине, перелет из точки А в точку Б и так далее).
Кроме того, сущность может быть каким-то понятием. Например, сущность как понятие — это должность в какой-нибудь HR-ской системе, учебная дисциплина или валюта в банковском приложении. Это так, потому что относительно этого понятия формулируется какое-то выражение, определяющее, что именно для нас является, например, валютой в данном контексте. Существуют многозначные термины и понятия, и в каждой системе они могут означать разные вещи.
Лектор предлагает привести примеры таких многозначных понятий, где в одной системе это одно, а в другой — другое. Студент предлагает пример с работниками в системе HR и проходной на заводе. Лектор уточняет, что на проходной это могут быть сотрудники или потенциальные кандидаты, что является близкими понятиями. Затем лектор приводит собственный пример с дашбордом: где-то это может означать конкретный отчет, а где-то — простую визуализацию данных, и в разных системах это могут быть абсолютно разные вещи. На первый мы смотрим, когда нам готовят или предоставляют отчет, а второй используем, когда просто хотим посмотреть информацию. Конечно, таких примеров можно привести еще, если подумать. Самое важное при работе с сущностями и понятиями — очень четко определиться с тем, что они значат в контексте конкретной системы.
Интерпретация сущностей и зависимые сущности
При работе с какими-то сущностями и понятиями очень важно определиться, что они на самом деле означают. Это реальные живые примеры, потому что заказчик может подразумевать под понятием что-то одно, и для него это будет вполне естественная вещь, а для каких-нибудь айтишников-исполнителей это может означать совершенно другое, то, к чему они привыкли. Здесь мы немного уходим в Domain-Driven Design (предметно-ориентированное проектирование), но оно на самом деле очень сильно пересекается, когда мы говорим про проектирование современных информационных систем и проектирование баз данных.
Что еще может быть взято в качестве сущности? Например, это может быть факт какой-то. Какая сущность у факта? Например, оценка за экзамен, запись на курс или являетесь вы участником проекта или не являетесь, и так далее.
Идем дальше. Некоторая абстракция предметной области. Мы сейчас проговорили про нечто, что существует логически или физически, а теперь говорим о том, что это может быть некоторая абстракция предметной области с уникальным названием. Опять же, помним о том, что это уникальное название может означать какие-то разные сущности: независимо существующую, уникально идентифицируемую и однозначно интерпретируемую. Вот это то, про что я вам говорил — должна быть однозначная интерпретация того, что вы подразумеваете под сущностью, ведь это могут быть какие-то разнопонимаемые, по-разному интерпретируемые вещи.
Экземпляры сущностей различаются идентификаторами. Идентификаторы, естественно, нужны для того, чтобы отделить одну сущность от другой однозначно. Нам потребуется какая-то идентификация, какие-то идентификаторы, способы идентификации.
Набор экземпляров сущностей образует множество, и эти множества не содержат дубликатов. Вот это очень важно в реляционных СУБД, почему? Потому что, действительно, мы говорим о множествах без дубликатов.
Отступление от темы
А давайте вот вопрос вам такой задам, но, конечно, я немножко, может быть, вперед забегаю, но все же. Есть у нас две строки в одной табличке. Там все одинаковое. Будут ли эти строки являться дубликатами или нет? Будут ли они являться дубликатами или нет? Немножко такой вопрос с подвохом. Поэтому добавлю: или что-то все-таки там у них будет разное, чем-то они будут отличаться? Ну, ID-шник там будет другой, вот тот самый идентификатор, и, соответственно, это будут для нас уже разные строки, пусть даже содержащие одинаковую информацию. >
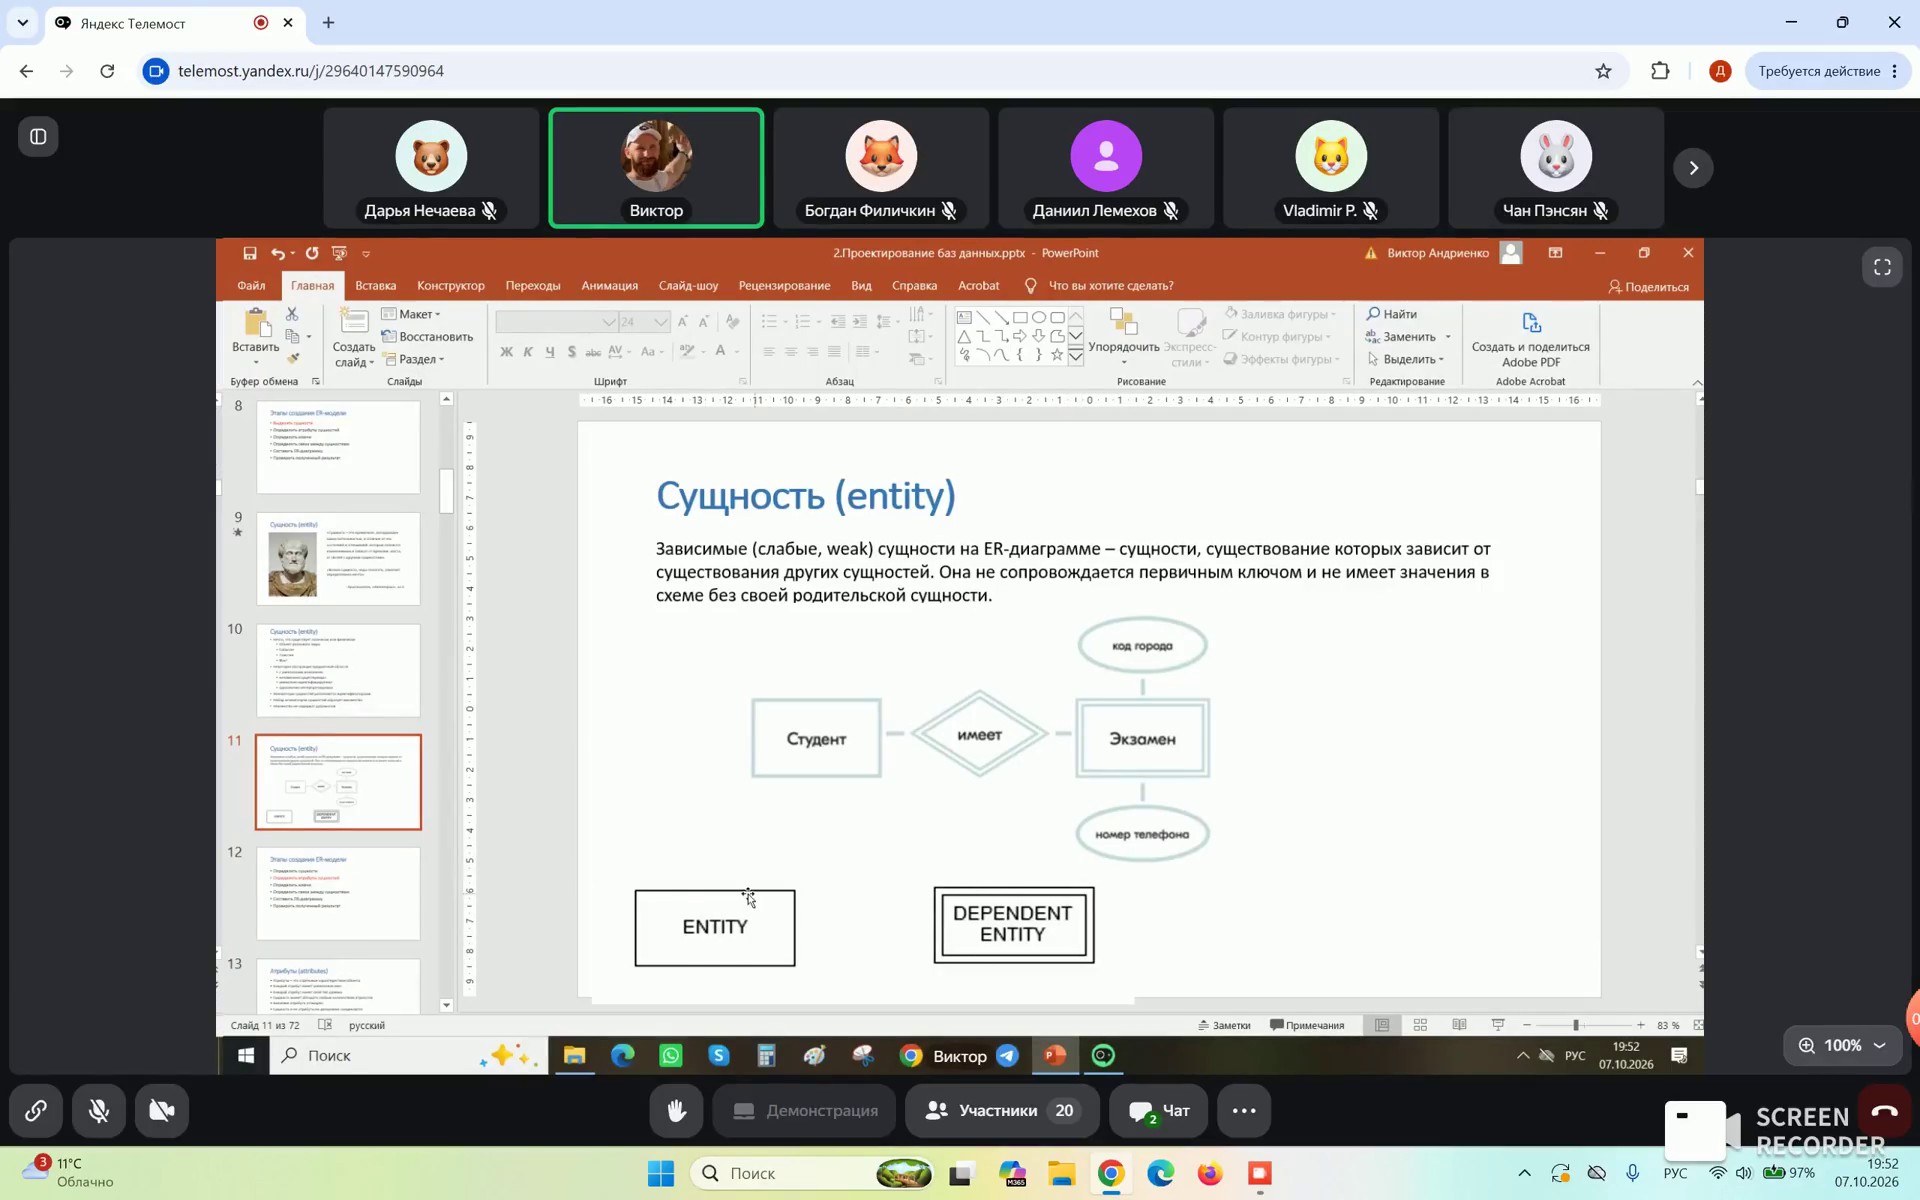
Идем дальше. Сущности. Есть у нас так называемые зависимые или слабые сущности на ER-диаграмме. Что это такое? Это сущности, существование которых зависит от существования других сущностей. Давайте немножко по-другому скажу, чтобы не было масла масляного: если есть какая-то сущность, существование которой зависит от другой сущности, то тогда эта сущность объявляется зависимой. Она не сопровождается первичным ключом и не имеет значения в схеме без своей родительской сущности.
Посмотрите, пожалуйста, определите, какая сущность на данном слайде является зависимой. Что думает по этому поводу? — Все здесь зависимые сущности. — Экзамен зависимый. Экзамен зависимый. А почему? — Ну, потому что у студентов есть экзамены, а не у экзаменов есть студенты. — Ну да, достаточно такой простой вопрос. Хорошо, конечно же, экзамены существуют у нас только в контексте студента и какого-нибудь там, например, курса.
Давайте еще пример зависимой сущности приведем, парочку примеров буквально. Например, телефонный номер сотрудника будет являться у нас отдельной сущностью или от чего-то зависит? — Зависит от сотрудника. — Зависит от сотрудника, абсолютно верно.
Ну хорошо, идем тогда дальше. Зависимая сущность выражается как прямоугольник с ободком, а обычная сущность обозначается как прямоугольник. Говорили про определение сущности, переходим к следующему этапу, который называется «Определение атрибутов сущности».
Определение атрибутов сущности и атомарность
После определения сущности мы переходим к следующему этапу, который называется «Определение атрибутов сущности». Это достаточно важная вещь. Давайте поговорим про атрибуты. Что это такое? Атрибуты – это отдельные характеристики объекта. То есть, если у нас есть какой-то объект, у него могут быть различные атрибуты, как в том же, например, объектно-ориентированном программировании.
Каждый атрибут имеет уникальное имя, а также каждый атрибут имеет свой тип данных. Сущность может обладать любым количеством атрибутов, я лишь только бы здесь добавил, чтобы это количество не было избыточным, чтобы мы не плодили атрибуты ради атрибутов. Потому что очень часто атрибутов, конечно, может быть сколько угодно, но есть какое-то ограниченное количество атрибутов, которых нам вполне достаточно для того, чтобы работать с какой-то сущностью. Как правило, это тоже определяется на этапе требований. Если же того, что предоставил заказчик, не хватает нам для нормальной работы на уровне ИТ, на уровне реализации, для работы с этой сущностью, то мы вводим какие-то свои дополнительные вспомогательные атрибуты, которые нам помогают с этим работать.
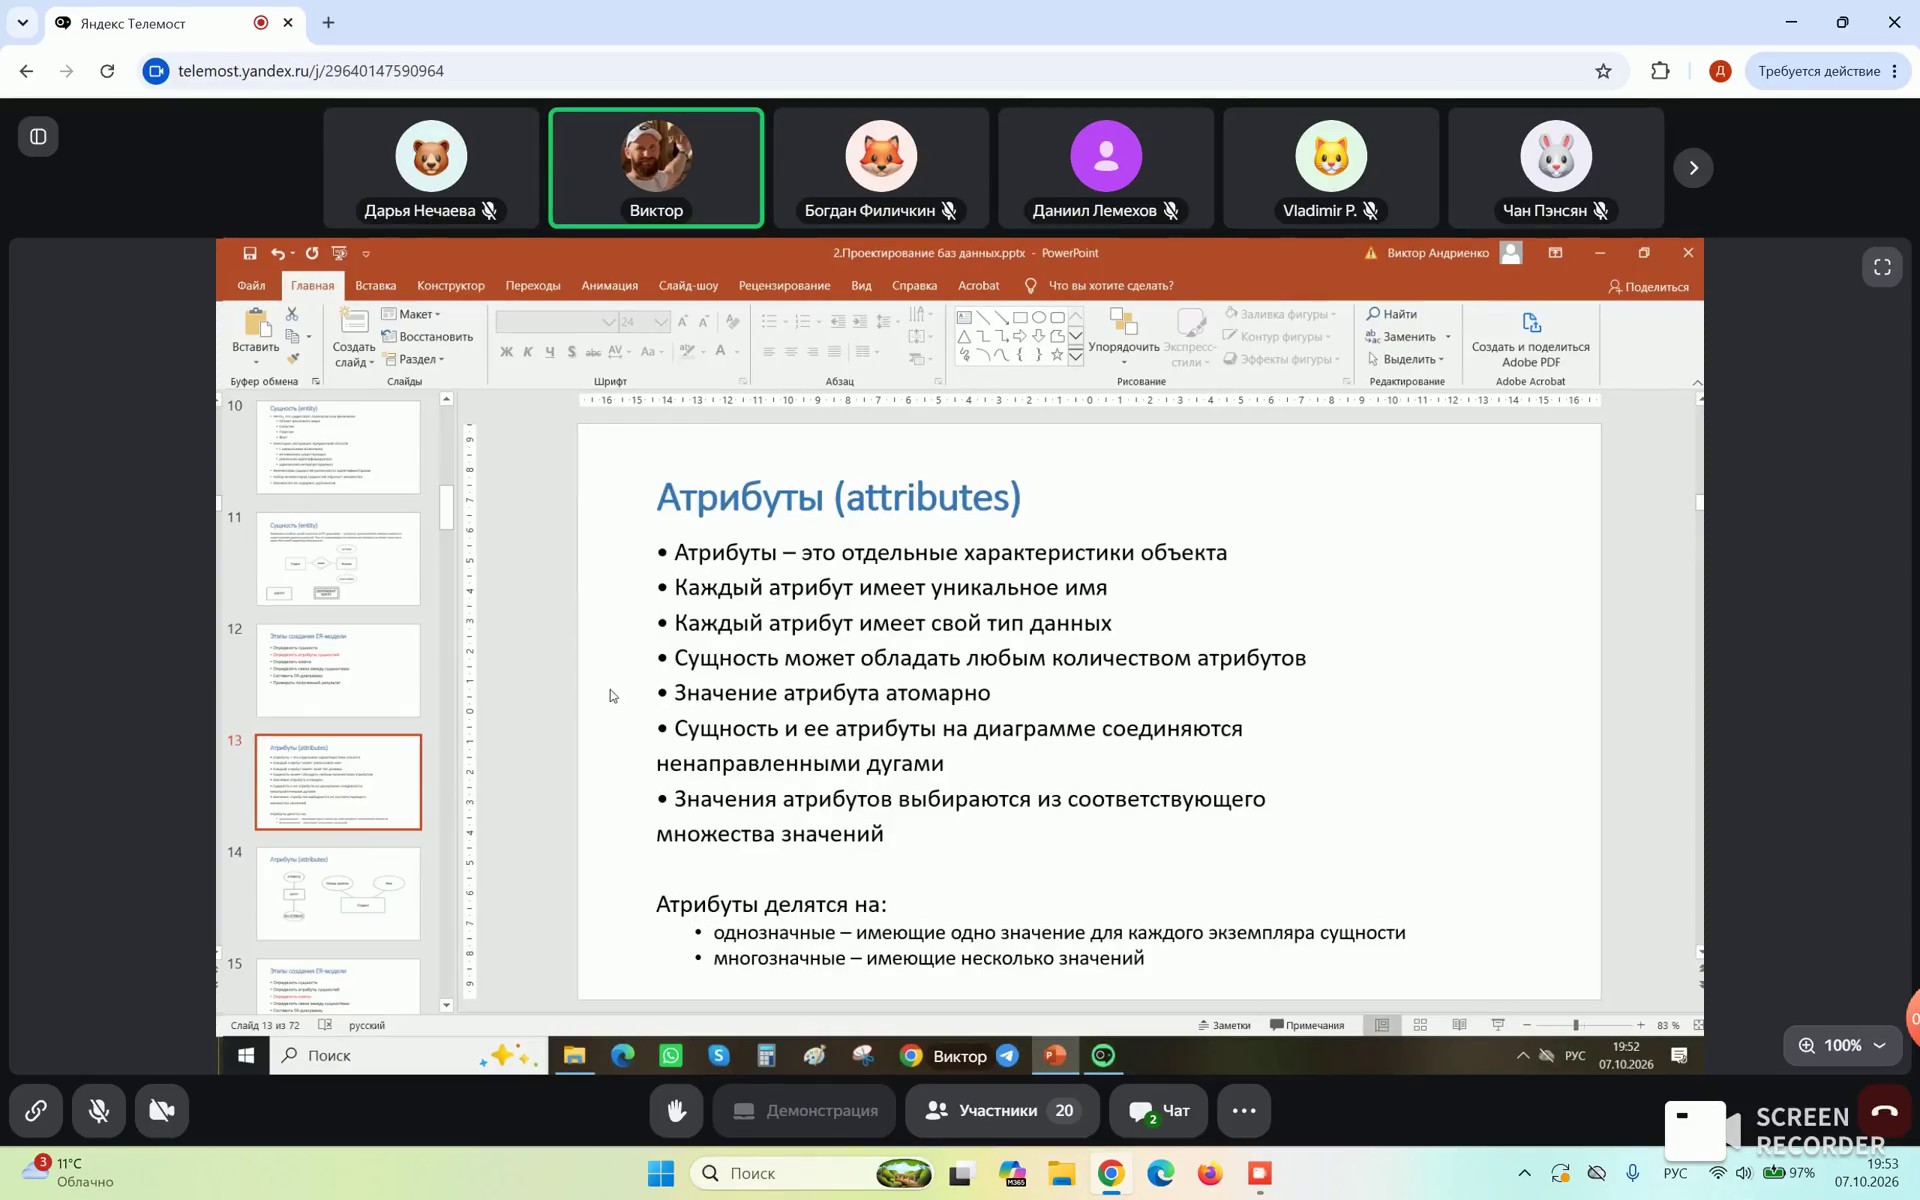
Значение атрибута должно быть атомарным. Что означает атомарность в данном случае? Давайте приведем пример неатомарного атрибута. Это когда мы объединяем несколько значений в одно, например, имя плюс фамилия или имя плюс фамилия и отчество еще у кого-то бывает (как правило, у всех, но у кого-то может и не быть). Если у нас атрибут какой-нибудь условный ФИО, то тогда мы естественным образом нарушаем атомарность. Почему? Потому что атомарность – это когда у нас фамилия отдельная, имя отдельное, отчество отдельное. Сущность и её атрибуты на диаграмме соединяются ненаправленными дугами.
Значение атрибутов выбирается из соответствующего множества значений. То есть у каждого атрибута есть определенное множество значений, которые этот атрибут может принимать. В свою очередь, атрибуты делятся на однозначные, которые имеют одно значение для каждого экземпляра сущности, и многозначные, имеющие несколько значений. Однозначные атрибуты, мы про них уже говорили, это, например, номер зачётки у студента. Что еще может это быть? Например, у автомобиля есть только один VIN-номер, и если вы там нашли какой-нибудь второй VIN-номер, значит, что-то с этим автомобилем не так.
Многозначные атрибуты — что это такое? Это, например, когда у книги есть несколько авторов. Это пример многозначных атрибутов. Что еще? Например, у студента может быть несколько телефонных номеров. Тоже пример многозначных атрибутов. Вот как выражаются у нас атрибуты — таким овальчиком. И приведем пример, когда у нас есть студент, и у него есть два атрибута: номер зачётки и имя. Есть так называемый ключевой атрибут, о нем мы поговорим чуть позже, переходя к определению ключей.
Идентификация сущностей: естественные и суррогатные ключи
Прежде чем говорить о ключах, необходимо рассмотреть понятие идентификации сущностей. Идентификация сущностей выражается как возможность отличимости одной сущности от другой. Сущности идентифицируются специально выделенными атрибутами, которые называются ключевыми и позволяют отличить один экземпляр сущности от другого. Среди ключевых атрибутов выбирается так называемый первичный ключ, по которому можно однозначно идентифицировать сущность, например, студента по номеру зачетки. Ключ — это один или несколько атрибутов объекта, по которым объект можно однозначно идентифицировать.
Ключи делятся на две основные категории. Естественные ключи — это атрибуты из реального мира, которые, однако, чаще всего являются ненадежными. Суррогатные (искусственные) ключи — это ключи, у которых нет соответствующей сущности в реальном мире, такие как числовой ID-шник либо более сложный идентификатор UUID.
В качестве примеров естественных ключей можно назвать номер в последовательности или номер телефона. Причиной ненадежности таких ключей является изменяемость: например, телефонный номер может перейти от человека к человеку. Аналогичным примером является паспорт, который тоже можно заменить, и номер старого паспорта станет недействительным. Сюда же относится и email — всё, что подвержено изменениям и не может однозначно быть связано с сущностью в течение достаточного для времени жизни этой сущности периода.
Другой причиной ненадежности естественных ключей является неуникальность. Ключ может быть не уникальным, как в примере, когда два студента с одинаковым ФИО (Иванов Иван Иванович) оказываются в одной группе, или когда речь идет о названиях компаний и других атрибутах, которые могут повторяться.
Суррогатные ключи представляют собой вводимые уникальные идентификаторы, такие как упомянутый UUID (128-битный идентификатор) или GUID (его аналог от Microsoft). Такой ключ является уникальным в той степени, которая удовлетворяет потребности информационной системы.
Простые и составные ключи
Ключи, помимо того, что они могут быть естественными или искусственными, также могут быть либо простыми, состоящими из одного атрибута, либо составными, которые состоят из нескольких атрибутов.
Когда ключ простой, то он сам по себе уникален и может индицировать нашу сущность достаточно надежно. Это может быть, как приводились уже примеры, номер зачетки у студента, VIN автомобиля или код ISBN у книжки, которую должна каждая книга иметь. В общем, всё то, что помогает однозначно идентифицировать какую-то сущность.
Когда мы говорим о составном ключе, то мы говорим о том, что этот ключ состоит из нескольких атрибутов, но когда мы их используем вместе. Один атрибут, если мы используем его по отдельности, может не гарантировать уникальность. В качестве примера можно привести комбинацию ФИО студента плюс номер зачетки. Если мы не говорим о том, что номер зачетки — это какой-то уникальный идентификатор сам по себе, а рассматриваем систему, где уникальность достигается только так, то вполне себе ФИО плюс номер зачетки может являться составным ключом, который однозначно идентифицирует какую-то сущность. Но на самом деле составной ключ мы используем только тогда, когда уникальность можно достичь именно комбинацией этих атрибутов. Во всех остальных случаях, конечно же, проще и лучше использовать простой ключ, а не играться с этими составными ключами. На слайде приведен пример такого составного ключа, когда у нас ключ образуется, хоть и не гарантирует абсолютную уникальность, но все же образуется через name и surname — через имя и фамилию.
Понятие и характеристики первичного ключа
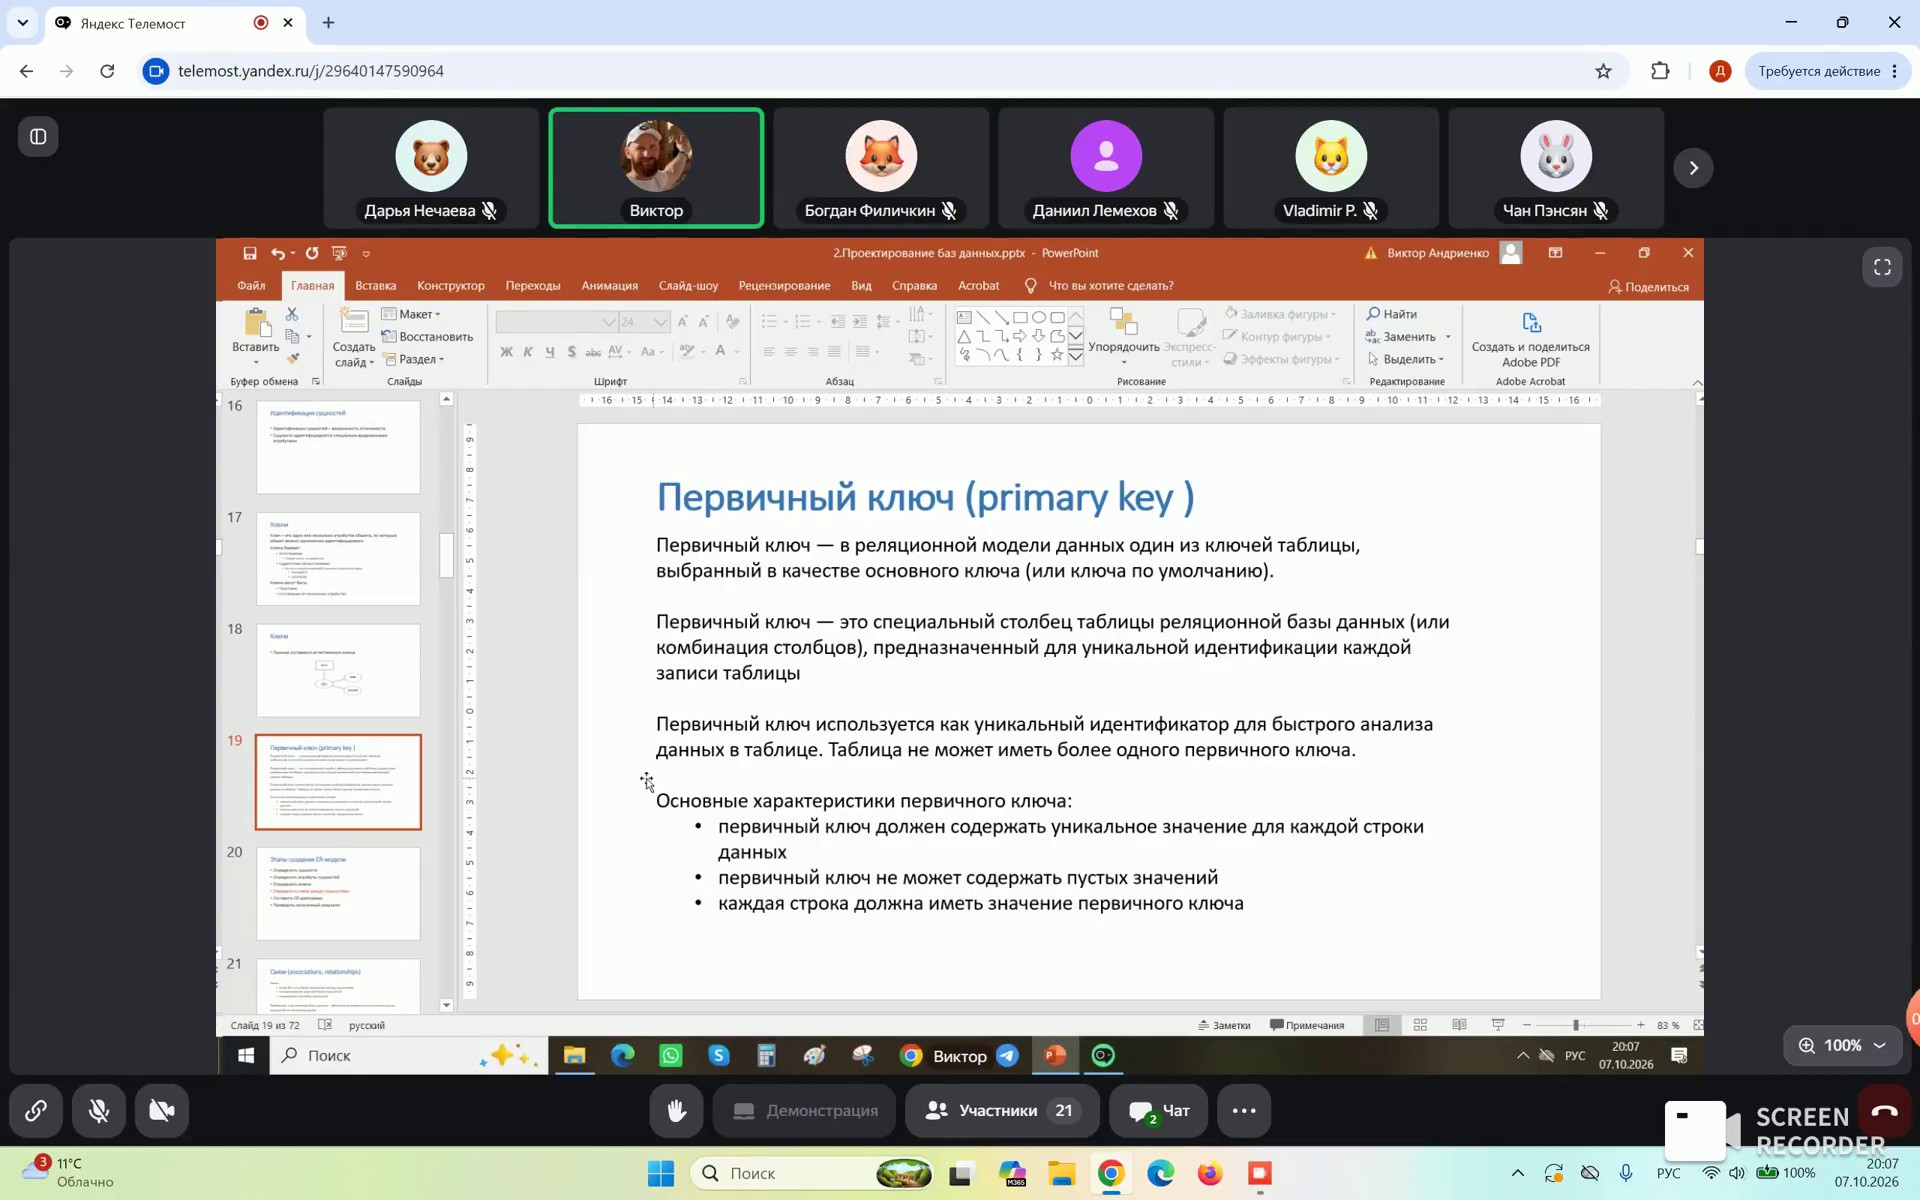
Первичный ключ в реляционной модели данных — это один из ключей таблицы, выбранный в качестве основного ключа или ключа по умолчанию. Другое определение описывает первичный ключ как специальный столбец таблицы реляционной базы данных или комбинацию столбцов, предназначенную для уникальной идентификации каждой записи таблицы. Первичный ключ также используется как уникальный идентификатор для быстрого анализа данных в таблице. Важно отметить, что таблица не может иметь более одного первичного ключа.
Для понимания этих определений следует выделить основные характеристики первичного ключа. Во-первых, первичный ключ должен содержать уникальное значение для каждой строки данных, чтобы не возникало ситуаций, когда невозможно уникально идентифицировать какую-либо из строк. Во-вторых, первичный ключ не может содержать пустых значений, и каждая строка должна иметь значение первичного ключа. Это означает, что поле первичного ключа должно быть NOT NULL, то есть нуллы в нем недопустимы.
Отступление от темы
Хорошо, давайте какой-нибудь вопросик, чтобы подвести итог. А вот какие характеристики первичного ключа у нас могут нарушиться, только внимательно подумайте над вопросом, над ответом точнее, на этот вопрос. Если мы в качестве первичного ключа возьмем фамилию и имя отчество. Мы не говорим здесь даже про атомарность. Давайте представим, что мы взяли в качестве первичного ключа фамилию и имя отчество. — Ну, уникальность. — Уникальность, да. Да, уникальность, а что еще может произойти? Уникальность также у нас может быть на... если мы берем с трех вместе людей некоторых... не то чисто, да, у нас вполне... — Абсолютно верно вы сказали, что отчество может не быть. И вот девушка сейчас добавила, что вполне там можно выйти замуж и поменять фамилию, вот, например, или там просто изменить свое имя, вот, если кто-то хочет какое-то экзотическое имя вдруг приобрести. Да, ребята, все правильно вы сказали. Очень радуюсь, что вы так активно отвечаете на вопросы. Хоть вопросы сложные, но они все же позволяют как-то вот эти формальные определения в каких-то образах как-то легче, наверное, запомнить. Окей, давайте тогда пойдем дальше.
Переходим от определения ключей к определению связей между сущностями.
Связи и нотации ER-диаграмм
Определение и характеристики связей между сущностями
Переходим к определению связей между сущностями. Это тоже одна из важных задач. Может быть, не то чтобы самая важная, ведь если определить сущности неправильно, потом вообще всё будет неправильно, но пренебрегать задачей определения связей мы тоже не можем.
Что такое связь? Какое бы то ни было отношение между сущностями, ассоциирование двух или более сущностей, упорядоченный набор сущностей — все эти определения по-своему правильно отвечают на вопрос, что такое связь. Соответственно, требования к организации баз данных включают в себя обеспечение возможности отыскания одних сущностей по значению других. В этом-то, наверное, и один из смыслов, когда мы берем что-то и по этому чему-то определяем то, что нам, например, необходимо.
Отступление от темы
Вот, и, значит, на экзамене для тех, кто хочет там получить вот эту супер оценку отличную, я предлагаю решить очень простые задачки, они настолько элементарные, как бы, да, что вот ребята, ну, которые действительно там добросовестно и на лекции ходят, слушают и практику, практикой занимаются, вот Татьяна Борисовна, они их решают там за пару минут, вот, ну, для кого-то они, конечно, вызывают сложности, Как правило, это достаточно простые задачи и сложности у большинства ребят не возникает. Попутно я сказал по поводу экзамена нашего предстоящего.
Идентификатор связи включает в себя идентификаторы сущностей, в них участвующих.
Что включает в себя связь? Название, упорядоченный список участвующих сущностей и так называемая мощность связи. Что такое мощность, мы с вами тоже поговорим, пока нужно запомнить вот эти три характеристики связи: название, упорядоченный список участвующих сущностей и мощность.
Мощность связей и их классические типы
Связи. Вот как раз мы добрались до мощности. Что такое мощность, что она показывает? Показывает количество участников в отношении с обеих сторон. Ну и какие у нас бывают мощности связей? Почему классические? Потому что, конечно, могут быть различные вариации между вот этими вот несколькими классическими мощностями связей.
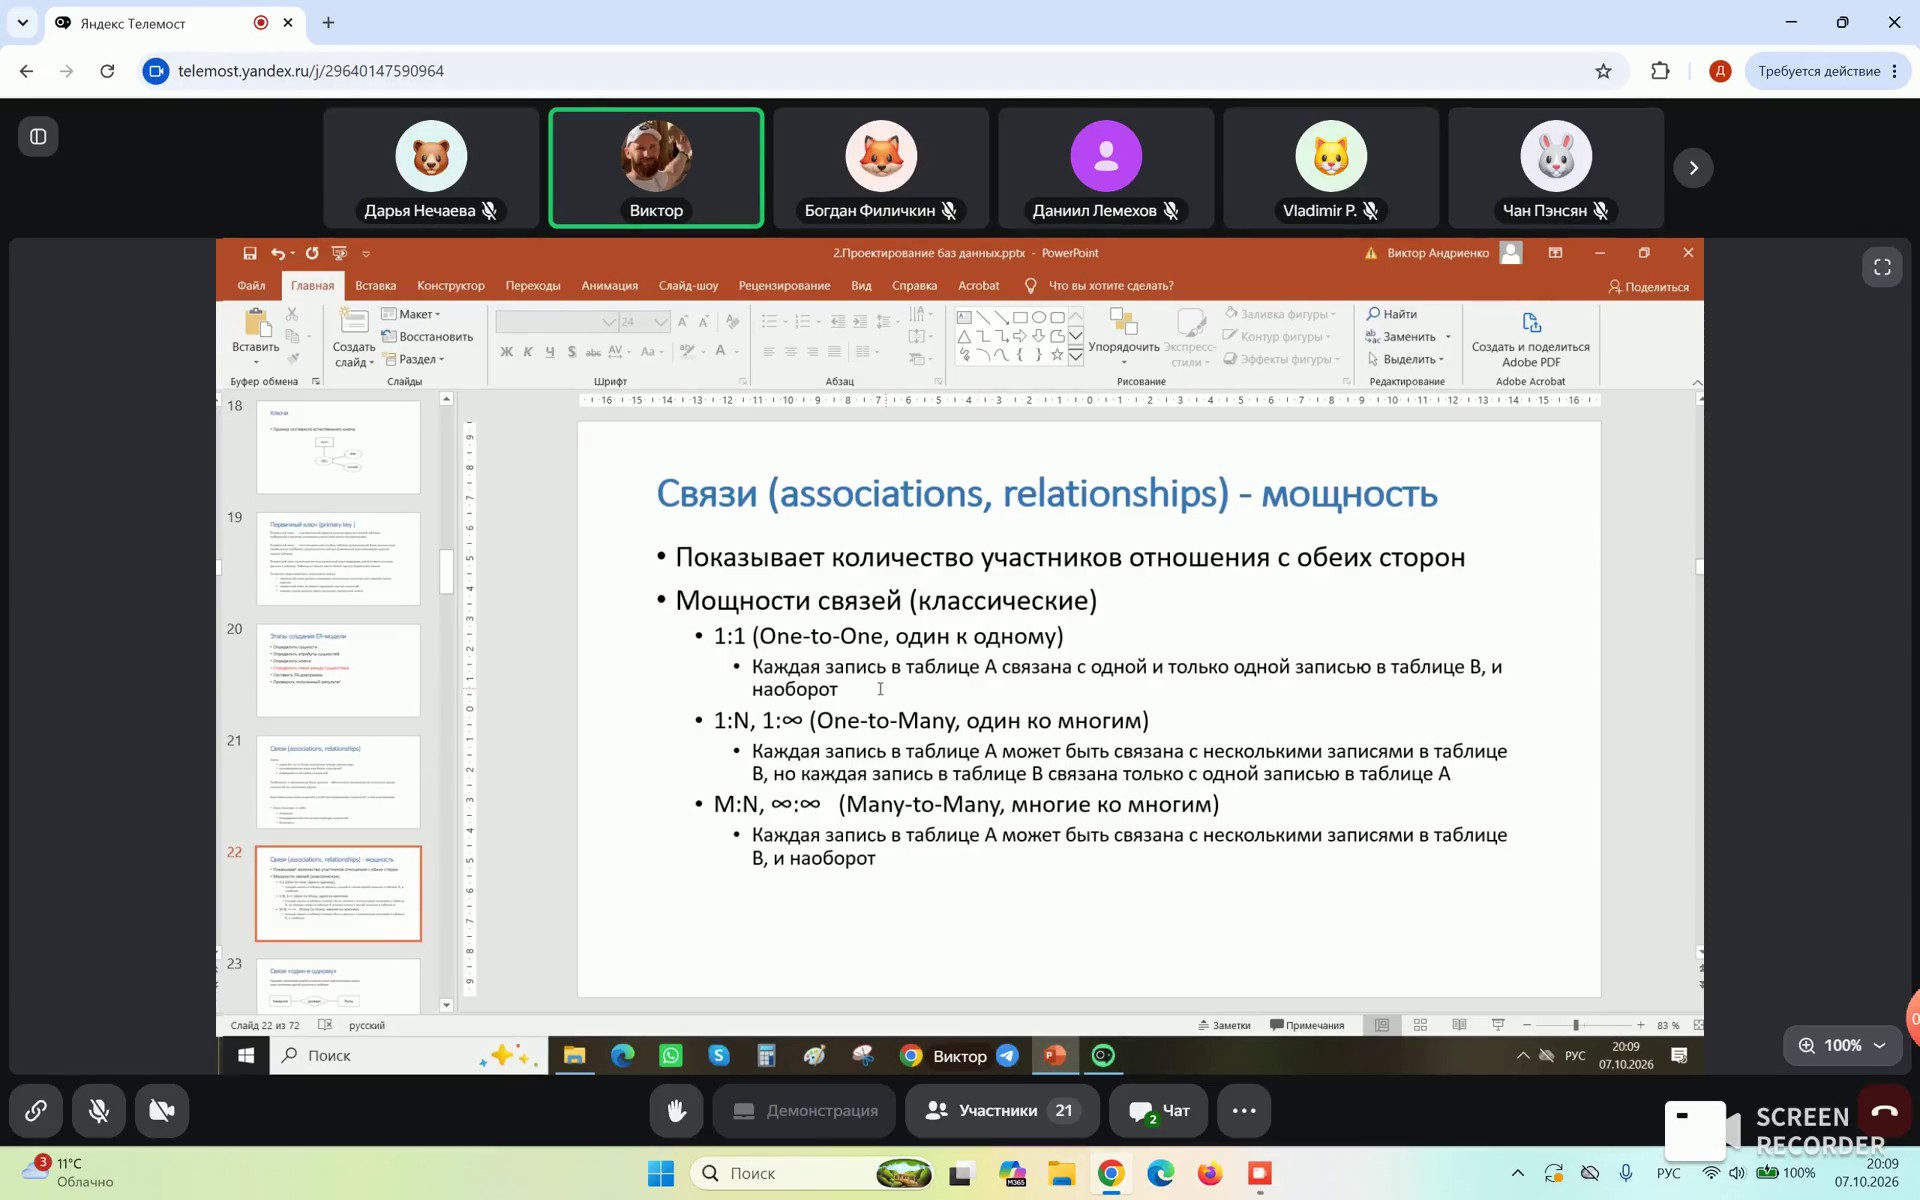
Первый вид связи – это один к одному. Что он означает? Каждая запись таблицы A связана с одной и той же только одной записью в таблице B и наоборот.
Один ко многим, что означает: каждая запись таблицы А может быть связана с несколькими записями в таблице B, но каждая запись таблицы B связана только с одной записью в таблице A.
Ну и, соответственно, многие ко многим, что это такое? Каждая запись таблицы A может быть связана с несколькими записями в таблице B, и наоборот.
Отступление от темы
Какие из типов связей, значит, мы, какие из типов связей мы, так, все уже заговорились, какие из типов связей являются наиболее правильными для проектирования баз данных, мы тоже с вами поговорим, вот, и даже порассуждаем, а почему именно так. Может быть, сейчас уже кто-то знает, какие вот типы, какой тип связи предпочтительны при проектировании баз данных, к чему мы стремимся? При прочих равных в общем случае. Есть какие-то предположения? Один к многим. Один ко многим. Действительно, это один ко многим. Хотя если бы один ко многим был у нас такой универсальным типом связи, то тогда другие связи нам бы вообще не понадобились. Действительно, это один ко многим. Почему мы с вами обязательно позже поговорим.
Связь один к одному. Немножко просматриваем эти типы связей и посмотрим примеры. Каждому экземпляру первой сущности может соответствовать ровно один экземпляр другой сущности и наоборот. Что у нас есть? У нас есть университет, у нас есть руководитель и у нас есть ректор. Как мы можем сказать про эту связь? Что в университете университетом руководит ректор. Но также мы можем сказать, что у какого-то университета есть определенный ректор. То есть ректор может руководить университетом, университет может иметь ректора. Так мы можем выразить эту связь. И то, и другое будет верно в зависимости от того, с какой точки зрения мы эту связь рассматриваем.
Связи один ко многим. Каждому экземпляру первой сущности может соответствовать несколько экземпляров другой сущности, но каждому экземпляру второй сущности соответствует не более одного экземпляра первой сущности. Сотрудник работает в отделе. Что имеется в виду? Что отдел-то у нас всего один, но этот один отдел может включать много сотрудников. Но как мы можем выразить, что отдел один со связью с сотрудником? Мы можем сказать, что каждый сотрудник из рассматриваемых, естественно, работает только в одном отделе. Вот только в одном отделе он работает. То есть со стороны отдела у нас получается один, а со стороны сотрудников у нас получается много.
Ну и, соответственно, связь многие ко многим.
Условия создания связей и нотация Питера Чена
Каждому экземпляру первой сущности может соответствовать несколько экземпляров другой сущности, и наоборот. В качестве примера можно привести сотрудника, который участвует в проекте: понятно, что может быть много проектов, в которых участвует сотрудник, и может быть много сотрудников, которые участвуют в каком-то проекте, причем верно и то, и другое.
Что касается условий создания связей, то связь нужна, если в качестве атрибута одной сущности хочется указать другую сущность или ключ другой сущности. Это два косвенных признака, по которым мы можем сказать, что здесь нам нужно спроектировать связь и сделать отношения.
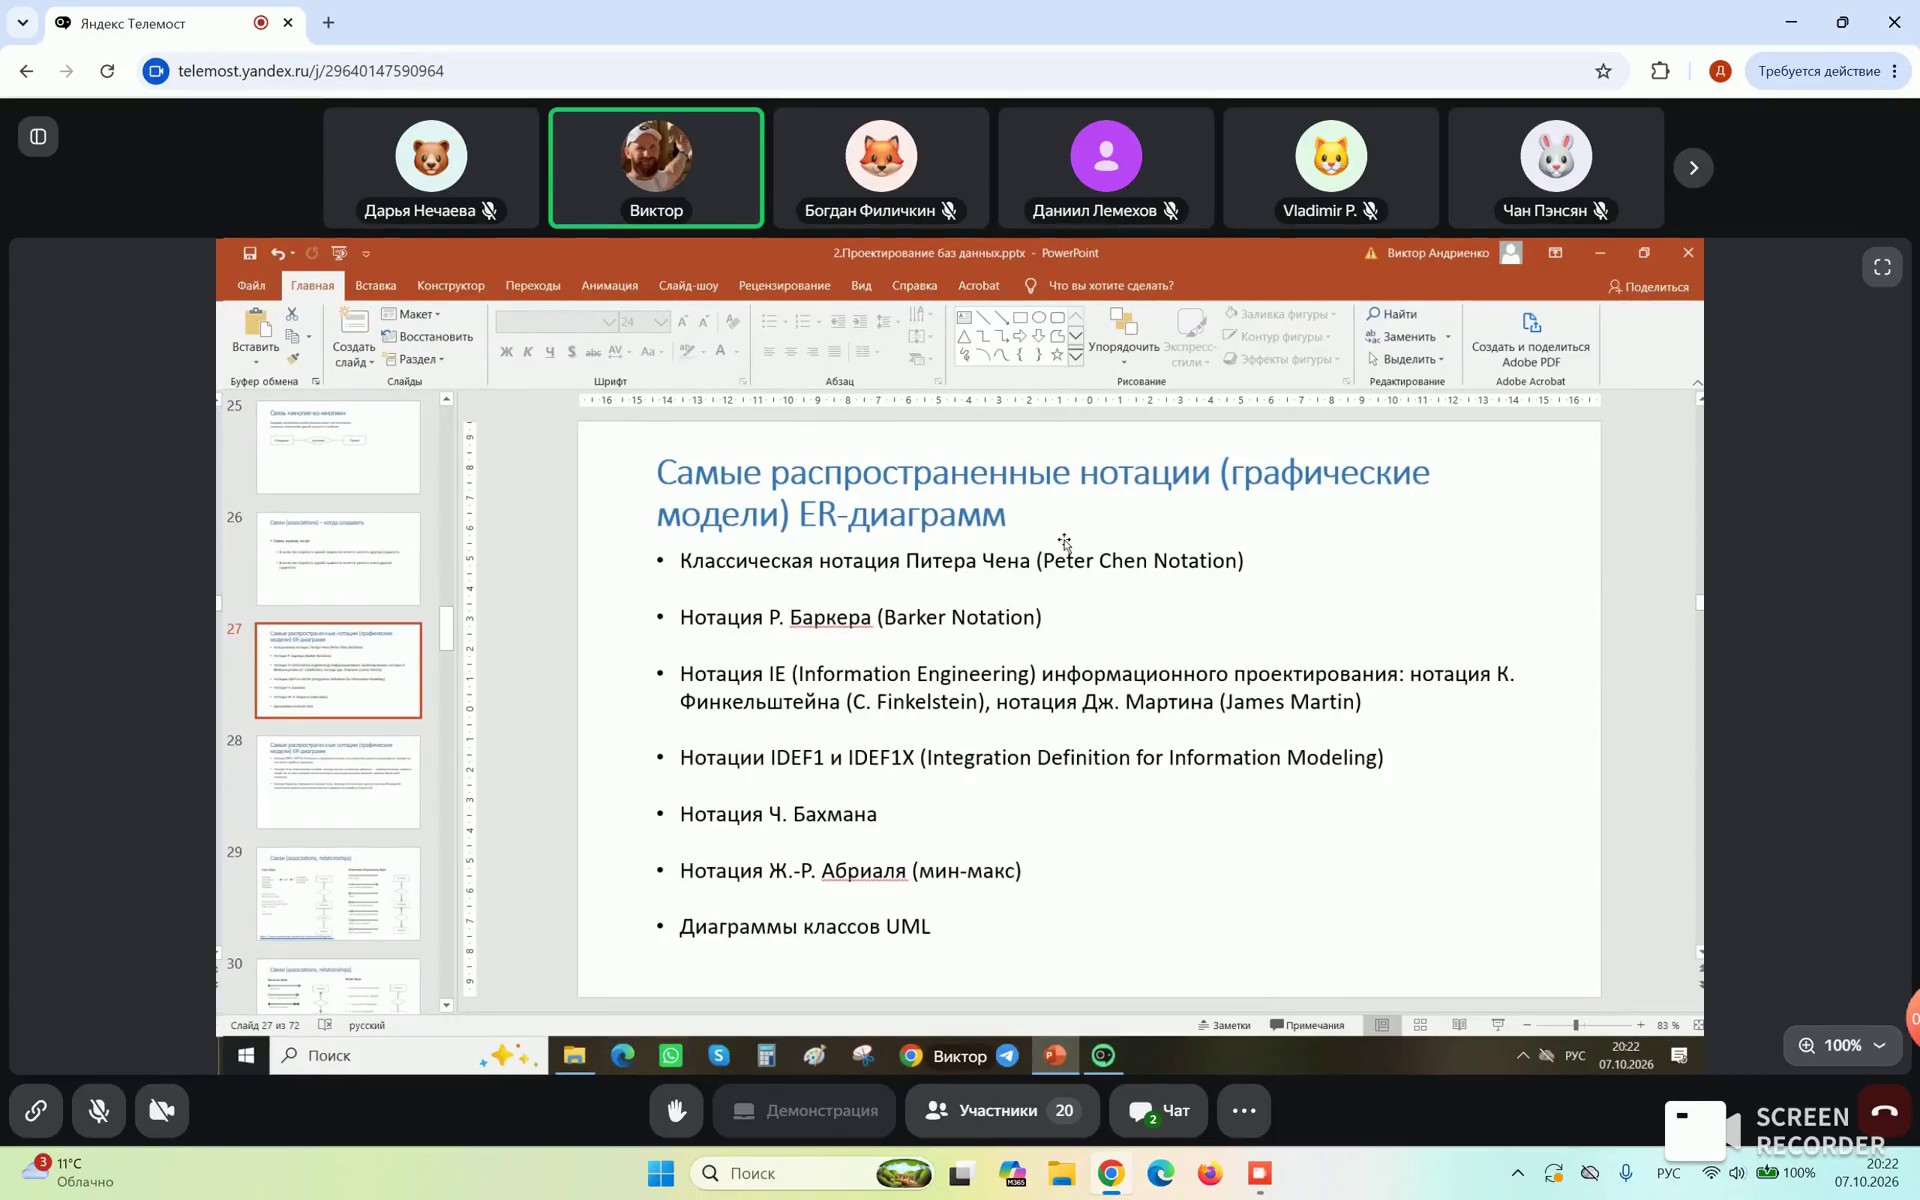
Среди самых распространенных нотаций и графических моделей выделяется классическая нотация Питера Чена, которую он придумал в 1976 году. В этой нотации сущности выражаются прямоугольниками, связи — ромбами, а атрибуты — овалы.
Отступление от темы
Лектор проводит интерактивный опрос студентов о том, какими фигурами выражаются атрибуты в нотации Питера Чена, хвалит ответившего студента и шутит, что если информация новая, она не с первого раза запоминается. Затем лектор делится собственным опытом и методом работы с литературой: он читает материал несколько раз (первый раз быстро по диагонали, второй — вчитываясь и находя интересные вещи, третий — машинально, а затем еще пару раз для лучшего понимания сути), отмечая, что с каждым разом находятся новые интересные детали. Несмотря на трудозатратность, такой подход оправдывает себя тем, что информация лучше укладывается, запоминается и структурируется, хотя и требует проигрыша в скорости.
Обзор нотаций Баркера, Information Engineering и IDEF1X
Далее рассматривается нотация Баркера, которая применяется для описания данных. До сих пор, правда, уже не так часто, она стала популярна благодаря использованию компании Oracle, так как Oracle — наше всё в плане баз данных. Нотация Баркера представляет собой всеми, наверное, известную воронью лапку из-за характерного изображения, похожего на воронью лапку, где символы мощности и кардинальности выражаются разветвлениями.
Затем идет нотация Information Engineering, что расшифровывается как информационное проектирование — это нотация Финкельштейна и нотация Мартина. Финкельштейн и Мартин основали свою нотацию на нотации вороньей лапки, и на этих линиях с лапками тоже обозначалась мощность.
Отступление от темы
Чем еще там, какие нюансы были, если честно, вам, наверное, не подскажу, потому что уже не помню.
Эта нотация достаточно сильно распространена в бизнес-моделировании, и ее там не то чтобы любят, а используют.
Нотация IDEF1 и IDEF1X. Вся эта серия IDEF возникла в Соединенных Штатах Америки в военных разработках информационных систем различных для ВВС США, если лектор не ошибается. Просто IDEF1 представляет собой концептуальную модель. А вот IDEF1X — это уточненная версия именно для реляционных БД: там у нас добавлялись primary key, foreign key (первичный и внешний ключи), добавлялись правила нормализации. В общем, если IDEF1 — это концептуальная модель, то IDEF1X — это такая реляционно-субэдэшная версия.
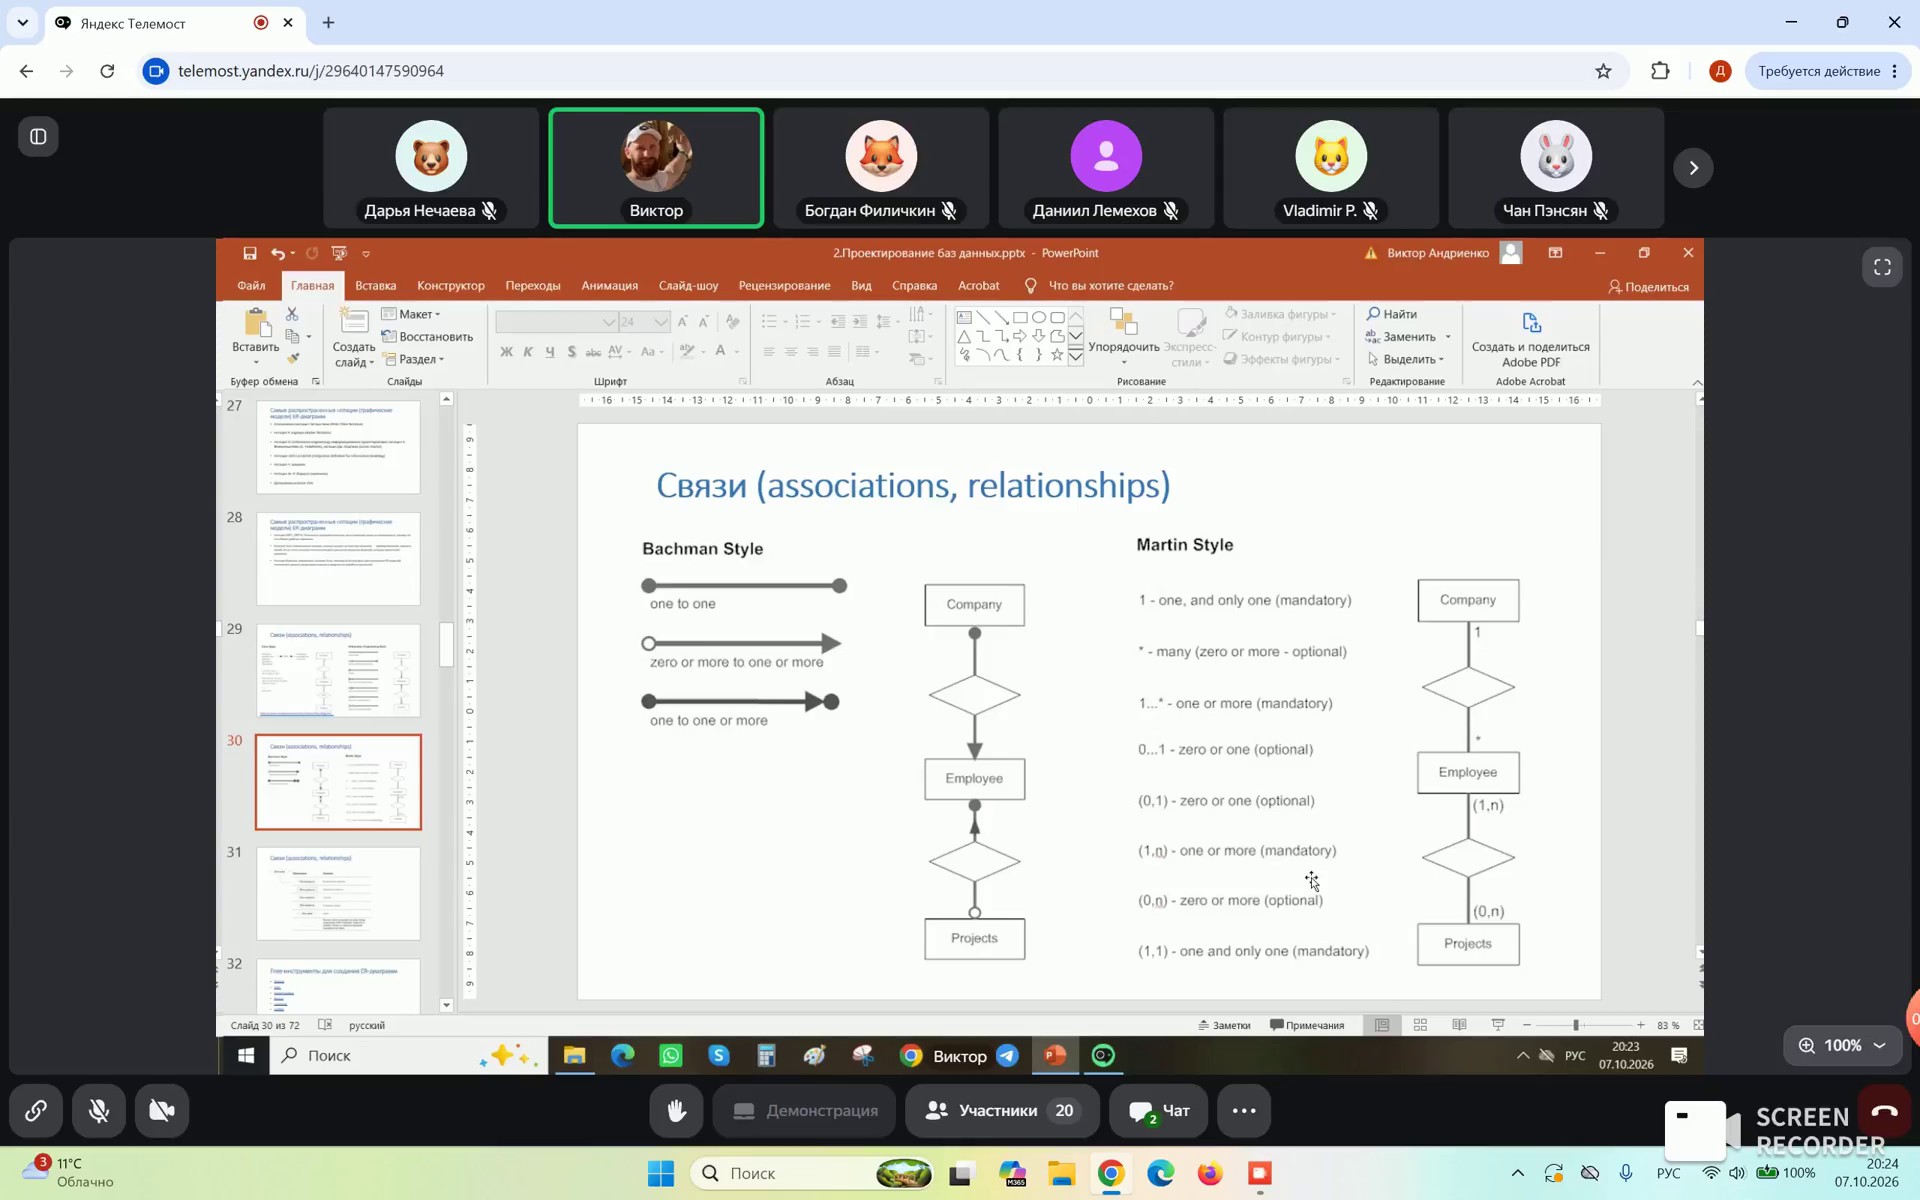
Что у нас есть еще дальше? Нотация Бахмана. Эта нотация появилась практически одновременно с нотацией Питера Чена, может быть, чуть попозже. Она представляла из себя изображение в виде сетевых моделей. Из-за своей специфичности она не так сильно была распространена в классических ER-диаграммах, то есть применение ее не было распространено для проектирования БД.
Что у нас еще осталось? Нотация Абриаля. Там использовался так называемый Min-Max подход. Смысл был в том, что этот минимаксный подход ограничивал связи, накладывал различные ограничения. Например, студент может сдавать минимум один экзамен и максимум десять экзаменов — вот вам пример ограничения в подходе нотации Абриаля.
Нотации Бахмана, Абриали и диаграммы классов UML
В подходе нотации Абриали, а также в диаграммах классов UML (Unified Modeling Language), которые представляют из себя на самом деле 14 языков (7 структурных диаграмм и 7 поведенческих диаграмм), язык UML мало применяется непосредственно при проектировании баз данных. Но поскольку он используется и в архитектуре, и в системной аналитике, а это все вещи, которые так или иначе оказывают влияние на проектирование баз данных, диаграммы классов UML из 14 диаграммок нужно знать и понимать на базовом уровне: что туда входит, какие диаграммы и за что каждая диаграмма отвечает.
Отступление от темы
Что хотел сказать? про нотации Бахмана, какие там символы для чего используются. Но это, конечно, будет очевидный плюс. Это так, чтобы в голове ставить какие-то заметки, что там говорить, отвечать на экзамене. Значит, так, ну, я вам все это, в принципе, рассказал, поэтому давайте немножко сэкономим время и перейдем к следующему слайду.
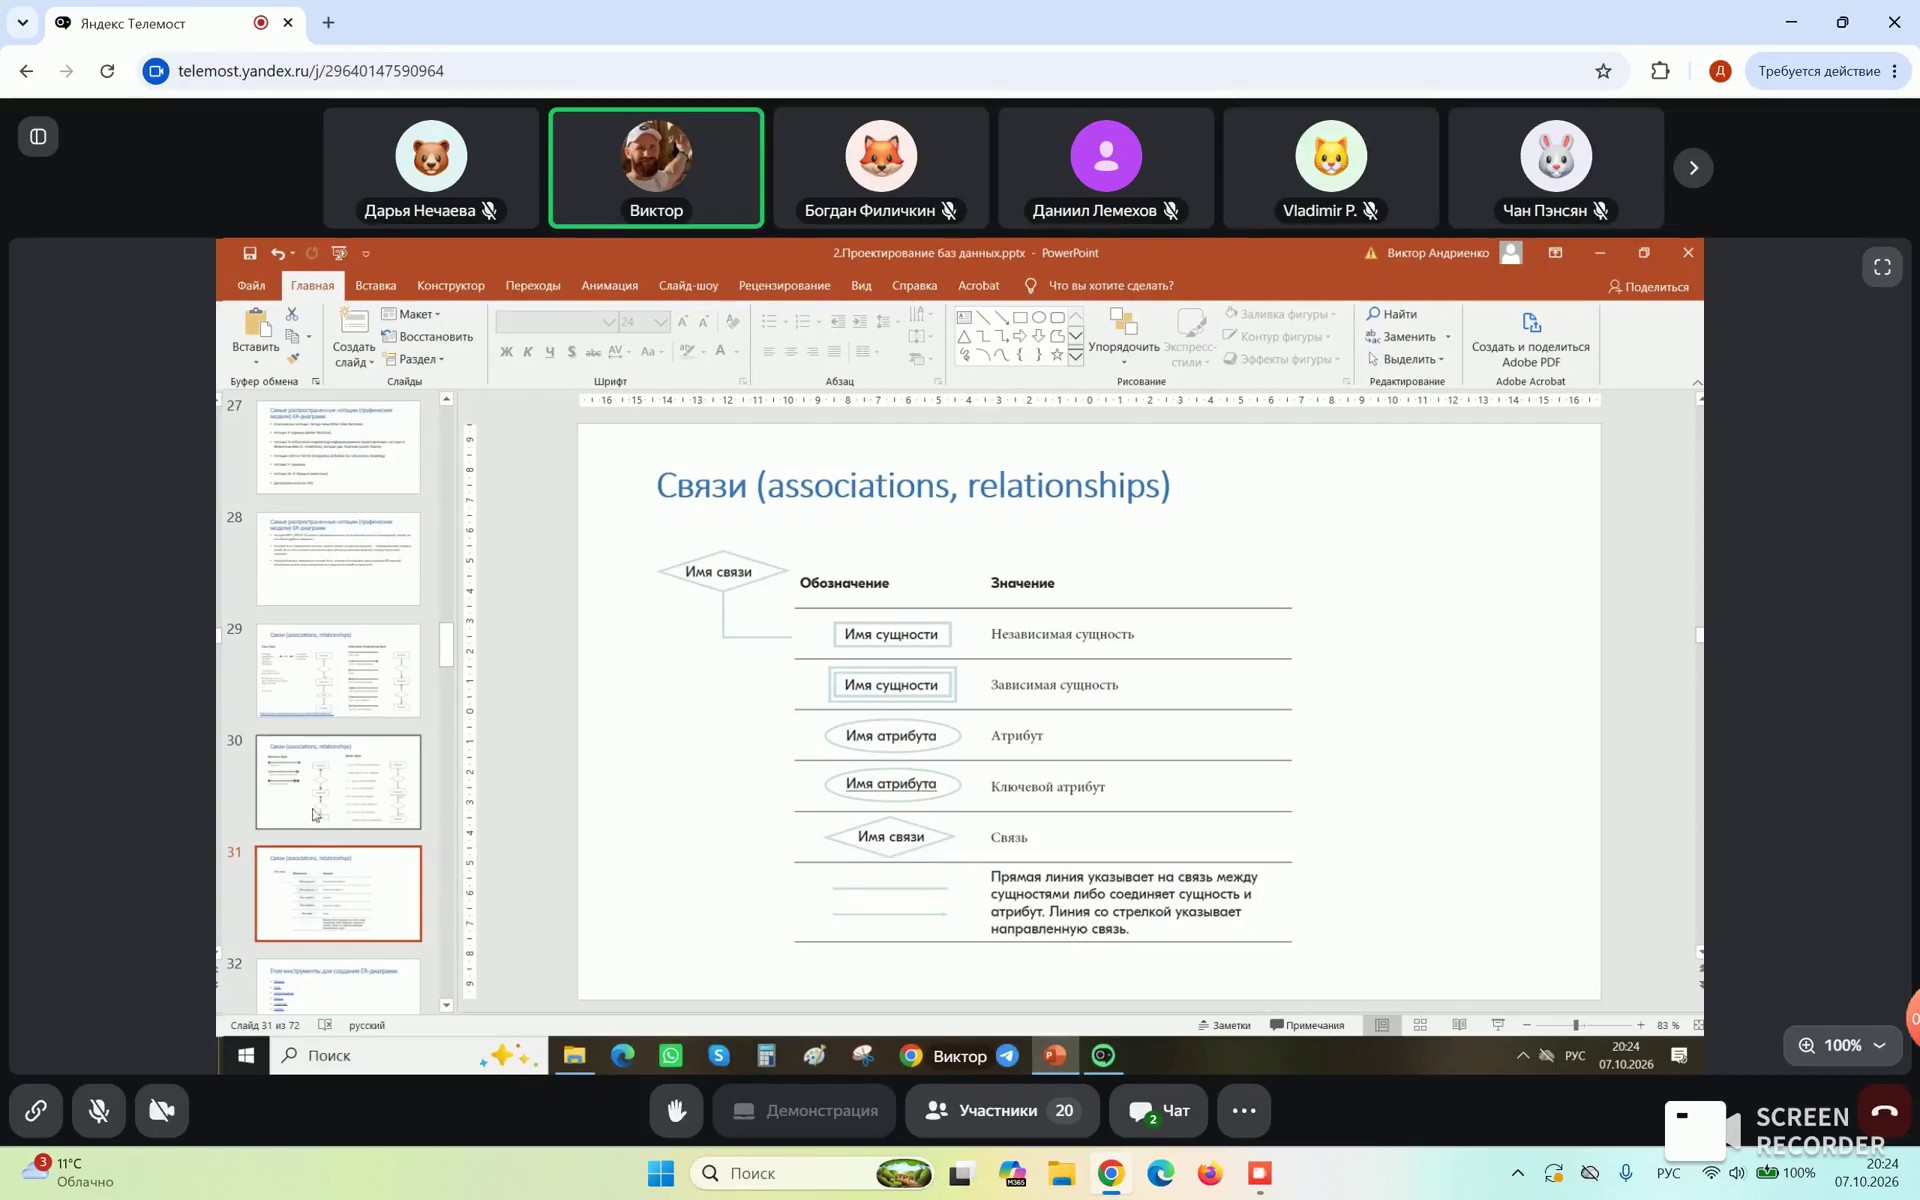
На изображении в нотации Пьеро Чина (в транскрипте — петра чина) отображается структура моделей, которую при ответе на экзамене можно просто зарисовать и объяснить, что здесь что означает, в том числе типы связей, как они и где подписываются. Например, связь one and only one — это обозначение в нотации Бахмана и Мартина, которое тоже можно нарисовать на экзамене и сказать, какая нотация за что отвечает.
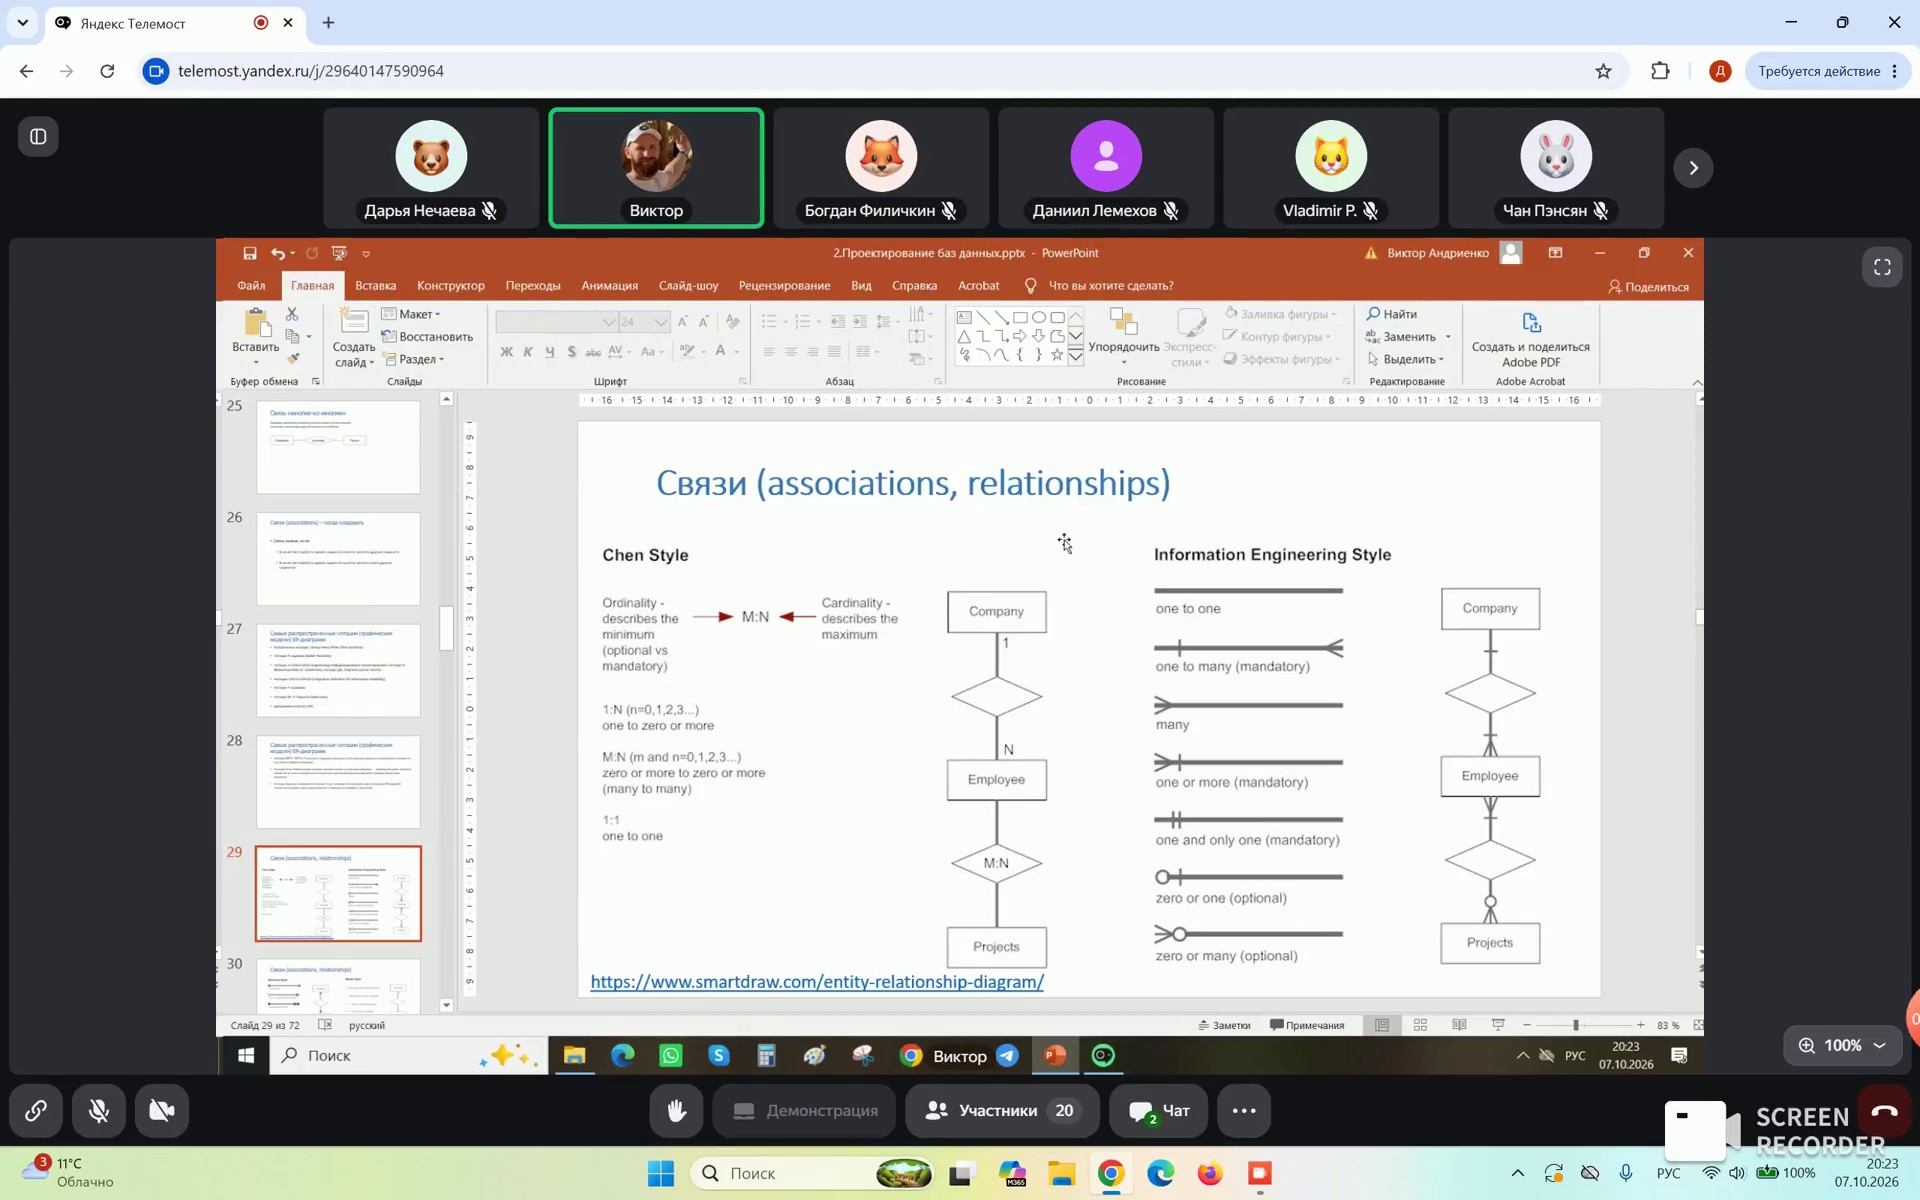
Если брать нотацию Чена, то в ней имя связи, независимая сущность и зависимая сущность обозначаются определенным образом, который наглядно виден на схеме. Атрибуты обозначаются стандартно, а ключевой атрибут обозначается с подчеркиванием. Таким образом можно показать имя связи. Прямая линия указывает на связь между сущностями либо соединяет сущность и атрибут, а линия со стрелкой указывает направленную связь.
Для того чтобы отображать базу данных, которую вы хотите спроектировать, существуют различные инструменты, которые непосредственно моделируют ER-диаграммы и заточены под них. Есть, конечно, более универсальные инструменты, такие как Draw.io, в которых можно моделировать не только ER-диаграммы, но и множество других вещей. Кому интересно, посмотрите, мало ли, пригодится, и вы будете это использовать в своей практике.
Свойства и основные характеристики связей
Связи могут иметь собственные атрибуты, и подобные связи объединяются в множество. При этом связи не могут существовать без связываемых сущностей — это самый очевидный тезис. Ключ связи состоит из ключей связываемых сущностей и, возможно, выделенных атрибутов связи.
Что входит в характеристики связи? Во-первых, размерность — количество видов объектов, которые участвуют в связи. Во-вторых, мощность — это значение максимального количества конкретных экземпляров сущностей, которые могут использоваться для данной связи (когда про мощность говорили, мы уже на этот вопрос отвечали). В-третьих, модальность — это ограничение мощности и отношения между различными объектами внутри схемы базы данных. Вот такие характеристики связи у нас есть.
Размерность связи бывает разной: бинарные, тернарные, эннарные, рекурсивные. Рассмотрим пример бинарной связи: студент-староста-группа. Между одними и теми же сущностями естественно может быть более одной связи.
Что касается тернарной связи, то у связи появляется собственный атрибут «оценка». В таком случае у нас появляются студент, преподаватель и предмет, и все они связаны между собой через сущность «экзамен», у которой появился атрибут «оценка». Вот что здесь выражает этот слайдик.
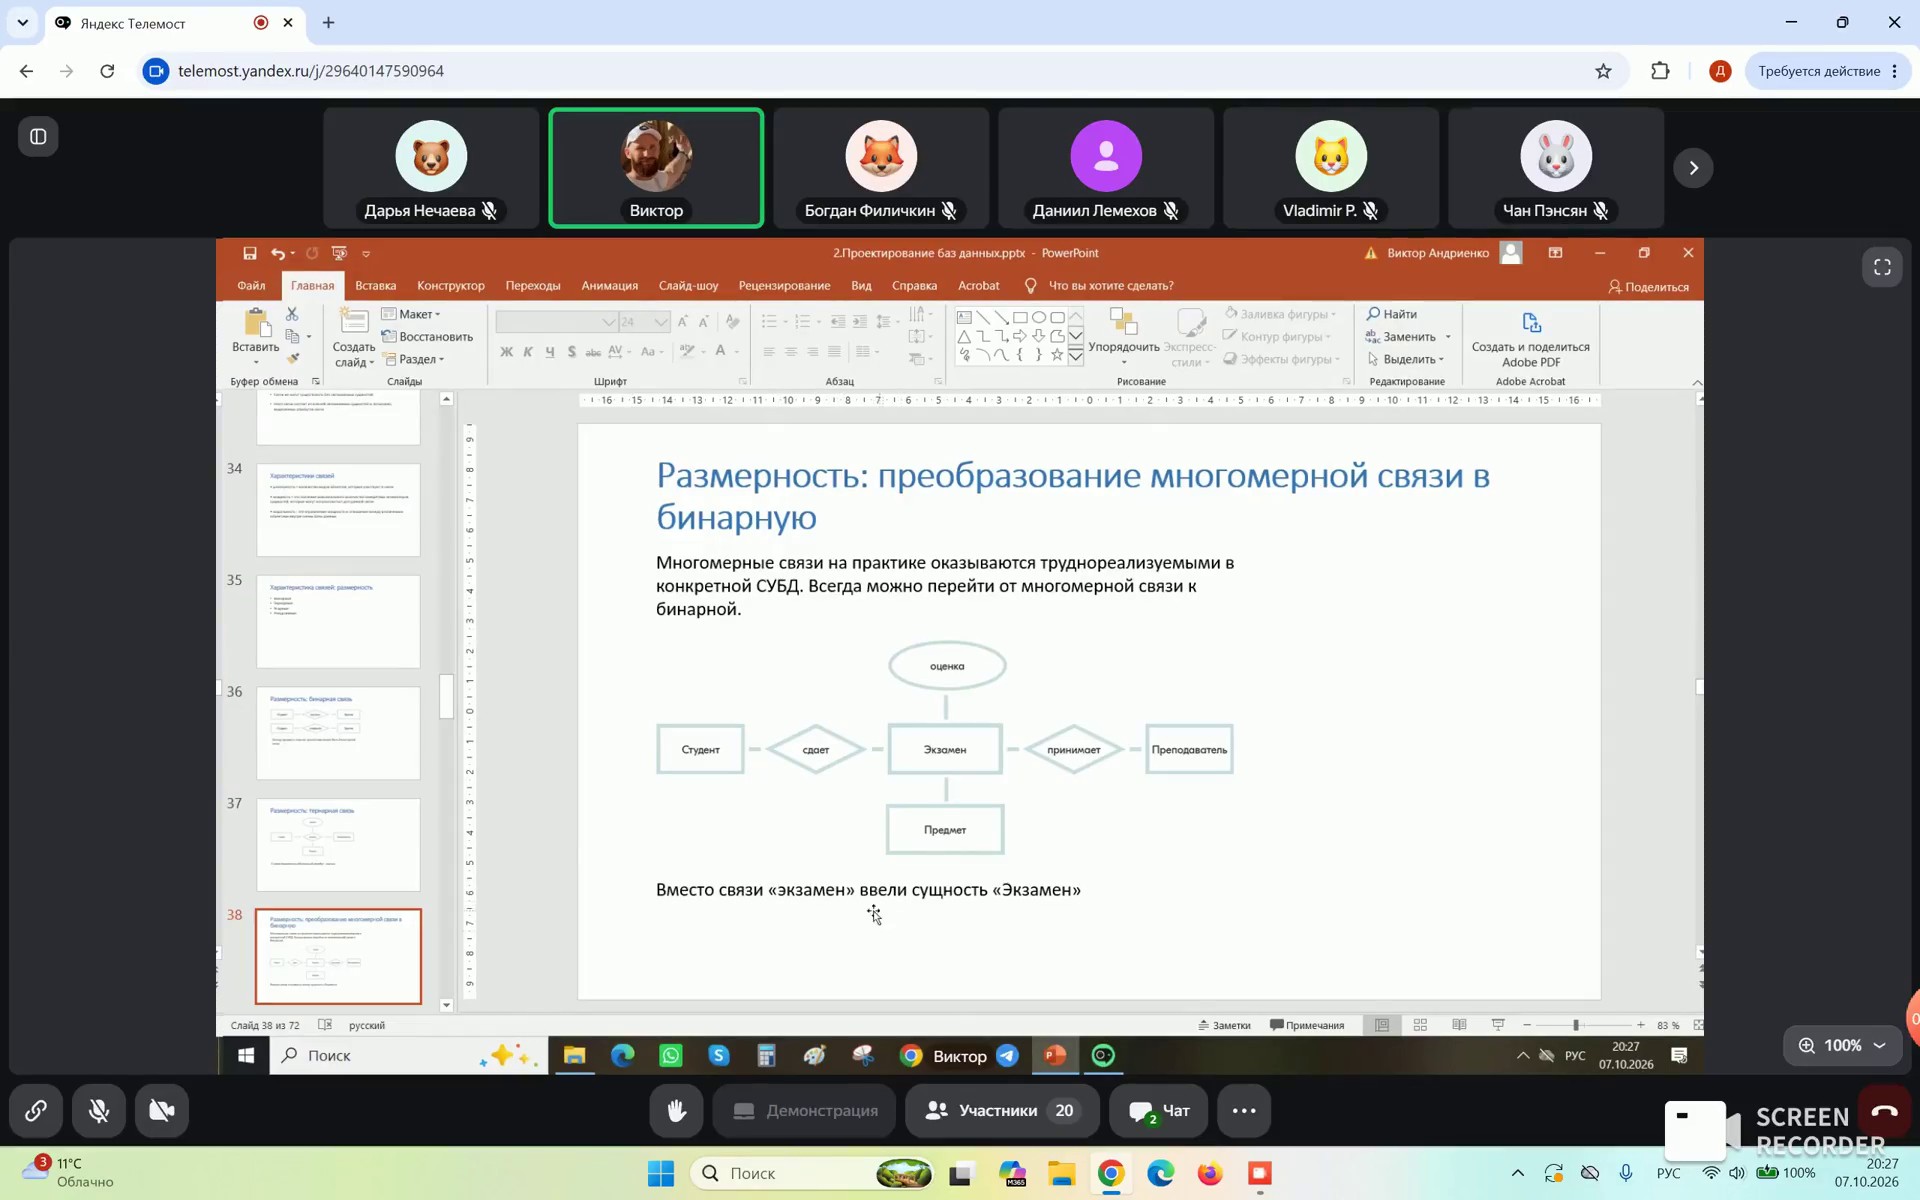
На практике многомерные связи оказываются трудно реализуемы в конкретной СУБД, но всегда можно перейти от многомерной связи к бинарной связи. Вместо связи «экзамен» здесь мы вводим сущность «экзамен». То есть что у нас получается? Студент связан с экзаменом тем, что студент сдаёт экзамен — это наша связь. Экзамен и преподаватель связаны друг с другом связью «принимает» (преподаватель принимает экзамен). И, соответственно, здесь же выражается атрибут «оценка». И экзамен, естественно, у нас по какому-то предмету, то есть предмет имеет экзамен (здесь данная связь просто не отображена).
Отступление от темы
В чем здесь рекурсивность? Кто мне подскажет? В чем здесь смысл рекурсивной связи? Сотрудник руководит. В чем здесь суть? Не бойтесь ошибиться, важны ваши мысли. Мы не на экзамене, сейчас оценки я никакие не ставлю за неправильные ответы. И за правильные тоже. В чем здесь суть рекурсивной связи? Есть какие-то мысли у кого-то? Смотрите, среди множества сотрудников может быть сотрудник, который является руководителем, но он же при этом не перестает быть сотрудником. Получается, что этот сотрудник, у него есть связь «руководитель». Правильно? Вот один из примеров рекурсивной связи.
Модальности связи. Модальность может...
Размерность, модальность и полнота связей
Модальность связи может означать, что экземпляр сущности A может быть связан с одним или несколькими экземплярами сущности B, а может быть и не связан ни с одним экземпляром. Более сильная модальность «должен» означает, что экземпляр сущности A обязан быть связан не менее чем с одним экземпляром сущности B.
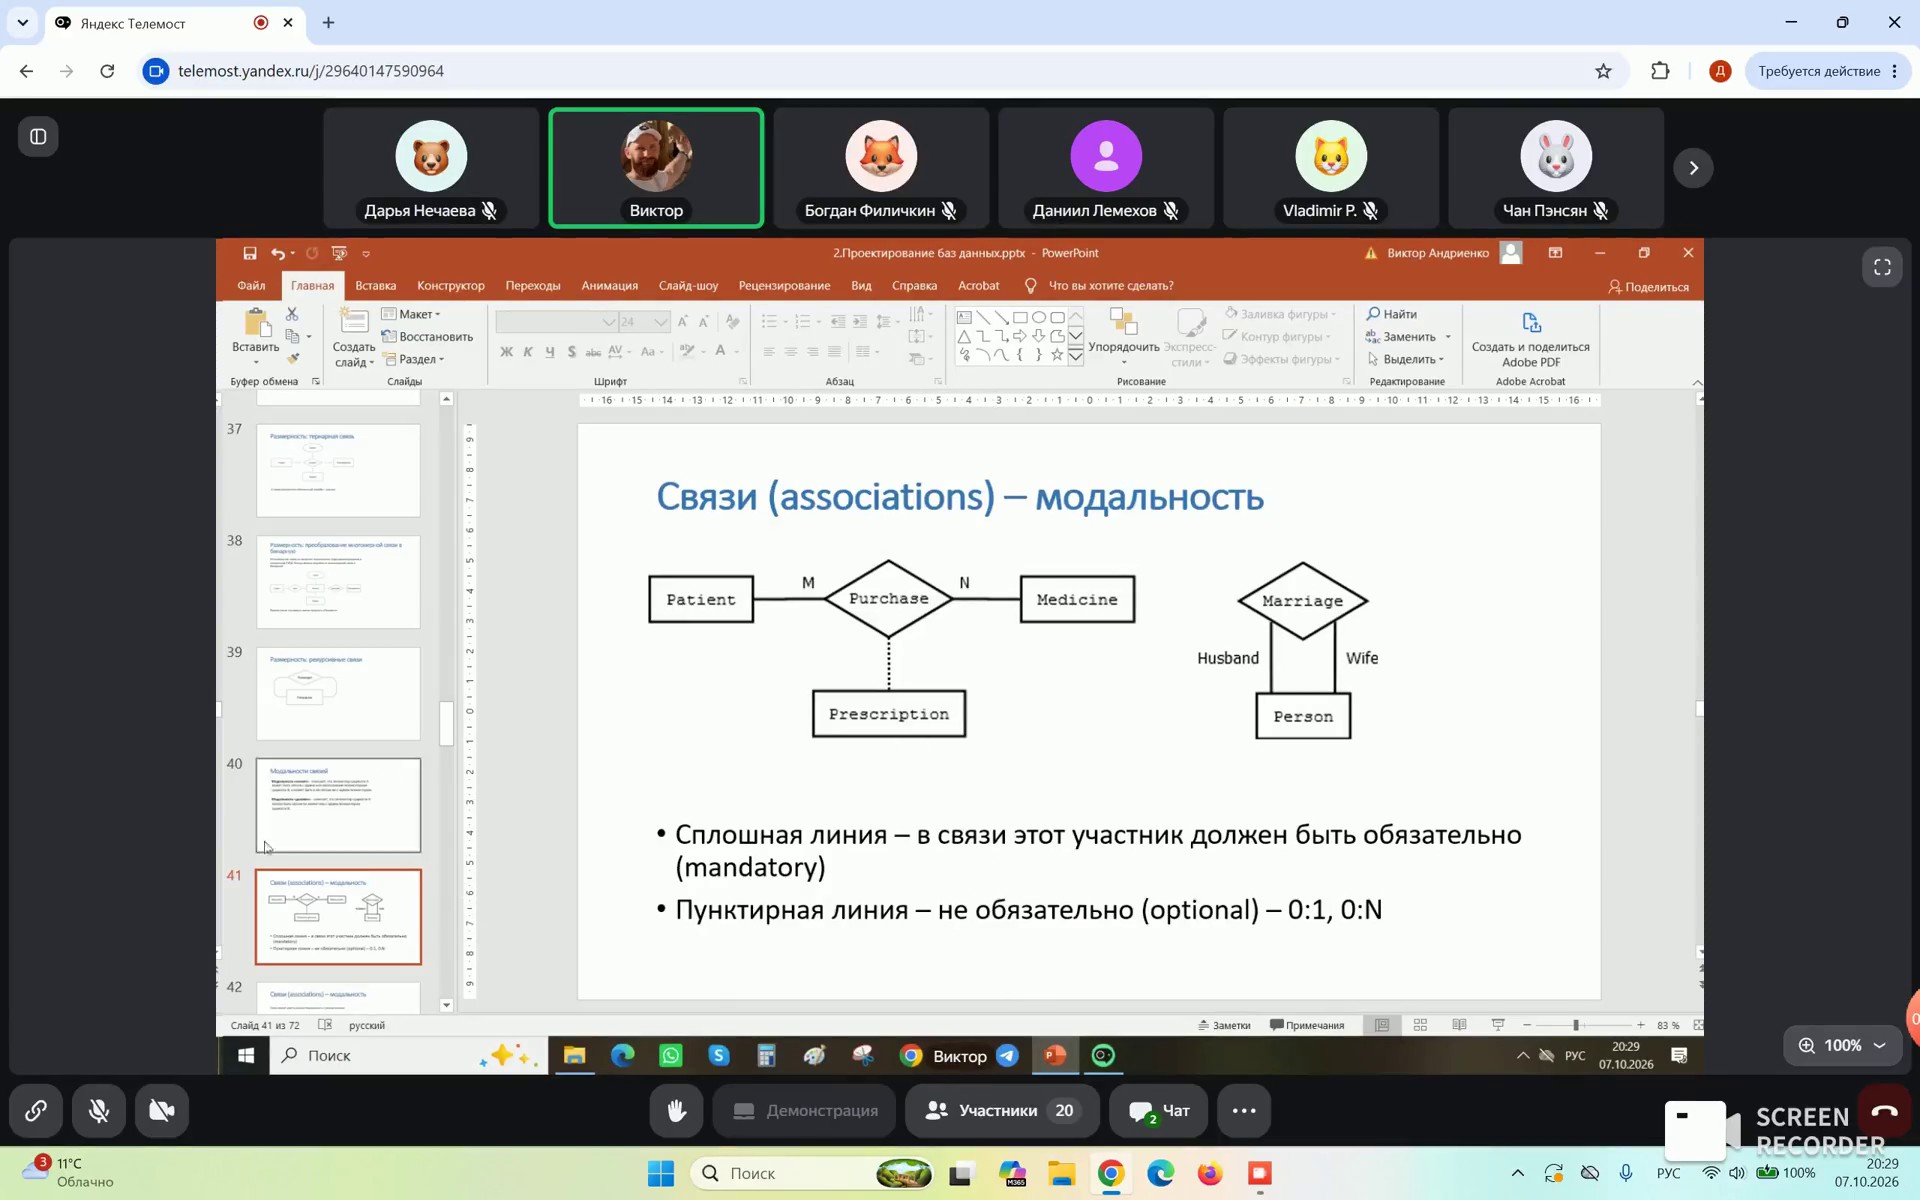
В графическом выражении модальность отображается следующим образом: сплошная линия означает, что участник должен быть обязательно в мандаторе, а пунктирная линия обозначает необязательную связь (optional), то есть функционально связь может быть, а может и не быть. В различных нотациях модальность может показываться по-разному, причём связь может иметь разную модальность с разных концов.
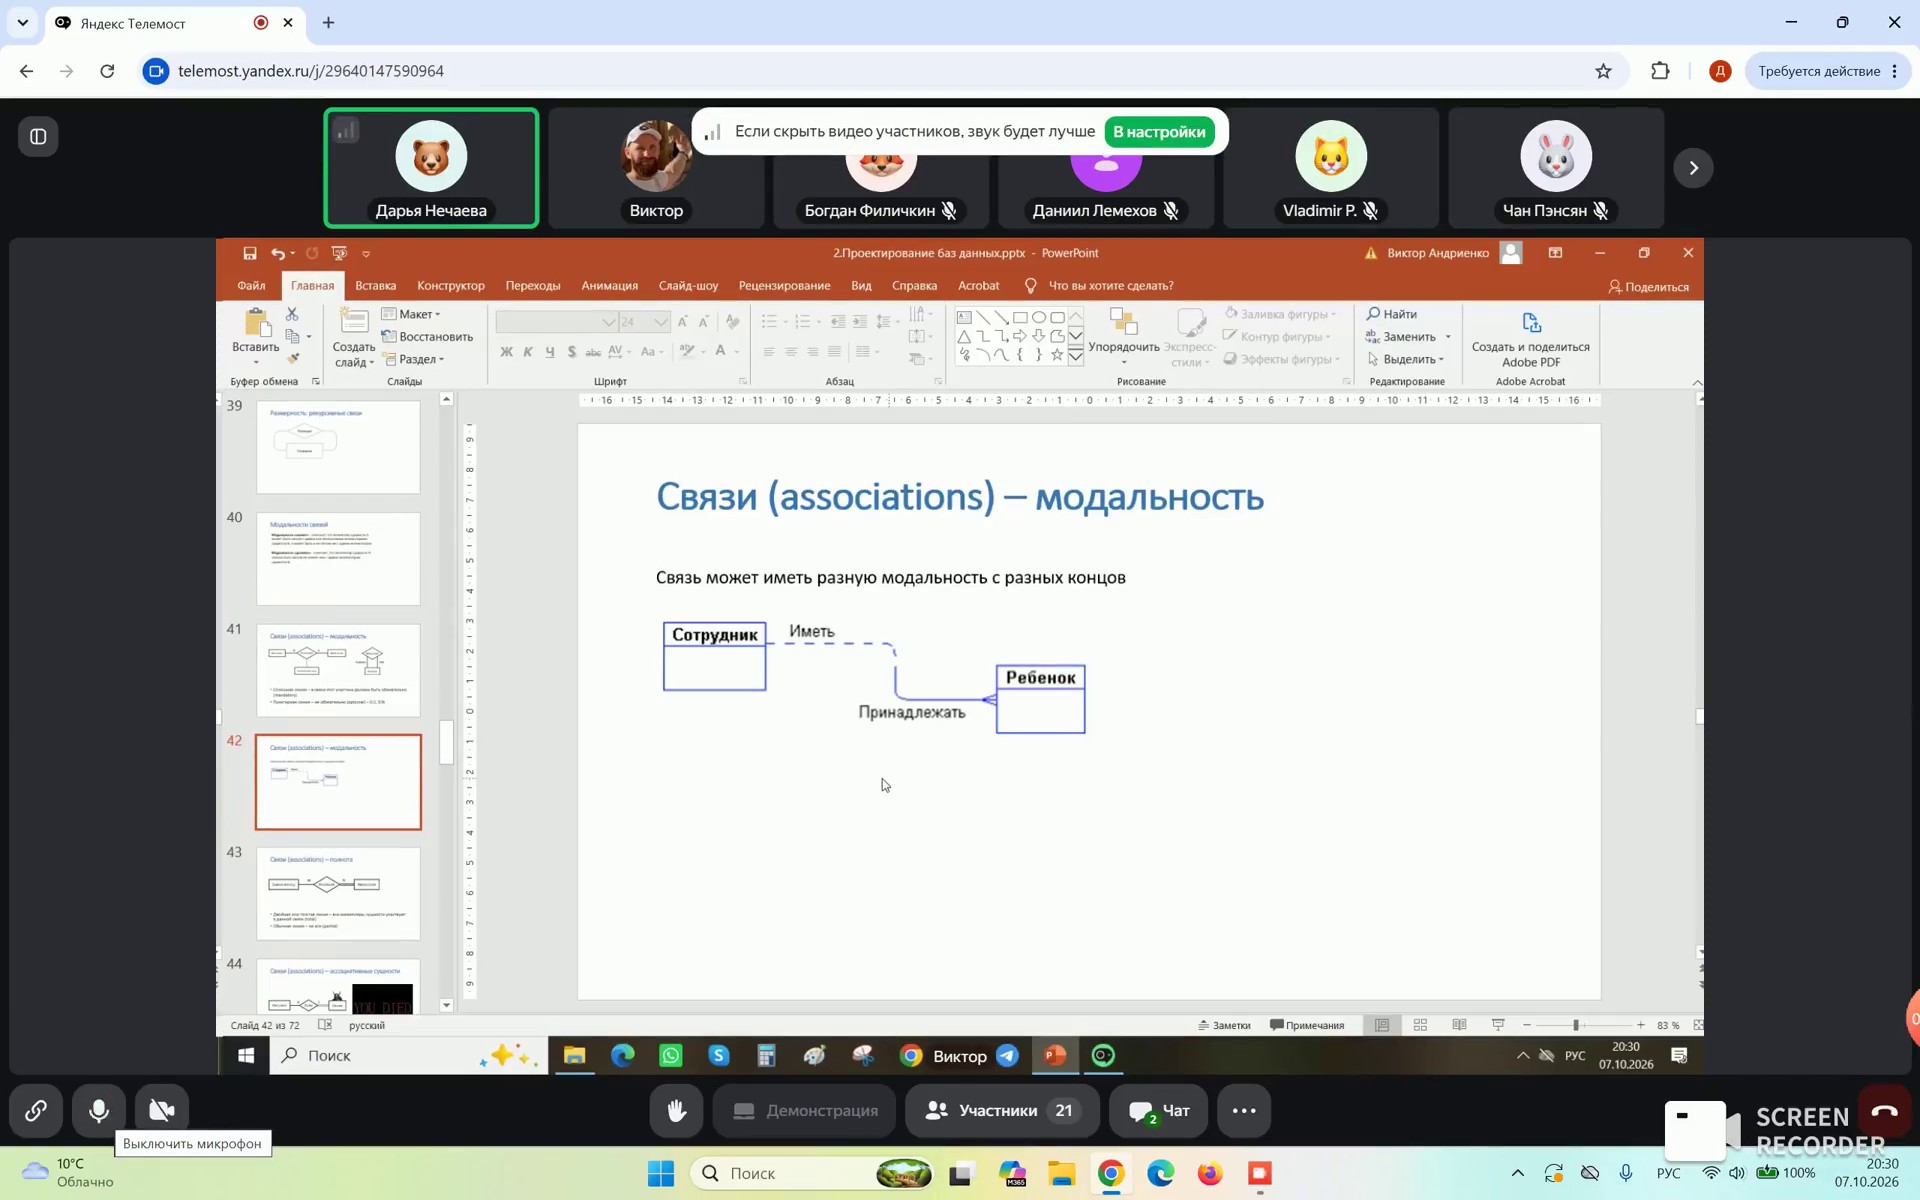
Рассматривая пример взаимодействия между сущностями «сотрудник» и «ребенок» через связи «принадлежать» и «иметь», можно определить их модальность. Ребенок должен принадлежать сотруднику — это обязательная связь, в то время как сотрудник может иметь, а может и не иметь ребенка — это опциональная связь.
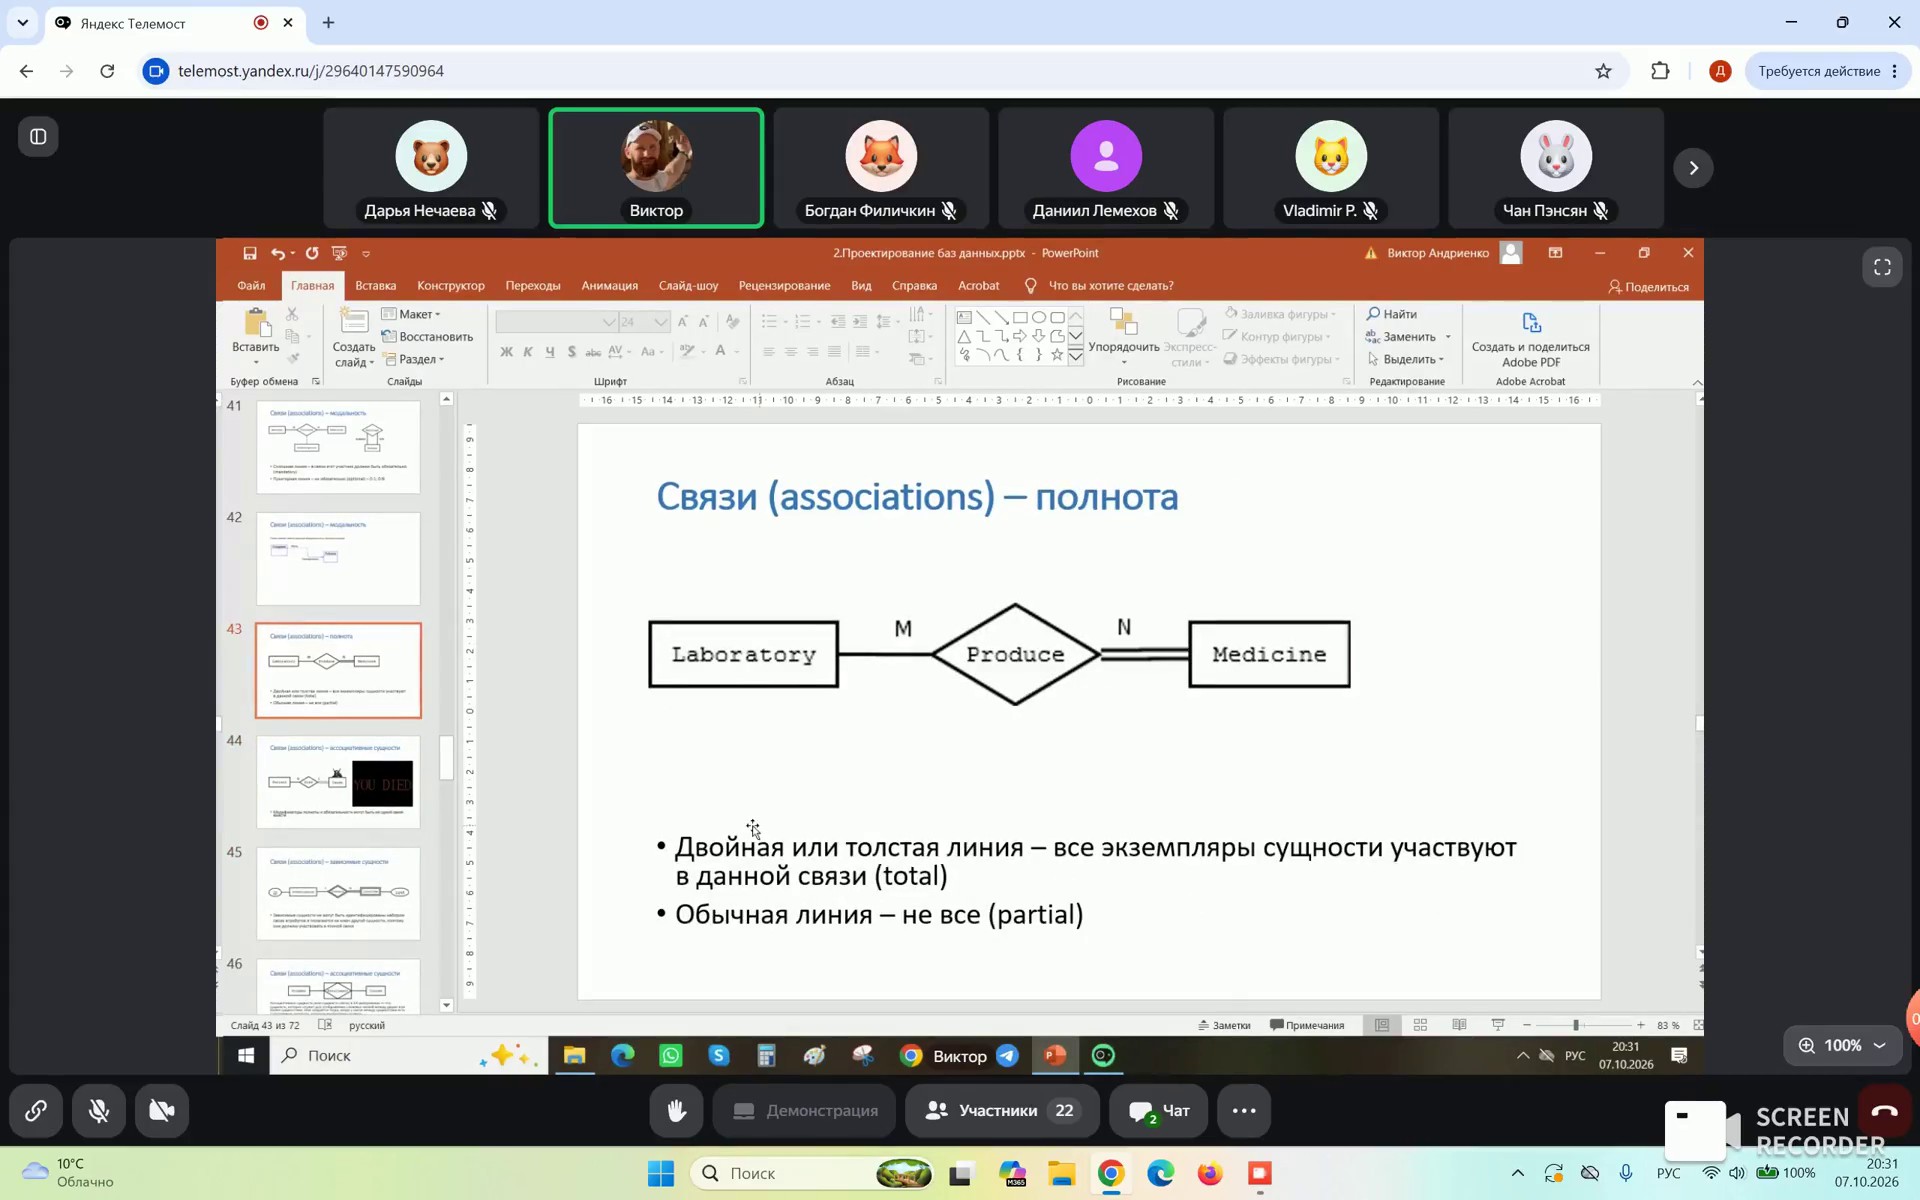
Далее рассматривается полнота связей. Двойная или толстая линия означает, что все экземпляры сущности участвуют в данной связи. Соответственно, обычная линия означает, что в связи участвуют не все экземпляры. В качестве примера разбирается ситуация, где все лекарства являются той или иной продукцией, но при этом не в каждой лаборатории может производиться та или иная продукция.
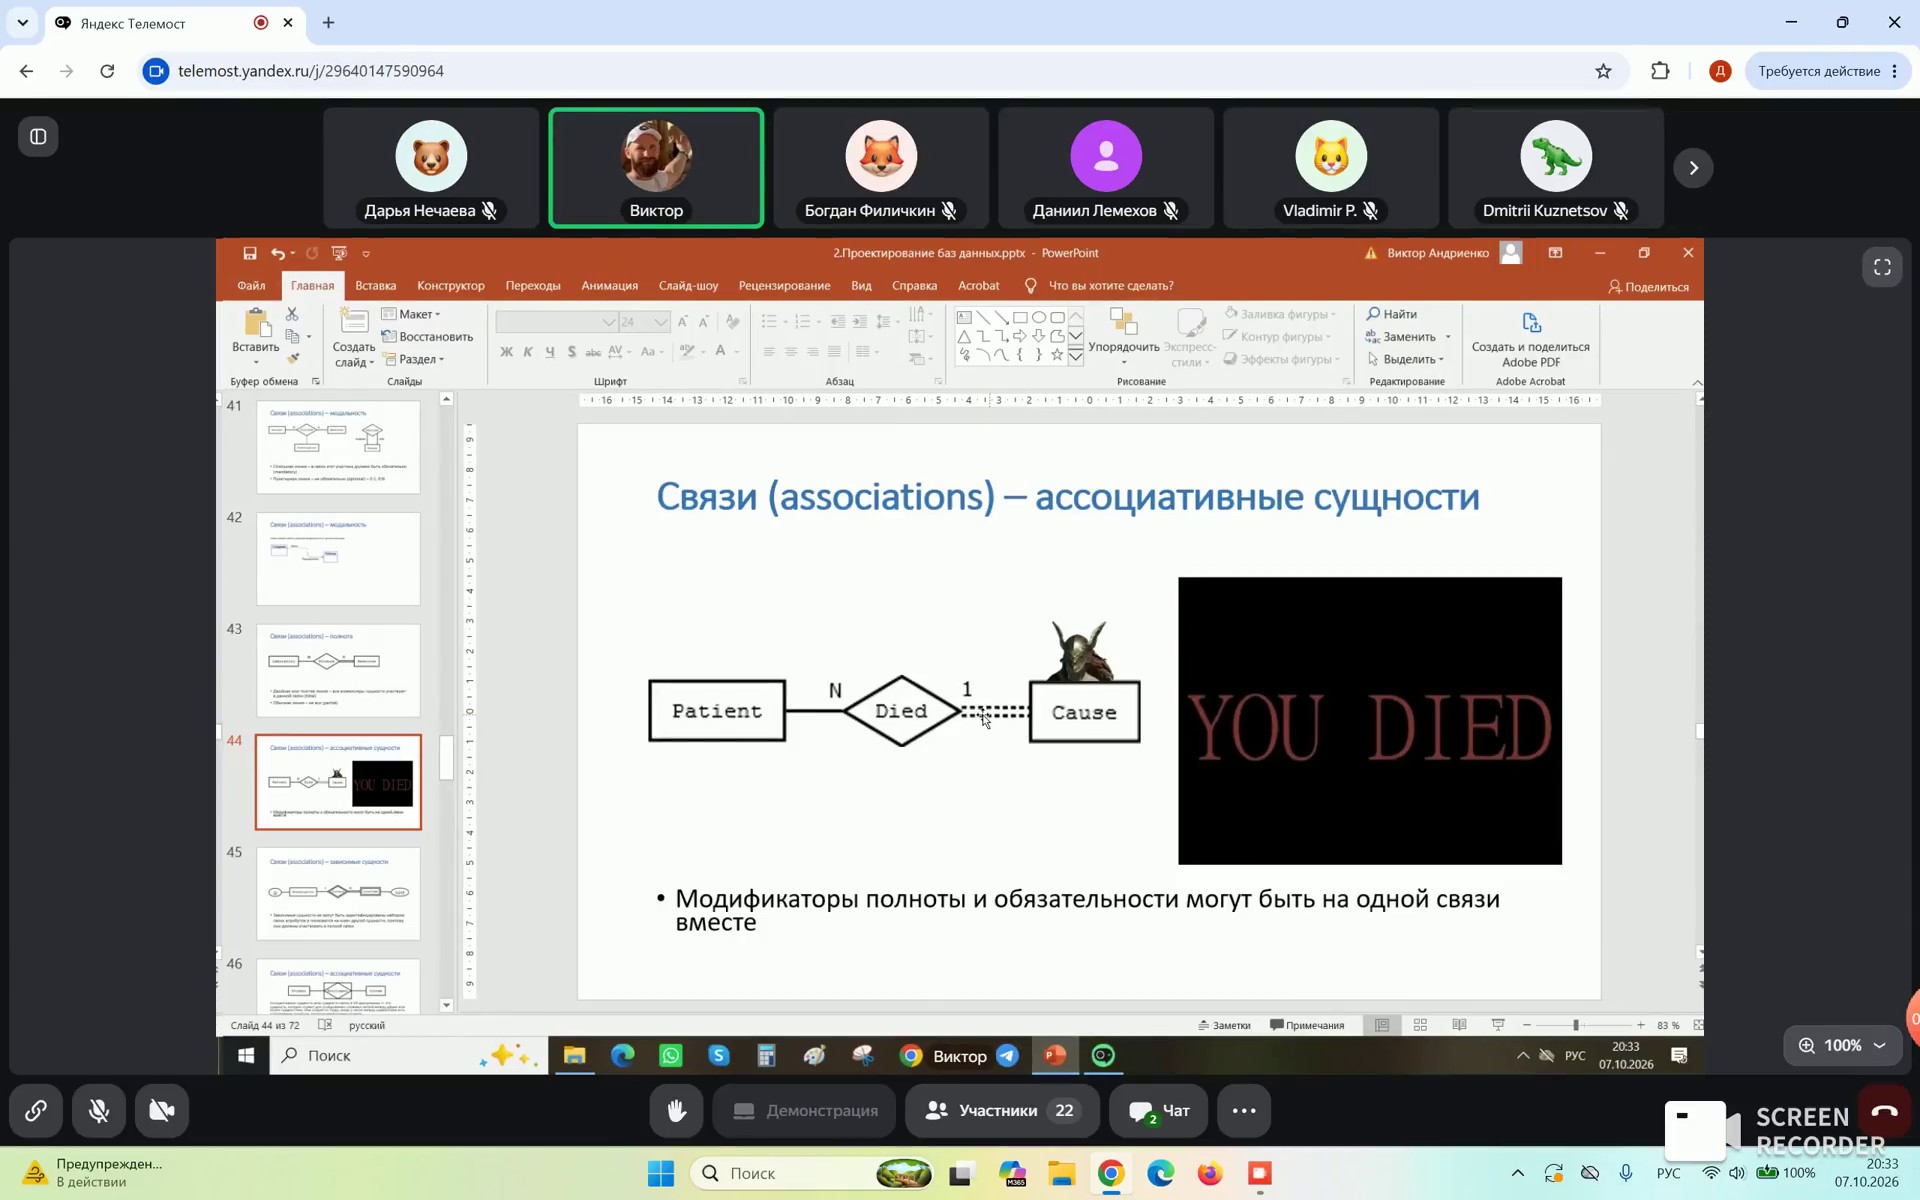
Модификаторы полноты и обязательности могут присутствовать на одной связи вместе. Анализируя пример с пунктирными линиями в контексте определенной схемы, лектор со студентами обсуждает понятие модальности («может» или «не должен») на примере сущностей «пациент» и «причина» (в контексте того, что пациент может быть мертв, и если он мертв, то для этого есть определенная причина).
Зависимые и ассоциативные сущности
Модификаторы полноты и обязательности могут быть на одной связи вместе, выражая соответствующее состояние: может быть, а может не быть.
Зависимые сущности — это сущности, которые не могут быть идентифицированы набором своих атрибутов и полагаются на ключ другой сущности, поэтому они должны участвовать в полной связи. Если у нас есть какие-то зависимые сущности, конечно же, они полагаются на ключ другой сущности. Когда мы их хотим идентифицировать, мы их идентифицируем через ключ вот этой сущности, от которой они зависят.
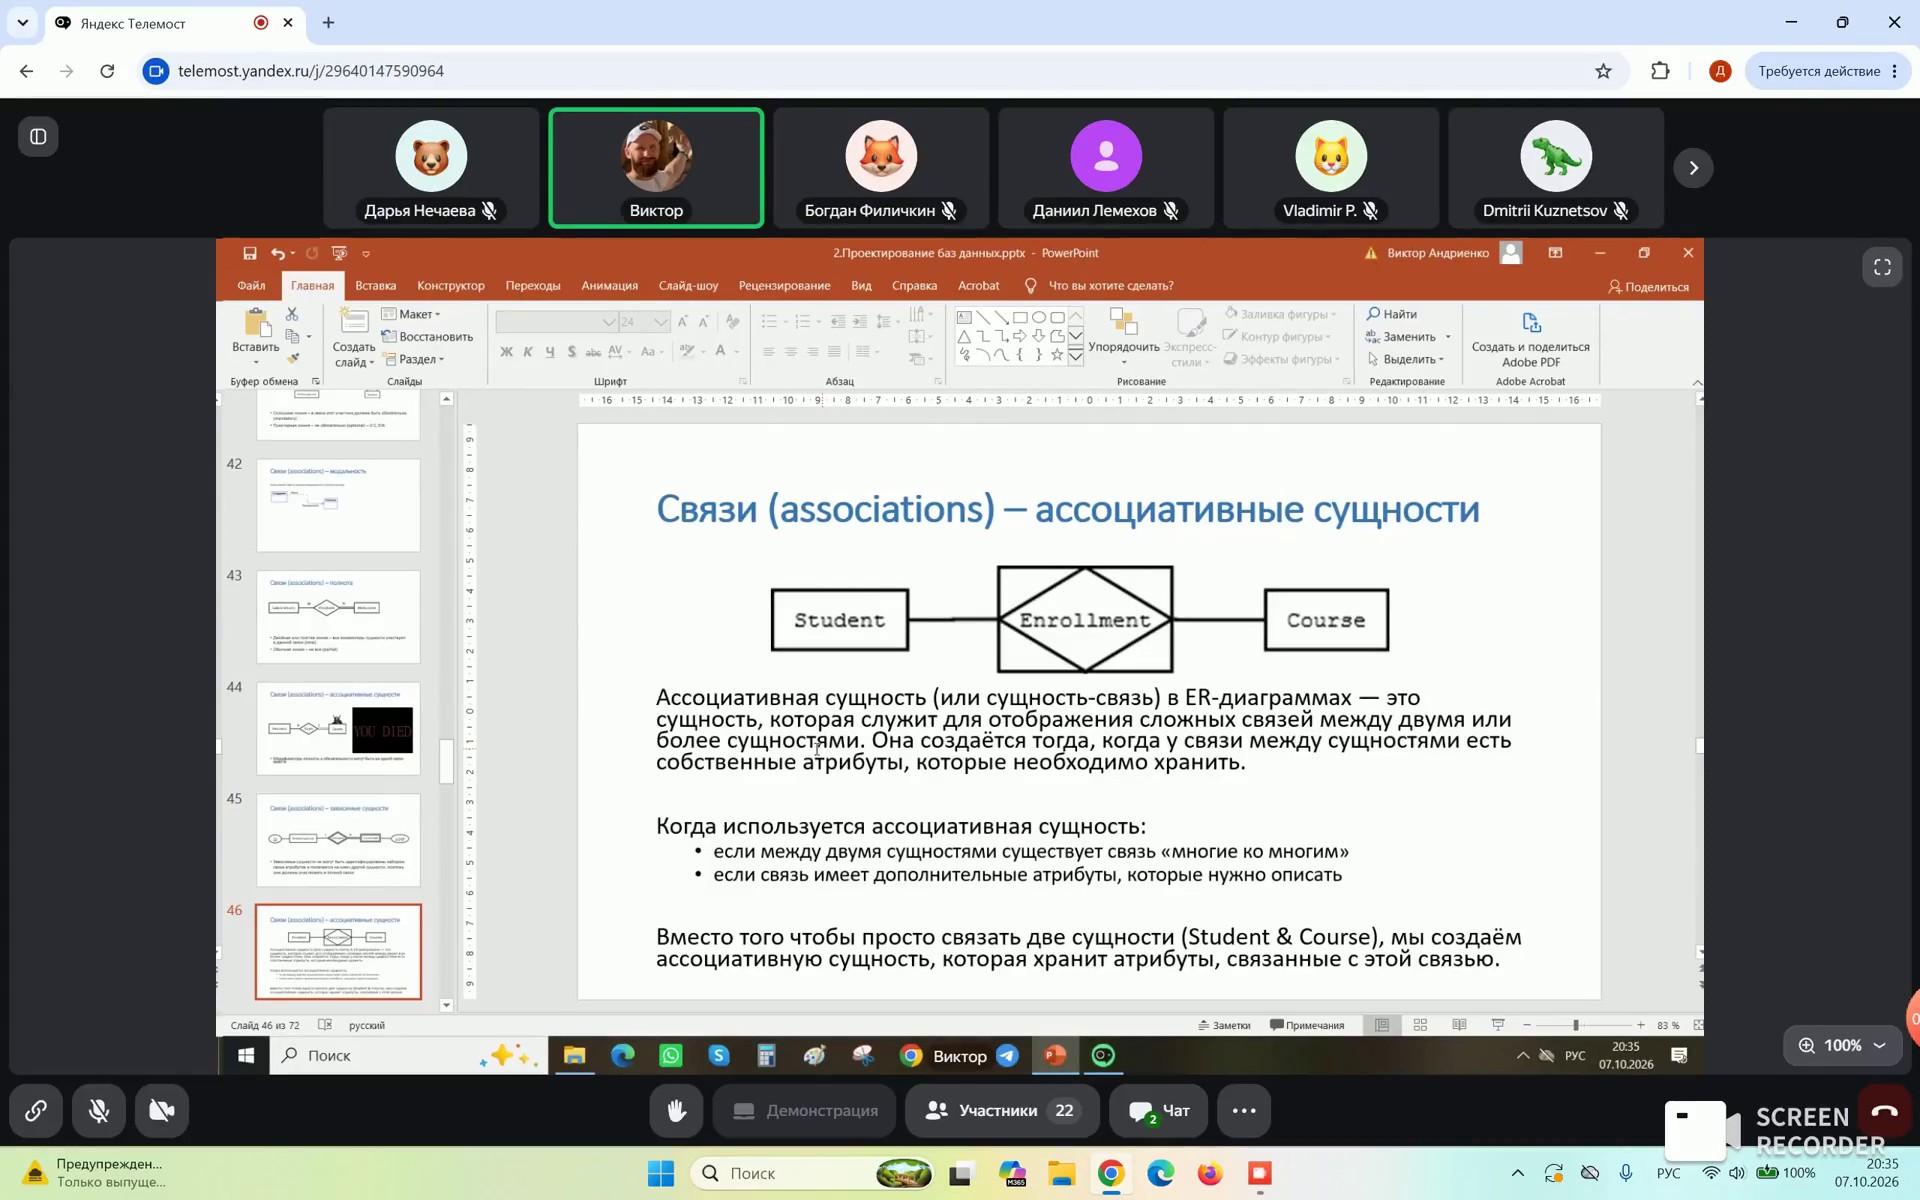
Ассоциативные сущности (или сущность связи в ER-диаграммах) — это сущность, которая служит для отображения сложных связей между двумя или более сущностями. Она создается тогда, когда у связи между сущностями есть собственные атрибуты, которые необходимо хранить. Ассоциативная сущность используется, если между двумя сущностями существует связь многие ко многим, и если связь имеет дополнительные атрибуты, которые нужно описать. Как мы видим хотя бы даже из этого примера, многие ко многим не есть хорошо, потому что у нас могут появляться различные ассоциативные сущности.
Отступление от темы
Конечно же, давайте сам расскажу, не буду вас больше мучить своими вопросами.
Слева у нас студент, справа у нас сущность курс, и между ними есть ассоциативная сущность запись на курс. У нас может быть просто связь, что студент проходит какой-то курс. Но в чем смысл введения вот этой ассоциативной сущности? В том, что у данной связи (студент проходит курс) могут быть какие-то дополнительные характеристики, которые надо как-то отражать, то есть, собственно, атрибуты. Это может быть, например, дата записи на курс. Что это еще может быть? Это может быть статус курса, активен он или, например, давно завершился. Это может быть оценка по курсу, если она важна. Поэтому здесь связь у нас превращается в ассоциативную сущность отдельную, и, соответственно, эта связь уже начинает жить своей жизнью, или что-либо повышается в статусе с точки зрения ER-модели. Вместо того, чтобы просто связать две сущности, мы создаем ассоциативную связь, которая хранит атрибуты, связанные с этой связью. Вот что мы здесь проговорили.
Шаги при создании ER-диаграммы: определить сущности, определить атрибуты сущности.
Шаги создания, пример и анализ ER-диаграммы
При создании ER-диаграммы выполняются следующие шаги: определение сущностей, определение атрибутов сущности, определение первичных сущностей, определение связей между сущностями, определение мощности (она же кардинальность связей), отрисовка ER-диаграммы и проверка ER-диаграммы на предмет того, удалось ли реализовать ограничения предметной области.
На примере рассматриваемой ER-диаграммы графические элементы обозначают следующие компоненты: прямоугольники — это сущности, эллипсы или овалы — это атрибуты, ромбы — это связи между сущностями. Пунктирная линия указывает на зависимость сущности, что обычно показывается для зависимых сущностей. Каждая стрелочка обозначает направление связи, а если интересует кардинальная связь или мощность связи, тогда можно выражать, откуда что идет.
На данной диаграмме понятно, что студент состоит в какой-то группе, и как уже проговаривалось ранее, один студент может принадлежать только одной группе, но в группе может быть много студентов. Экзамен принимает преподаватель: как правило, один экзамен закреплен за определенным преподавателем, хотя это не строго обязательное правило, но, по крайней мере, за конкретным экзаменом закреплена ответственность преподавателя. При этом преподаватель, конечно же, может принимать много экзаменов и не только какой-то один, то есть связь здесь возникает «один ко многим».
Относительно других сущностей можно провести аналогичные параллели: например, экзамен соответствует какому-то предмету, а у предмета может быть несколько экзаменов. Или, например, студент имеет телефон, и студент вполне может иметь несколько номеров телефона.
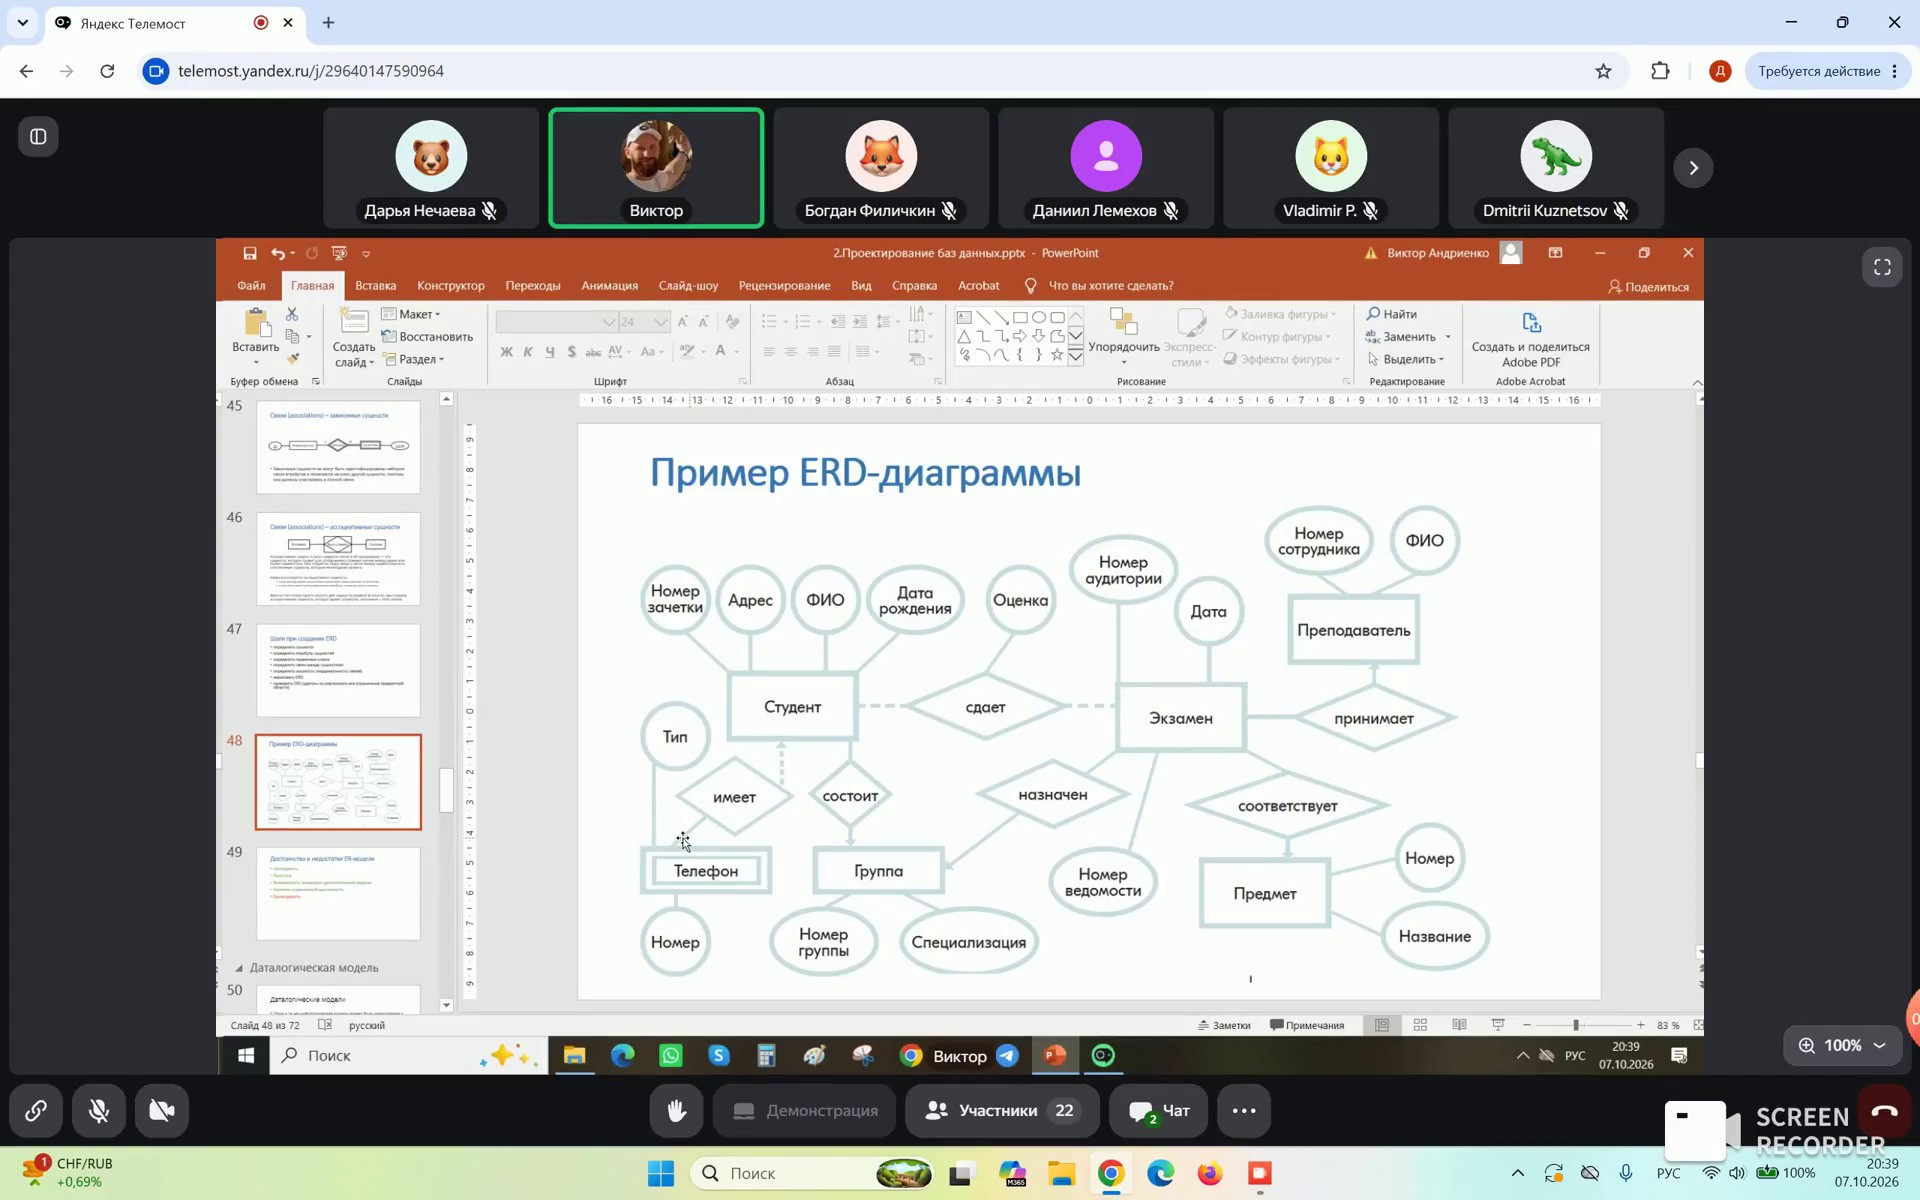
Достоинства ER-диаграмм уже обсуждались ранее, а вот их очевидным недостатком является громоздкость, особенно при моделировании чего-то очень большого. Но в связи с развитием современных программных средств моделирования проблема громоздкости отходит на второй план, потому что можно менять масштаб, выделять различные участки модели и работать с ней таким образом, чтобы проблемы масштаба решались.
Отступление от темы
Так, что-то я заговорился, рассказывая вам про ER-диаграммы. Время уже 20:40, давайте сделаем небольшой перерыв, и после этого продолжим рассказывать про датологическую модель. Перерыв, ну давайте минут 10 сделаем, передохнем и продолжим. Все, перерыв 10 минут.
Датологические модели и основы реляционной модели данных
Датологические модели и основы реляционной модели данных
Переходим к датологической модели. Одна и та же инфологическая модель может быть реализована с помощью различных датологических моделей. Исторически выделялись три основные датологические модели: иерархическая, сетевая и реляционная. В настоящее время иерархическая и сетевая модели практически не применяются в чистом виде для современных систем управления базами данных, за исключением узкоспециализированных областей, хотя иерархическая структура востребована для форматов XML и JSON.
Иерархическая модель
Иерархическая модель была изобретена в 60-х годах XX века корпорацией IBM (в рамках проекта System/360). Данные в этой модели представляли собой записи с атрибутами, связанными с другими записями отношениями «один ко многим», в результате чего естественным образом образовывалась древовидная структура.
Нюансы и характеристики иерархической модели:
- Данные организованы в виде древовидной структуры.
- Модель была востребованной, но не гибкой.
- Каждая запись могла иметь только одного предка, даже если отдельные записи могли иметь несколько потомков.
- Первая иерархическая СУБД называлась IMS (от IBM).
Сетевая модель
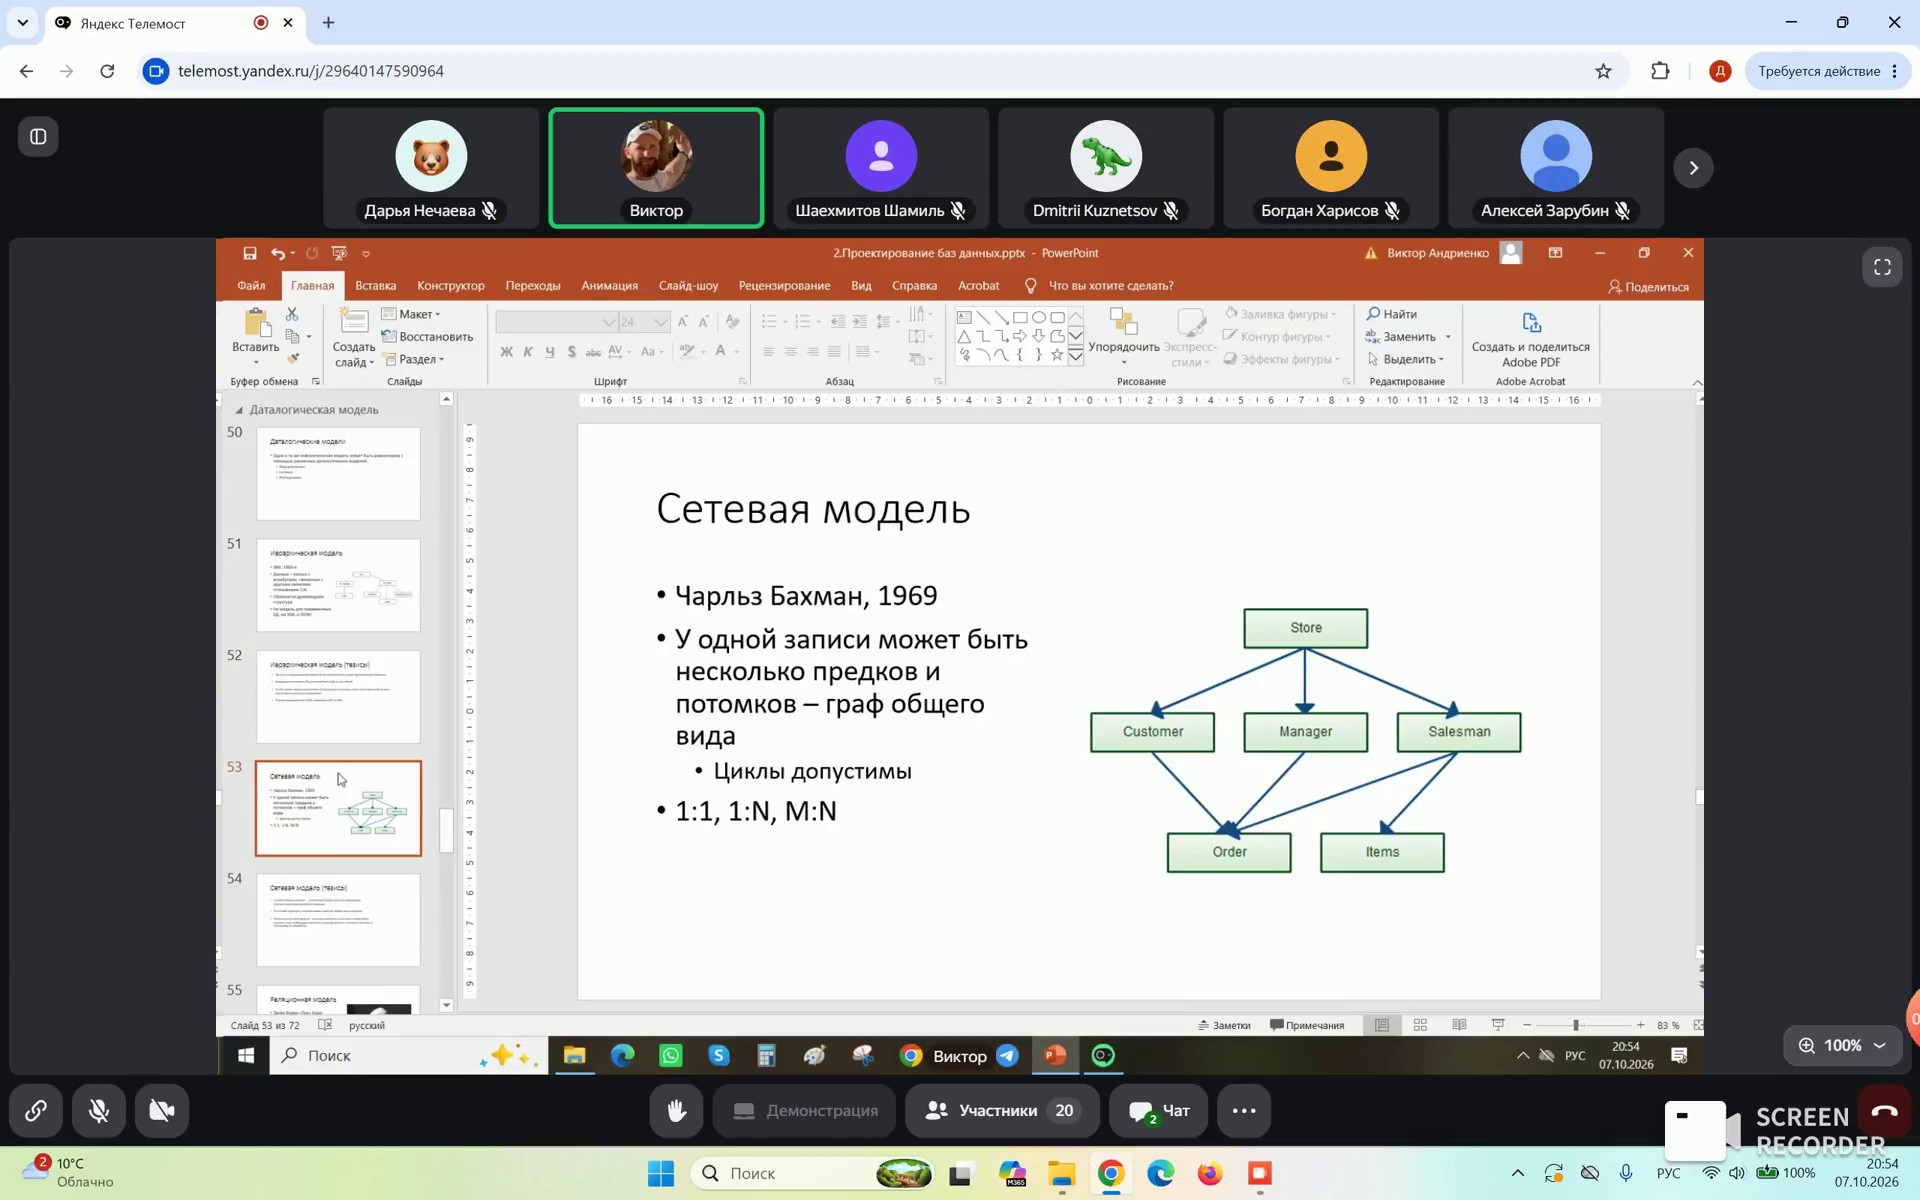
Еще одним видом логической модели является сетевая модель, которую разработал Чарльз Бахман в 1969 году. В сетевой модели у одной записи уже может быть несколько предков и потомков, благодаря чему получается граф общего вида, который может быть цикличным. Поддерживались типы связей «один к одному», «один ко многим» и «многие ко многим». Сетевая модель была более гибкой, чем иерархическая, но все еще не удовлетворяла всем пожеланиям разработчиков.
Тезисы сетевой модели данных:
- Это логическая модель данных, являющаяся расширением иерархического подхода в основном за счет того, что у потомка может быть несколько предков (любое число предков).
- Недостатком сетевой модели являлась высокая сложность и жесткость схемы базы данных. Если необходимо изменить структуру данных, то нужно изменить и программу ее обработки. Это создает жесткую зависимость между концептом (абстракцией) и реализацией, к которой не стремятся в современных системах.
Реляционная модель
На рубеже 1969–1970 годов в своей статье «Relational Model of Data for Large Shared Data Banks» Эдгар Франк Кодд (по прозвищу Тед Кодд) изложил основные концепты и идеи реляционной модели баз данных, предложив революционную модель. Большинство современных СУБД используют реляционную модель с различными вариациями и изменениями, но фундамент и основа остались такими же, какими их придумал Эдгар Кодд.
Реляционная модель определяет способ представления данных, структуру данных, методы защиты данных, целостность данных и операции, которые можно выполнять с данными (манипулирование данными, а также различные другие операции, изучаемые в языке SQL во всем его многообразии).
Основные принципы реляционной модели:
- Все данные на концептуальном уровне представляются в виде объектов, заданных в виде строк и столбцов, называемых отношением (в скобках часто синонимично говорят «таблица», хотя между отношением и таблицей есть большая разница). Прежде всего, разница заключается в понимании того, что есть отношение: отношение является математическим объектом, в то время как таблица — это удобное для нас выражение математической модели отношения (реляции).
- В пересечении строки и столбца таблицы можно занести только одно значение — это основной принцип реляционной модели.
- Все операции выполняются над целыми отношениями, и результатом этих операций также являются отношения (любая операция над отношениями приводит к отношениям той же структуры).
Терминология реляционной модели
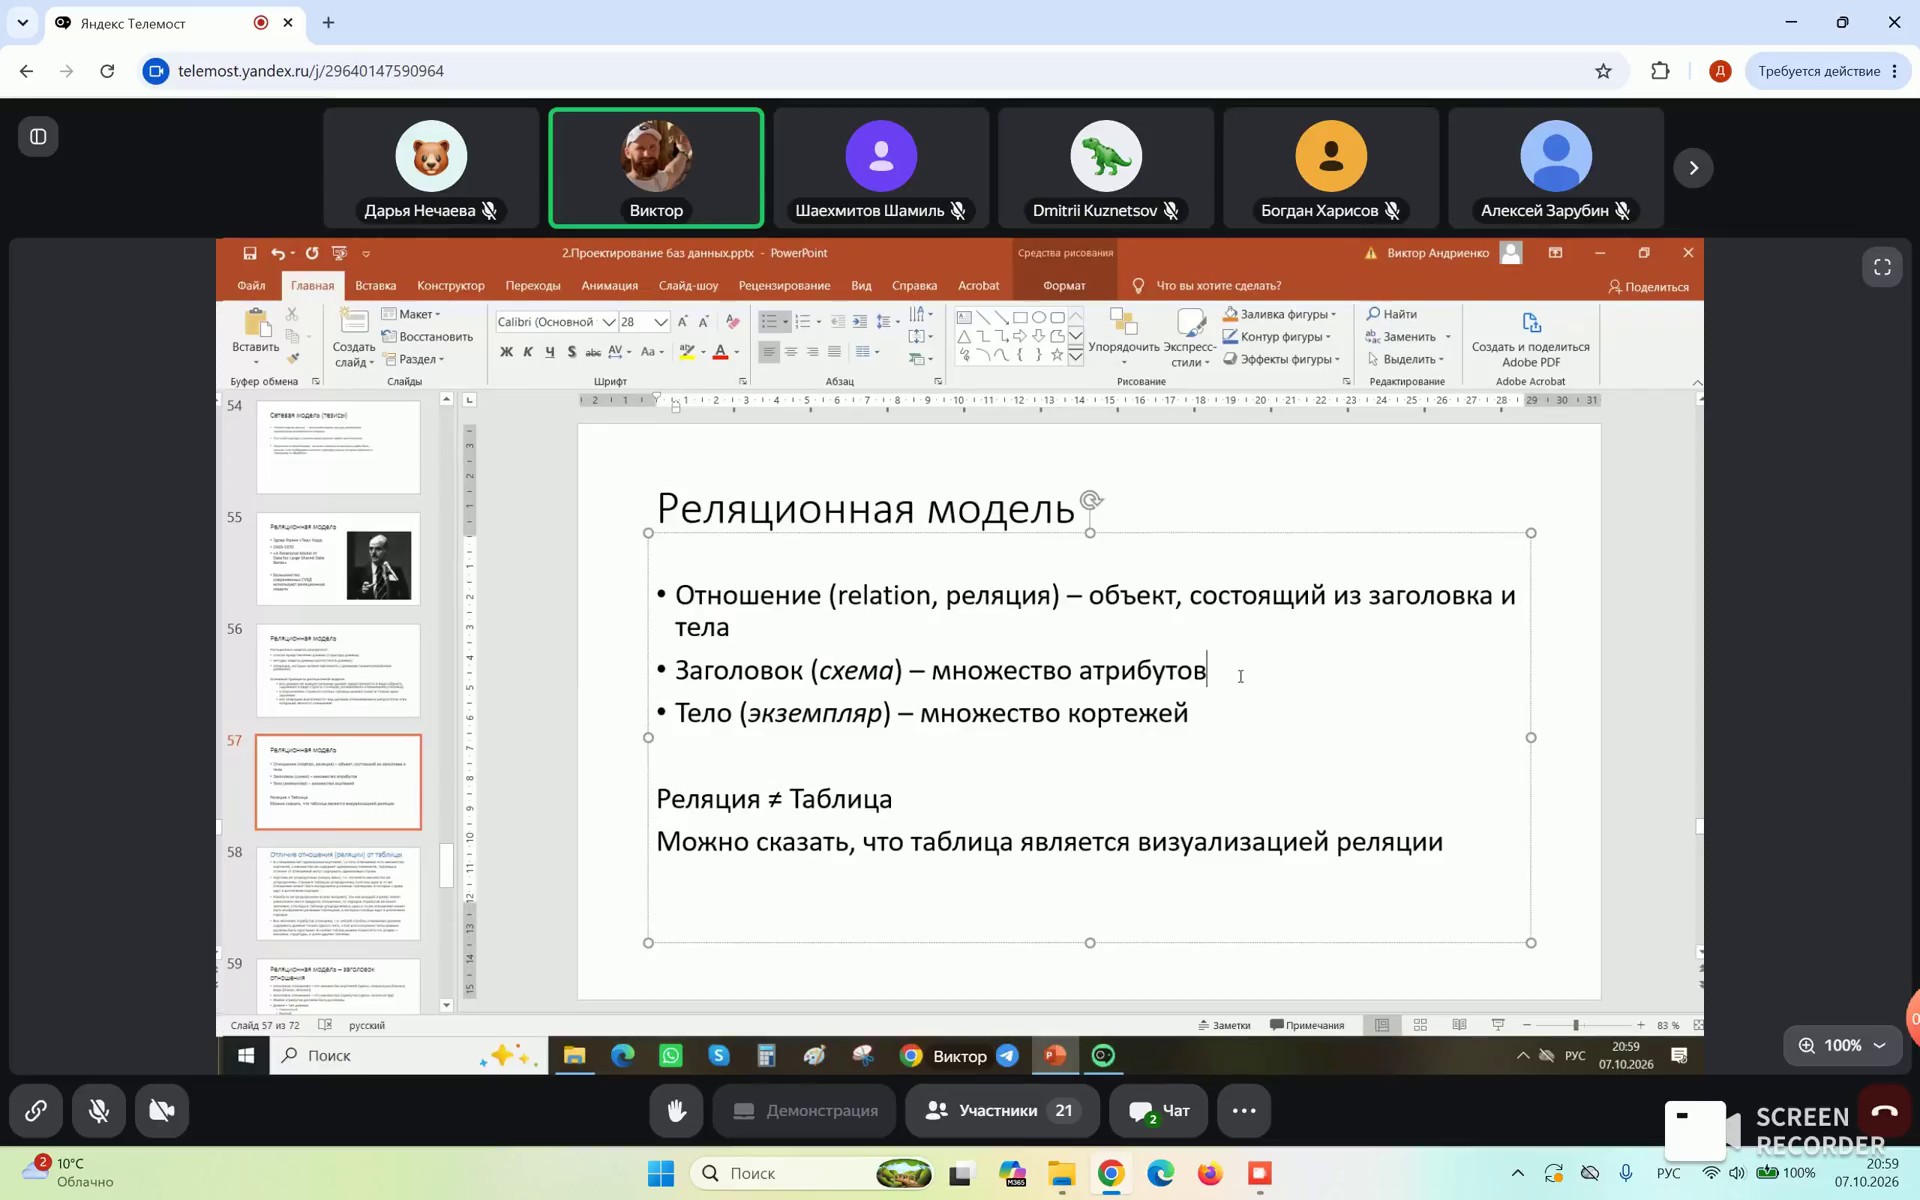
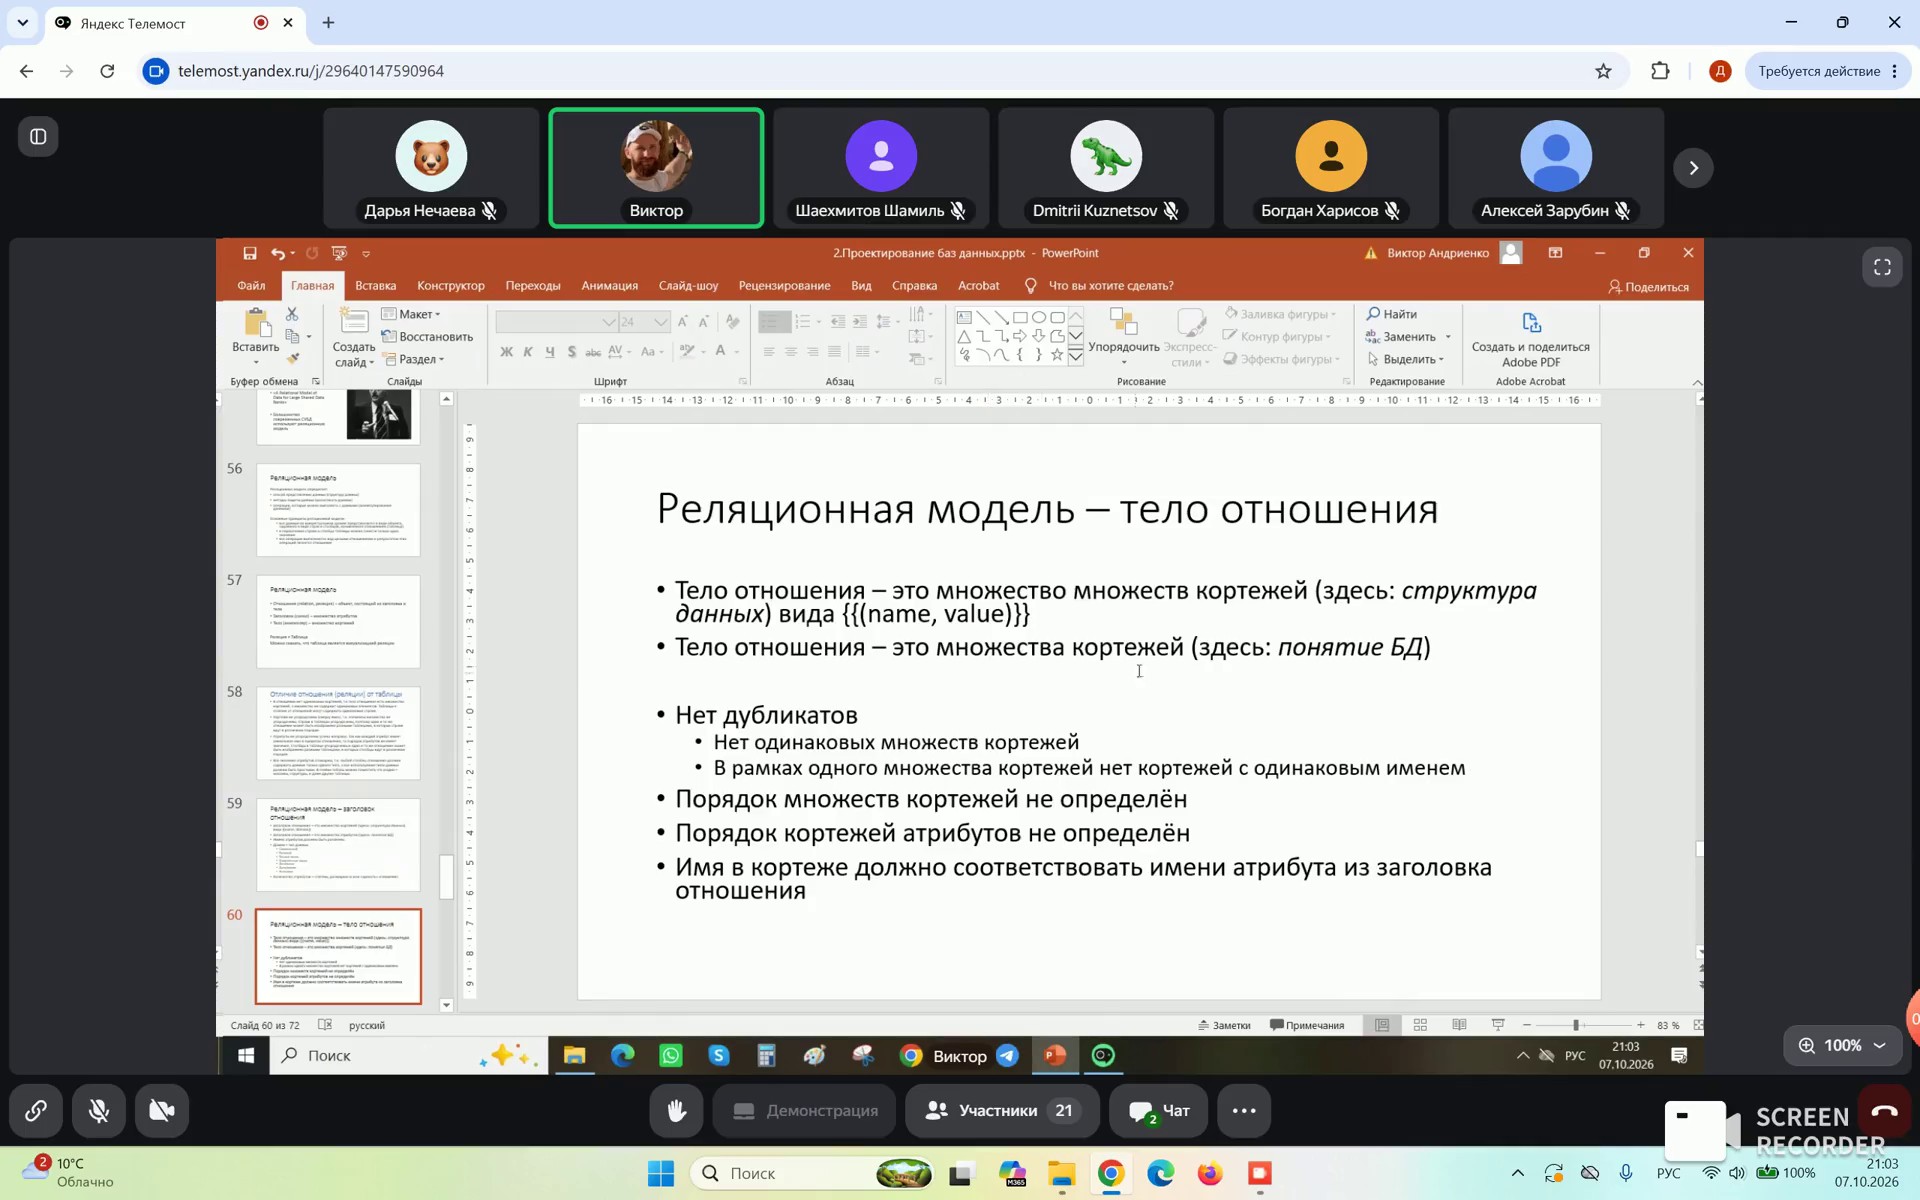
Отношение (либо реляция) — это объект, состоящий из заголовка и тела.
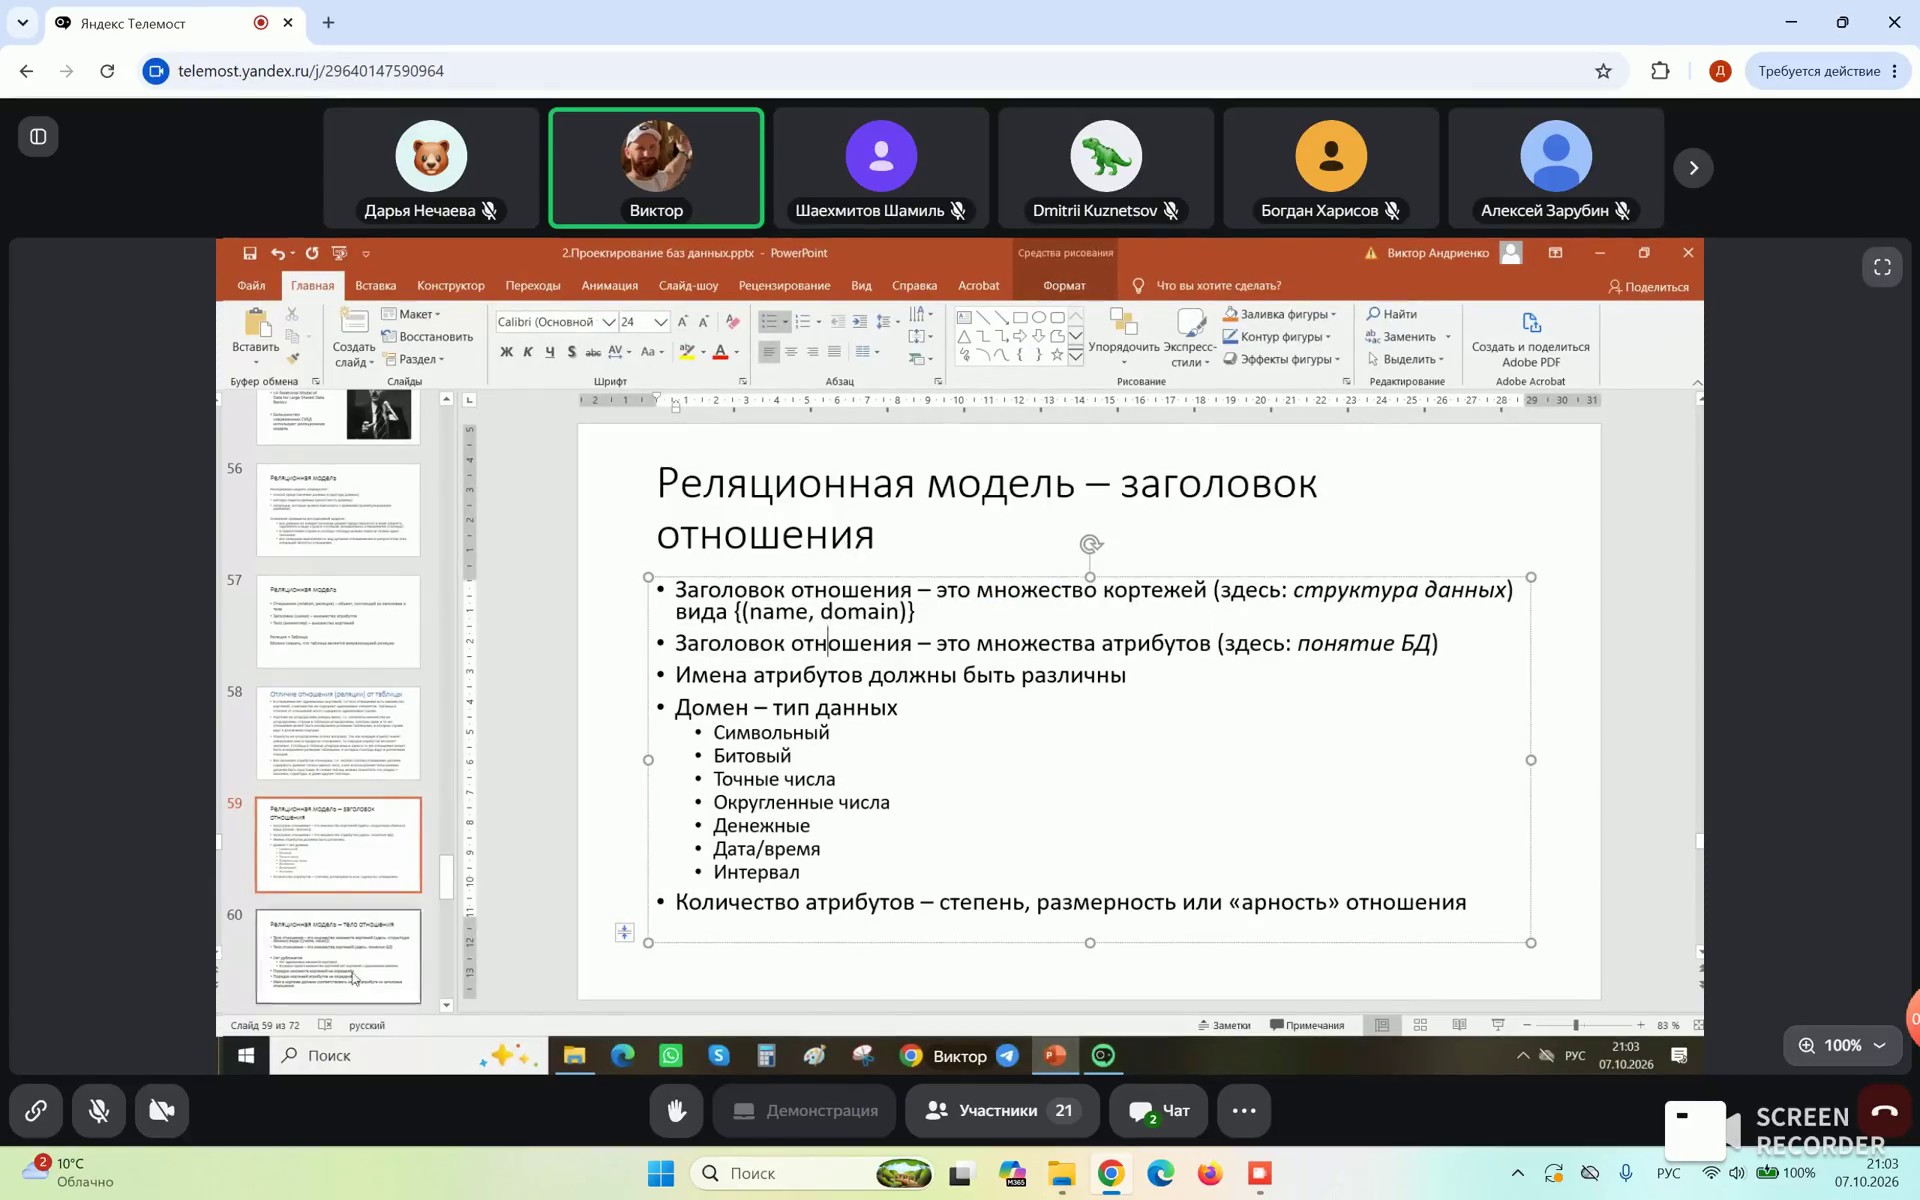
- Заголовок (синонимично со словом схема) — это множество атрибутов. Заголовок — это не название таблички (не название «студенты» или «заказы»), а задание того, какие атрибуты могут быть в данном отношении. Имена атрибутов должны быть различны (не должно быть атрибутов с одинаковым именем).
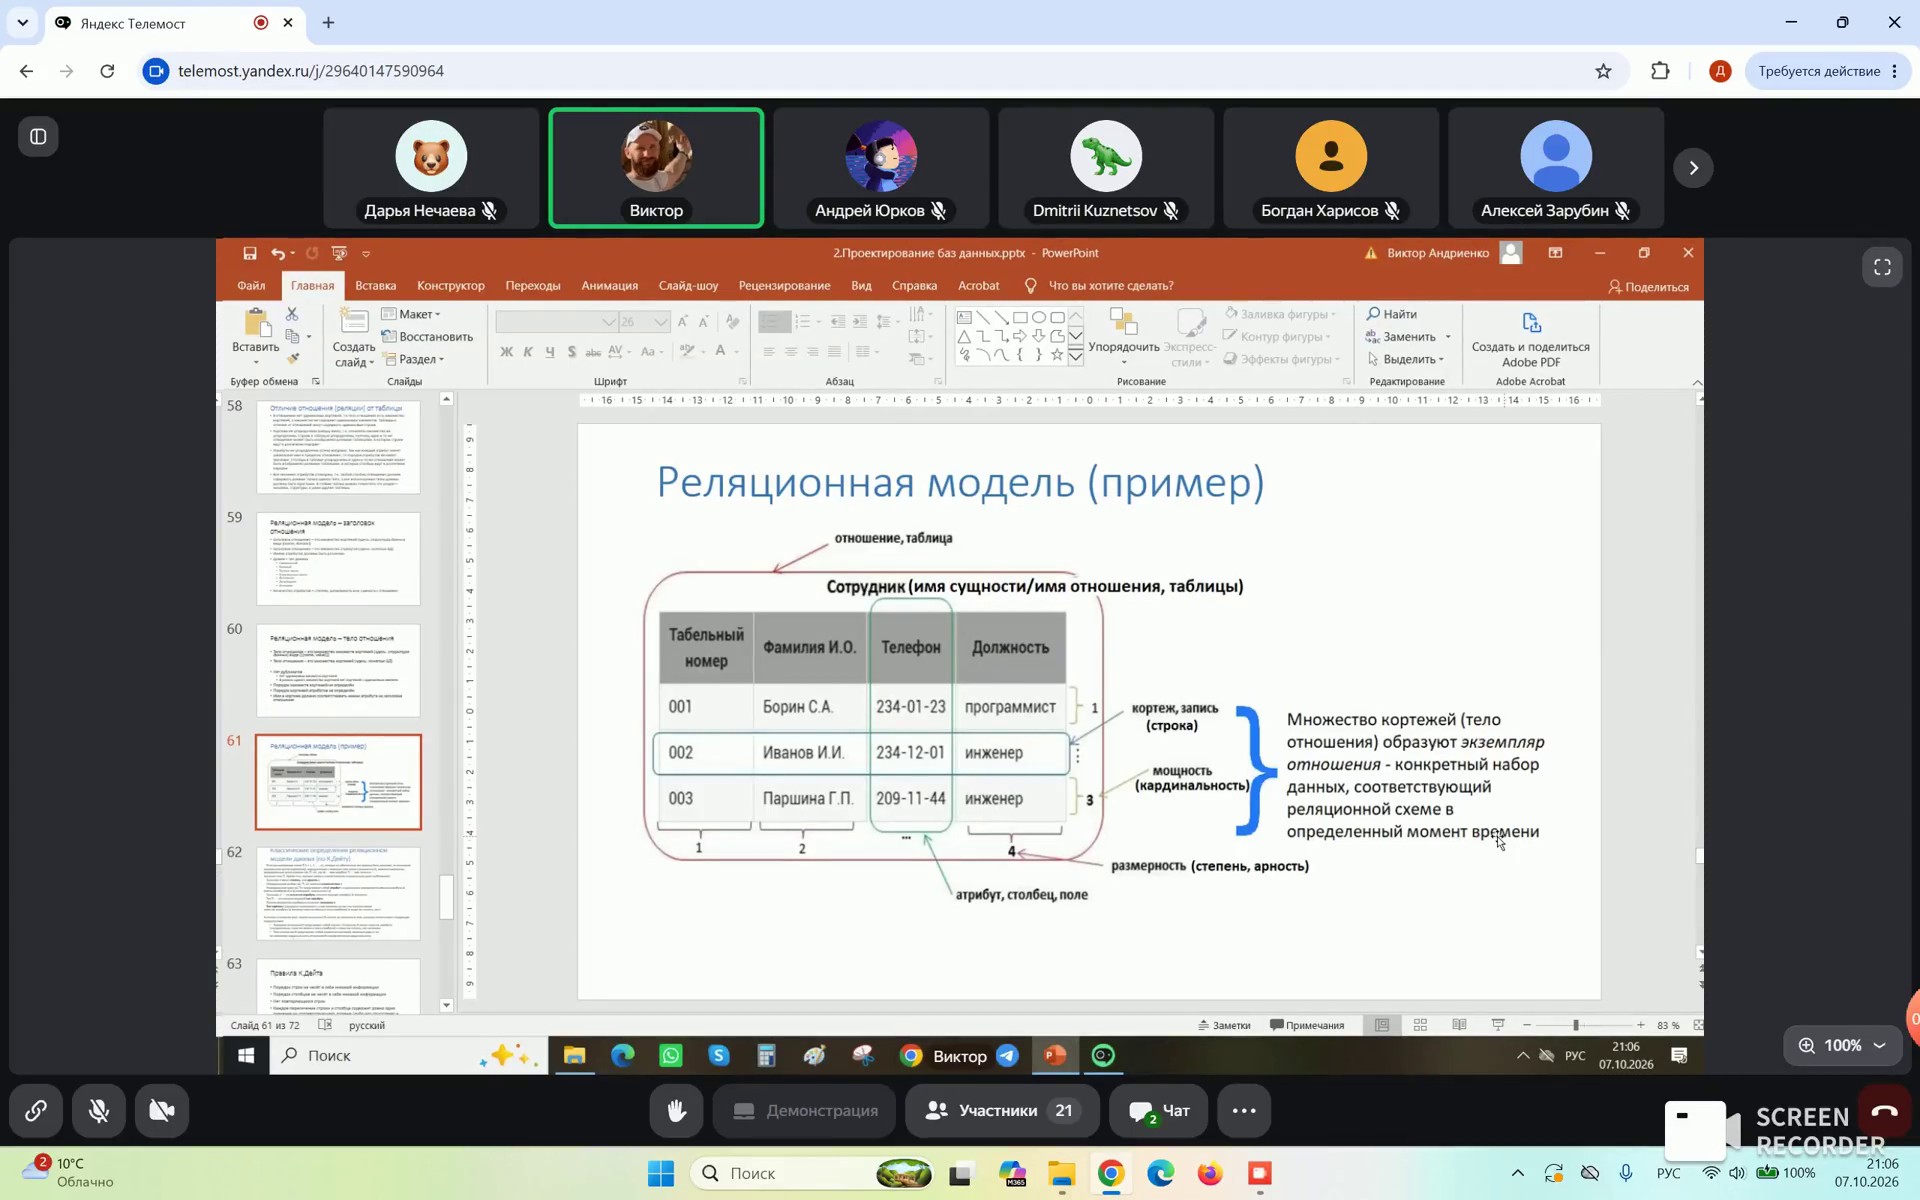
- Тело (либо экземпляр) — это множество кортежей, которые может иметь отношение.
Таким образом, отношение — это заголовок плюс тело; заголовок — множество атрибутов, тело — множество кортежей.
Количество атрибутов называется степенью, размерностью или арностью отношения. Все эти термины являются синонимами.
Различия между отношением и таблицей
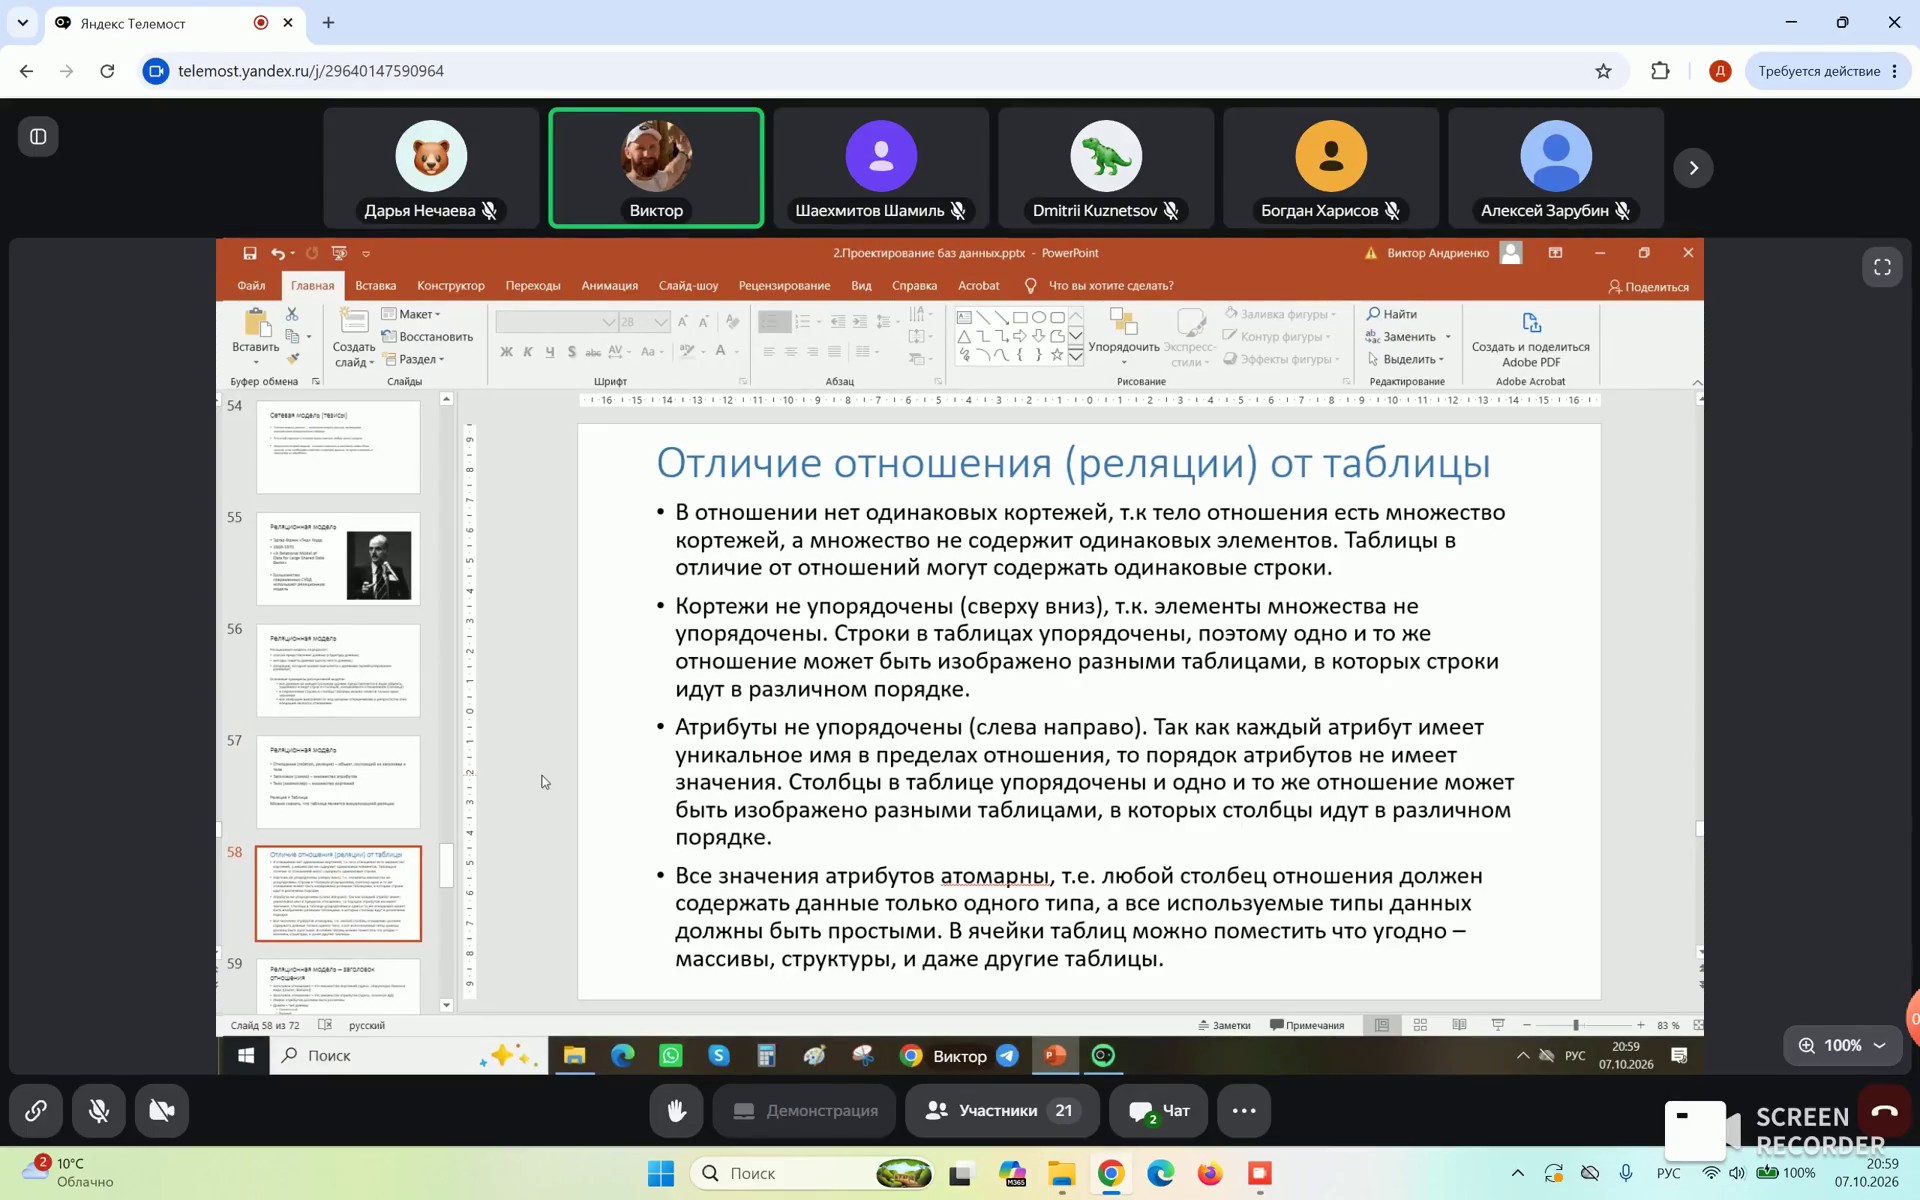
- В отношении нет одинаковых кортежей, так как тело отношения есть множество кортежей, а множество не содержит дубликатов. Таблицы, в отличие от отношений, могут содержать одинаковые строки.
- Кортежи не упорядочены сверху вниз, так как элементы множества неупорядочены. Строки в таблицах упорядочены, поэтому одно и то же отношение может быть изображено разными таблицами, в которых строки идут в различном порядке.
- Атрибуты неупорядочены: так как каждый атрибут имеет уникальное имя в пределах отношения, порядок атрибутов не имеет значения. Обратно, столбцы в таблице упорядочены, и одно и то же отношение может быть изображено различными таблицами, в которых столбцы идут в различном порядке.
- Значения атрибутов берутся из доменов: любой столбец отношения должен содержать данные только одного типа, а все используемые типы данных должны быть простыми. В ячейку таблицы можно поместить что угодно (массивы, структуры и даже другие таблицы). Иными словами, отношение — это строгий описательный математический объект, коим таблица может не являться.
Домены могут включать простые символьные, битовые, точные числа и т.д. В различных реализациях СУБД имеется множество собственных типов данных, которые где-то пересекаются, а где-то являются уникальными.
Детальное формальное определение по Дейту
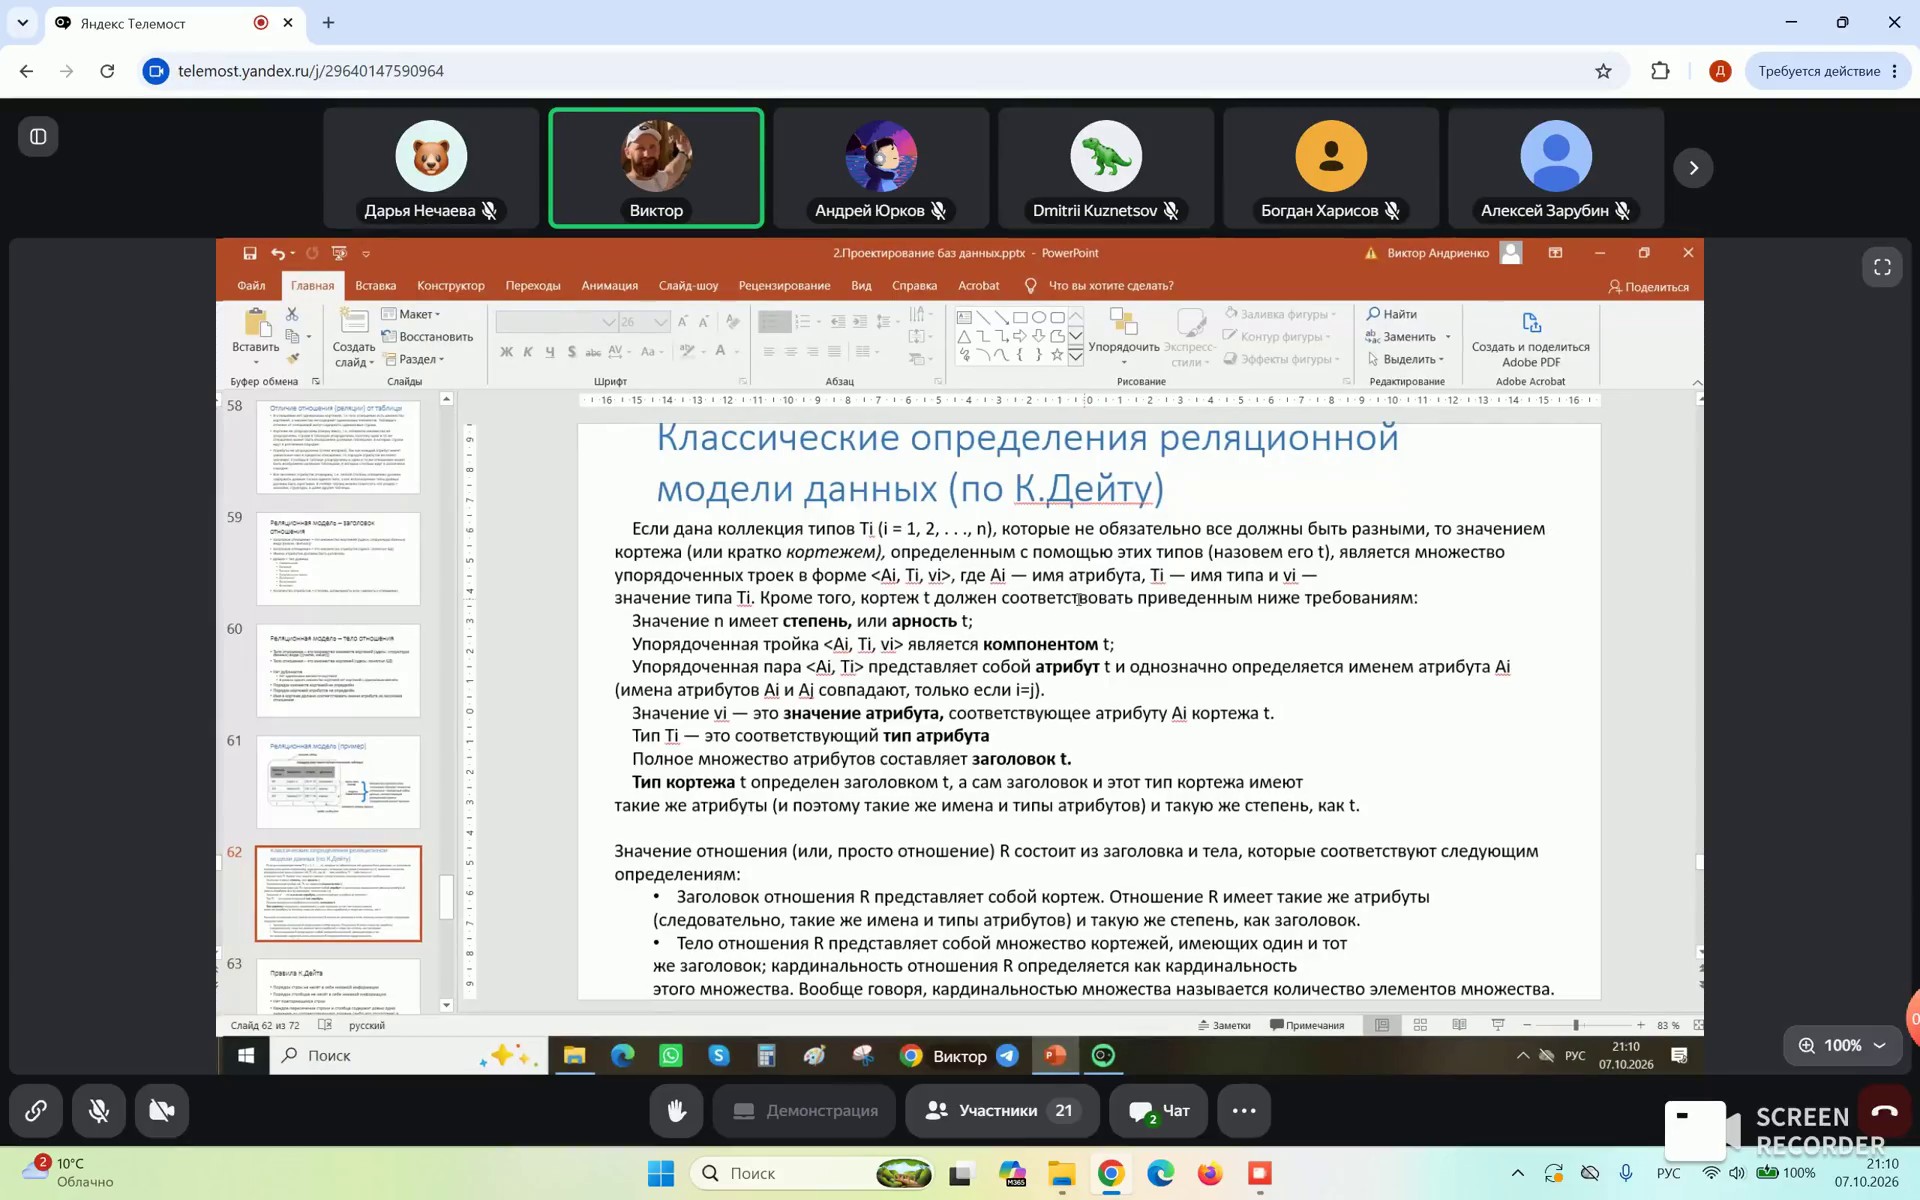
Для теоретического описания: если дана коллекция типов $T_i$ от единички до $N$, которые не обязательно все должны быть разными, то значением кортежа (или кратко — кортежем), определенного с помощью этих типов, является множество упорядоченных троек в формате $(A_i, T_i, V_i)$, где $A_i$ — имя атрибута, $T_i$ — имя типа, и $V_i$ — значение типа.
Кортеж $T$ должен соответствовать следующим требованиям:
- Значение имеет степень или арность $T$ (маленькая буква, как принято в математике).
- Упорядоченная тройка $(A_i, T_i, V_i)$ является компонентом $T$.
- Упорядоченная пара $(A_i, T_i)$ представляет собой атрибут и однозначно является именем атрибута $A_i$. Имена атрибутов $A_i$ и $A_j$ совпадают тогда и только тогда, когда $i = j$.
- Значение $V_i$ — это значение атрибута, соответствующего атрибуту $A_i$ кортежа $T$, а тип $T_i$ — это соответствующий тип атрибута.
- Полное множество атрибутов составляет заголовок отношения $T$. Тип кортежа $T$ определен заголовком $T$, а сам заголовок этого типа кортежа имеет такие же атрибуты, и поэтому такие же имена и типы атрибутов, и такую же степень, как $T$.
Значение отношения (или просто отношение) $R$ состоит из заголовка и тела:
- Заголовок отношения $R$ представляет собой кортеж (строку) с набором имени атрибута, имени типа и значения типа.
- Тело отношения $R$ представляет собой множество кортежей, имеющих один и тот же заголовок.
- Кардинальность (мощность) отношения $R$ определяется как кардинальность этого множества (количество элементов множества).
Правила Кодда (правила Дейта):
- Порядок строк не несет в себе никакой информации.
- Порядок столбцов также не несет в себе никакой информации.
- Нет дубликатов строк (повторяющихся строк).
- Каждое пересечение строки и столбца содержит ровно одно значение соответствующего домена либо его отсутствие, и больше ничего.
- Все столбцы являются обычными (нет скрытых компонентов).
Ключи в реляционной модели
При переходе от инфологической модели к датологической ключевые атрибуты типа сущности становятся ключевыми атрибутами отношения:
- Возможный ключ — минимальный набор атрибутов, от которого функционально зависят все остальные, и по которому их все можно определить.
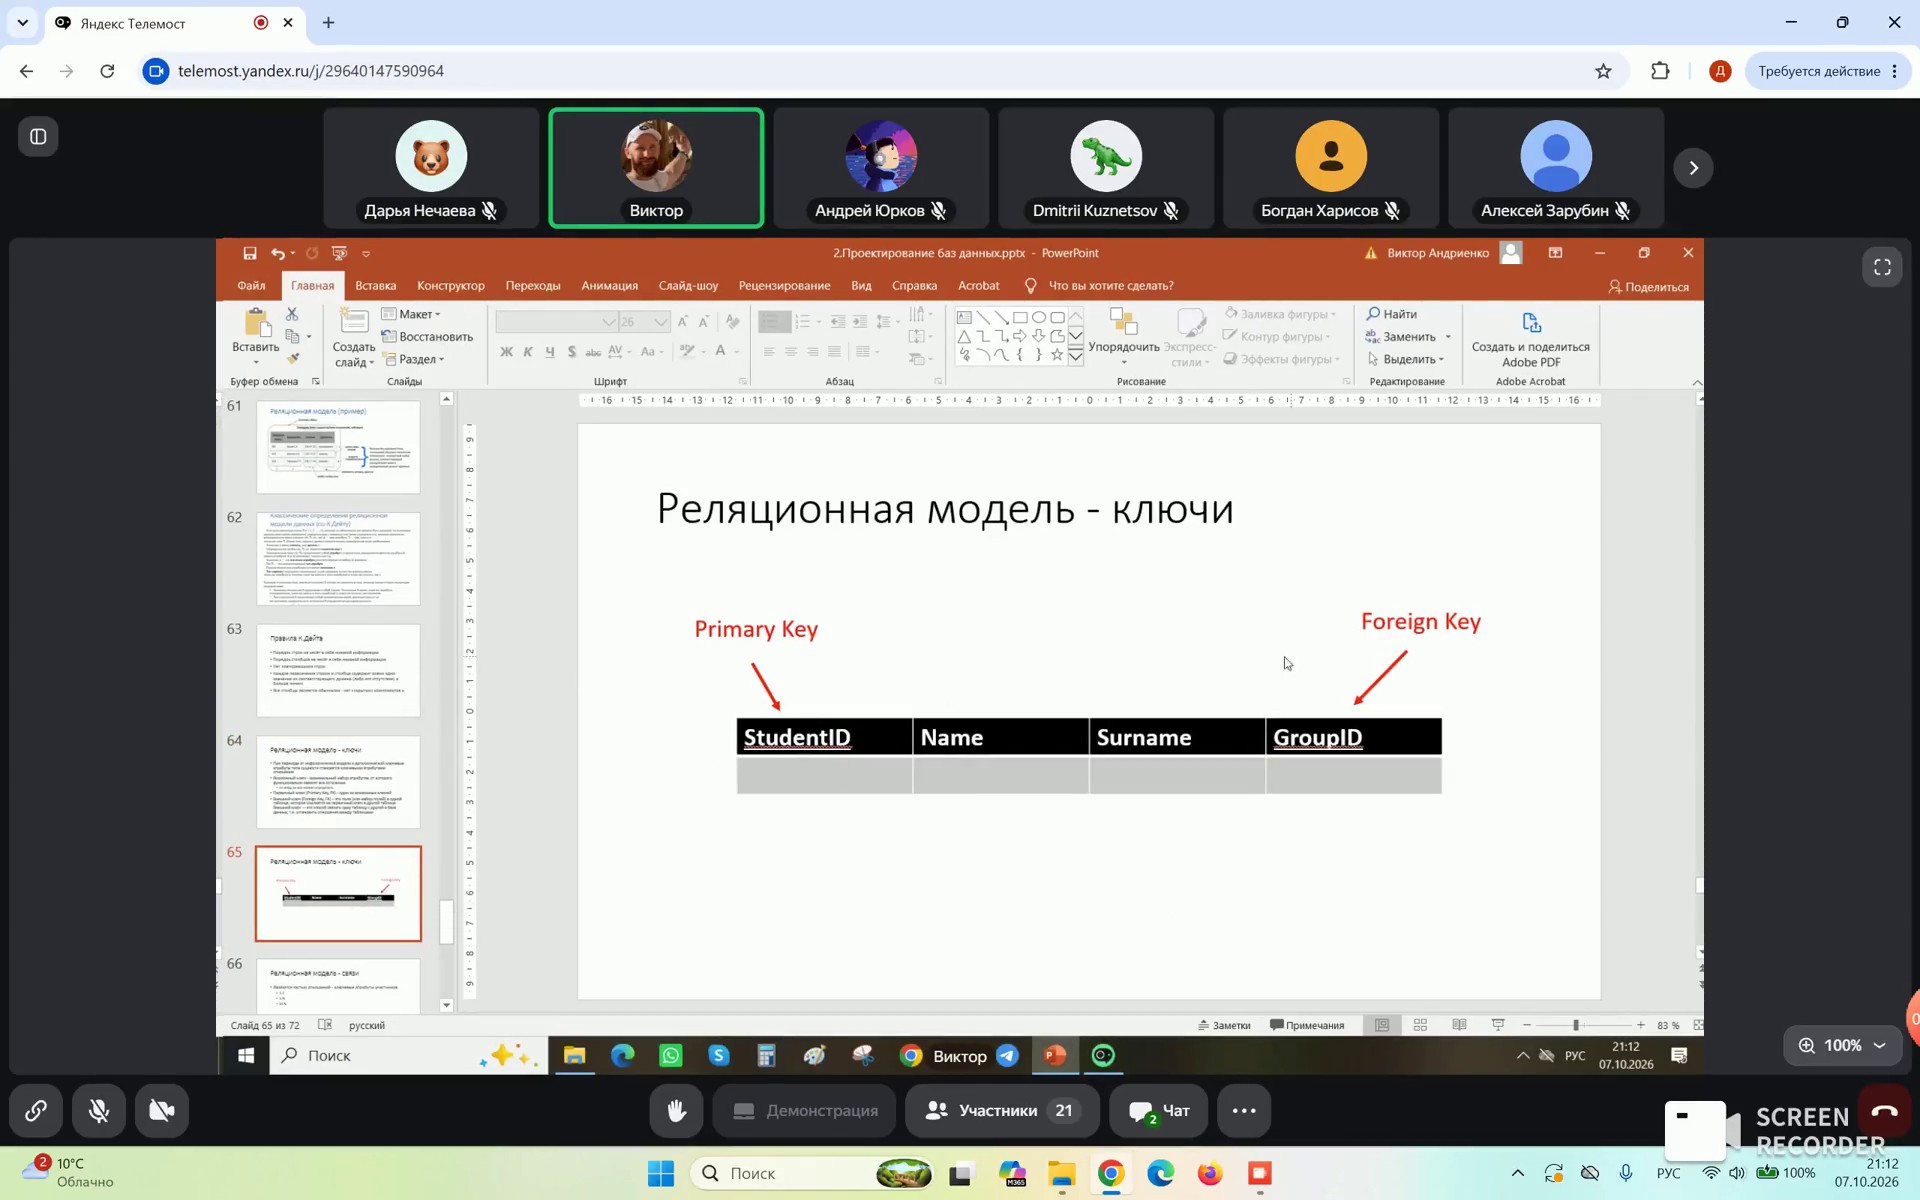
- Первичный ключ (Primary Key) — один из возможных ключей, выбранный в качестве основного.
- Внешний ключ (Foreign Key) — поле или набор полей в одной таблице, ссылающееся на первичный ключ другой таблицы. Внешний ключ является способом связать одну таблицу с другой в базе данных, то есть установить отношения между таблицами.
Интерпретация понятий и связей через отношения
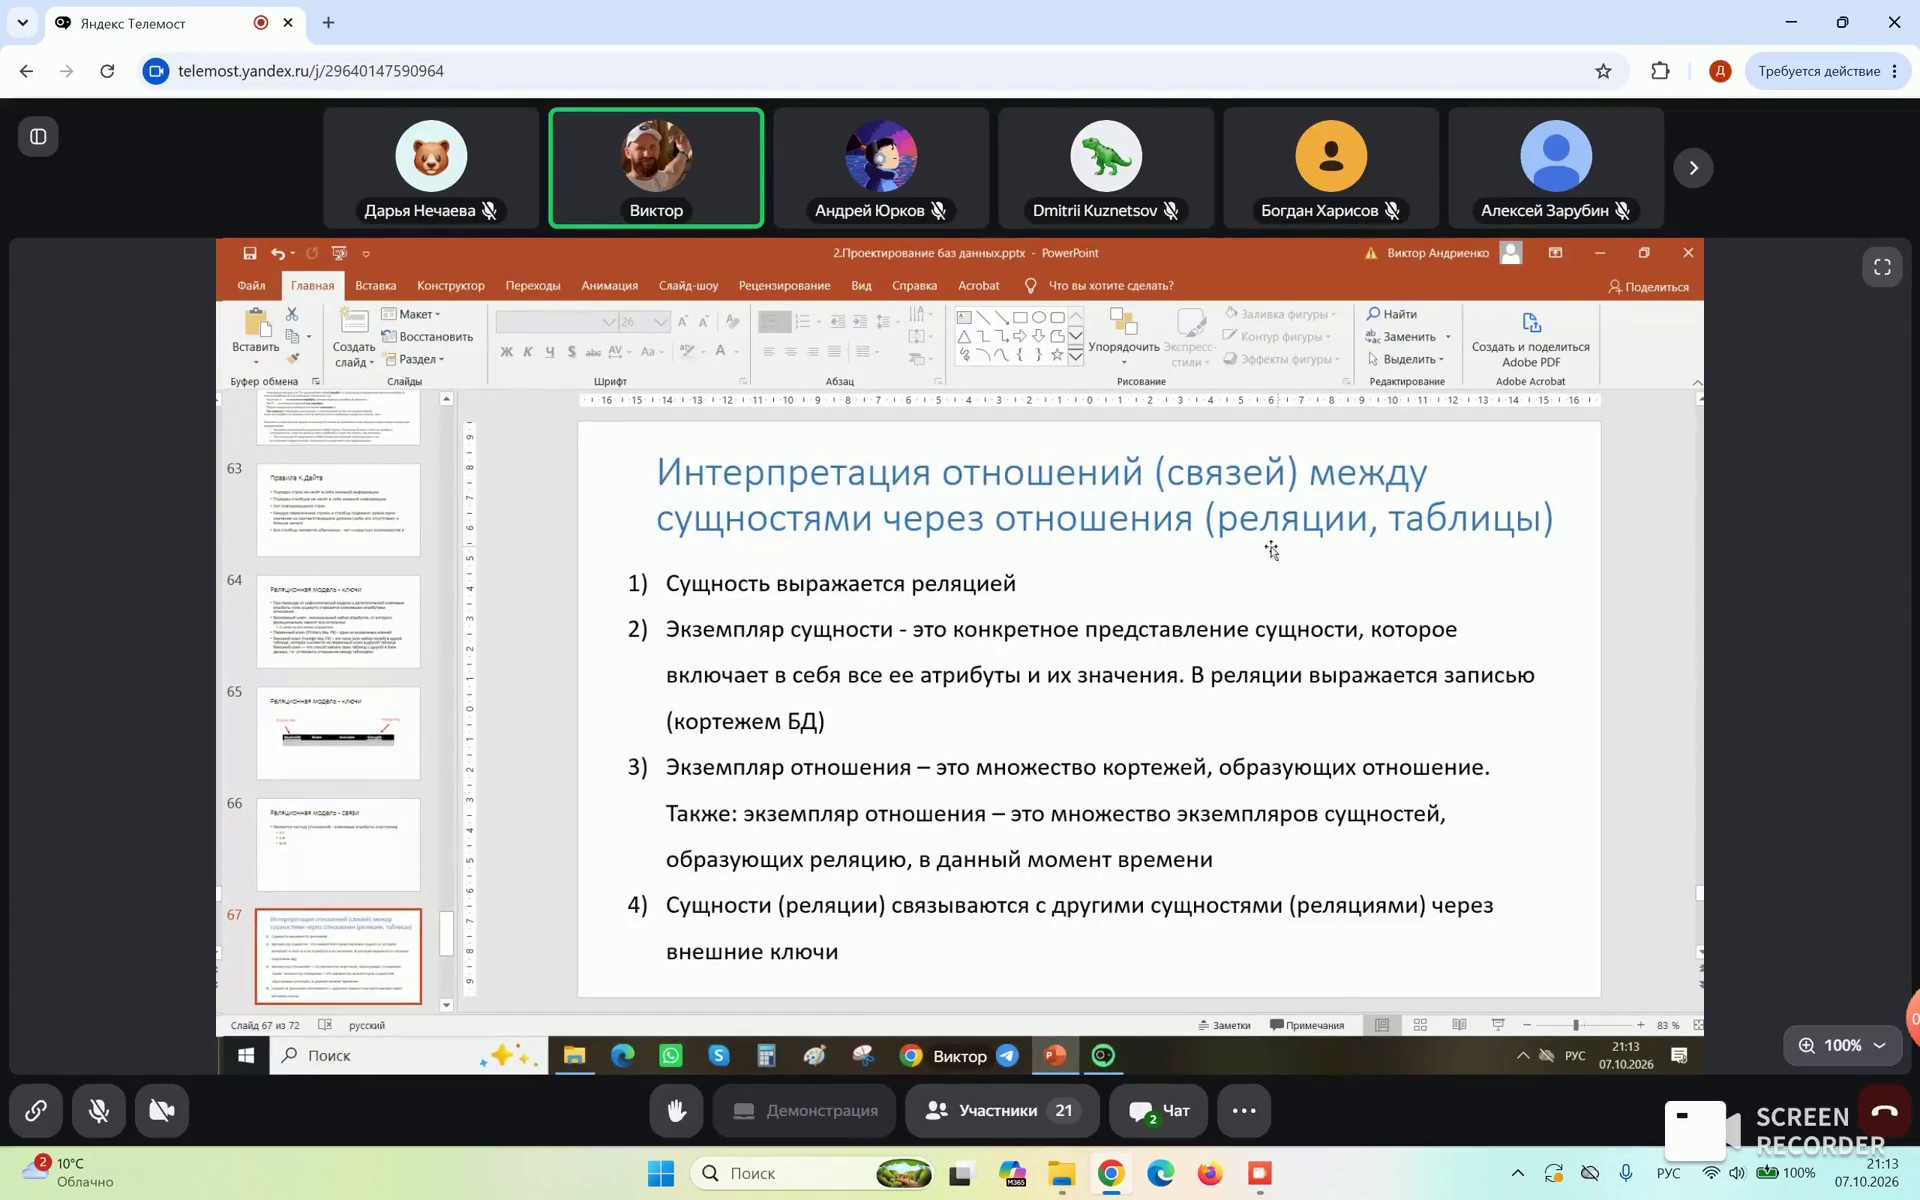
- Сущность выражается отношением (реляцией).
- Экземпляр сущности (конкретное представление сущности, включающее все ее атрибуты и значения в определенный момент времени) в реляции выражается записью (кортежем).
- Экземпляр отношения — это множество кортежей, образующих отношение (или множество экземпляров сущностей, образующих реляцию, в определенный момент времени). При внесении изменений в данные (например, при изменении телефона у конкретного сотрудника) возникает новый экземпляр отношения, так как меняется конкретный набор данных, соответствующий реляционной схеме в определенный момент времени.
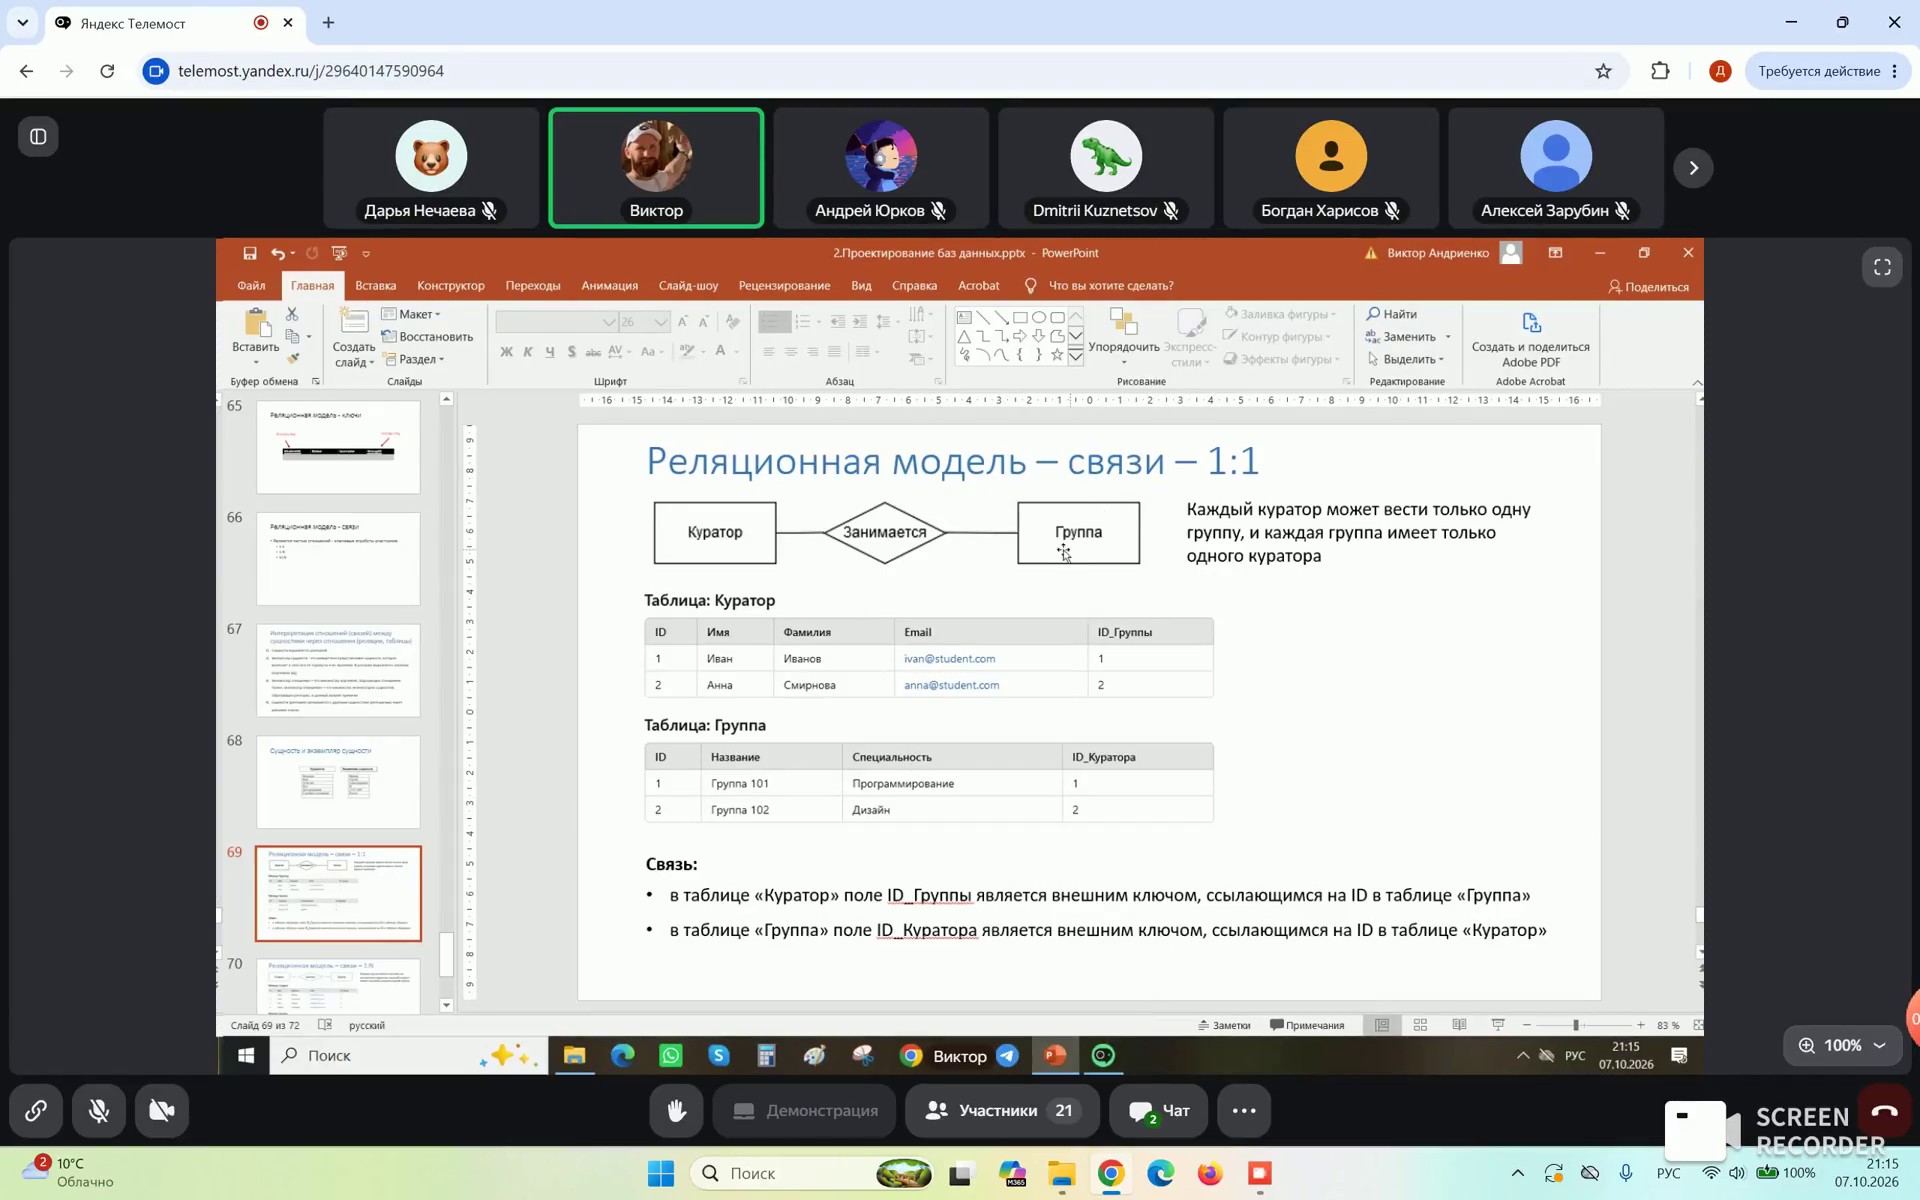
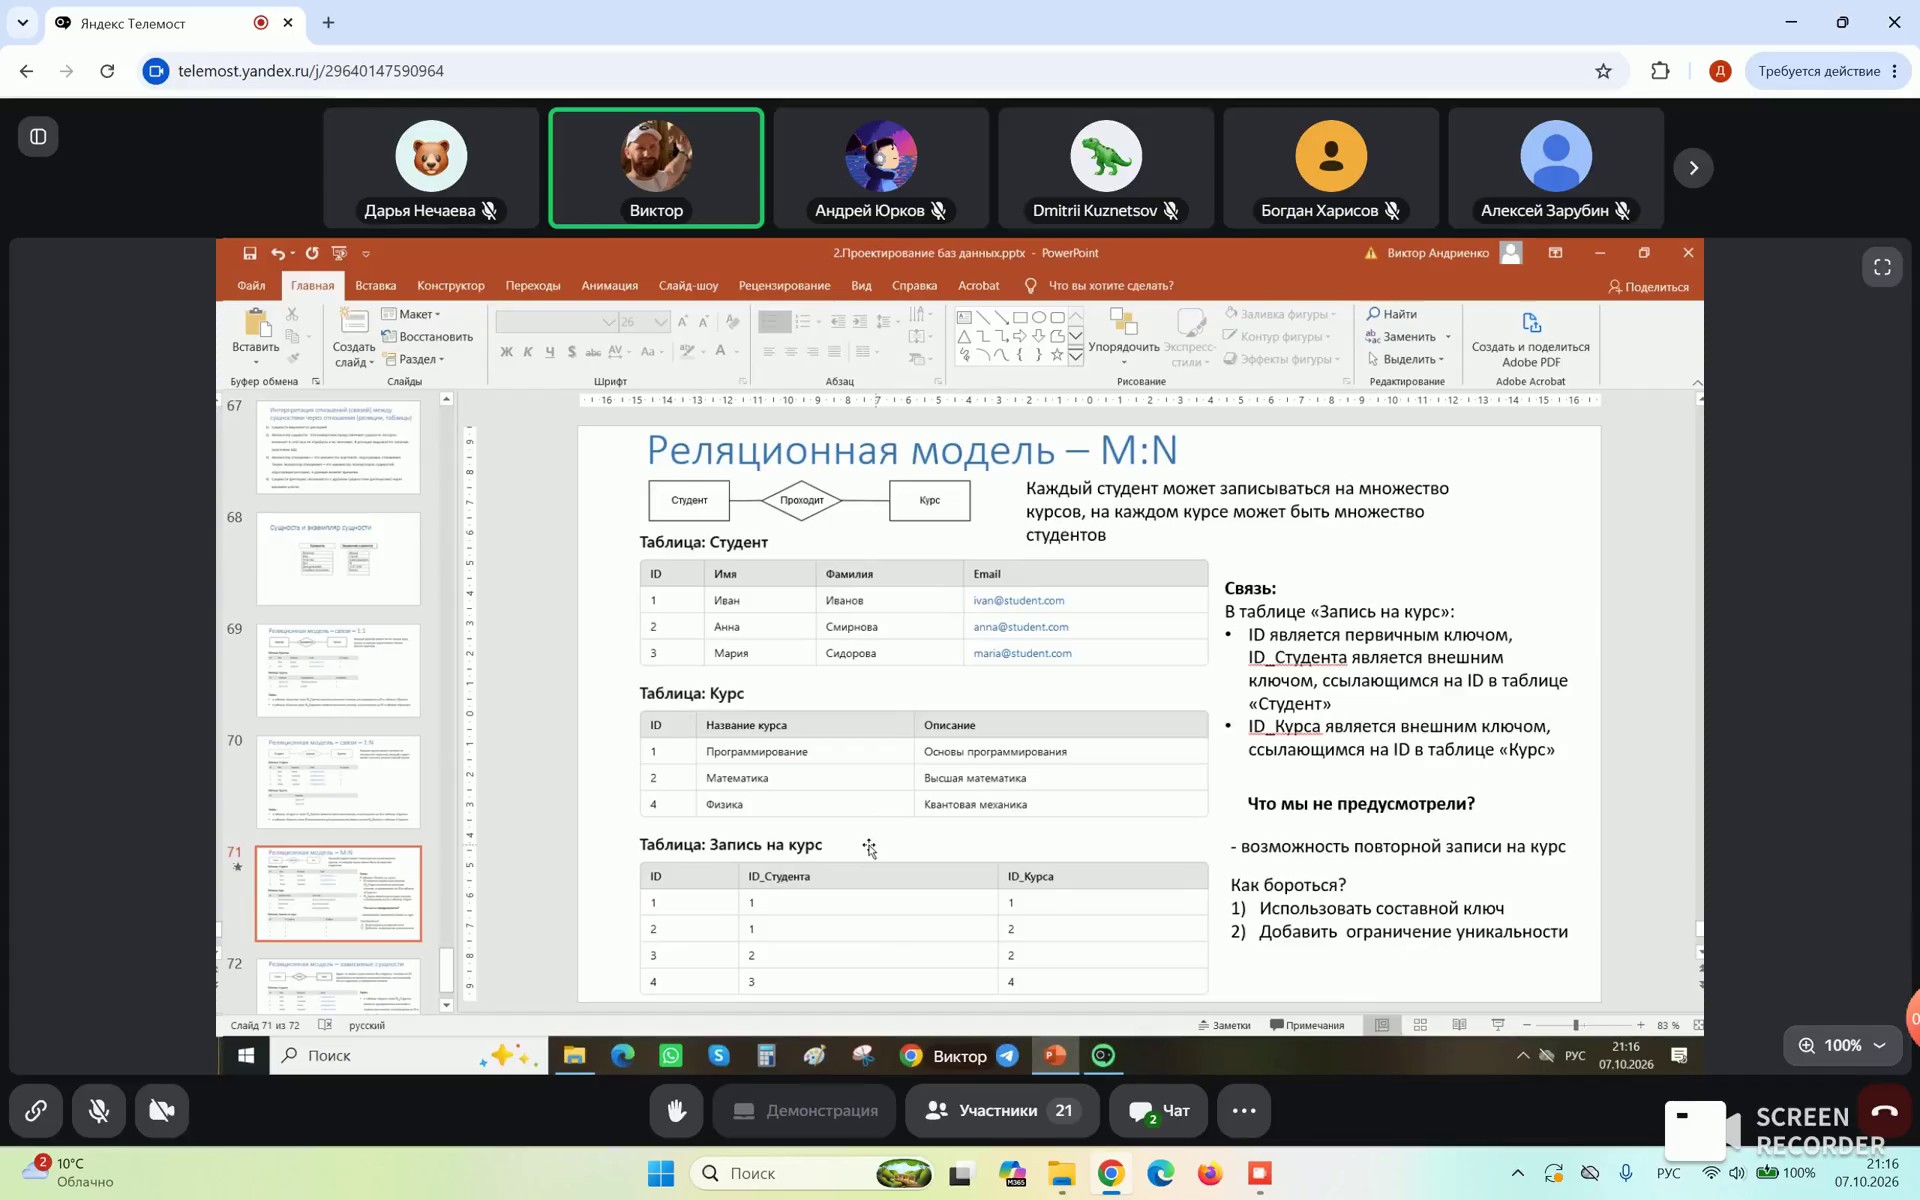
Примеры выражения связей в реляционной модели:
- Связь «один к одному»: в таблице «Куратор» поле «ID группы» является внешним ключом, ссылающимся на «ID» в таблице «Группа»; в таблице «Группа» поле «ID куратора» является внешним ключом, ссылающимся на «ID» в таблице «Куратор». Семантически: каждый куратор может вести только одну группу, и каждая группа имеет только одного куратора.
- Связь «один ко многим»: в таблице «Студент» поле «ID группы» является внешним ключом, ссылающимся на «ID» в таблице «Группа». Семантически: каждая группа может состоять из множества студентов, каждый студент может состоять только в одной группе.
- Связь «многие ко многим»: вводится таблица «Запись на курс», где «ID» является первичным ключом, «ID студента» — внешним ключом, ссылающимся на «ID» в таблице «Студент», а «ID курса» — внешним ключом, ссылающимся на «ID» в таблице «Курс». Для предотвращения повторной записи на курс используется составной ключ или добавление ограничения уникальности.
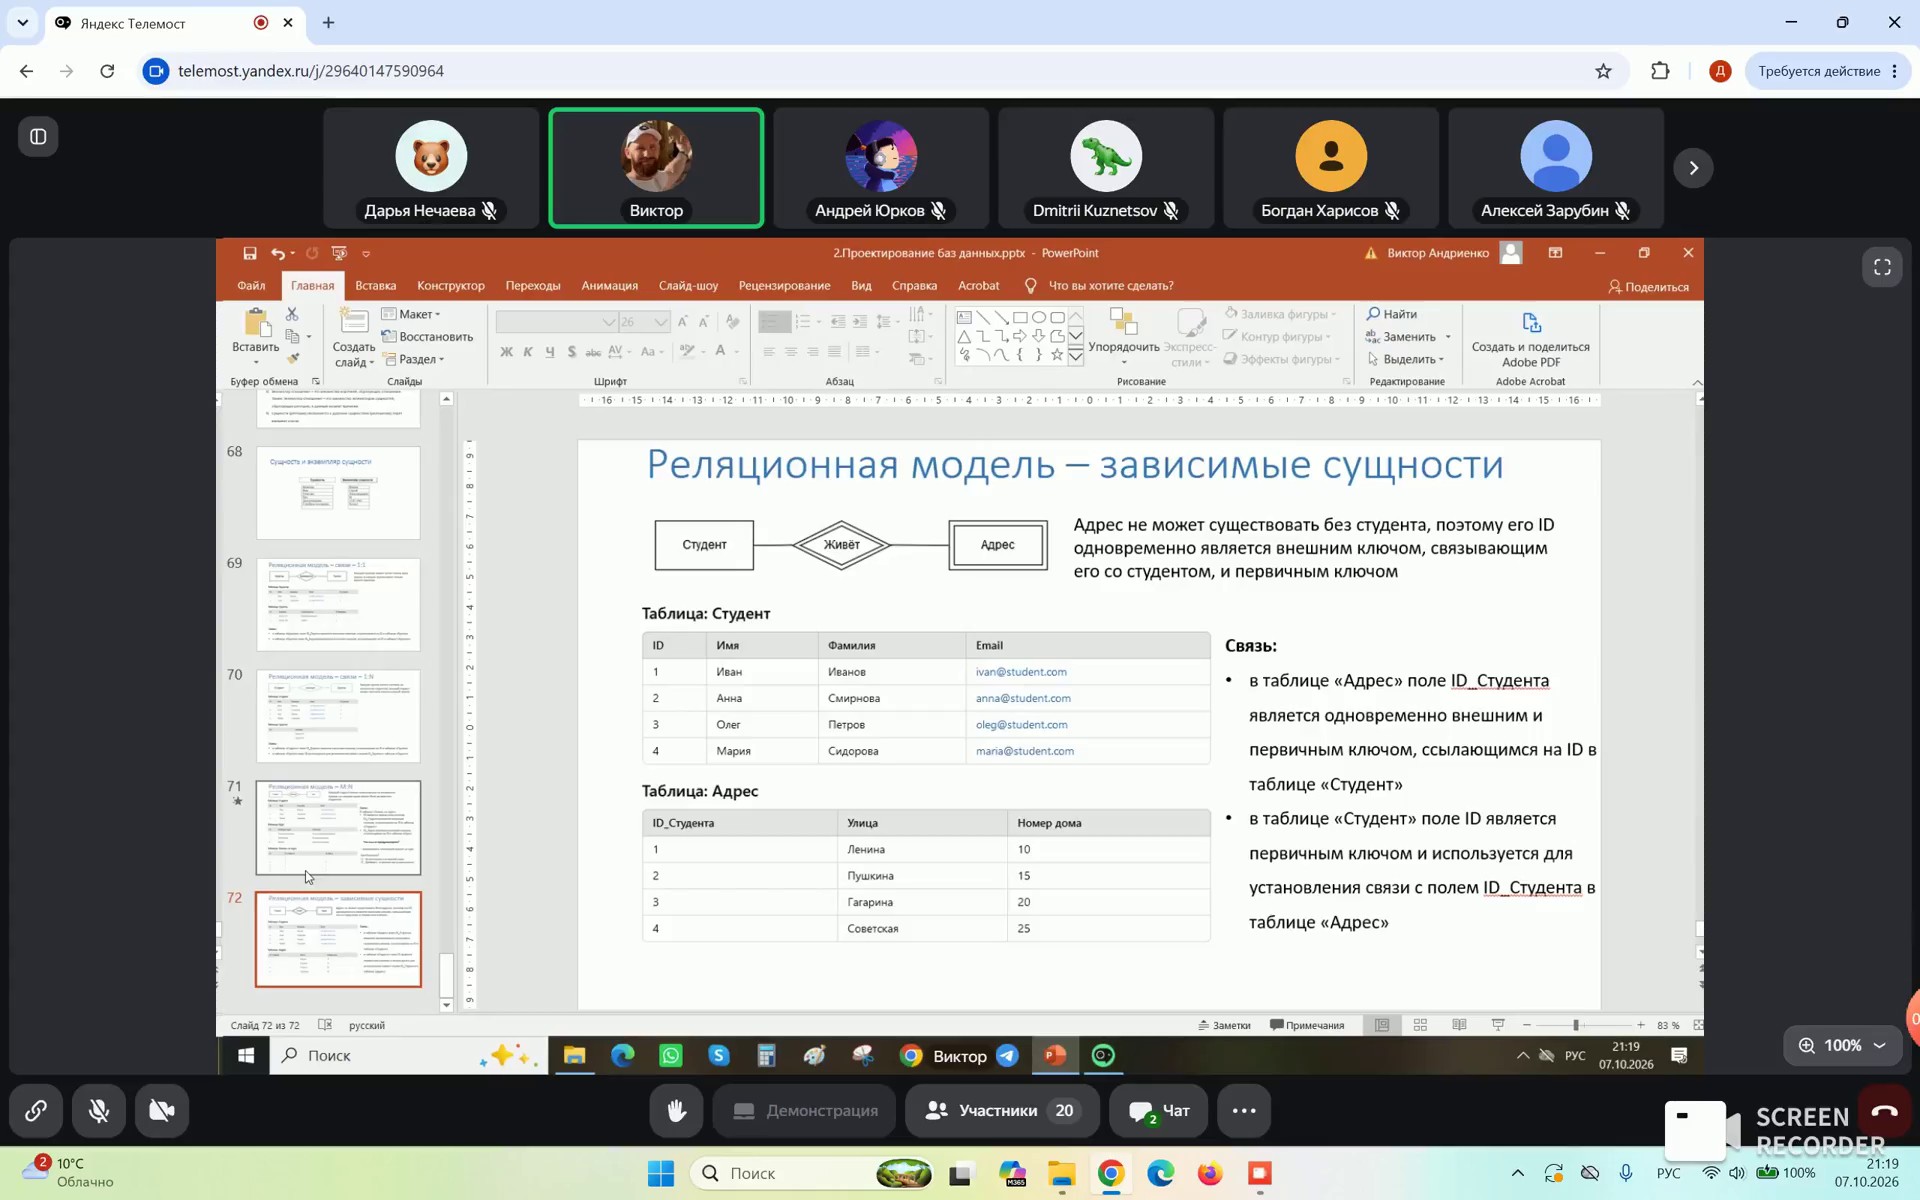
- Зависимые сущности (пример со студентом и адресом): в таблице «Адрес» поле «ID студента» является одновременно внешним и первичным ключом, ссылающимся на «ID» в таблице «Студент». Адрес не может существовать без студента, поэтому его ID одновременно связывает его со студентом как внешний ключ и выступает первичным ключом.
Завершение лекции и организационные объявления
Анонс следующей темы и завершение лекции
На следующем занятии мы пройдемся более плотно по реляционной алгебре, по операциям реляционной алгебры. Опять же, держим в голове, что нас интересует все это дело больше с практической стороны, чем с теоретической, потому что там можно выучить 100-500 определений теоретических и не понимать суть, как это применяется на практике. У нас во главе угла практика, практическое использование этих знаний, поэтому мы будем на этом делать акцент. Наверное, на сегодня у меня всё. Есть ли какие-то вопросы? Если вопросов нет, спасибо всем за внимание. В таком ключе мы будем продолжать до конца нашего семестра.
Отступление от темы
Что еще забыл сказать? Наверное, я вам пришлю план — опять же, план на твой план, чтобы планом вот это, как бы ни звучало, примерный план на текущий момент по переносам по нашим лекциям, чтобы мы там минимальную успели часть программы хотя бы пройти, чтобы вы получили базовые знания. Если успеем, значит, конечно же, дополнительные проведем там всякие занятия по облачным хранилищам, по вот этим всем интересным вещам. Но если у нас не получится полноценно там несколько лекций, это значит затащить... по крайней мере, какую-нибудь обзорную лекцию я для вас сделаю, и пройдемся в основном по современным трендам: что популярно, что используется, где и как используется. Наверное, у меня всё, не буду тоже вас задерживать, всем спасибо, кто пришел. Следующее занятие у нас получается в пятницу, по времени предварительно в 19:00. Но опять же, все течет, все меняется, поэтому, может быть, я вам что-то напишу, постараюсь предварительно [уточнить], какое у нас точно будет время. А так плановое время у нас 19:00. Все, всем пока, пока.