Конспект лекции
Введение в контекстную инженерию и управление памятью ИИ-агентов
Введение и обзор тем лекции
Примечание: Транскрипт содержит фрагменты на валлийском языке (автоматический сбой ASR), однако основная содержательная часть лекции произнесена на английском языке и переведена/восстановлена в соответствии с контекстом выступления на конференции по искусственному интеллекту.
Меня зовут Ламис, я являюсь членом технического персонала компании Anthropic. Я работаю в нашей команде практического искусственного интеллекта (Applied AI team), которая находится на стыке исследований, работы с продуктами и взаимодействия с клиентами. Мы занимаемся как внутренними проектами, так и работой с клиентами, которые создают агентов на базе наших моделей. Лично я в основном работаю со стартапами и разработчиками, многие из которых присутствуют здесь сегодня, и я считаю, что это лучшая позиция, поскольку эти пользователи выжимают максимум из того, что возможно с помощью современных моделей и систем.
Один из главных выводов, который следует из этого, заключается в понимании того, что требуется для того, чтобы взять «сырые» модели, имеющиеся у нас сегодня, и заставить их работать вместе для создания масштабируемых и полезных продуктов. И одним из главных рычагов, которые у нас есть для этого, является context engineering (инженерия контекста), которая станет фокусом моего сегодняшнего выступления.
В ходе этого выступления я планирую осветить несколько ключевых тем. Во-первых, я хочу сделать краткий обзор того, как развивалась инженерия контекста за последний год — это направление буквально взорвалось, и через это мы выделим примитивы, которые доказали свою полезность, а также то, что оказалось менее полезным. Во-вторых, мы поговорим о текущем уровне развития технологий управления памятью (state of the art for memory management). В-третьих, мы обсудим не только красивые теоретические принципы, но и то, что на самом деле требуется для создания таких систем в продакшене. И, наконец, в-четвертых, мы поговорим о том, куда мы движемся по пути к непрерывному обучению (continual learning), и, в частности, затронем парадигму под названием dreaming (сновидения/грезы). Как уже говорилось ранее, модели постоянно совершенствуются и становятся все более интеллектуальными, однако когда мы начинаем внедрять эти модели в ваши рабочие процессы, в ваши окружения, в ваши организации... [неясный фрагмент]
Проблематика контекста и важность контекстной инженерии
[неясный фрагмент]
Эволюция подходов к памяти: от файлов Markdown до файловых систем
Эволюция файлов контекста и систем записей
Подводя итог тому, чего мы достигли на этом пути инженерии контекста, в Anthropic мы любим говорить: делайте простую вещь, которая работает. Временная шкала здесь охватывает на самом деле лишь последний год. То, с чего мы начали, — это файлы CLAUDE.md, которые мы запустили вместе с Claude Code.
То, что мы извлекли из этого опыта, заключалось в том, что это было в некотором роде неразумно эффективно. Такой файл задает некоторые ориентиры для вашего пути вокруг кодовой базы, вашей организации, ваших селекторов прав, и то, что сделало это привлекательным в начале периода модели для старта сессии, — это то, что было очень хорошо находить важные вещи и помогать находить ваши права. [неясный фрагмент] Но в то же время мы узнали и о некоторых вещах, которые здесь не работают. Когда мы применяем это для сессии, мы очевидно начинаем сталкиваться с проблемами, когда возникают проблемы с раздуванием контекста (context bloat). Что происходит, когда этот файл с очень важными настройками становится очень-очень длинным? Как мне управлять этим со временем? И поэтому мы вернулись к чертежной доске и стали думать о путях улучшить это.
С другой стороны, оставалось верным то, что наличие очень простого файла в формате markdown, который является читаемым для человека, в который ваш агент может записывать информацию и в который вы можете записывать информацию, является действительно очень эффективным. [неясный фрагмент: валлийская вставка в оригинале транскрипта]. Следующая вещь, которую мы исследовали, — это системы записей (systems of records). И это интересно, потому что это говорит нам об идее: что, если мы позволим агентам управлять своими собственными системами записей?
Таким образом, мы настраиваем их так, чтобы они сами выбирали, когда читать, когда писать и когда распознавать записи. И это происходит в рамках сессии, что означает, что существует определенный период внутри сессии. Таким образом, во время сессии эксперт [возможная ошибка распознавания: агент] думает о том, что было бы интересно вынести оттуда и что было бы интересно записать. Автономный подход (autonomy) в данном случае доказал свою эффективность, и со временем мы развили это в такие системы, где мы становимся еще менее предвзятыми в отношении того, как эти инструменты должны выглядеть, и я коснусь этого через секунду.
Использование навыков и прогрессивное раскрытие
Следующей остановкой на этом пути являются skills, о которых, я уверен, вы сегодня уже много слышали. То, что они решают, — это проблема постоянно растущего контекста. Здесь применяется очень умная идея — progressive disclosure (прогрессивное раскрытие). Способ, которым я люблю думать об этом, заключается в том, для чего на самом деле хороши skills. Это процессы, в которых у вас есть процедурный воркфлоу, то есть что-то, где у вас есть определенное мнение о том, как процесс работает от начала и до конца, и вы хотите, чтобы агент этому следовал.
И что очень умно, агент смотрит только на frontmatter [возможная ошибка распознавания: пару предложений] в самом верху файла перед загрузкой скилла, но при этом вы можете загрузить сколько угодно деталей в основное тело файла. Таким образом, вы можете одновременно иметь очень глубокие уровни детализации, не перегружая контекст модели.
Способ, которым я люблю думать об этом, — как будто у меня есть книжная полка в комнате, и каждый раз, когда кто-то со мной разговаривает, я могу просканировать и посмотреть на список книг, увидеть, могут ли какие-то названия быть релевантными для разговора, снять книгу с полки и прочитать ее, когда это необходимо. Например, если бы кто-то подошел ко мне и заговорил по-французски, и я бы заметил, что у меня есть французский словарь, я мог бы достать его, и это дало бы мне контекст, как бы загружаемый во время разговора, который помог бы мне без необходимости удерживать в памяти все семь лет школьных уроков французского и держать их загруженными в своем контексте постоянно. Так что это действительно, действительно великая инновация.
Но потенциальным узким местом здесь является то, что этот подход все еще в некоторой степени управляется людьми и агентами вместе — то есть вы все еще, даже если используете своих агентов для написания скиллов вместе с вами, остаетесь довольно категоричными в отношении того, для каких вещей нужны скиллы. И это подводит меня к...
Файловые системы как современный подход к памяти агентов
Финальным шагом на этом пути является то, что мы воспринимаем как самые современные state-of-the-art системы памяти на сегодняшний день. То, что мы сделали и считаем лучшей практикой (best practice), заключается в моделировании этих систем памяти просто как файловых систем. Это в некотором роде объединяет выводы из предыдущего опыта. Файловые системы великолепны тем, что их можно просто заполнять файлами в формате markdown. Агенты на самом деле очень хорошо умеют использовать обычные инструменты файловой системы, такие как Bash и grep, позволяя им производить поиск по файловой системе, вместо того чтобы навязывать им какие-то специфические жесткие инструменты для чтения и записи в память. Такой подход к поиску отражает идею progressive disclosure (прогрессивного раскрытия информации). Эти системы памяти можно очень хорошо индексировать, чтобы агенты могли интеллектуально искать по ним. И это то, к чему мы в итоге пришли на данный момент.
Подводя итог ключевым выводам: формат markdown отлично подходит для чтения воспоминаний; позволяйте памяти увеличиваться в размерах, но давайте агентам инструменты для быстрой индексации и поиска того, что является релевантным; и, наконец, предоставляйте агентам автономию при записи в память. Если вы пойдете и построите такую систему, она будет работать хорошо, и у вас действительно возникнет ощущение непрерывного обучения (continual learning), потому что ваши агенты будут становиться лучше в любых конкретных задачах.
Проблемы масштабирования систем памяти в продакшене и ключевые принципы
Проблемы масштабирования систем памяти агентов в продакшене
Однако, как и со всем остальным, эта аккуратная идея сталкивается с некоторыми проблемами, когда вы пытаетесь масштабировать её в продакшене. У нас есть концепция того, что работает в теории, и когда мы думаем о масштабировании этого в продакшене в средах, где у нас много агентов сотрудничают одновременно, где они работают в течение очень долгого времени и где, потенциально, эти кодовые базы становятся действительно сложными, множество проблем начинает возникать, и мы видели их в продакшене снова и снова.
Поэтому есть пара вещей, просто чтобы подстегнуть ваше воображение. Подумайте о нескольких агентах, пытающихся записать файл памяти одновременно — как вы этим управляете? Подумайте об одном агенте, который сталкивается с проблемой и решает записать что-то в общеорганизационный контекст, который читают все остальные агенты; если там окажется что-то неверное, это повлияет на всех ваших агентов, и всё может пойти наперекосяк. И подумайте о том, когда у вас есть множество работников, сотрудничающих в течение периода обучения: как вы можете уследить за тем, что происходит?
Проблема заключается еще и в том, что обучение может портиться, со временем то, что было чрезвычайно важно в прошлом, может оказаться неважным сегодня, или может быть записано неправильно, или даже подвергнуться серьезной порче со стороны кого-то, кто пытается повлиять на ваши системы, чтобы записать вредоносные вещи в журнал. Поэтому вам приходится многое учитывать, чтобы гарантировать, что эти прекрасные автономные системы записей работают в продакшене. Поэтому я собираюсь рассказать о двух главных принципах, которые мы используем при проектировании систем записей в продакшене, чтобы гарантировать использование всех тех прекрасных эффектов, о которых мы говорили.
Версионирование и контроль параллелизма
Первым ключевым аспектом является versioning (версионирование). Когда вы проектируете любую систему памяти, вам необходимо иметь возможность сохранять версии, чтобы отслеживать происходящее и иметь возможность выполнить откат (roll back), если новое обновление окажется не особенно удачным. Дополнительно вам, вероятно, захочется подумать о том, на каком контексте было основано это обновление: какая именно сессия агента и какой транскрипт привели к тому, что вы захотели внести это обновление. Кроме того, вы можете захотеть отслеживать, кто именно внес изменения — конкретный агент и так далее. Это действительно важно.
Вторым аспектом является concurrency (параллелизм). Мы уже говорили о том, что происходит, когда мы развертываем тысячи агентов, работающих с одной и той же системой памяти. Решением, которое мы здесь приняли, является использование системы хеширования. Когда агент решает, что он хочет записать обновление в память, [неясный фрагмент на валлийском языке, описывающий процесс проверки хеша перед записью, предотвращения конфликтов при одновременном обновлении и механизм повторной попытки создания записи в случае обнаружения изменений]. Именно такие инженерные практики позволяют масштабировать архитектуры с множеством агентов и масштабировать память для подобных архитектур. Еще пару ключевых принципов представляет собой permissioning (управление доступом).
Управление правами доступа и портируемость
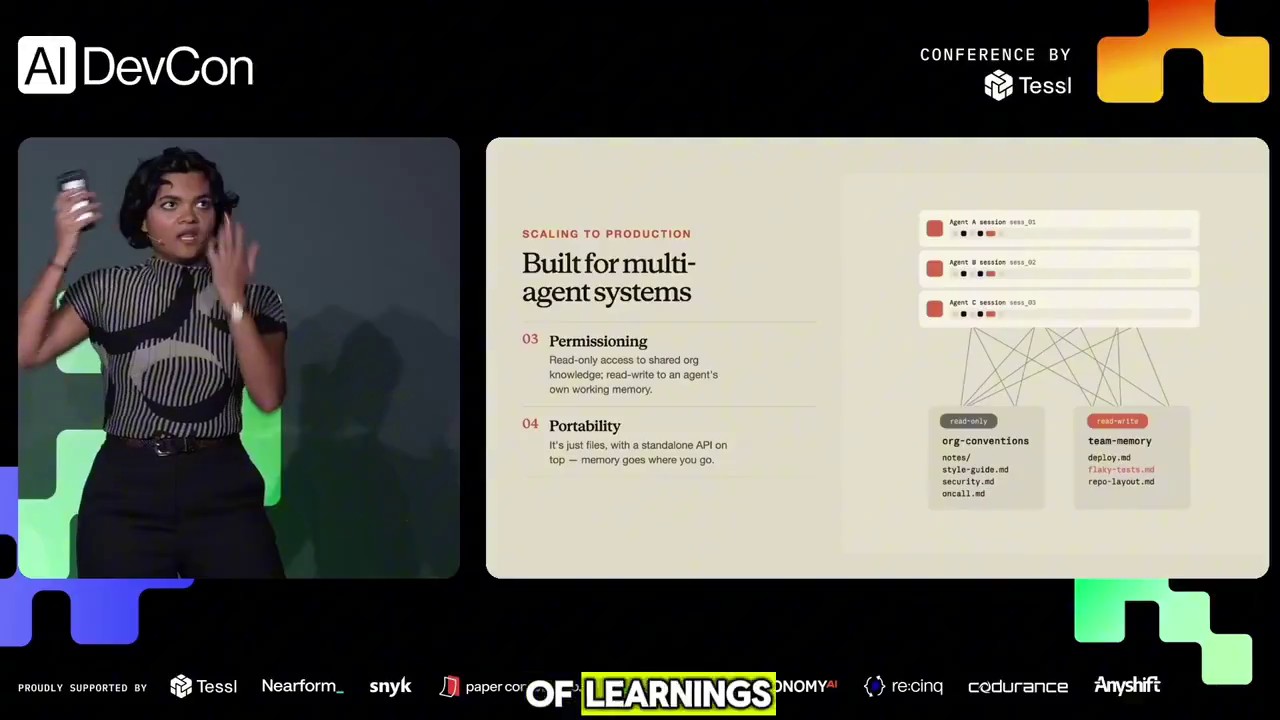
When you have large memory bases, you probably have a mixture of top-level, organisational-wide knowledge. It might be like your key, like what your organisation is trying to achieve, or key principles [неясный фрагмент] up to a level of a bit more expert-oriented knowledge, where an expert writes their own scratchpad, which is very interesting. And up to a certain point, you can have things for specialised organisations or cross-sections. So it's very important that you have different permissions when it comes to these records.
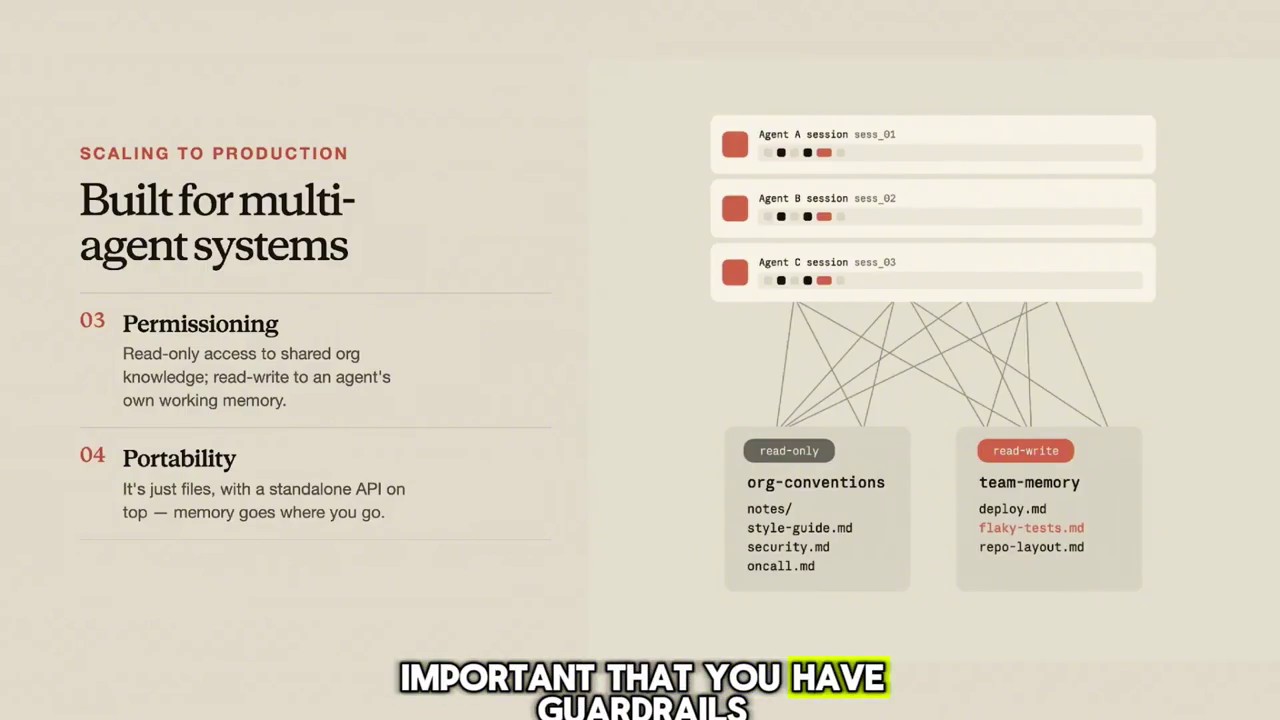
So, as I said, you wouldn't want one expert to decide that it should update the organisation-wide context. Probably, you might want that as read-only. However, for its own scratchpad, you would want it to have write access. And that's permissioning.
The final thing which is kind of peripheral but still really important when you design memory systems is portability. So, like I mentioned before, [неясный фрагмент]. So, if you are putting a lot of effort to curate your memory systems, you want it to be [неясный фрагмент] and connected by [неясный фрагмент]. So, designing in a way with the API so that it can be portable, and that you can connect it appropriately, is very important.
So, when you put all these things here all together, we have what we learn in terms of asking workers to implement their records, and those who are working on production, a level that enables them fortunately to use all these principles in practice. When you do this, you
Результаты внедрения и практические выводы
При развертывании крупномасштабных систем памяти в продакшене можно получить очень эффективные результаты. В качестве нескольких выводов из этого опыта можно отметить следующее. Во-первых, достигается лучшая точность: наблюдается эффект, при котором агент выполняет задачу во второй раз лучше и с более высокими результатами, поскольку он уже учитывает прошлый опыт [неясный фрагмент из-за сбоя распознавания речи на валлийском языке]. Во-вторых, это влияет на время и стоимость работы специалистов (в частности, бухгалтеров), поскольку они быстрее справляются с формами, способны выполнять задачи в режиме one-shot гораздо проще, так как понимают, что именно они делают [неясный фрагмент]. Для самых разных процессов специалисты могут выполнять задачи лучше и быстрее. Наконец, когда процесс выстраивается так, что сотрудники начинают автономно вести свои записи, это высвобождает их время для таких задач, как разработка продуктов и фокусировка на продуктовых достижениях, а не на непрерывном совместном обучении в процессе работы. В итоге, как только такая организационная структура настроена действительно хорошо, эта работа начинает функционировать очень эффективно.
Концепция « Dreaming » и внеполосное управление памятью
Ограничения внутрисессионной памяти агентов
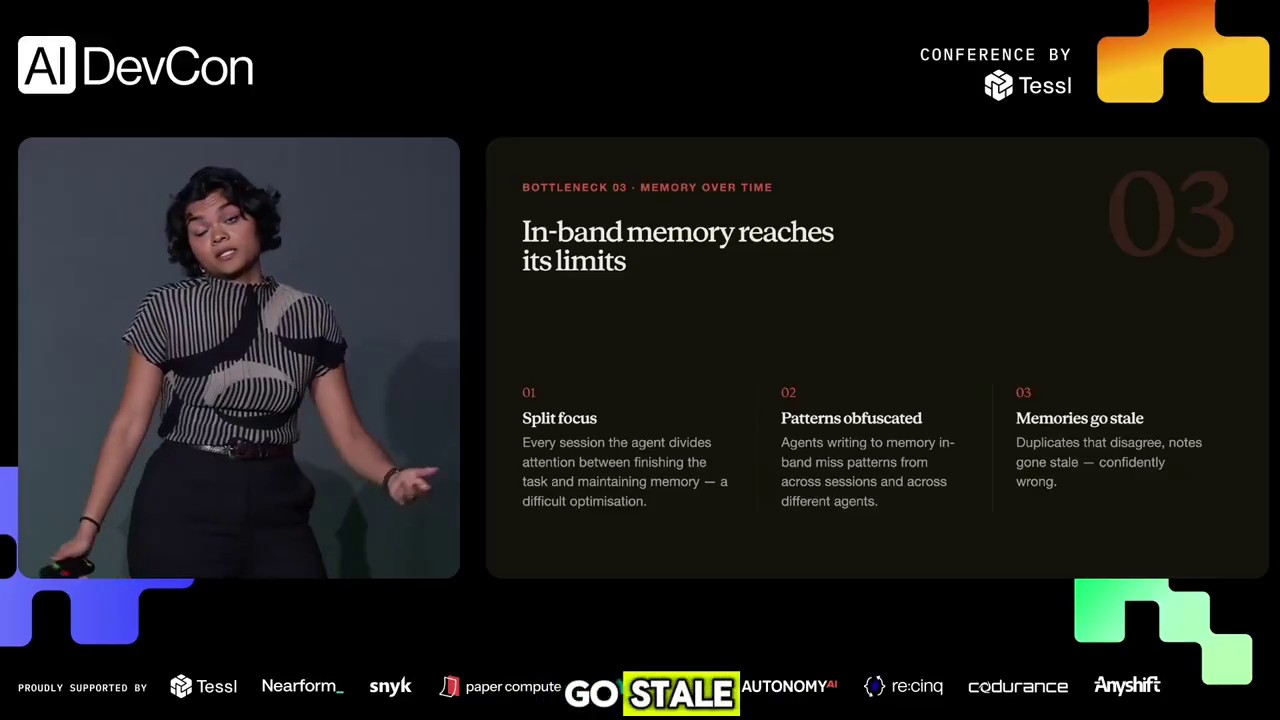
В данном фрагменте рассматривается концепция внутрисессионной памяти (in-band memory) агентов и её архитектурные ограничения в контексте непрерывного обучения общего пула агентов. Под in-band memory понимается ситуация, когда агенты осуществляют запись в память и чтение из неё в рамках конкретной сессии. В качестве примера можно привести работу с Claude Code, где при запуске новой сессии фокус чтения и записи из памяти сосредоточен именно на этом специфическом контексте.
С архитектурной и философской точек зрения такой подход имеет ограничения для непрерывных целей общего пула агентов, и на это есть две главные причины. Первая причина заключается в присущем разделении фокуса и ресурсов. От агента требуется выполнение поставленной задачи и одновременно инвестиции в курацию памяти, которая помогла бы ему эффективнее работать в будущем сеансе. Соединение этих двух аспектов превращается в очень сложную проблему оптимизации, поскольку возникает вопрос: какой объем емкости агент должен тратить на помощь будущим версиям самого себя, а какой — на выполнение непосредственно заданной ему задачи? Кроме того, здесь возникают и другие эффекты, например, задержка (latency).
Вторая причина связана с тем, что агенты обладают присущим им ограничением видимости: они располагают контекстом только того, что происходит в рамках их собственной сессии. Из-за этого они не способны замечать паттерны, которые возникают между разными сессиями. Когда пользователь испытывает разочарование из-за того, что агент продолжает совершать одни и те же ошибки от сессии к сессии, агент просто не понимает, насколько это фрустрирующе, так как в каждой из таких сессий у него новое окно контекста.
[Фрагмент на валлийском языке: 00:16:36,071 - 00:16:53,271] [неясный фрагмент].
Для решения этих проблем вводится концепция работы вне основного потока данных (out-of-band). Чтобы объяснить, почему это работает именно так, лектор предлагает обратиться к аналогии со школой, где учится много студентов, выполняющих большой объем работы, а также есть учителя, которые проверяют работы, и директор, контролирующий всё вместе. Подобная система существует в реальном мире неслучайно: она эффективна, когда есть отдельные индивиды с выделенной емкостью для помощи в обучении, а также люди, обладающие видимостью по отношению ко всему пулу агентов или учащихся, способные замечать закономерности и направлять контекст — или, в данном случае, учебную программу (curriculum).
Концепция процесса «сновидений» для управления памятью
При создании таких систем необходимо учитывать одно ограничение, заключающееся в том, что воспоминания со временем устаревают, поэтому требуется некоторый проход, который проверяет, что всё написанное там всё еще корректно. Для этого вводится концепция процесса «сновидений» (в транскрипте из-за особенностей распознавания звучит как валлийский текст, описывающий процессы выбора и управления контекстом агентов). Если думать о том, как это устроено, у нас есть фактический контекст, включающий память и инструменты, процессы «сновидений», позволяющие агентам самостоятельно управлять контекстом, и механизм, который работает в фоновом режиме и производит выбор с использованием собственных ресурсов, чтобы обеспечить эффективность этих процессов и помочь агенту обучаться со временем.
Суть этого процесса заключается в том, что мы берем существующую историю записей (некий план или хранилище записей), а также берем сессии или транскрипты взаимодействия агентов за определенный период времени. Всё это передается агенту, который просматривает все транскрипты и изучает хранилище с самого начала, чтобы выявить проблемы и обнаружить места, где в хранилищах могут быть недостатки. В процессе этого агент способен создавать новое хранилище, предлагая изменения для исходного. Агент может использовать инструменты для решения проблемы обучения агентов, выявления областей, где агенты в целом терпят неудачу, и внесения изменений, которые делают историю записей более эффективной. В результате на следующий день при запуске агентов работа ощущается более существенной и качественной.
Отступление od темы
Лектор упоминает математические экзамены GCE и приводит примеры из школьной практики, когда учащиеся массово допускают одинаковые ошибки из-за того, как были сформулированы вопросы или как работали калькуляторы.
Возвращаясь к аналогии, можно представить несколько сценариев того, как это выглядит на практике. Например, преподаватель просматривает все транскрипты и осознает, что все студенты отвечают на какой-то вопрос одинаково неправильно, записывая все детали в этот конкретный вопрос, из-за чего лектор понимает наличие проблемы в учебной программе. Преподаватель может увидеть эту проблему, изучить хранилище записей и предложить новое руководство для учебной программы, чтобы на следующий день при работе с материалом обучающиеся сразу получали необходимую информацию.
Другой пример связан с использованием инструментов, когда ответы оказываются неверными из-за того, как настроены сервисы или калькуляторы (как это бывало на математических экзаменах GCE). В этом случае в транскриптах обнаруживается, что что-то не так с активностью инструментов, и вы можете заметить, что определенные вызовы инструментов постоянно завершаются ошибкой. При этом важно отметить, что при анализе транскриптов рассматриваются не просто передачи ответов между агентом, системой или пользователем, а детально изучаются вызовы инструментов и вся остальная метадата, которая имеет центральное значение для производительности агента.
В завершение можно заметить проблемы или паттерны, которые носят системный или организационный характер (fleet-wide или organisation-wide). Например, если все начинают использовать слишком много тире (em dashes), и вам это не нравится, вы можете добавить общеорганизационное объявление или изменить контекст, запрещающее подобные действия. Это дает полное представление о том, почему такой подход может быть исключительно эффективным.
Проектирование системы управления памятью в продакшене
При проектировании такой системы в продакшене у вас есть концепция memory store, которая представляет собой коллекцию воспоминаний. Способ, которым мы это спроектировали, заключается в использовании оркестратора и набора sub-agents, которые совместно анализируют все транскрипты.
Когда вы проектируете эти системы, у вас есть возможность настраивать то, как агенты, записывающие информацию и общающиеся в процессе работы с памятью, подходят к решению проблем. Вы можете указать им, какие вещи в вашем конкретном случае вы считаете чрезвычайно важными, а какие — неважными. Таким образом, у вас есть возможность курировать этот процесс памяти и dreaming применительно именно к вашей организации.
Оркестратор просматривает все ответы от суб-агентов и решает, где имеются достаточно распространенные паттерны, которые, по его мнению, оправдывают изменения в воспоминаниях. Исходя из этого, он предлагает отдельные изменения в memory store. В нашем варианте реализации в продакшене оркестратор также предоставляет в качестве ресурсов примеры транскриптов, где, по его мнению, этот паттерн имел место, а также некоторую статистику о том, каков этот паттерн и почему он работает для улучшения хранилища памяти в будущем. В результате всё это работает очень слаженно, и как человек вы можете выбирать, где именно применять изменения к записям, где их отклонять, и так далее.
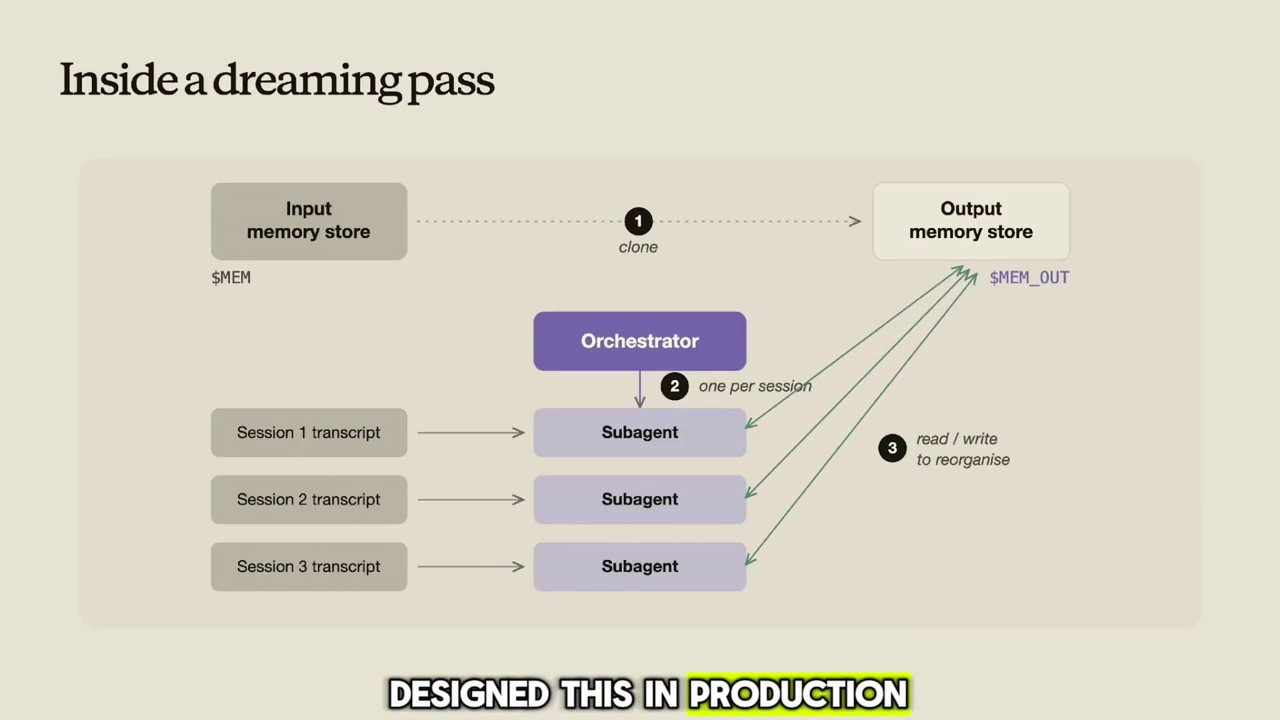
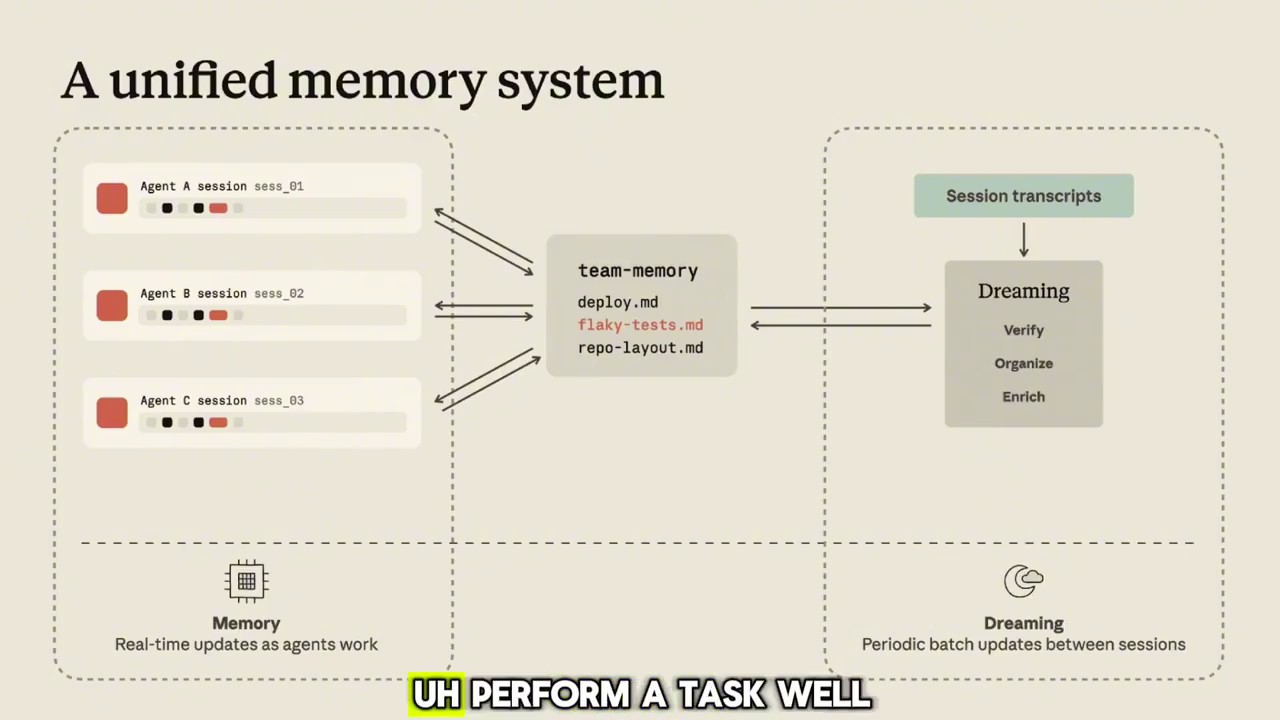
Вместе у нас работают два взаимосвязанных процесса. Во-первых, это запись, где оркестратор использует определенные подходы к поведению, записывая то, что считает важным, что помогает агенту в следующей сессии. Сеансы более универсальны для отслеживания изменений, в то время как работа оркестратора связана с применением изменений, определением того, что закладывать в поведение и что использовать для выполнения задачи.
Второй процесс — это Dreaming, который представляет собой более масштабный фоновый процесс. Он требует больших затрат вычислительных ресурсов и направлен конкретно на то, чтобы помочь агентам обучаться лучше. Вы можете подумать, что это звучит очень дорого, и задаться вопросом, зачем тратить на это дополнительные ресурсы. Однако, если вспомнить об улучшении результатов при построении эффективных хранилищ памяти, на самом деле можно заметить, как снижается ряд других затрат, поскольку агенты получают возможность решать задачи с первой попытки («one-shot») гораздо эффективнее. У них появляется вся необходимая информация для качественного выполнения задачи. Подводя итог [неясный фрагмент].
Итоги и перспективы развития контекстной инженерии
Управление объемом контекста и вовлеченности имеет огромное значение для эффективности работы систем. Использование таких подходов, как файлы конфигурации вроде Claude.md или специализированных навыков, позволяет эффективно управлять отдельными системами. Однако при масштабировании этих подходов на архитектуры с большим количеством агентов, которые поддерживаются в течение длительного времени, возникают сценарии, где работа и развитие продолжаются непрерывно при возникновении сложных задач или долгосрочных кризисов. В таких случаях необходимо начинать использовать дополнительные данные или guardrails, которые позволяют агентам управлять своей памятью безопасным, проверяемым и аудируемым образом.
Стоит отметить, что хотя подобные практики чрезвычайно эффективны, например, при решении задач программирования, они никоим образом не ограничиваются только кодингом. Память постоянно используется при создании презентаций, где учитывается контекст того, как именно предпочитает писать автор, как должны выглядеть слайды и так далее, и этот опыт развивается со временем. Данный подход абсолютно не является специфичным исключительно для написания кода.
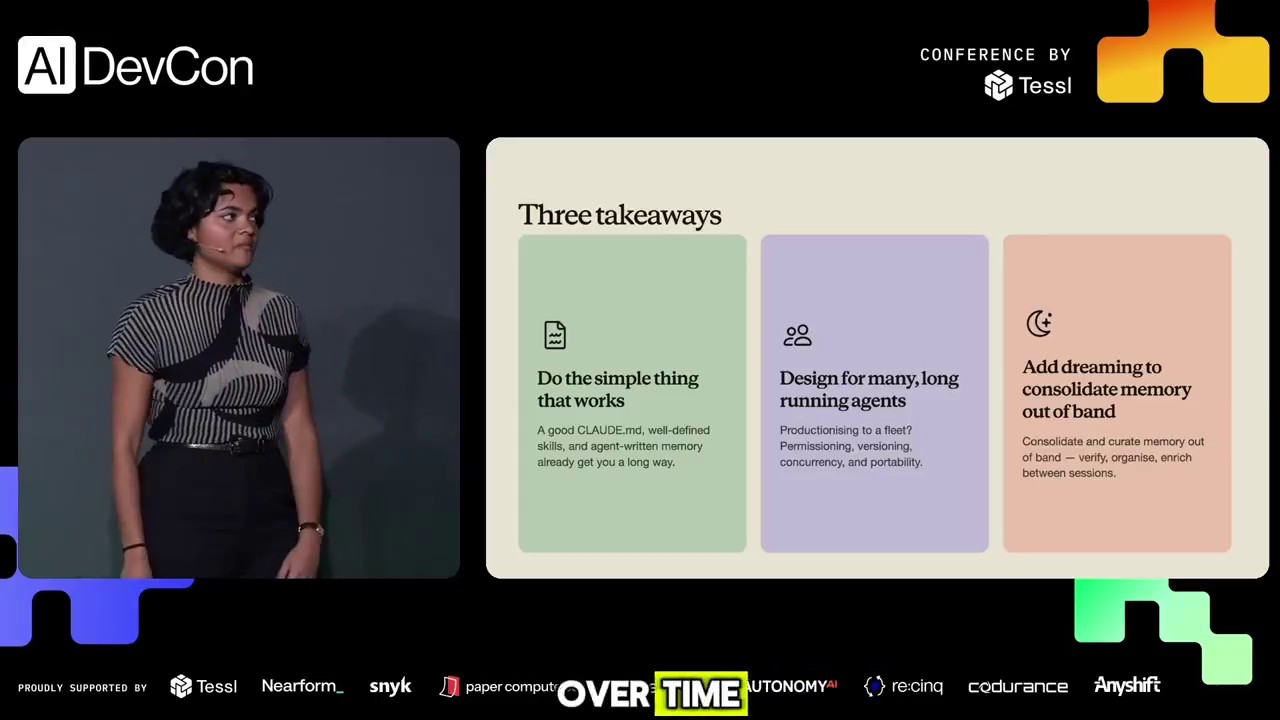
В завершение процесса, если действительно хочется замкнуть цикл, следует подумать о добавлении дополнительного внеполосного процесса, называемого «сновидением» (dreaming), который служит для консолидации памяти, удаления больше не актуальной информации, добавления того, чего агентам не хватает, а также для очистки и организации систем памяти.
Подводя итог, весь этот путь в области контекстной инженерии во многом прошел всего лишь за последний год. Это чрезвычайно открытая область исследований и разработок, в которой видятся огромные перспективы на будущее. Лектор выражает огромный энтузиазм по поводу того, какие именно типы вкладов и достижений все присутствующие смогут внести в эту сферу, и призывает продолжать думать, продолжать учиться и продолжать движение вперед.
Сессия вопросов и ответов
Вопросы по реализации хранилища памяти и архитектуре
Отступление от темы
Лектор благодарит выступающего по имени Lamys за презентацию и предлагает задать вопросы в аудитории, после чего переходит к вопросу от слушателя.
Слушатель задает вопрос о том, есть ли какая-то конкретная реализация хранилища памяти (memory store implementation), которую можно было бы предложить или порекомендовать для изучения, упоминая при этом, что сейчас он просто складывает файлы на свой ноутбук, но хотел бы посмотреть на что-то более серьезное и масштабное.
В ответ на это обсуждение затрагивает поведенческие аспекты и архитектуру, используемую в организационных хранилищах для компьютеров. Лектор поясняет, что реализация подобных механизмов работы с записями и хранилищами задействуется через API и современные инструменты управления, упоминая при этом облачные сервисы и инфраструктуру для управления такого рода данными.
Масштабирование систем памяти и механизмы контроля доступа
Обсуждается вопрос масштабирования систем памяти на уровне enterprise, в частности при наличии сотен пользователей с различными наборами прав доступа (permission sets). Возникает вопрос: как убедиться, что процессы «сновидений» (dreaming) следуют тем же защитным барьерам (guardrails), если они происходят вне основного цикла (out of band), а контекст отличается от того, который имеет агент при использовании его пользователем?
В качестве ответа поясняется, что эти механизмы хорошо комбинируются между собой. При настройке процедуры dreaming можно точно определить, какие именно стенограммы сеансов (session transcripts) к ней прикрепляются. Это позволяет построить процесс, который зеркально отражает любые права доступа, настроенные для агентов.
Таким образом, при запуске задачи dreaming система не обязательно захватывает абсолютно всё за определенный период времени (хотя такую конфигурацию тоже можно задать). Вместо этого можно производить поиск только по тем стенограммам, которые имеют тот же набор прав доступа (permission set), что и соответствующее хранилище памяти (memory store), обеспечивая тем самым их полное соответствие.
Вопросы версионирования, консистентности и возврата к базам данных
This was really, really interesting. I found it fascinating earlier when you were mentioning about versioning, concurrency, durability, all these things. At what point are we reinventing databases from first principles again?
Yeah, this is an interesting point. I still think... One of the things that... This is a good reminder for me that's something I didn't say. What we're trying to do here is find the right boundary to draw between letting of these agents autonomously act, and then also which things should just be kind of programmatic things that are baked into the harness. And so I think what you allude to is, first of all, we were just kind of letting these agents write in markdown files and just commit whatever they wanted, and now we're kind of seeing, having seen which primitives work really well, we're thinking about kind of codifying that in the harness.
And so when we think about the hashing or the versioning, yeah, we are kind of going back to the software engineering principles that we've seen work well in the past, but in a way that autonomous agents can act and can interact with those really effectively. So I think to some extent, we sort of are merging back into those practices, but that's because we have enough signal now to know that those things should just be done in a very deterministic way, and there's no need to reinvent the wheel. I hope that answers your question.
Отступление от темы
Perfect. We're absolutely out of time. thank you once again big round of applause for lamix thank you