Конспект лекции
Комп 3
Введение в архитектуры RISC-V, x86 и ARM
Вводная беседа и отличие архитектур RISC от CISC
Лектор начинает занятие с технических моментов подключения оборудования, после чего переходит к вопросам к аудитории о предыдущих курсах и архитектуре RISC-V. Обсуждается расширение буквы V, а также базовые отличия архитектур RISC и CISC.
Отступление от темы
Лектор настраивает подключение, просит соединиться и нажать нужную кнопку, комментируя процесс словами «О, щось новеньке. Ну, якщо ніхто нічого не робив, то можна їхати далі. Логічно». Также по ходу беседы со студентами возникают отвлеченные диалоги про то, кто учился на первом курсе, упоминаются конкретные студенты (Бавишев, Самодуров) и преподаватели (Кириленко), а также шутки про отчисление за невнятные ответы и спасение репутации всего третьего курса.
В ходе обсуждения архитектур лектор разбирает ошибочные ответы студентов о размерах инструкций (например, утверждение, что все инструкции занимают 4 байта, опровергается — в RISC-V бывают инструкции длиной и по 2 байта, и по 4 байта). Также затрагиваются особенности команд вроде load immediate, принимающих регистр и число, и операции сложения, работающие с регистрами destination, source и числовыми значениями. Грубо говоря, архитектура предполагает разделение подходов к работе с данными и инструкциями.
История x86, особенности Load/Store и микроархитектура
Существуют архитектуры, где предусмотрены отдельные инструкции для работы с памятью, которые называются Load/Store-архитектура. В таких системах используются специальные инструкции, в отличие от архитектуры x86, где всё находится вперемешку. Исторически x86 развивался ради удобства человека, потому что в 1980-х годах инструкции ассемблера писались вручную. Для человека было важно, чтобы на этом было удобно программировать, поэтому появлялись высокоуровневые инструкции, которые делают много действий сразу и могут занимать в памяти около 6 байт, наряду с простыми и понятными инструкциями, занимающими 1 байт.
Отступление от темы
Современные процессоры выпускают Intel, AMD, а также некоторые другие производители. Можно вспомнить мертвых производителей или компании из прошлого, такие как VIA, которая занималась этим в 90-х, но уже сдохла. Также в прошлом десятилетии AMD вела какие-то исследования совместно с китайцами на тему улучшения AMD64. Когда их отношения завершились, у китайцев неожиданно остались права по китайскому законодательству на то, что они исследовали, и де-факто они могут выпускать x86. Писали, что у них даже есть свои китайские x86 (то ли задизайненные, то ли уже выпущенные), но название я не помню, читал на «похоронившимся» ресурсе.
С течением времени получилось так, что некоторые инструкции, занимающие 1 байт, де-факто перестали использоваться, потому что они работают медленно. Например, современные компиляторы не используют инструкцию доставания элемента со стека напрямую, а занимаются сложением указателя на стек с числом. Это обусловлено тем, как устроены современные процессоры.
Из-за того, что в x86 (и x86-64) исторически много инструкций разной длины, процессору сложно понимать, что написано перед ним, так как инструкция может занимать от 1 до 6 байт. Процессор должен прочитать первый байт, понять, нужно ли читать второй, затем понять, нужно ли читать третий, и так далее. Исторически на этом было удобно программировать, но сейчас некоторые из тех удобных инструкций на современных процессорах де-факто не используются и тормозят сильнее, чем длинные инструкции. Поэтому когда компилятор занимается компиляцией, ему важно знать не просто архитектуру, а конкретную линейку микроархитектуры.
Грубо говоря, конкретный набор команд процессор может реализовать по-разному: сделать одно ядро, два ядра, три ядра, или реализовать большее или меньшее количество сумматоров. Это возвращает нас к вопросу с прошлой летучки про instruction-level parallelism (параллелизм на уровне инструкций), когда суммирование в цикле можно организовать так, чтобы отдельно складывать четные и нечетные позиции. Тем самым суммирование будет происходить одновременно, поскольку в процессоре есть два сумматора, которые могут это выполнять параллельно. Короче говоря, x86 — это такой legacy, и она...
Сравнение ARM и RISC-V, практическое применение ассемблера
Архитектура x86 является устаревшей и тянет за собой груз совместимости с прошлыми решениями, поэтому в определенный момент некоторые разработчики решили создать всё заново и по-другому. Так появилась архитектура ARM, расшифровывающаяся как Advanced RISC Machine. Современные микропроцессоры ARM на практике ушли далеко вперед: в них напихано столько возможностей, что это уже больше похоже на CISC, чем на RISC, хотя это отчасти шутка. Компания ARM занимается тем, что разрабатывает процессоры и просит лицензионные отчисления у компаний, которые физически печатают эти процессоры в кремнии.
Отступление от темы
Ну а чтобы денежку не платить, можно без ARM жить. Вот так появился примерно RISC-V, который пятый. У меня в голове V, и я уже не знаю, когда я переучусь. Поэтому держитесь.
Лектор объясняет, что расскажет поверхностно о том, что представляет собой эта архитектура и как на ней программировать. Необходимость работать с ассемблером часто возникает при написании простых компиляторов: когда создается базовая вещь, она может взрываться по количеству инструкций, генерируемых в ассемблерном коде. Если сгенерированный код работает — это хорошо, но если он не работает, разобраться в нем крайне сложно. В таких ситуациях лектору приходилось брать ассемблерный код и вручную редактировать его, чтобы сделать покороче, но при этом воспроизвести проблему. Без навыков программирования на ассемблере подобное редактирование невозможно, поэтому базовый навык написания элементарных вещей вроде факториалов на ассемблере желательно иметь. К счастью, это не так уж сложно и не требует изучения сложных языков вроде Kotlin. Для дальнейшего понимания необходимо разобраться с тем, как устроен ассемблер.
Структура программы на ассемблере RISC-V
Основы ассемблера: секции, типы данных и программа Hello World
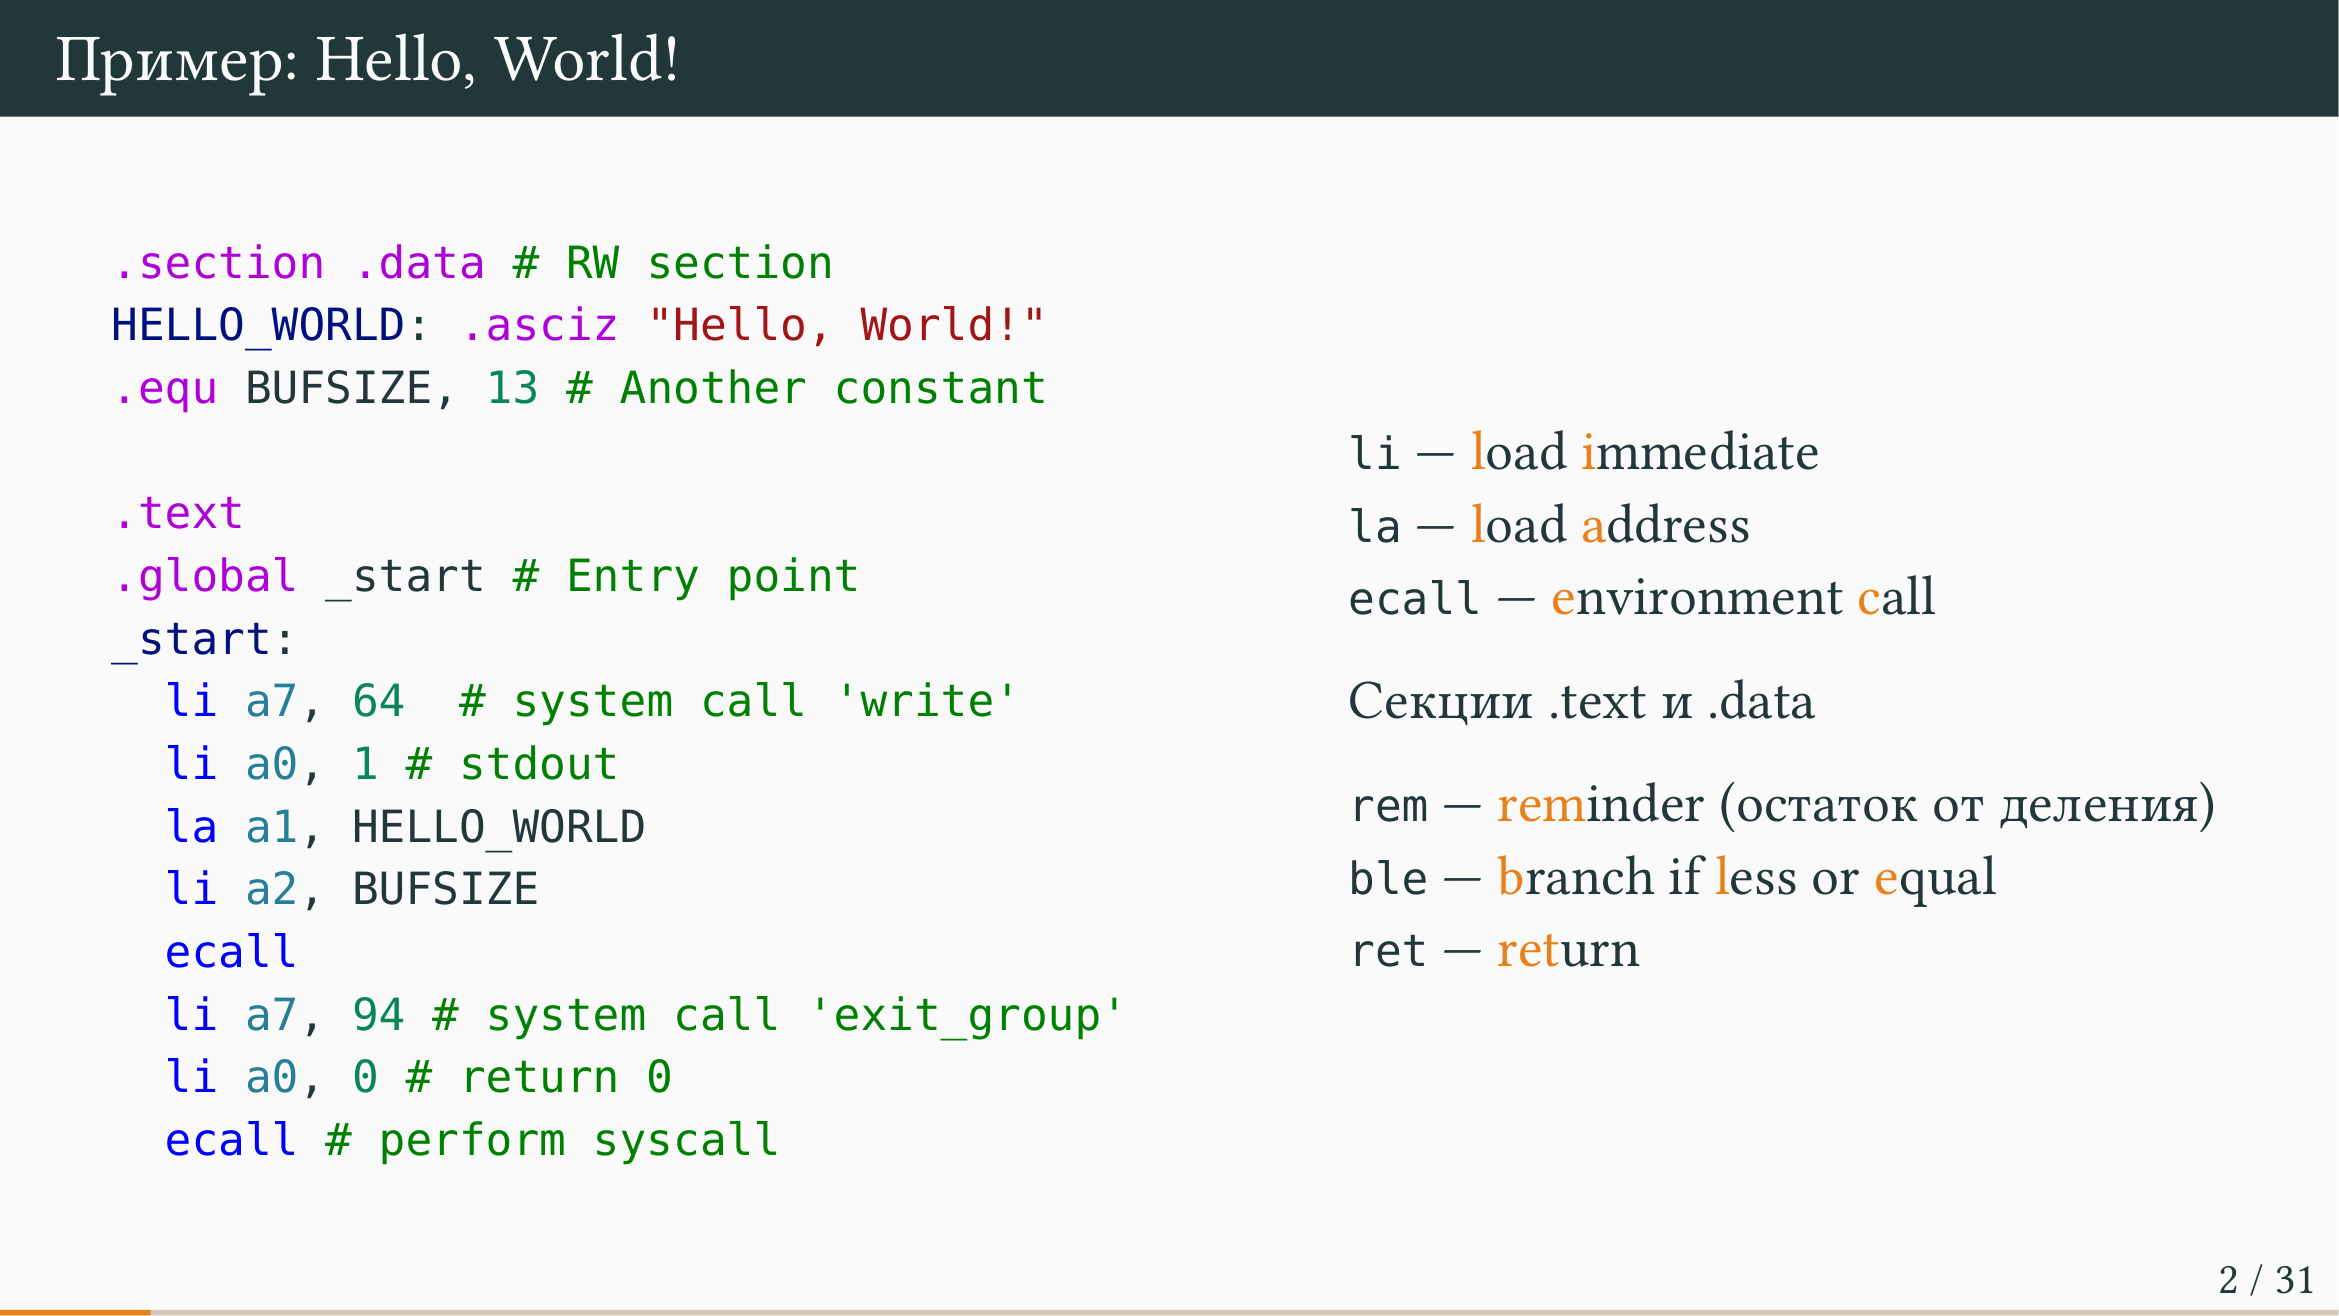
В ассемблере программа делится на разделы, или секции. Самый важный раздел – .text, в котором написан текст программы, он же код. Также есть раздел с данными – .data, где записаны данные. Разделов с данными бывает много, и они могут быть как только для чтения, так и для чтения и записи, куда можно и читать, и писать.
Отступление от темы
так уж сложно, не как Kotlin, короче говоря.
В данных можно создавать константы. Константы бывают целочисленные, и у них бывает много видов: байты, слова. С точки зрения размеров: byte – это 8 бит, word (слово) – 16 бит, doubleword (двойное слово) – 32 бита, quadword (четверное слово) – 64 бита.
Для задания чисел используются специальные директивы, но на слайдах в качестве примера задается строка в кодировке ASCII. Директива .asciz означает, что строка заканчивается нулевым байтом (само ставит слэш 0 в конце), чтобы это была ASCIIZ-строка. Константы также можно создавать с помощью директивы .equ, которая работает примерно как #define в C (например, .equ BUFSIZE, 13). Самая распространенная ошибка при выводе «Hello, World!» — это неправильный расчет длины строки, так как сама фраза «Hello, World!» с восклицательным знаком и пробелом занимает ровно 13 байт.
После секции данных пишется текст программы. В тексте программы всегда заводится так называемая глобальная метка (с помощью директивы .global), с которой программа начинается. В Linux принято называть эту метку _start (с подчеркивания). Метка _start не является main в привычном понимании, хотя в данном случае она отрабатывает роль main.
Далее в секции _start пишутся команды ассемблера, которые состоят из мнемоник и аргументов этих команд. Самая простая инструкция — это li (load immediate), которая загружает непосредственную константу в регистр. Регистров в архитектуре строго 32 штуки. Если их именовать канонично, то используются имена от x0 до x31, но для удобства многим даны человеческие имена, такие как a0, a7, t0 и другие.
На примере программы вывода «Hello, World!» процесс выглядит следующим образом. Сначала в регистр a7 загружается число 64, которое обозначает системный вызов write (написать что-нибудь на терминал). В регистр a0 загружается 1, так как 0 – это stdin, 1 – это stdout (стандартный вывод), а 2 – это stderr. В регистр a1 с помощью инструкции la (load address) загружается адрес строки HELLO_WORLD. В регистр a2 загружается длина строки (BUFSIZE, равная 13). После подготовки аргументов вызывается инструкция ecall (environment call), которая делает системный вызов операционной системе, чтобы она выполнила операцию записи на терминал.
После вывода текста программу необходимо аккуратно завершить. Для этого делается другой системный вызов с кодом 94 (exit_group). Ему требуется всего один аргумент в регистре a0, куда кладется 0, что соответствует return 0 из функции main на языке C. Затем выполняется второй ecall, и программа без проблем завершается. То, что пишется на языке C, на самом деле неявным образом вызывает именно такие низкоуровневые конструкции.
Отступление от темы
Если что, можно задавать вопросы. Я не знаю, насколько это сложно, может быть, вам это уже рассказывали. Кто-нибудь такое уже видел? Поднимите руку. На сях было? Или на усях? А, то есть вы все это знаете. Короче, если вы это все знаете, вы просто кричите я буду ехать дальше и быстрее.
Важно помнить, что мнемоники имеют сокращения, а в программе используются разные разделы. В ассемблере нет развитой системы типов, которая будет «бить вас по рукам» за ошибки — процессор просто будет исполнять то, что написано, и аварийно завершаться (segfault), когда увидит какой-то бредовый код.
На слайде также приведены другие полезные мнемоники: rem (reminder) — остаток от деления, ble (branch if less or equal) — переход, если меньше или равно, и ret (return) — возврат из функции.
Метки, ветвления и пример с вычислением факториала
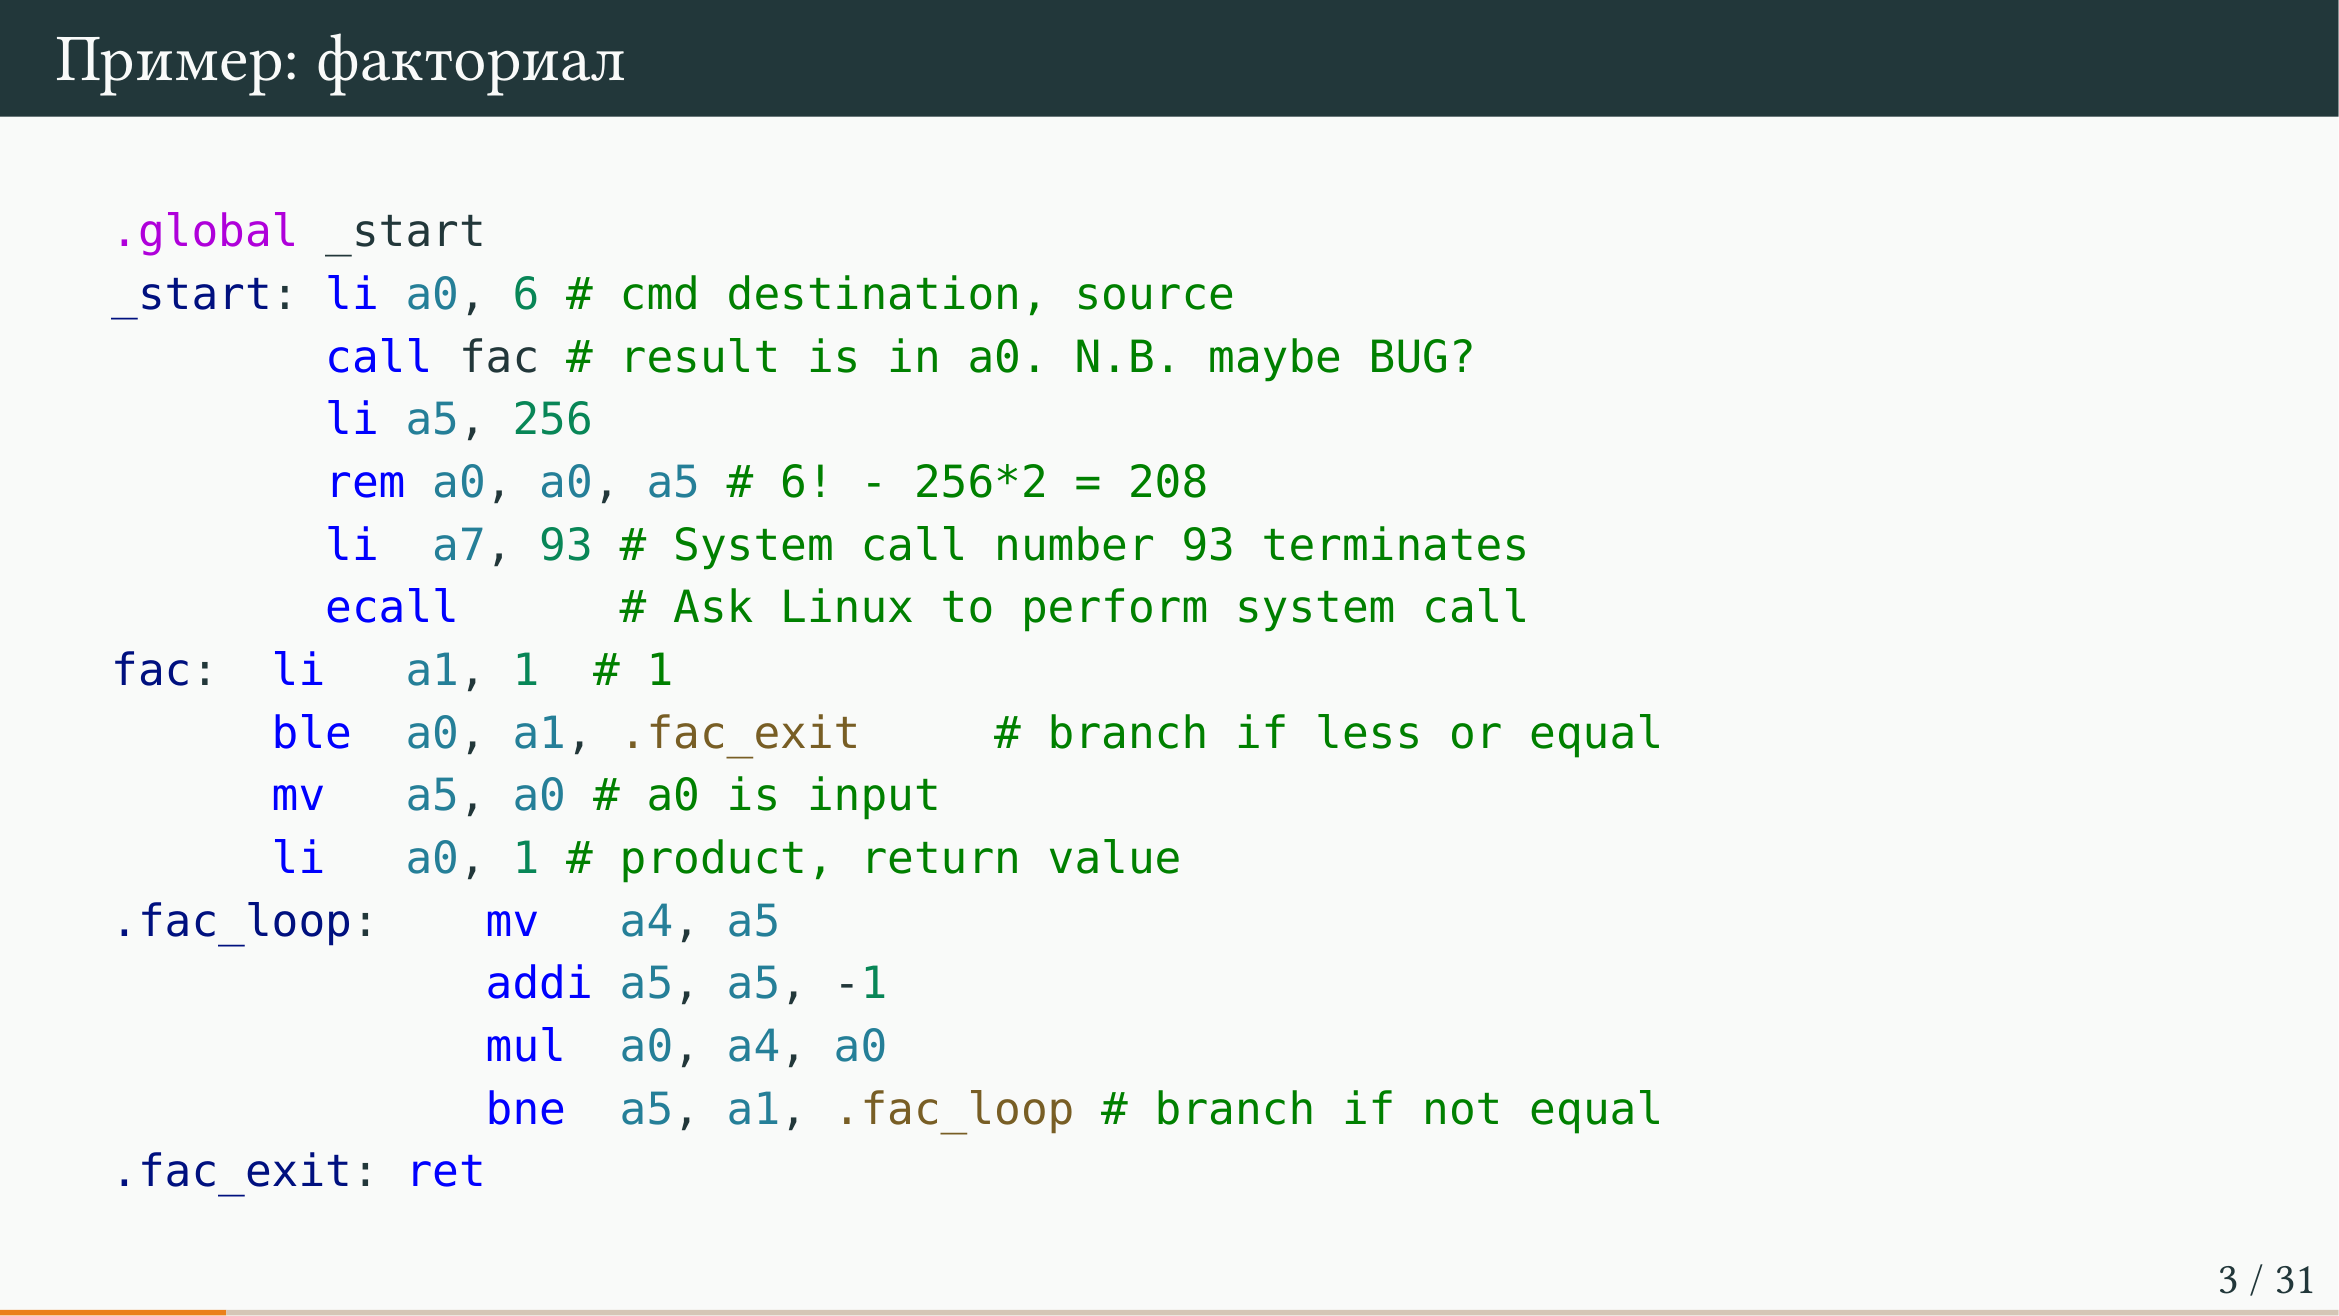
В ассемблере для организации переходов используются метки, на которые можно прыгать с помощью инструкций безусловного перехода jump и условных переходов, таких как branch (например, bne — branch if not equal или ble — branch if less or equal), а также циклов вроде factorial loop. Некоторые метки начинаются с точки, что указывает на то, что это локальные метки. Если не ставить точки, то одинаково названные метки в разных функциях будут слипаться, и компилятор не сможет определить, что именно имел в виду программист. Поэтому при написании генератора кода следует либо аккуратно создавать уникальные имена меток, либо использовать точки в нужных местах. Директива global означает, что сущность глобально доступна. Например, метка _start должна быть глобально доступной, чтобы операционная система могла её вызвать. Метку factorial также можно сделать глобально доступной или локальной; без глобальной доступности невозможно вызвать factorial из другого кода или при линковке с кодом на языке C.
Отступление от темы
Уйду от а нужно ли объяснять факториал кому нужно объяснить факториал вам нужно о кому-то нужно значит придется рассказывать
Рассмотрим пример программы для вычисления факториала. На старте в регистр a0 кладется число 6, которое служит первым аргументом для функции факториала. Далее вызывается функция с помощью инструкции call, и в результате в регистре a0 оказывается искомое значение (так как 6 факториал равен 720). Особенность работы в Linux заключается в том, что exit-код, возвращаемый функцией main (аналог return 0), должен быть размером в один байт. Если вернуть число больше одного байта, программа завершится с ошибкой segmentation fault. Чтобы этого избежать, в коде выполняется деление значения в a0 на число 256, записанное в регистр a5, а именно берётся остаток от деления (rem — remainder). Полученный остаток помещается в регистр a0, в регистр a7 записывается номер системного вызова 93 (отвечающий за завершение программы), после чего вызывается инструкция ecall, и программа успешно завершается с кодом возврата 208 (поскольку 720 по модулю 256 дает примерно столько).
Один из студентов задал вопрос о том, как именно работают локальные метки. Лектор пояснил, что компилятор каким-то образом группирует их по функциям, хотя глубоко в устройство этого механизма он не вникал, но на практике такая система помогает корректно осуществлять переходы, и в его опыте прыжки происходили именно на те метки, на которые ожидалось. Лектор предложил студентам самостоятельно попробовать «сломать» этот механизм и разобраться, как он работает на самом деле.
Компиляция, запуск в QEMU и отладка в GDB
Сборка и запуск программ на RISC-V: Cross-compiler, QEMU и libc
Для компиляции программ под архитектуру RISC-V требуется кросс-компилятор. Кросс-компилятор RISC-V64 можно легко установить из стандартных репозиториев Ubuntu. Если же возникает необходимость компилировать код под RISC-V32, установка напрямую из репозиториев Ubuntu вызовет трудности, так как там может не оказаться нужной кросс-версии стандартной библиотеки libc (содержащей функции вроде malloc, printf и другие необходимые компоненты для линковки). В таком случае рекомендуется скачивать вручную подходящий toolchain (например, от Syntacore или других производителей), в котором присутствует кросс-компилятор для RISC-V32, и прописывать для него корректные пути в системе.
Отступление от темы
Короче, мы ставим кросс-компилятор, GDB MultiArch, который будет дебажить нам всё что угодно, и QEMU...
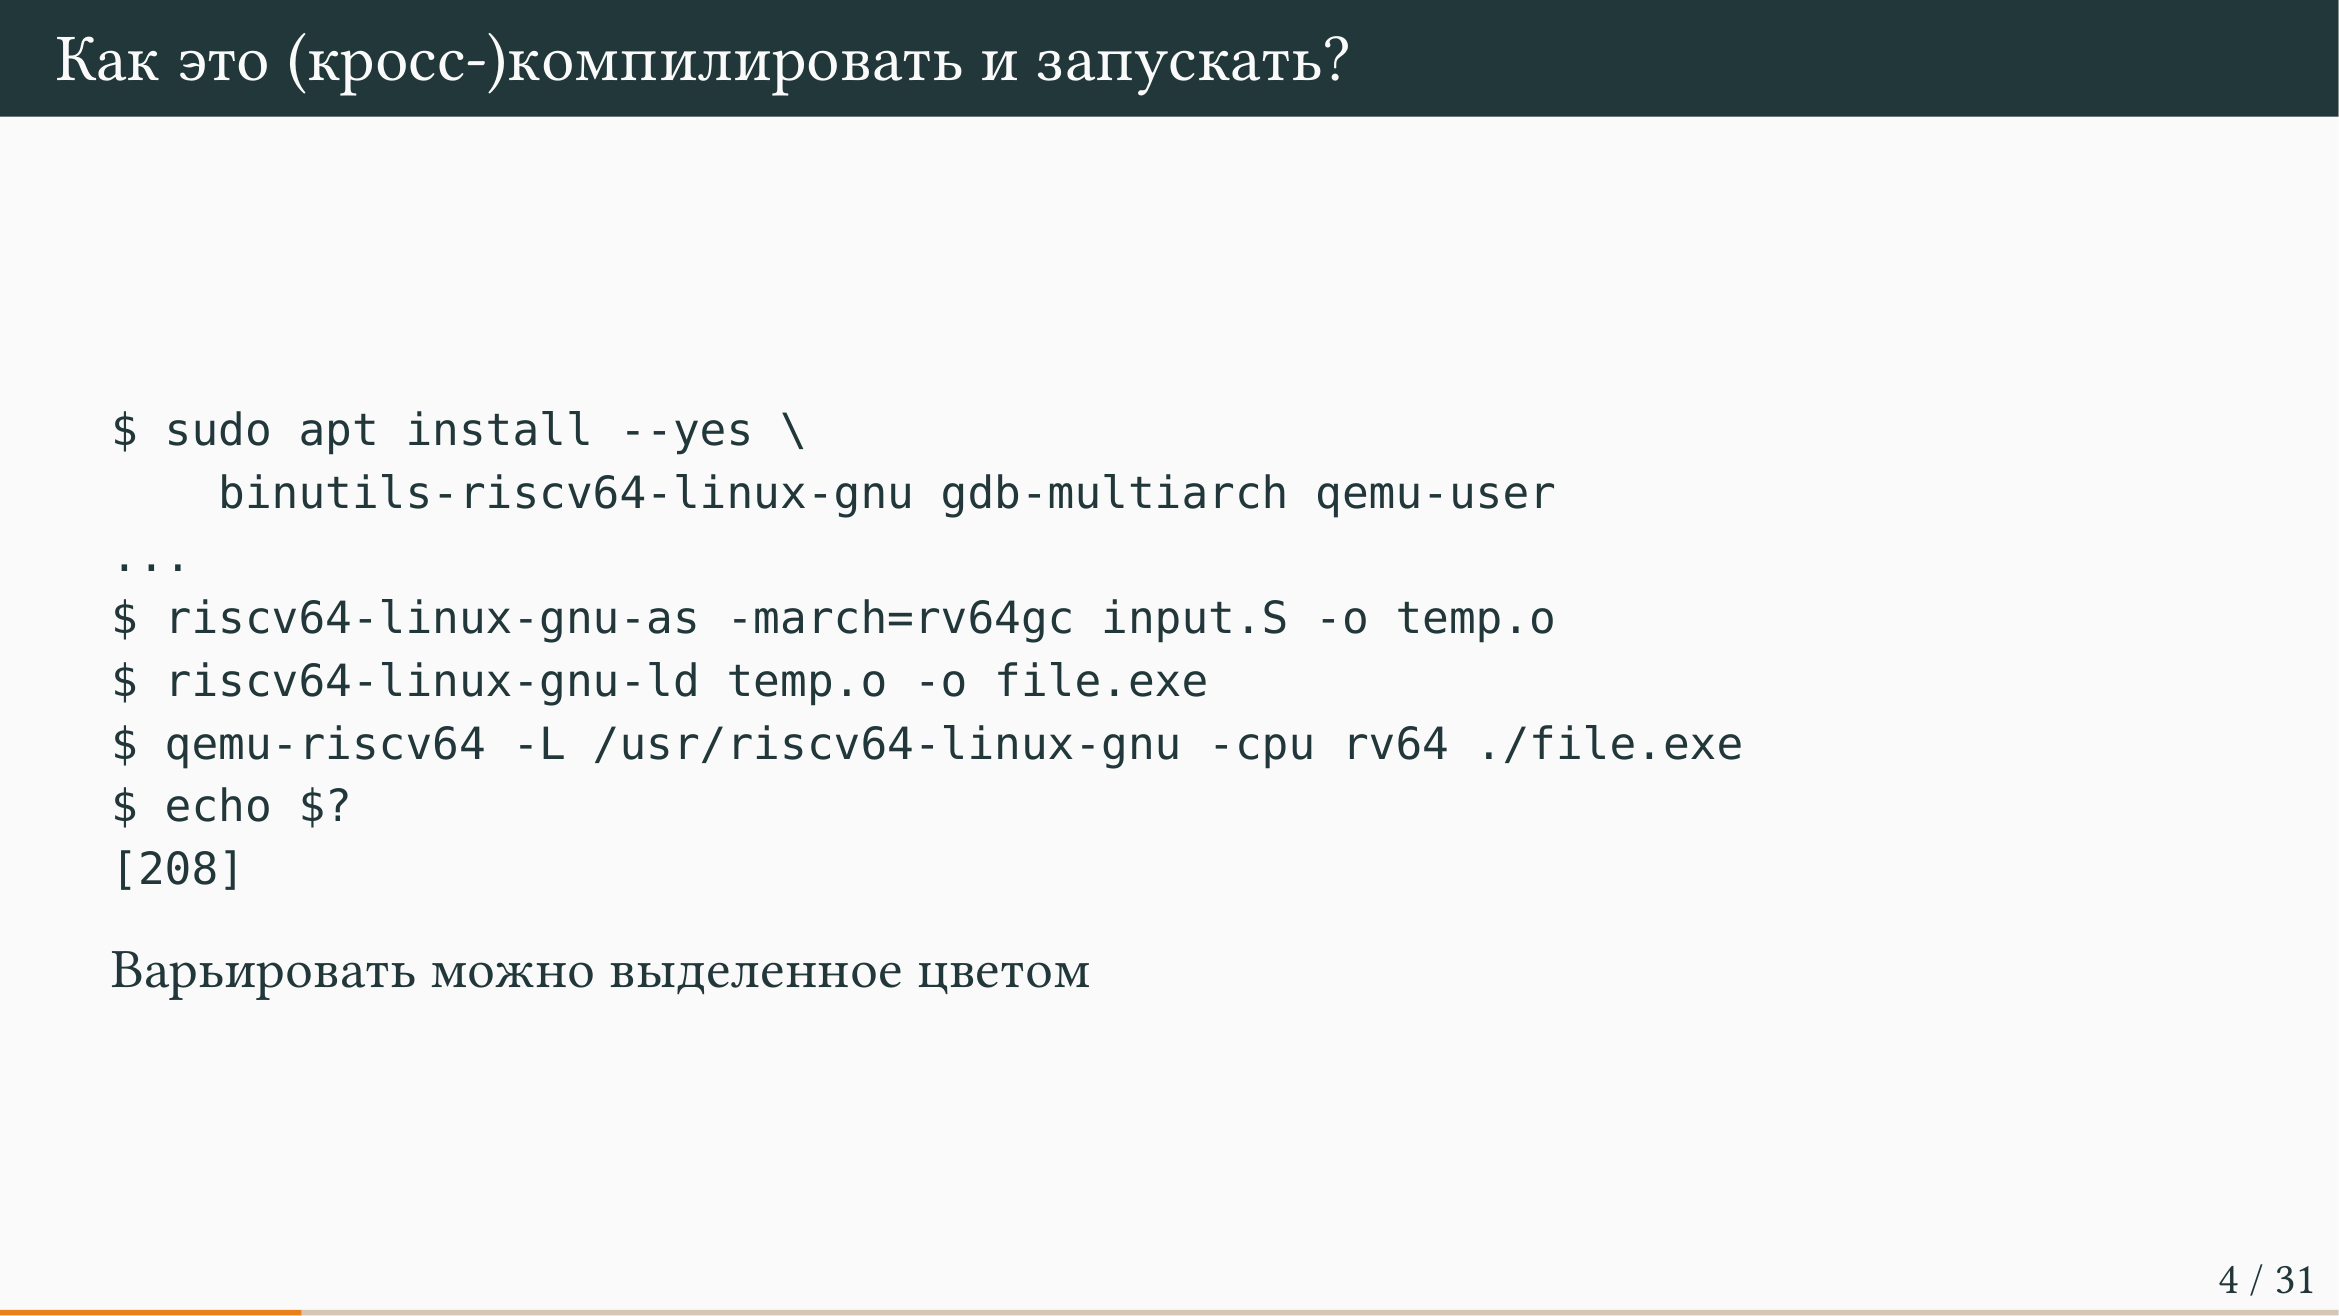
Для работы требуются следующие инструменты: cross-compiler (например, binutils-riscv64-linux-gnu), GDB MultiArch для отладки кода под любые архитектуры и QEMU (qemu-user), который позволяет эмулировать программы для RISC-V32 (или RISC-V64) на том компьютере, где запущена основная ОС (у большинства это архитектура AMD64).
Процесс сборки и запуска выглядит следующим образом. Создаётся файл input.s (суффикс .s является стандартным для ассемблерных листингов, хотя в принципе файлы можно называть и иначе). С помощью ассемблера (riscv64-linux-gnu-as с указанием флага архитектуры, например, -march=rv64gc) исходный файл компилируется в объектный файл (с расширением .o). Затем с помощью компоновщика (riscv64-linux-gnu-ld) из объектного файла собирается исполняемый файл в формате ELF. Полученный ELF-файл передается на исполнение в QEMU с правильным указанием процессора и путей к библиотекам (например, через флаг -L /usr/riscv64-linux-gnu). QEMU исполняет программу и завершается с тем же кодом ошибки, что и сама программа. Проверить код возврата можно стандартной командой оболочки echo $? (например, возвращенное значение 208 соответствует результату деления в примере лекции).
Всё это можно автоматизировать, поместив в Makefile, чтобы собирать и кросс-компилировать исполняемый файл из ассемблера, либо написать конфигурационный файл для Си-систем (если используется сишный листинг, порожденный GCC или LLVM), а затем запускать через QEMU.
Отступление от темы
И так у вас тесты будут сделаны позже. Нормальное название, чего там смеетесь на Камчатке? Всяко лучше, чем XML или YAML, вот.
Отступление от темы
Чем вот это всё отличается от сишечки?
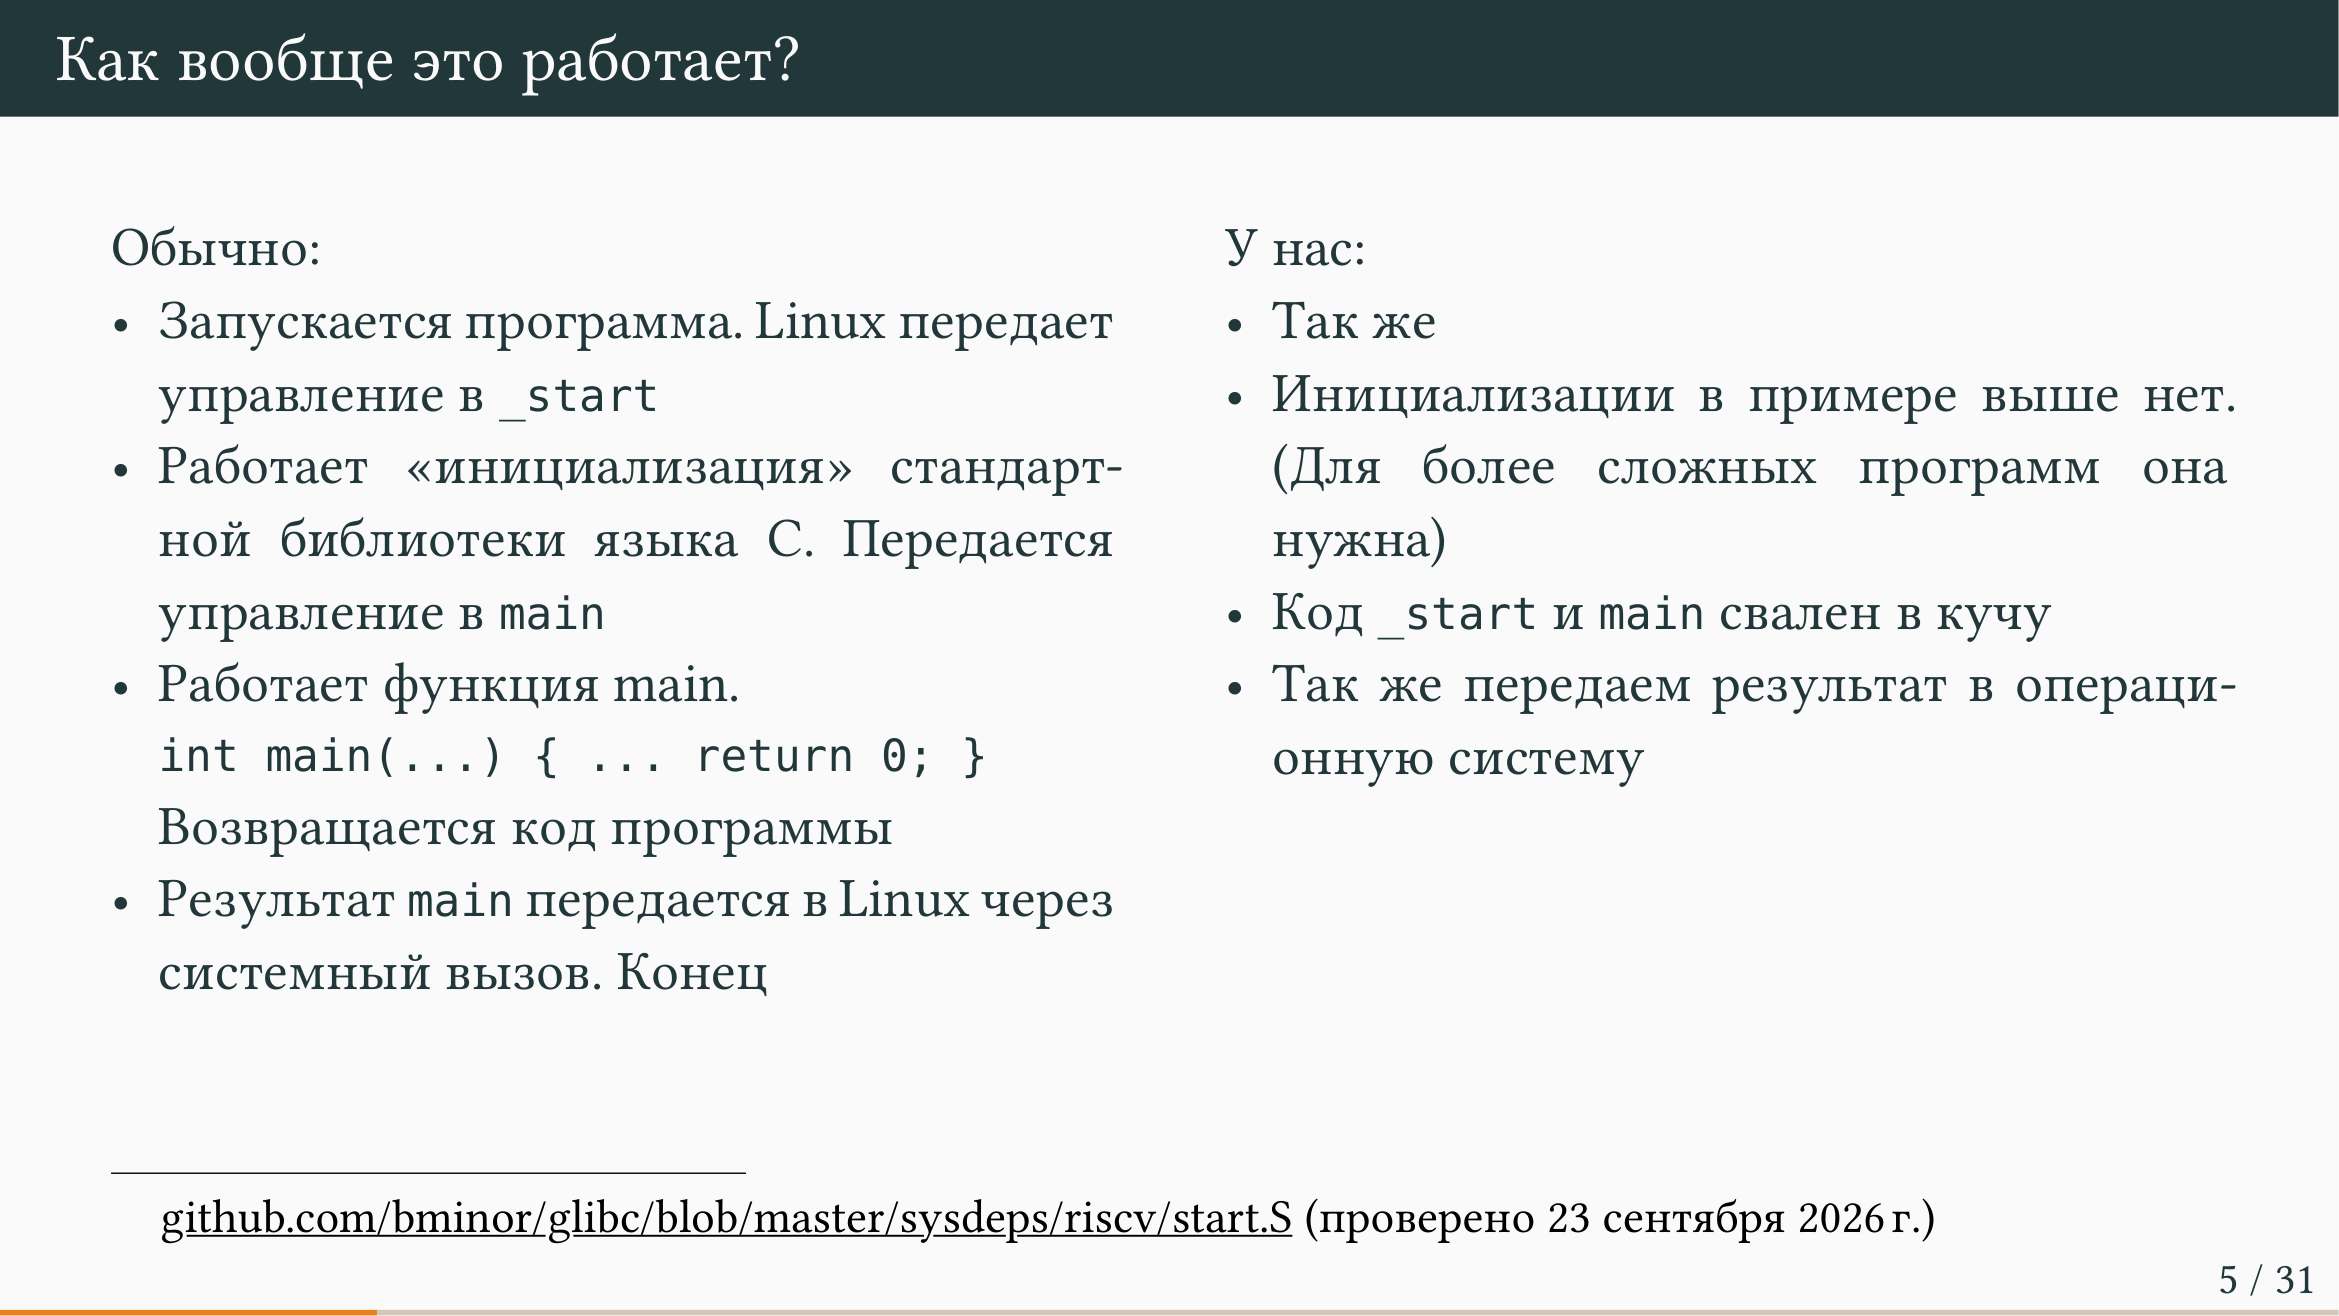
В программах на языке Си всё устроено иначе, поскольку в них неявным образом линкуется стандартная библиотека libc. Внутри libc содержится символ _start, с которого начинается исполнение скомпилированной программы. Функция _start выполняет множество не вполне тривиальных задач по инициализации, после чего передает управление в функцию main (int main(...)), написанную разработчиком.
После того как main отрабатывает и выполняет return 0, управление возвращается обратно в код libc. Библиотека libc производит системный вызов для аккуратного завершения программы с тем самым кодом возврата, который передается в операционную систему. Рассмотренный ранее пример с ассемблером демонстрирует упрощенный подход: как написать программу без использования libc, чтобы она напрямую делала системные вызовы, печатала данные и корректно работала. Написание программ полностью без libc возможно.
Все константы, используемые в системных вызовах, строго специфичны для конкретной связки операционной системы и архитектуры. Например, константы для Linux под RISC-V будут отличаться от констант для Windows, Darwin или любой другой операционной системы.
Отладка кода: Связка QEMU и GDB Multiarch
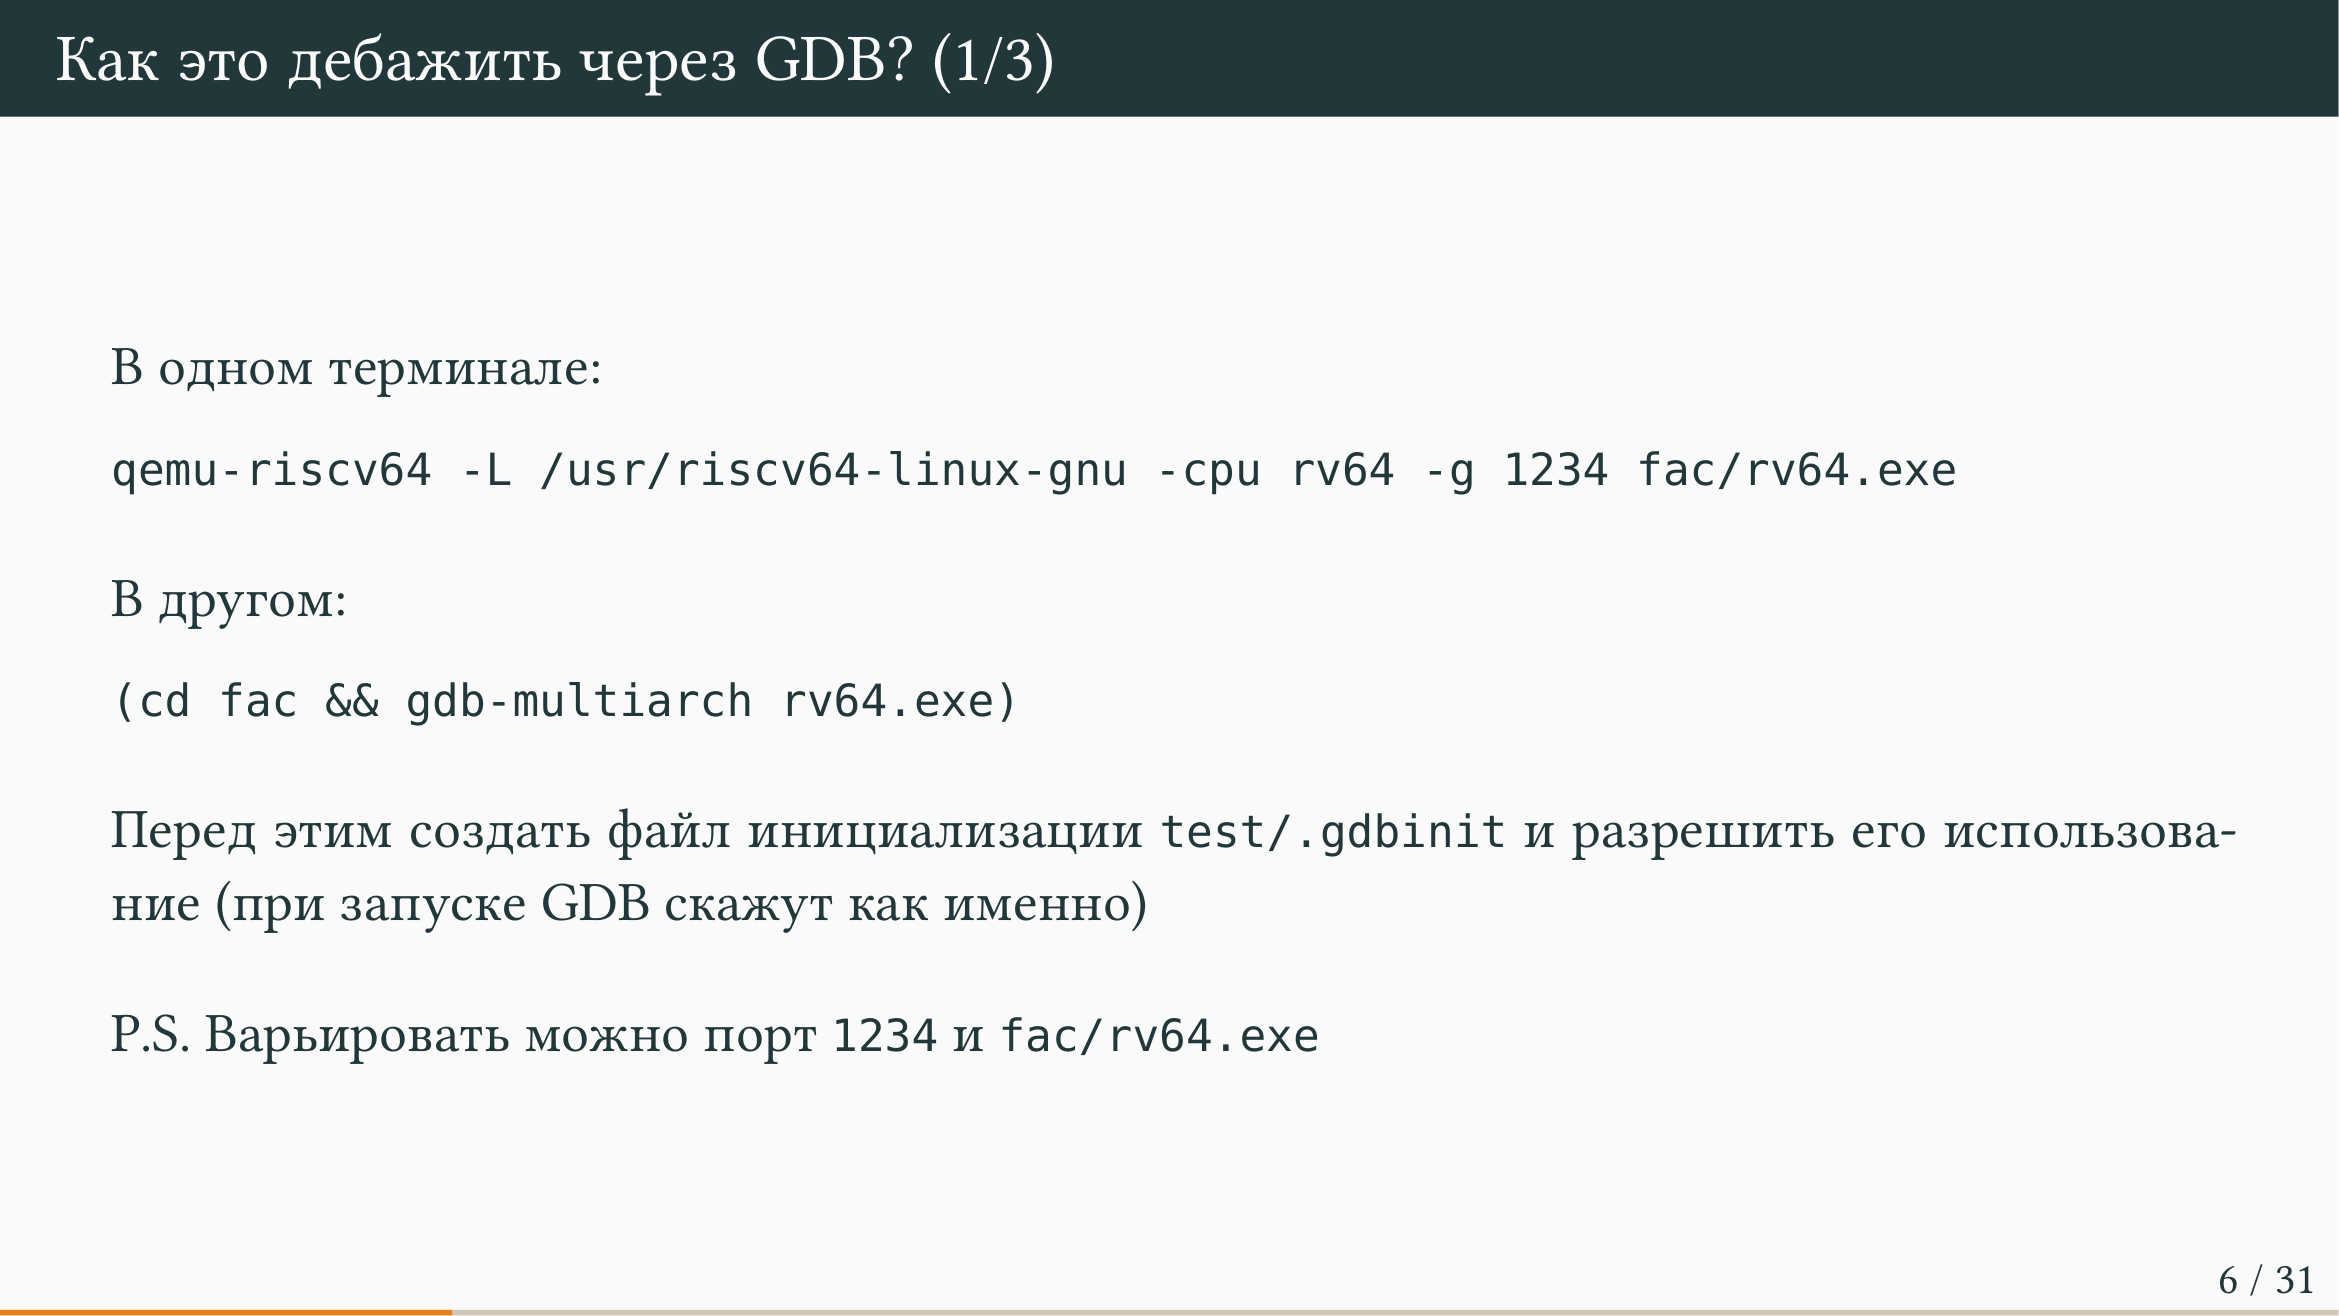
Как отлаживать код, если что-то не работает? Для этого нужно использовать QEMU и передать ей опцию -g, которая запустит её в режиме сервера. QEMU откроет порт и будет ждать соединения от GDB Multiarch, который выступает в роли клиента, подсоединяется к QEMU и позволяет удаленно отлаживать запущенную программу.
Обычно, когда вы отлаживали программы на x86 с помощью GDB на первом курсе, всё запускалось без GDB Multiarch — вы запускали отладку приложения напрямую. При этом вы, скорее всего, замечали странный эффект: если GDB печатает что-то в stderr (например, распечатку стека, регистров или результат выполнения команды вроде help для команды установки брейкпоинта), то этот вывод и вывод stdout вашей программы шли на один и тот же терминал и сливались вместе, что не очень приятно. В принципе, имеет смысл и для нативной системы AMD64 выполнять отладку в клиент-серверном режиме: в одном терминале запускать stdout приложения, а в другом — GDB, и это будет гораздо удобнее. Так что клиент-серверная архитектура и multi-arch полезны не только для RISC-V, но и для нативной разработки.
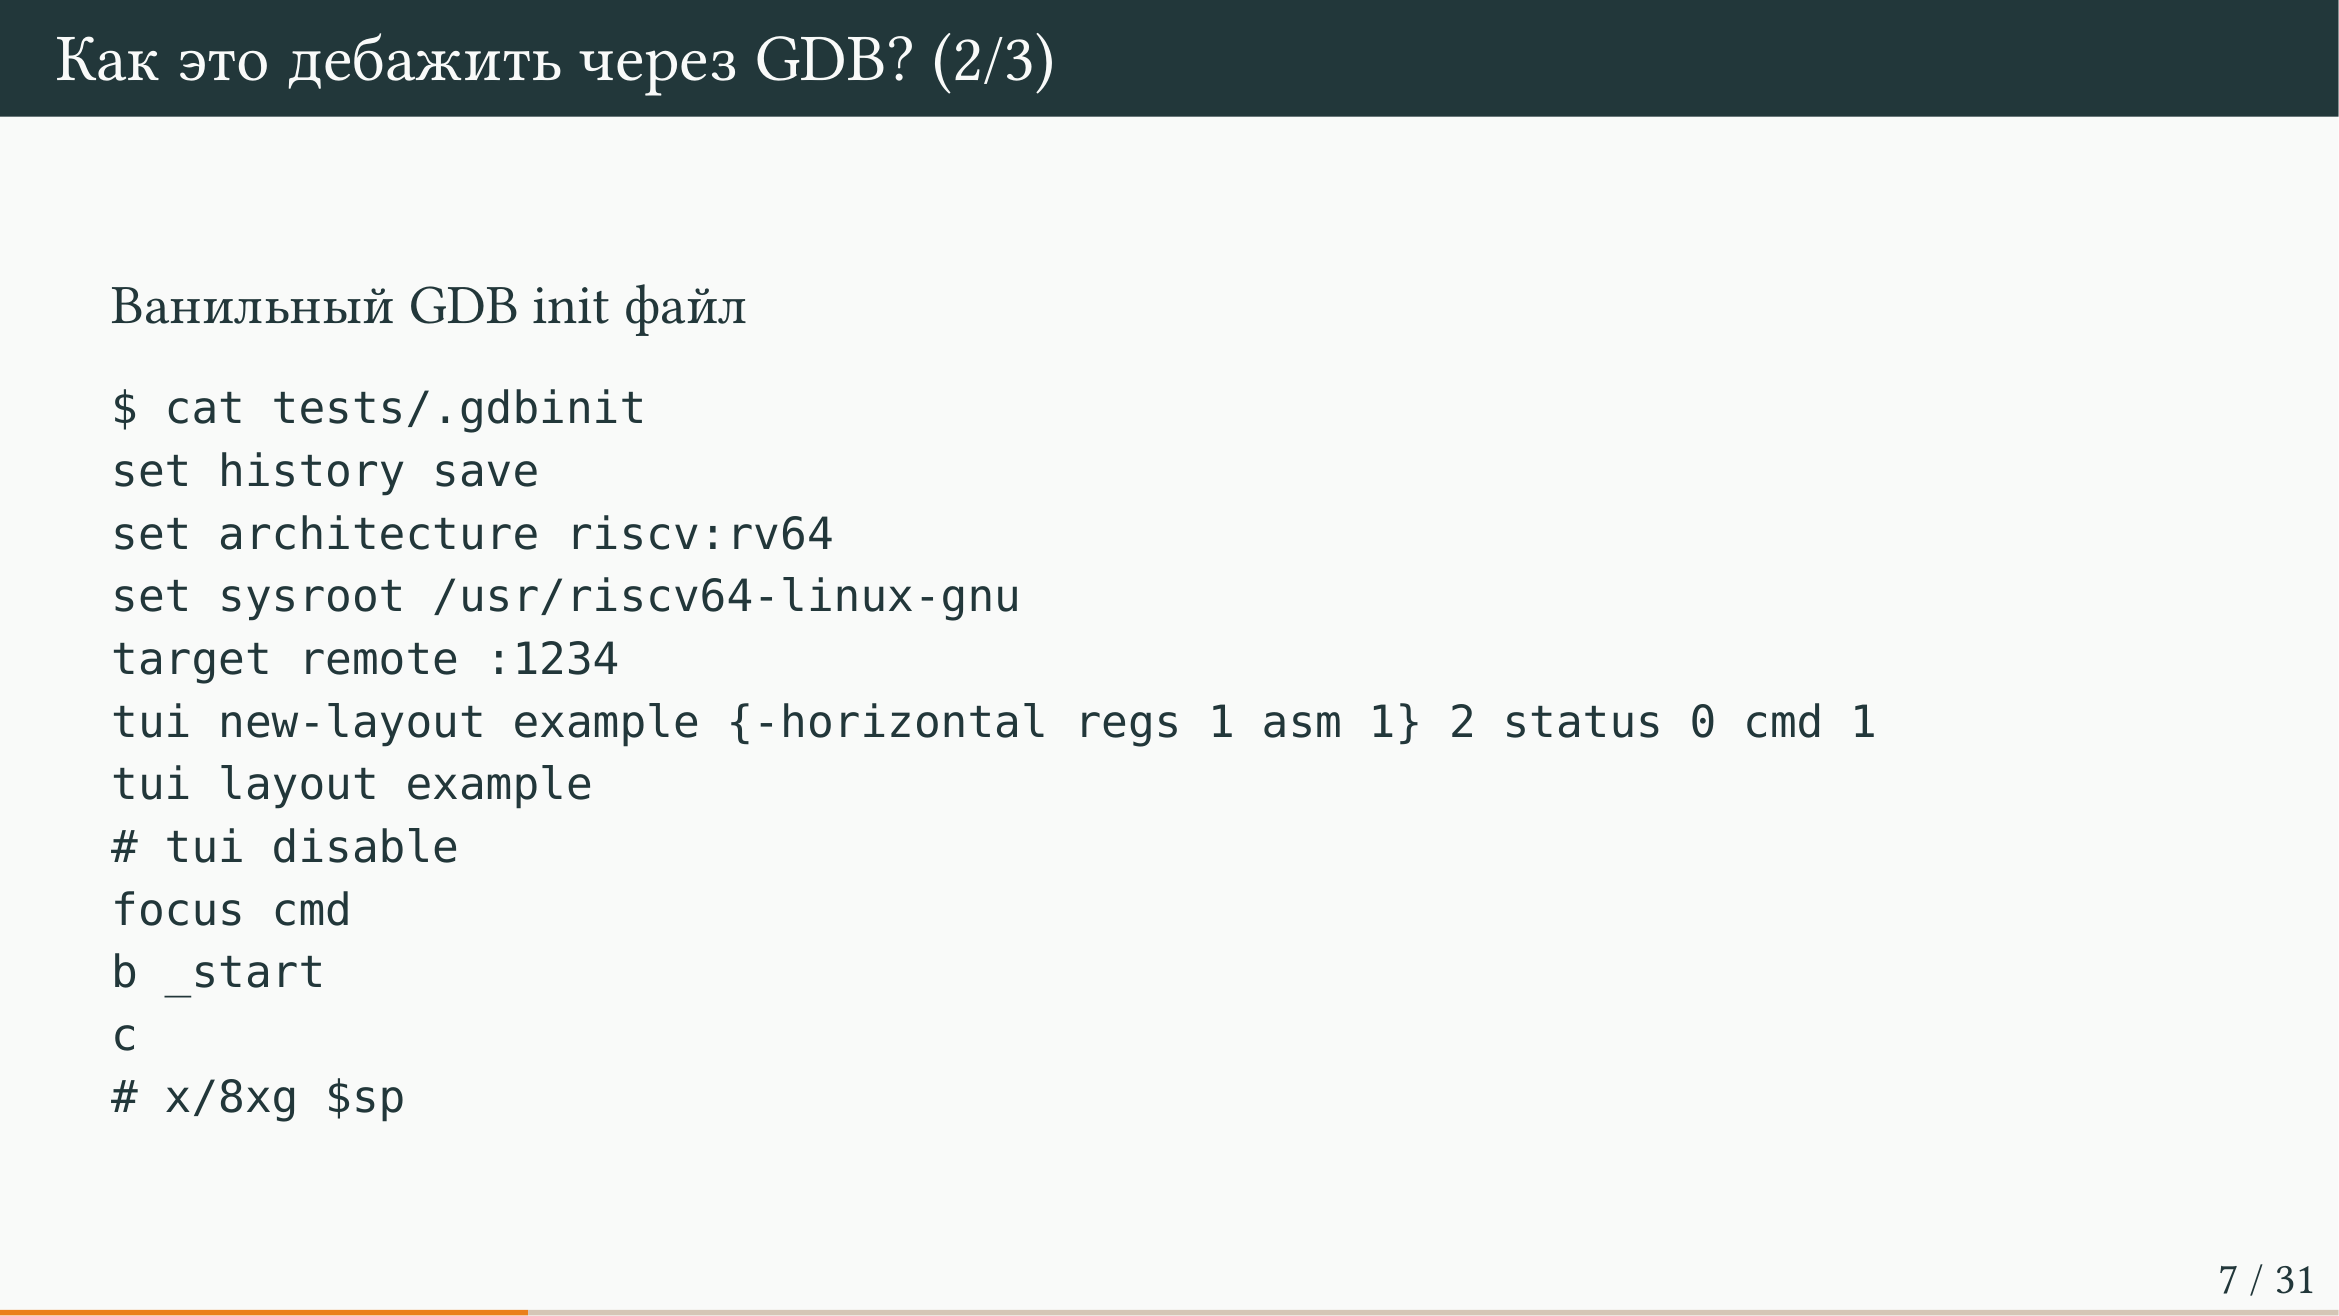
В GDB существуют специальные файлы конфигурации, куда можно записать команды, выполняемые при запуске отладчика. Например, можно настроить сохранение истории, указать архитектуру, задать директорию с полезными файлами, подключиться по указанному порту (как на предыдущем слайде) или настроить TUI (Text User Interface). С помощью TUI можно сделать так, чтобы в отдельных окошках терминала были видны регистры, верхняя часть стека, ассемблерный листинг программы, а также сишный листинг (если вы отлаживаете программу на C). Написание кода предполагается в основном на C или на Rust, но главным образом на C, так что рантайм на Rust писать не нужно. В настройках TUI можно указывать расположение окон (кто сверху, кто снизу), настраивать фокус на нужном окне, а также прописывать команды автоматизации: например, b как сокращение для breakpoint и c как сокращение для continue, после чего отладка идет вперед. При этом всё делается через консоль, без использования мыши. Бывают странные случаи, когда человек попадает в университет, запускает программу исключительно кнопочкой старта в интерфейсе и вообще не понимает, как это работает изнутри, что выглядит довольно грустно.
Среди самых полезных команд в GDB выделяются команды для пошагового выполнения. Это next instruction, которая выполняет буквально одну следующую инструкцию, а также step into, позволяющая зайти внутрь инструкции. В контексте вызовов это означает возможность зайти внутрь вызова и посмотреть, что именно исполняется внутри. Учитывая, что мы имеем дело с ассемблером, правильнее говорить «подпрограмма», потому что такие программы (например, вычисление факториала) могут не заниматься классическим раскладыванием аргументов по соглашениям о вызовах, а просто исполнять то, что им передали.
Основные команды и приемы отладки в GDB
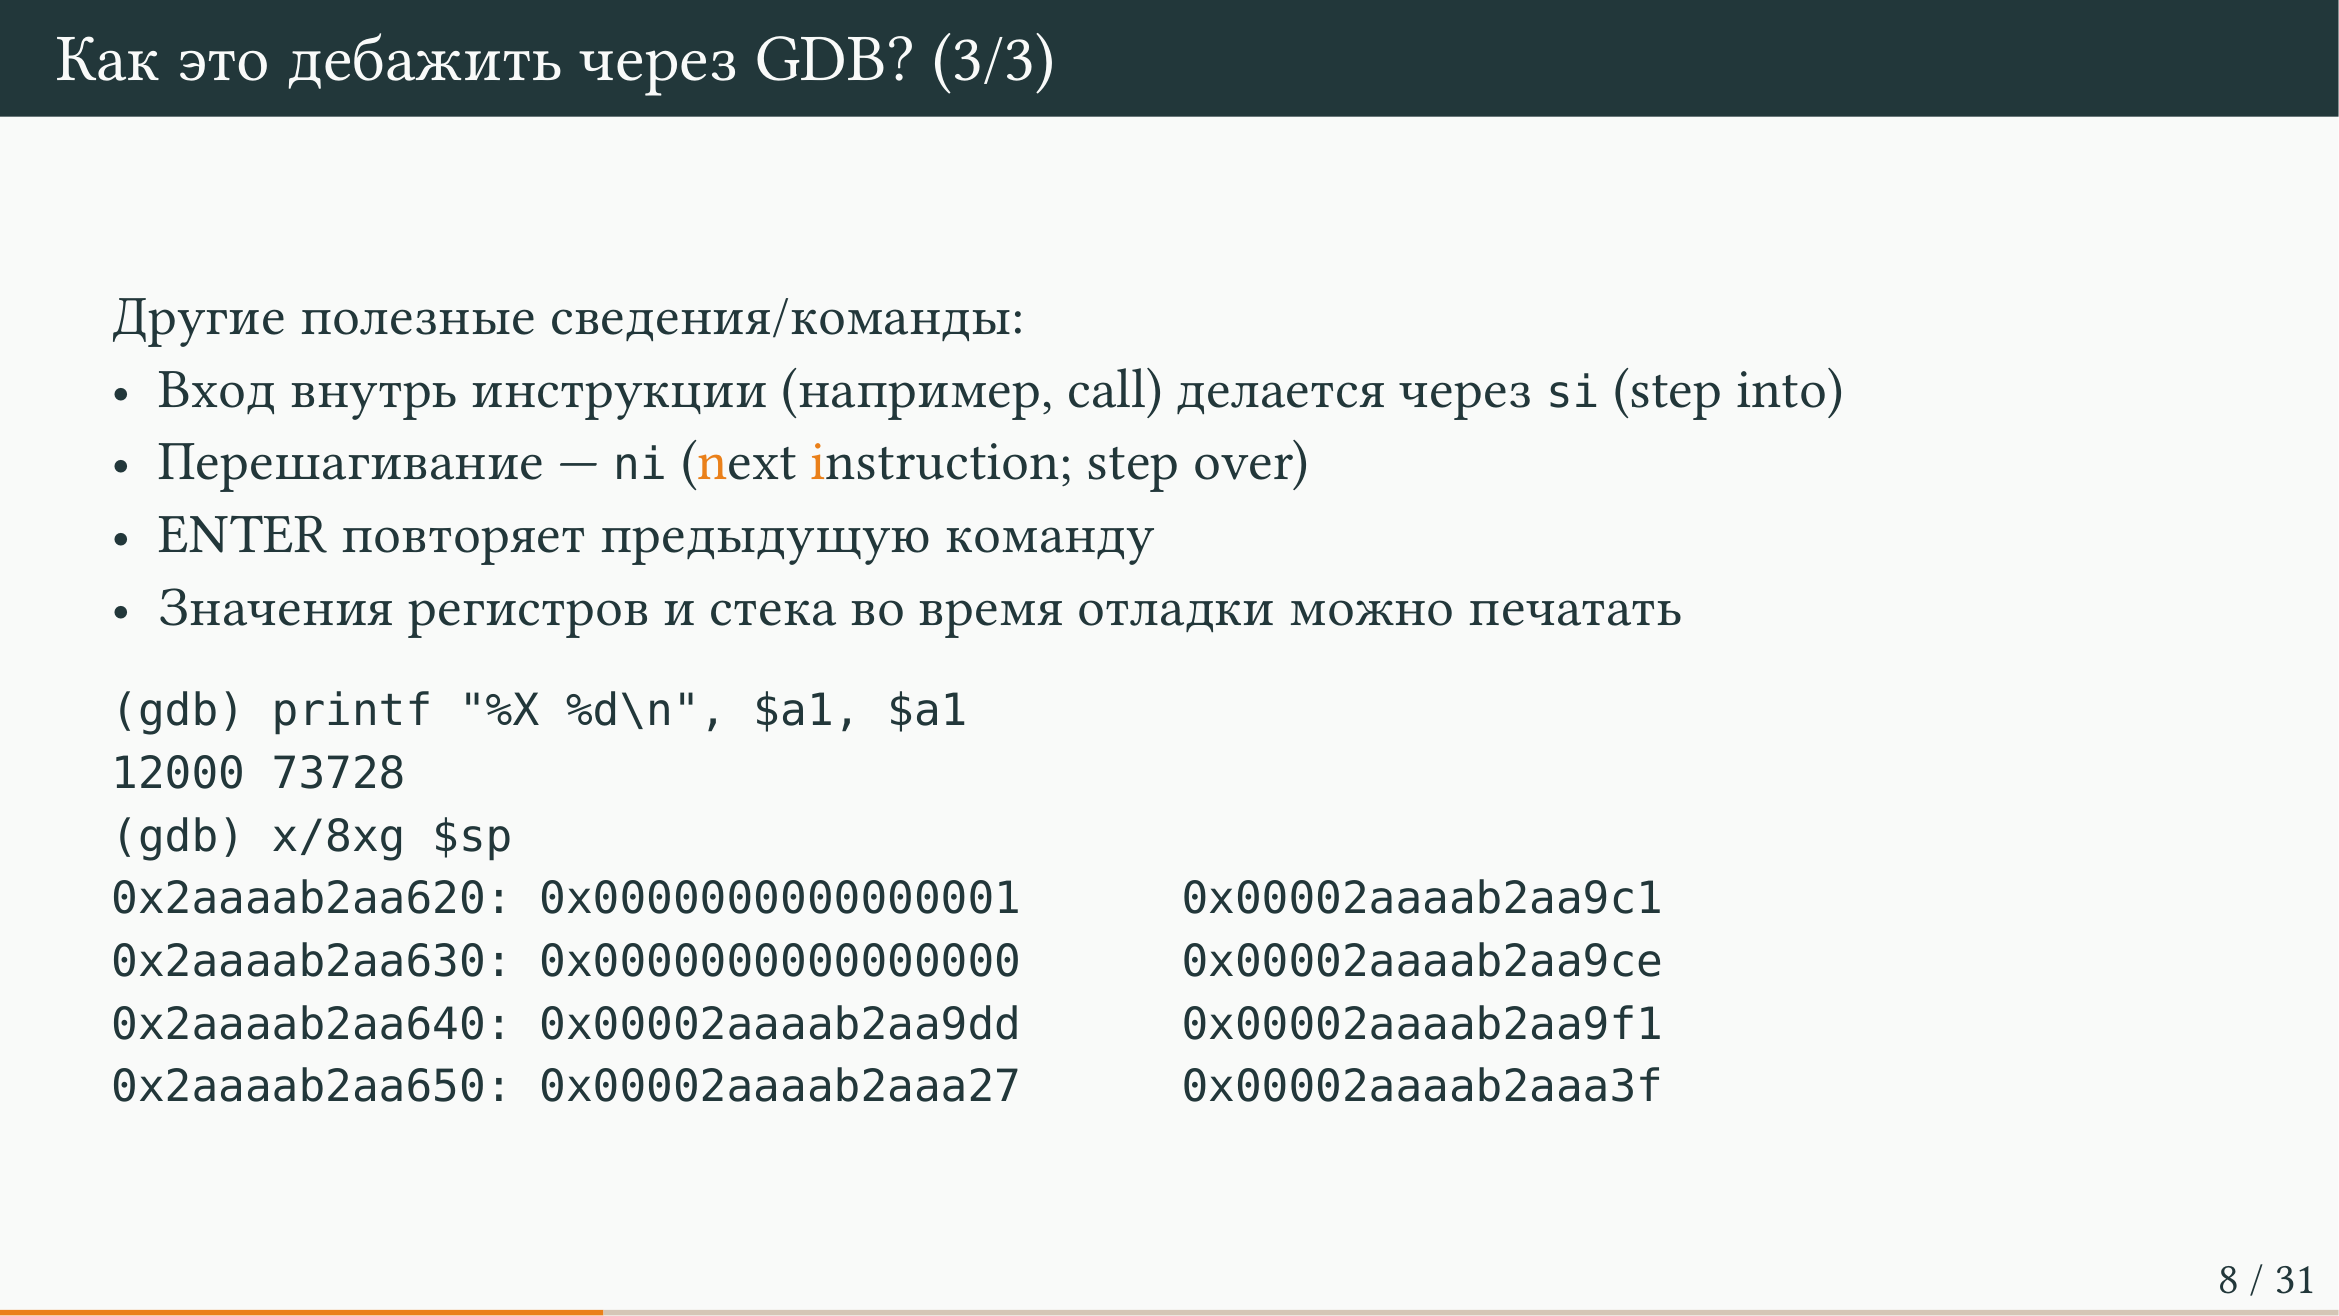
В GDB предусмотрена история команд, к которой можно обратиться с помощью стрелки вверх, что позволяет не набирать каждый раз одну и ту же команду вручную. Более того, при пустом нажатии клавиши Enter отладчик по умолчанию просто запускает предыдущую команду. Это избавляет от необходимости постоянно чередовать нажатия стрелки вверх и Enter, позволяя просто отправлять Enter до тех пор, пока выполнение не дойдет до нужного места в коде.
Значения регистров в GDB можно печатать как в шестнадцатеричном формате (hex), так и в десятичных числах. Команда print (или printf, судя по слайду) имеет несколько специфичный синтаксис. Например, при выводе значения регистра $al в шестнадцатеричном формате получается 12000, а в десятичном — 73728.
Также в GDB можно печатать содержимое стека. Команды для печати стека выглядят несколько сложно; например, команда x/8xg $sp содержит аргументы, где 8 обозначает количество значений на вершине стека, а комбинация символов вроде xg указывает на формат вывода (в частности, на то, что значения являются 64-битными, из-за чего выводятся длинные цифры). Печать стека с указанием конкретного количества значений бывает крайне полезной, когда требуется узнать, какие именно аргументы были переданы в функцию, при условии, что эти аргументы передавались через стек.
Регистры RISC-V и манипуляции со стеком
Регистры архитектуры RISC-V и соглашение о вызовах
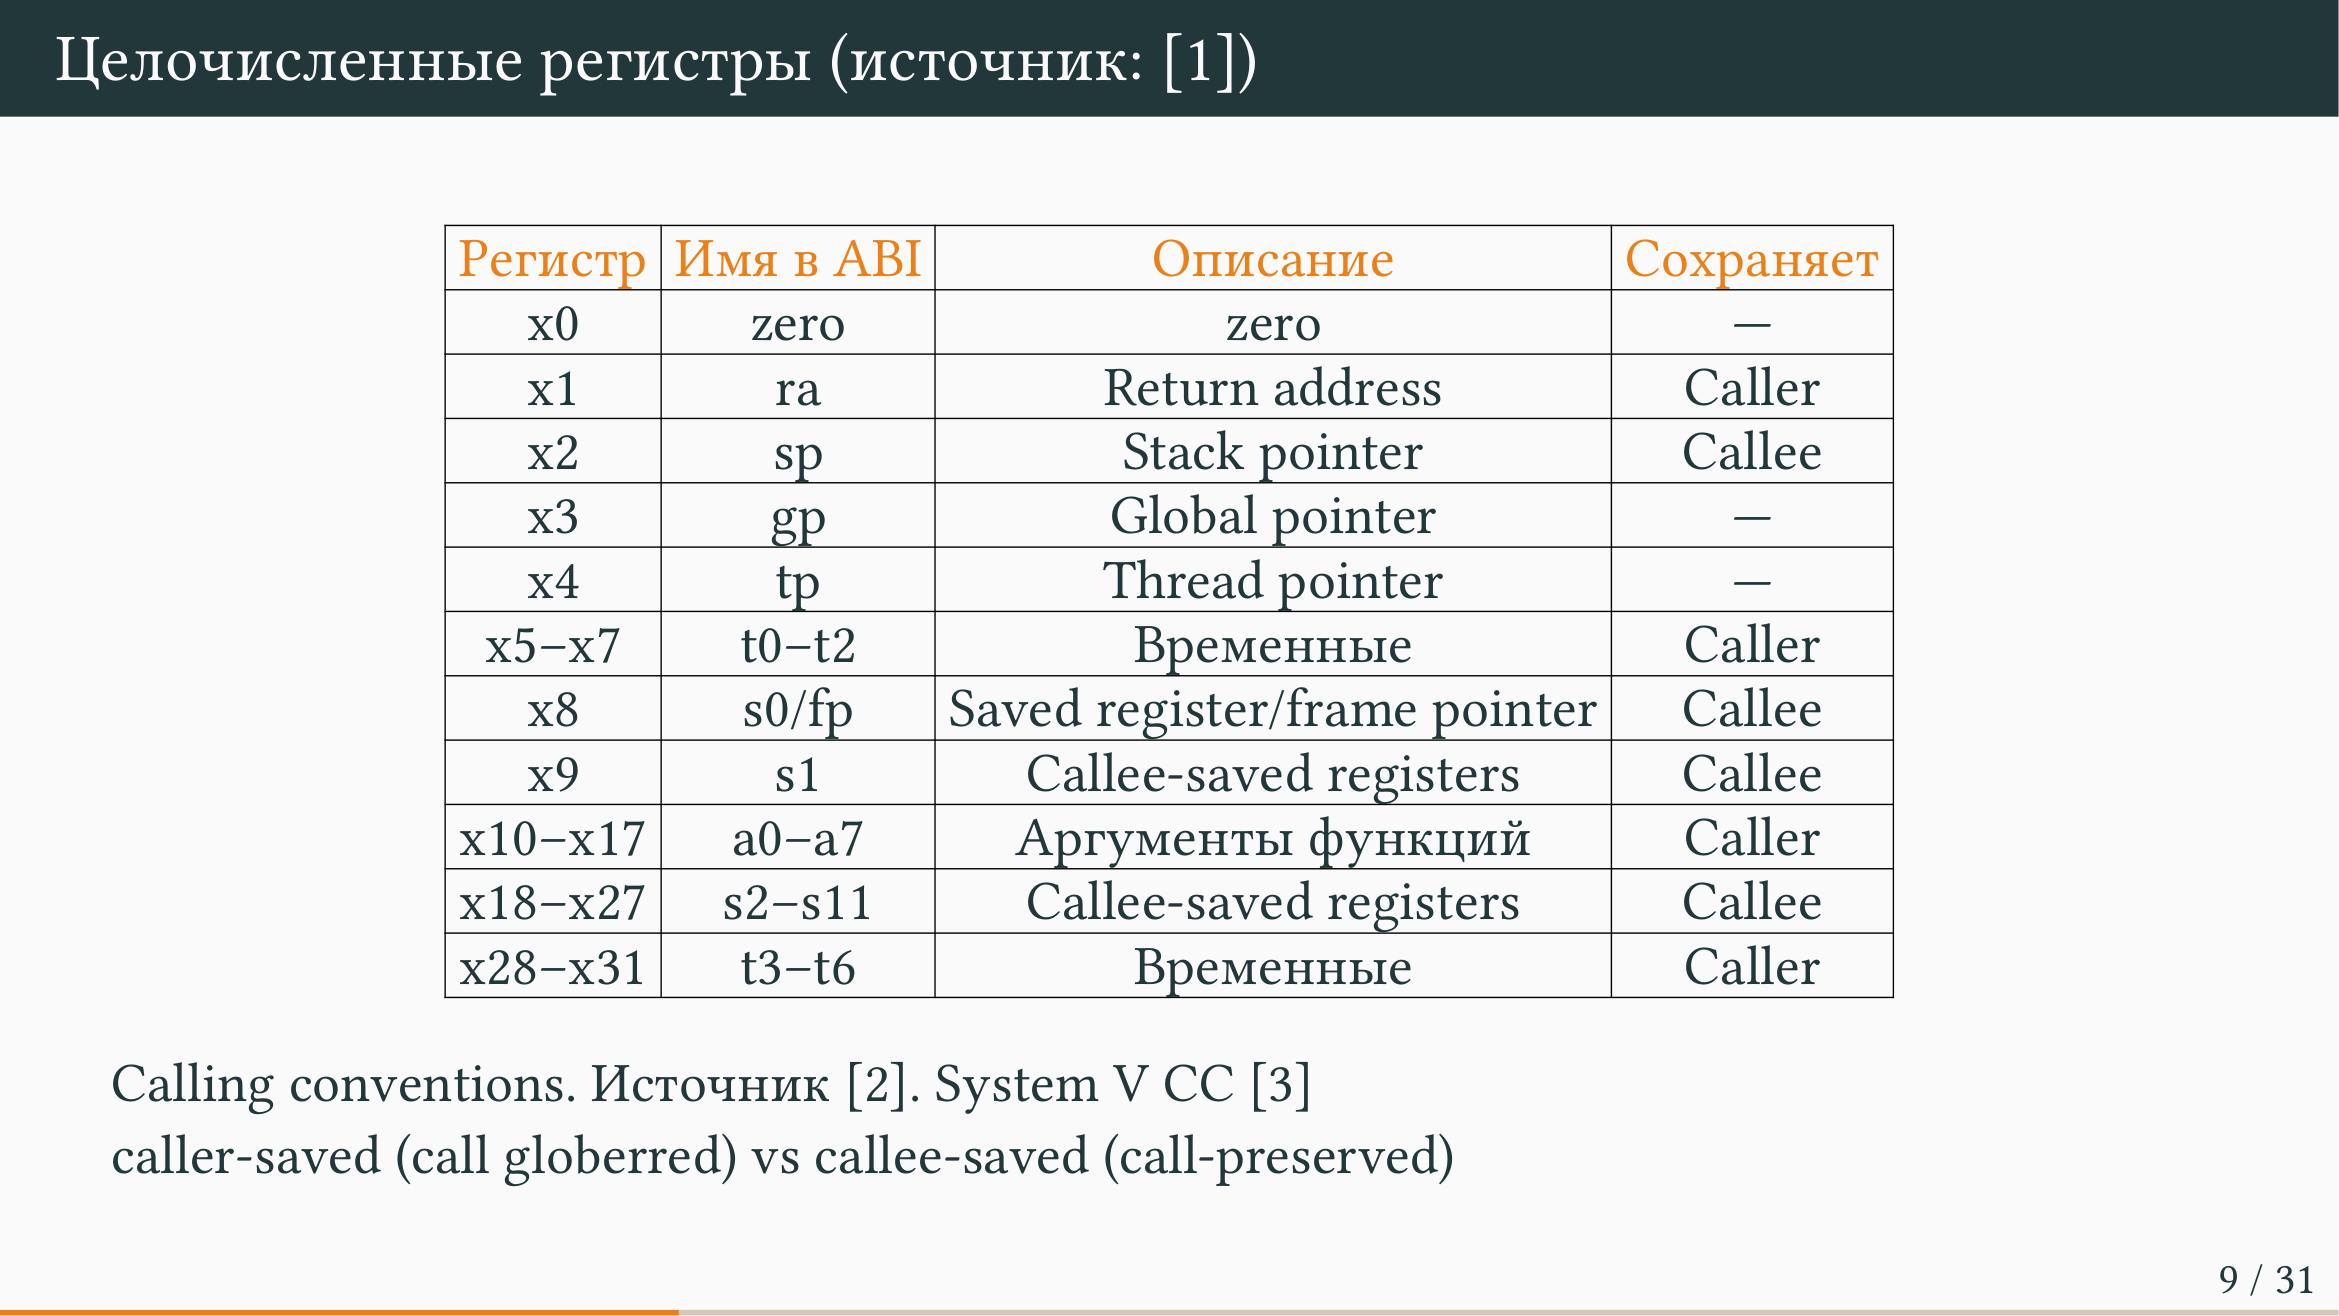
В архитектуре RISC-V предусмотрено 32 регистра, которые нумеруются с помощью буквы x (от x0 до x31), а некоторым из них даны человеческие имена.
Регистр x0 (имя в ABI: zero) примечателен тем, что из него всегда читается ноль. Какое бы значение вы ни пытались оттуда прочитать (например, ставя на красное или на черное) и что бы туда ни записывали (даже если записать туда 42), в результате все равно будет возвращаться ноль.
Регистр x1 (имя ra, Return address) хранит адрес, куда нужно возвращаться после исполнения данной функции. Регистр x2 (sp, Stack pointer) является указателем на стек. Регистр x3 (gp, Global pointer) может потребоваться для того, чтобы в момент старта программы вставить одну команду для появления доступа к строковым константам, лежащим в секции Data (если же в программе используются только целые числа, скорее всего, это не понадобится). Регистр x4 (tp, Thread pointer) в данном контексте не понадобится вовсе.
Временные регистры t0–t2 (x5–x7) и t3–t6 (x28–x31) понадобятся для хранения временных данных. Также в архитектуре присутствуют сохраненные регистры s0/fp (x8), s1 (x9) и s2–s11 (x18–x27). Регистры аргументов функций a0–a7 (x10–x17) понадобятся в случае вызова системных вызовов или при вызове кода на C из вашего рантайма, что необходимо для работы частичного применения.
В правом столбце таблицы указано, что можно ожидать от регистров с точки зрения их сохранности при вызове подпрограмм. Регистры делятся на группы по принципу того, останется ли их содержимое прежним после вызова некоторой подпрограммы, то есть сохраняется ли оно вызываемым (callee saved или call-preserved) либо сохраняется вызывающим (caller-saved).
Например, временные регистры (t0–t6) являются caller-saved: поскольку они временные, подпрограмма имеет право использовать их для своих нужд, поэтому вызывающий должен самостоятельно озаботиться тем, чтобы записанные там данные не потерялись. В то же время регистры вроде sp или сохраненные регистры s являются callee-saved.
Глобально правила сохранения регистров регламентируются соглашением о вызовах (calling conventions), которое специфично для конкретной архитектуры и конкретной операционной системы. Необходимо аккуратно изучать документацию, чтобы знать, какие регистры используются для передачи целочисленных аргументов или аргументов с плавающей точкой, где находится return-адрес и кто отвечает за сохранение регистров. Например, в соглашении о вызовах x86_64 существует оговорка о том, что перед вызовом функции может потребоваться занурить некоторый временный регистр, чтобы вызванная функция на C могла использовать varargs-аргументы (автор лекции отмечает, что сам наступал на эти грабли, из-за чего у него не работал printf в C).
Соглашение о вызовах очень сильно завязано на архитектуру: если архитектура исторически накопила большое количество костылей, то и в соглашении их будет много; если архитектура более новая, костылей меньше. Это соглашение необходимо уважать, иначе всё начнет ломаться в момент вызова кода на C из ассемблерного листинга. Сам по себе ассемблерный листинг является вещью в себе и до тех пор, пока ничего другого не вызывает, может использовать любые соглашения, но при обращении к миру C, использующему строго описанные на бумаге соглашения о вызовах, возникают странные эффекты, и при возникновении проблем в этот момент в первую очередь следует проверять именно корректность соблюдения соглашения о вызовах.
Работа со стеком и отладка в GDB
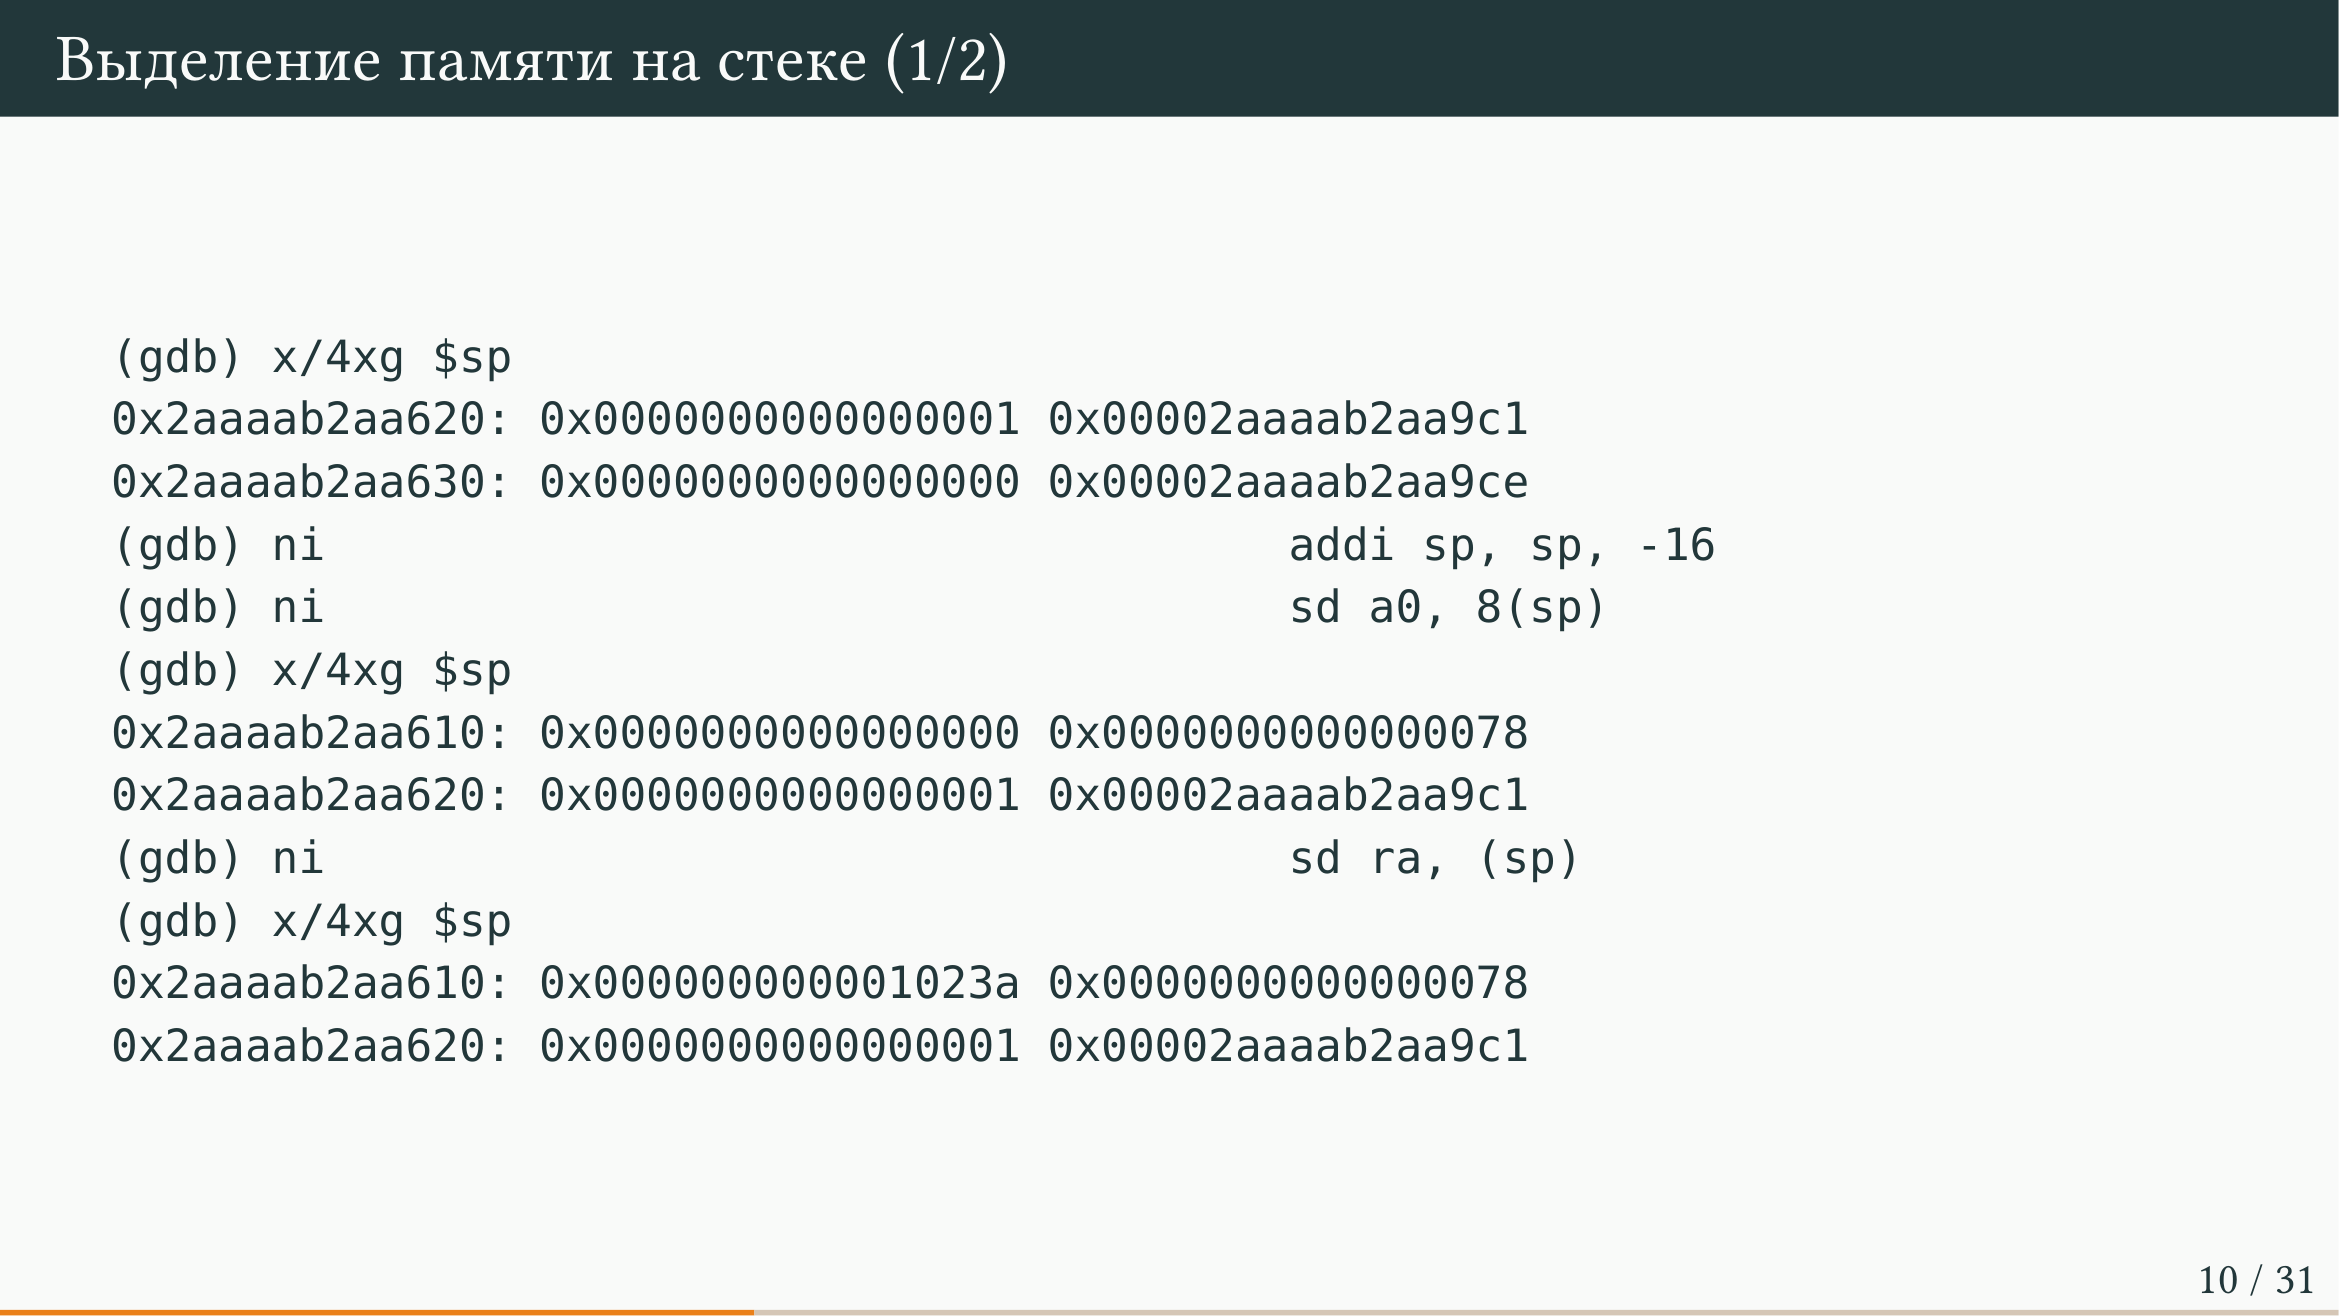
При отладке программ с использованием стека в GDB можно наглядно увидеть, как именно изменяется состояние памяти при выделении места и сохранении данных. Если вывести содержимое памяти по адресу стекового указателя $sp (например, с помощью команды x/4xg $sp), мы видим некотрое количество 64-битных значений в шестнадцатеричном формате. Адрес вида 0x2aaaab2aa620 лежит примерно на вершине стека.
Когда мы выполняем выделение памяти на стеке для двух значений (по 16 байт в сумме, так как архитектура 64-битная, и каждое значение занимает по 8 байт — инструкция addi sp, sp, -16), строка, которая находилась на стеке первой, смещается вниз, а на вершине стека появляются новые значения, выглядящие как мусор. После этого на вершину стека можно загружать значения регистров. Например, с помощью инструкции sd a0, 8(sp) и последующего сохранения регистра ra (sd ra, (sp)) мы записываем данные на стек. Инспектируя стек в GDB, можно увидеть, что на вершине появляются значения, похожие на реальные адреса, которые не выглядят полностью случайными. Таким образом можно инспектировать стек, если что-то работает не так, как ожидалось, и нужно понять, почему возникла ошибка в коде — написали ли вы его самостоятельно или воспользовались помощью нейросетей.
Отступление от темы
Я занимался разгребанием как-то, раскодированием инструкций RISC-V. Я понял, что нейронки часто врут в манипуляциях битиками. Мне приходилось на бумажке аккуратно выписывать и проверять, что же оно там раскодировало. Ну ладно, мы до этого дойдем.
Стек работает по своим законам: когда вы делаете вычитание указателя стека (addi sp, sp, -16), вы выделяете место и добавляете данные на стек, и они реально там появляются, с ними можно работать и осмыслять их.
Соглашения о вызовах и системные вызовы
Соглашение о вызовах и передача аргументов через стек и регистры
Соглашение о вызовах говорит о том, как вам нужно договориться о передаче аргументов функции подпрограмме. Классический, или скорее довольно естественный вариант, описанный в System V ABI, заключается в том, чтобы передавать аргументы через регистры. Логично, что через регистры аргументы передаются быстро, а всё, что не влезло через регистры, передается через стек. Скорее всего, у вас будут простые программы, и на стек будет влезать довольно мало, но в принципе написать код, который передает и через регистры, и через стек, с первого раза довольно сложно.
Разумно начать реализацию с такого соглашения о вызовах, которое передает все аргументы через стек. В литературе такие соглашения о вызовах представлены какими-нибудь cdecl и Pascal Calling Convention. Они отличаются примерно порядком расположения аргументов: последний с краю стека или первый с краю стека. Но в принципе, если вы пишете код, который вызывает ваш собственный функцию или метод, потому что другого не дано, то вы можете использовать любое соглашение о вызовах. Главное — использовать его правильно в каждом месте, чтобы никакого расхождения не произошло. Вы можете сделать так, чтобы первый аргумент был с краю стека, последний аргумент с краю стека, или, в порядке бреда, в начале с краю стека чётные аргументы, а потом нечётные. Вы можете использовать какие-нибудь странные регистры для аргументов: это будет максимально странно, но это будет работать до тех пор, пока вы не начнёте вызывать сторонний код.
Самый простой вариант — это все аргументы передавать через стек. Если у вас в функции есть какие-то локальные переменные, то самый простой вариант — сохранять их тоже на стеке. Вы считаете количество локальных переменных и выделяете на стеке достаточное количество памяти, чтобы эти локальные переменные взять и сохранить там. Это будет неэффективно (ну, не то чтобы максимально, наверняка вы сможете придумать более неэффективный вариант), но это будет работать. В данном конкретном примере люди пытаются напечатать число.
Сохранение регистров RA и A0 на стеке и типичные ошибки при отладке
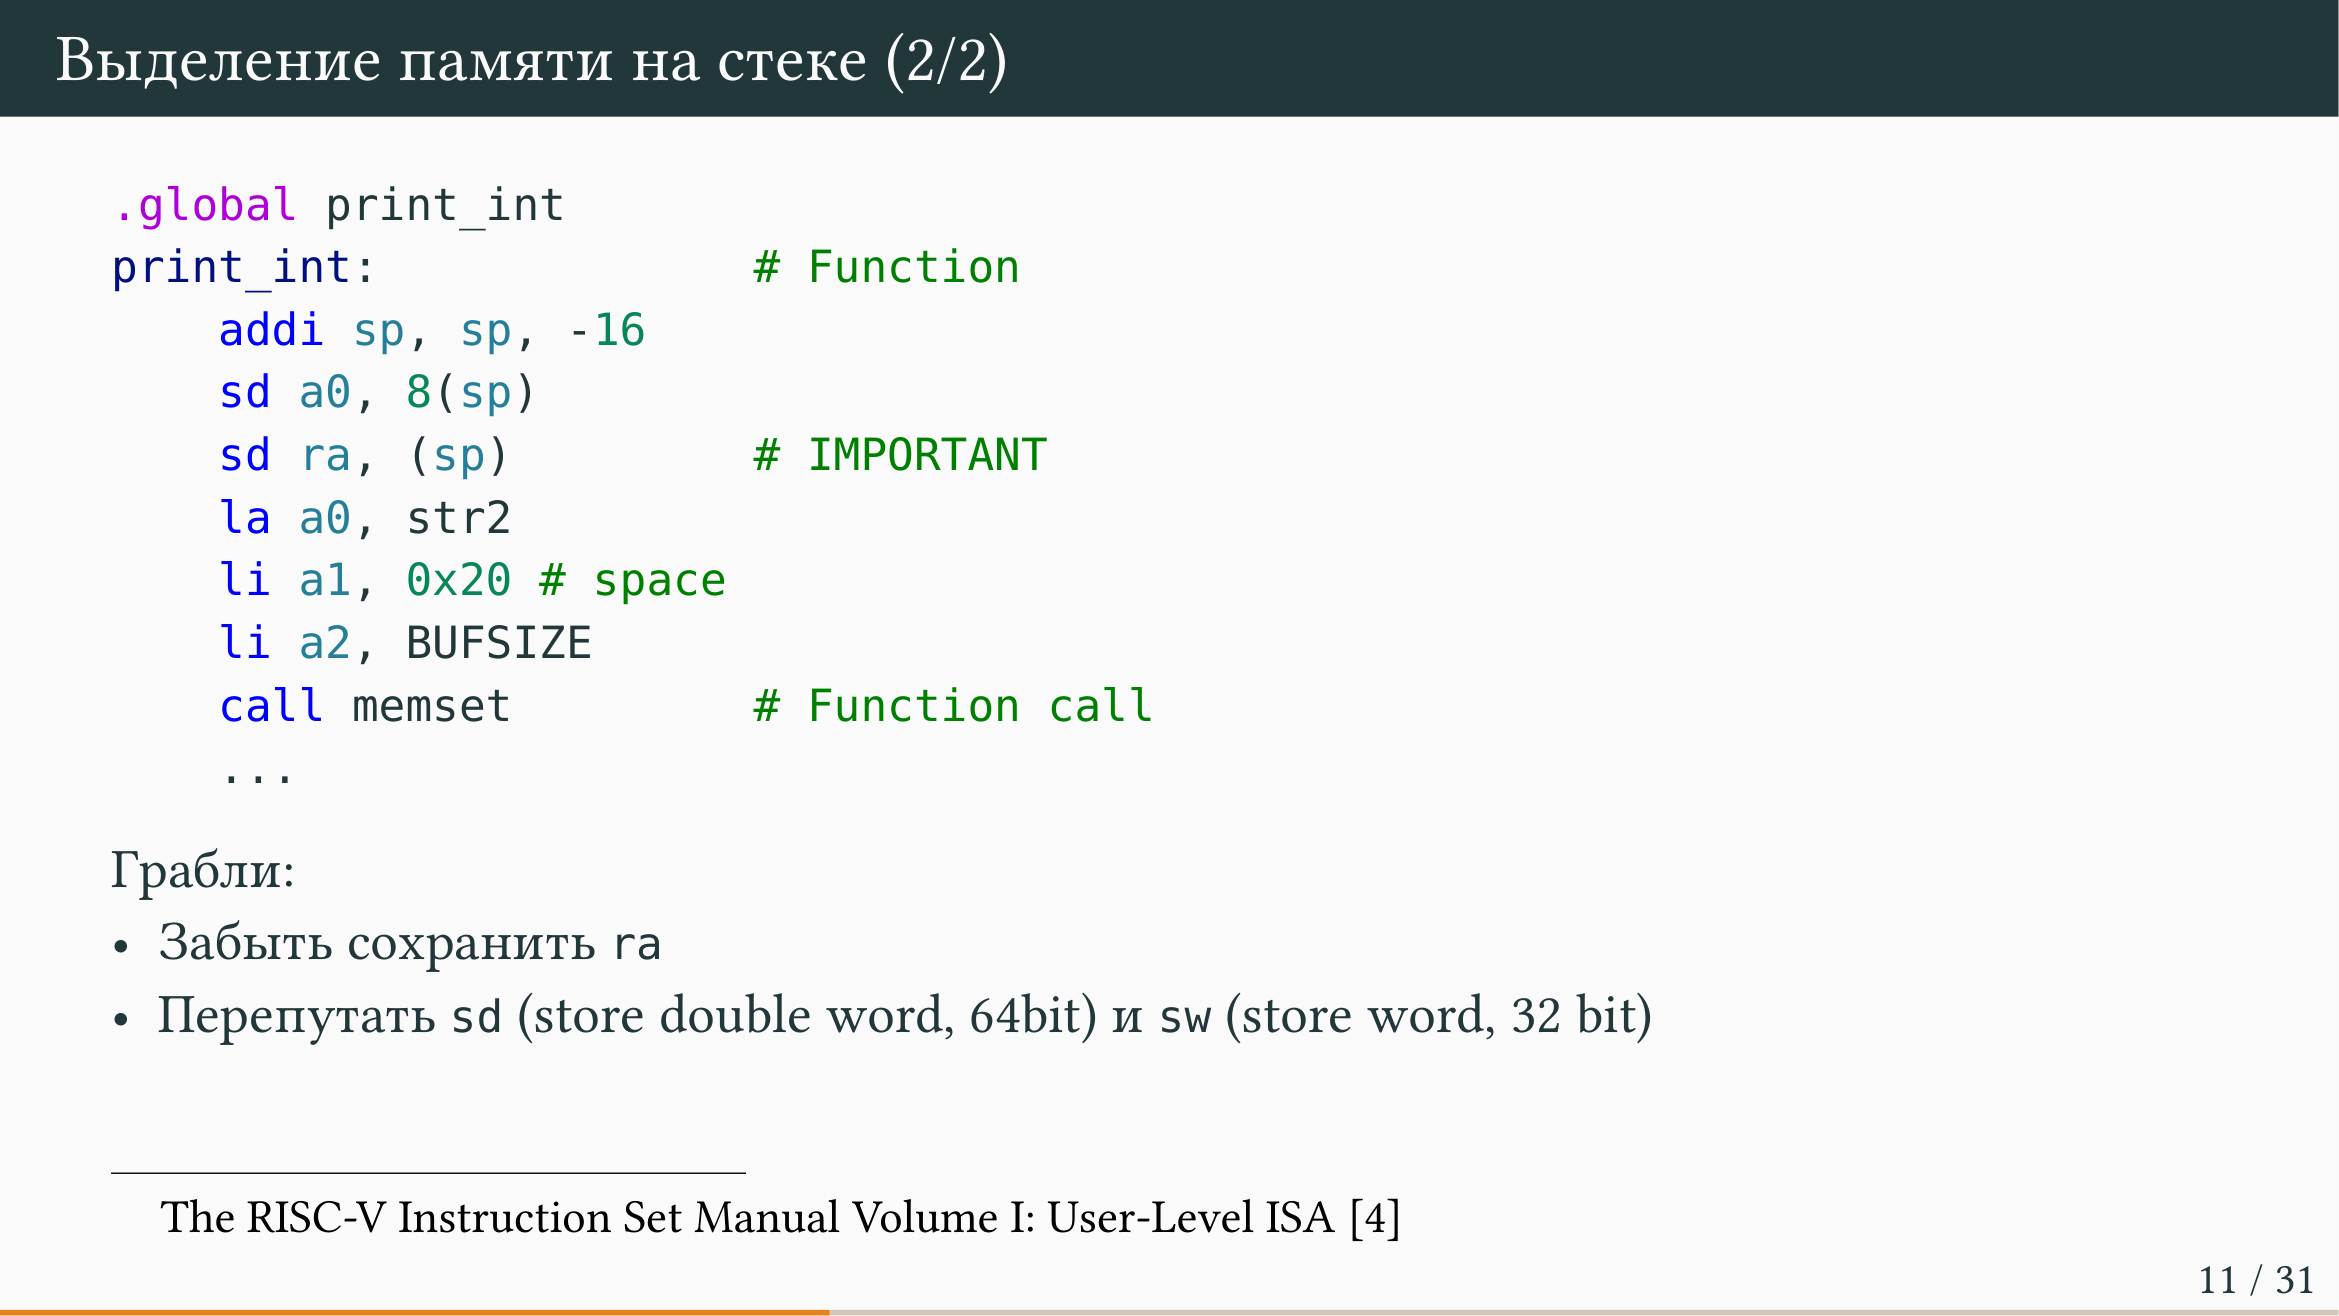
На конкретном примере функции печати числа (printint) рассмотрим, как происходит сохранение данных на стеке. Разработчики выделяют на стеке место по два значения и сохраняют с краю регистр RA, а на второй позиции от края — регистр A0, который содержит аргумент. Аргумент необходимо сохранять, потому что далее в программе происходит какой-то вызов memset, который использует A0 как аргумент. Вам нужно не потерять то, что передали в функцию printint, иначе вы не сможете потом напечатать это число.
Регистр RA сохраняется с краю, а A0 сохраняется после него. В принципе, можно поменять их местами, и ничего плохого не случится: как сделаете, так и будет работать. Ну или не будет работать — тогда вы будете заниматься отладкой. Вы делаете какой-то вызов от программы, она что-то делает, а затем с помощью команды load double word загружаете обратно со стека в регистр то число, которое хотели напечатать, и делаете с ним что-нибудь полезное.
В этом месте возникают типичные грабли. Первое: если вы забудете сохранить RA, вы не сможете вернуться обратно к той функции, которая вызывала printint, потому что адрес того, кто вызывал, потеряется, и у вас ничего не будет работать. Это очень распространенные грабли, когда я делал руками, я на них наступал постоянно. Не делайте так, сохраняйте RA, иначе вы задолбаетесь это дебажить. Это важно, без этого ничего не будет работать.
Отступление от темы
когда я делал рукам ул я на них наступал постоянно не делайте так
Второе: вам нужно учитывать размер тех регистров, которые вы будете сохранять на стек и загружать со стека. Очень легко перепутать инструкции сохранения и загрузки. Например, инструкция для работы с 32-биткивыми значениями и sd (store double word) для 64-битных значений. Еще есть инструкция сохранения байта (store byte), но она вам скорее не понадобится до тех пор, пока вы не начнете добавлять строки в ваш код [неясный фрагмент].
Если вы перепутаете размер и загрузите слишком малое значение, то загрузится только младшая половина регистра, и у вас получится какое-то неожиданное число в регистре. После этого будет сложно отладить, что вообще происходит и почему от адреса, к которому мы должны были перейти, загрузилась только половина, из-за чего выполнение переходит в совершенно левое место. Важно не перепутать мнемонику инструкции, которая работает с нужным размером регистра, иначе ничего не будет работать. Здесь на самом деле закладывается... нет, еще не закладывается, некоторое наблюдение, оно скажется позже.
Получение номеров и аргументов системных вызовов через заголовочные файлы и S-trace
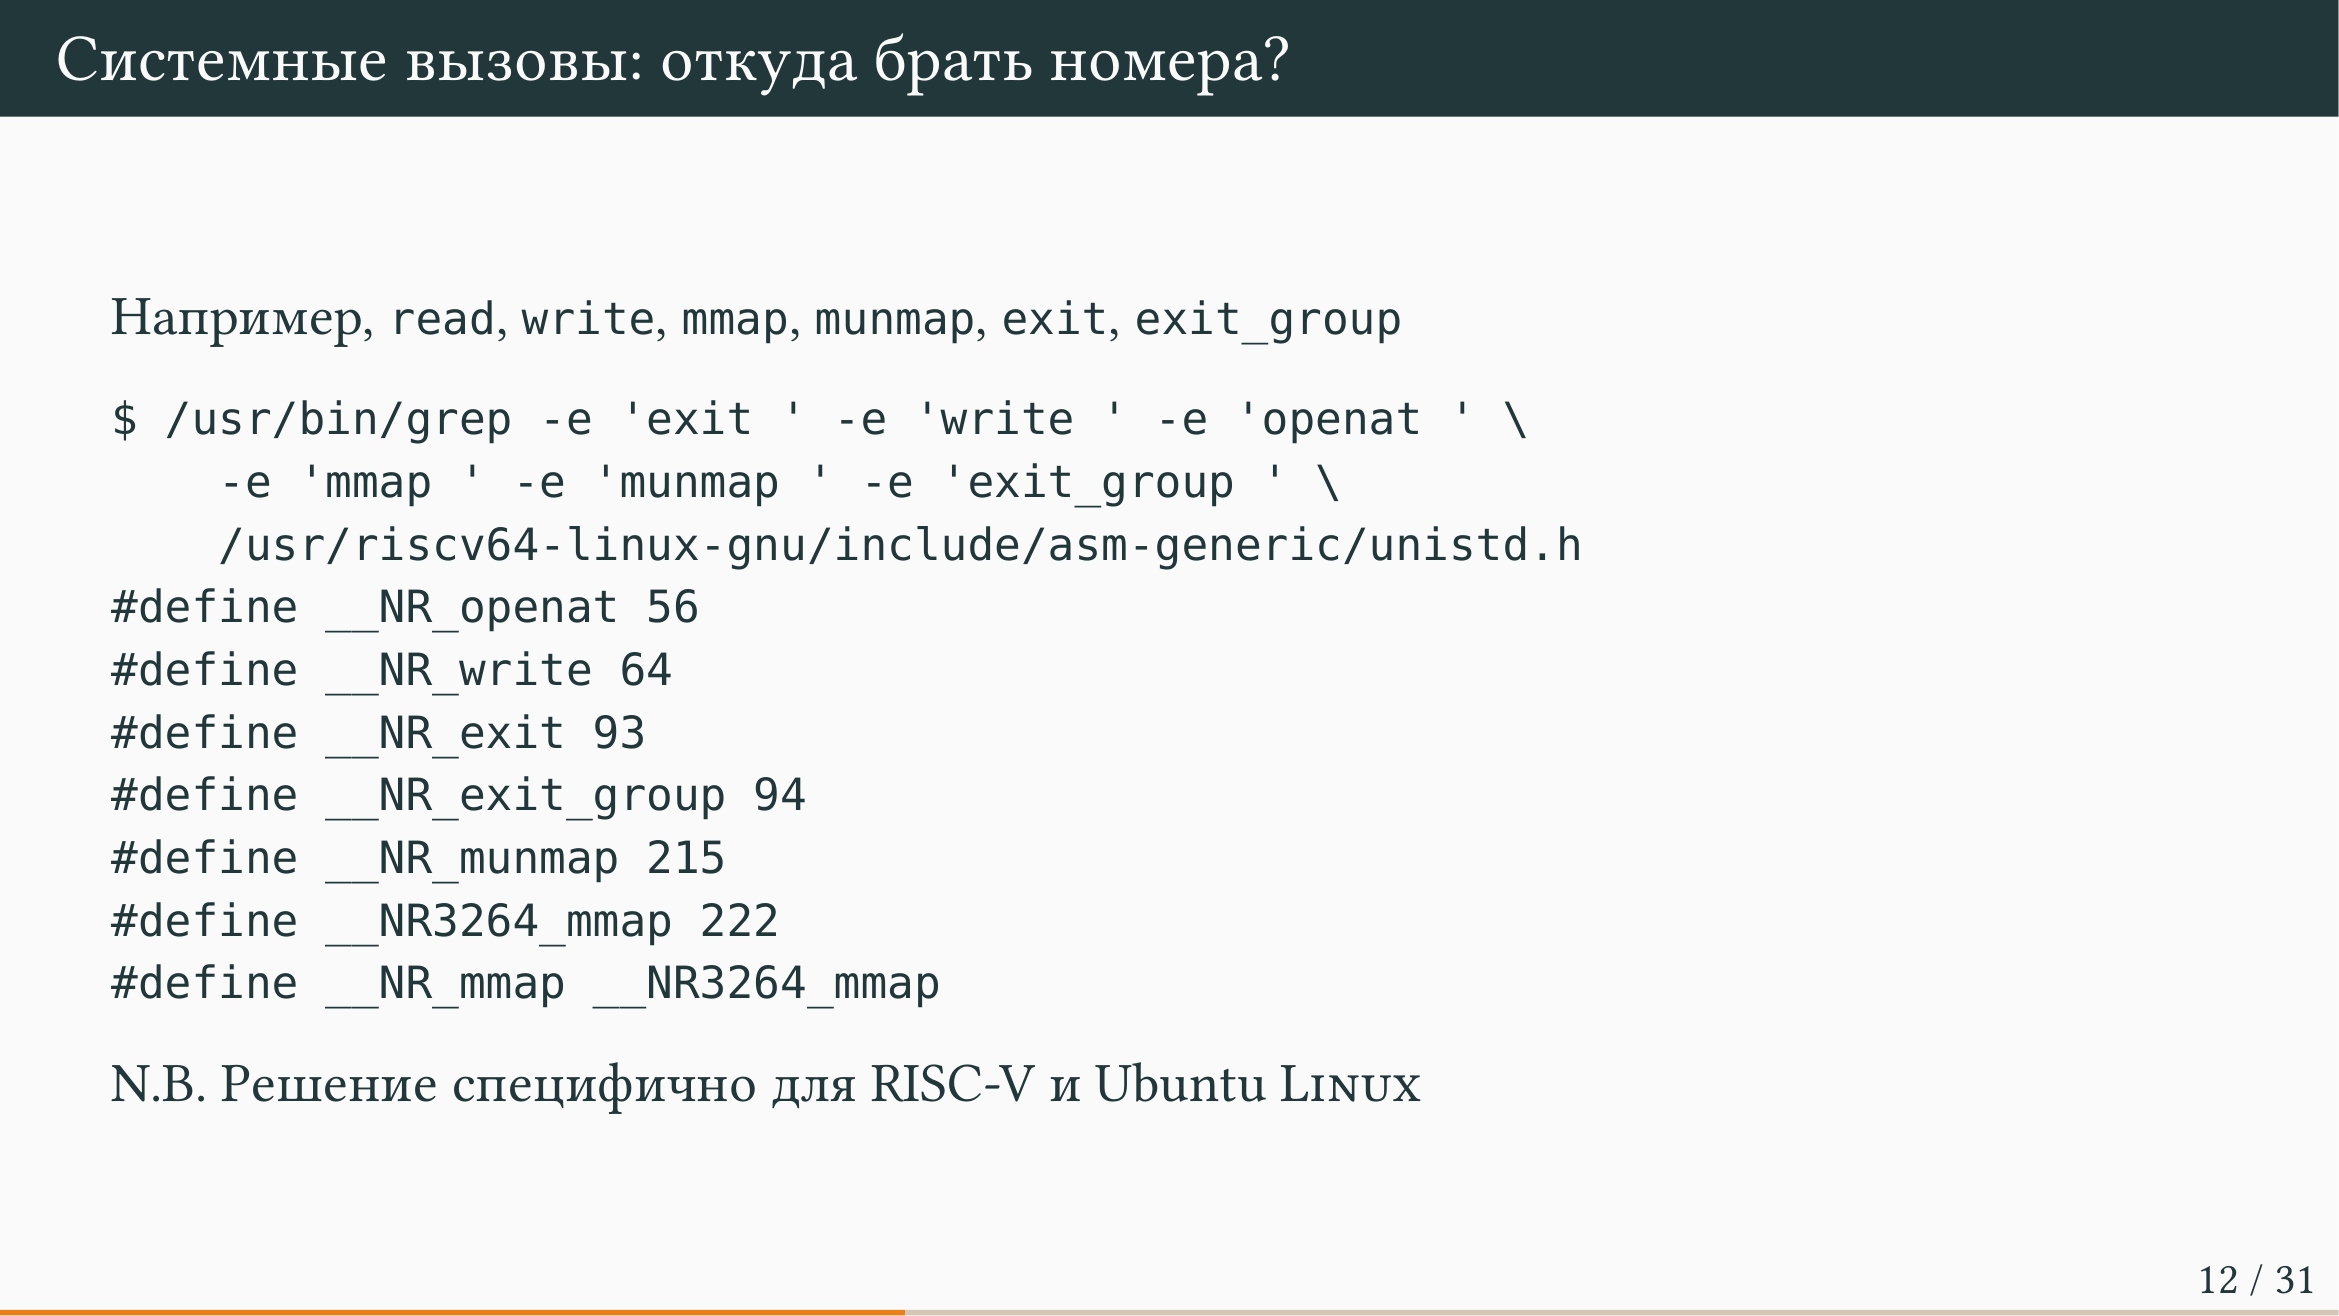
Откуда берутся константы и номера, используемые при совершении системных вызовов? Все заголовочные файлы, связанные с ядром операционной системы, можно брать и изучать оттуда. Например, если вы возьмете Ubuntu и RISC-V, то при поисковом запросе в заголовочных файлах можно обнаружить специальные константы для различных системных вызовов: openat (для открытия файла), write, exit и exit_group (используются для выхода), а также mmap и munmap (для выделения памяти). У всех системных вызовов есть свои номера, которые необходимо указывать правильно, иначе ничего не будет работать. Вы можете вооружаться утилитой grep, искать по нужным файлам и узнавать оттуда необходимые номера системных вызовов.
Кроме номеров, нужно знать аргументы системных вызовов. Узнать правильные аргументы можно примерно двумя способами. Первый способ — это открыть документацию (маны) и начать изучать, что там написано. Например, для системного вызова exit_group первый аргумент — это код возврата, а второго аргумента, скорее всего, нет. У системного вызова write целых три аргумента: куда печатать (дескриптор), буфер, который печатают, и размер буфера.
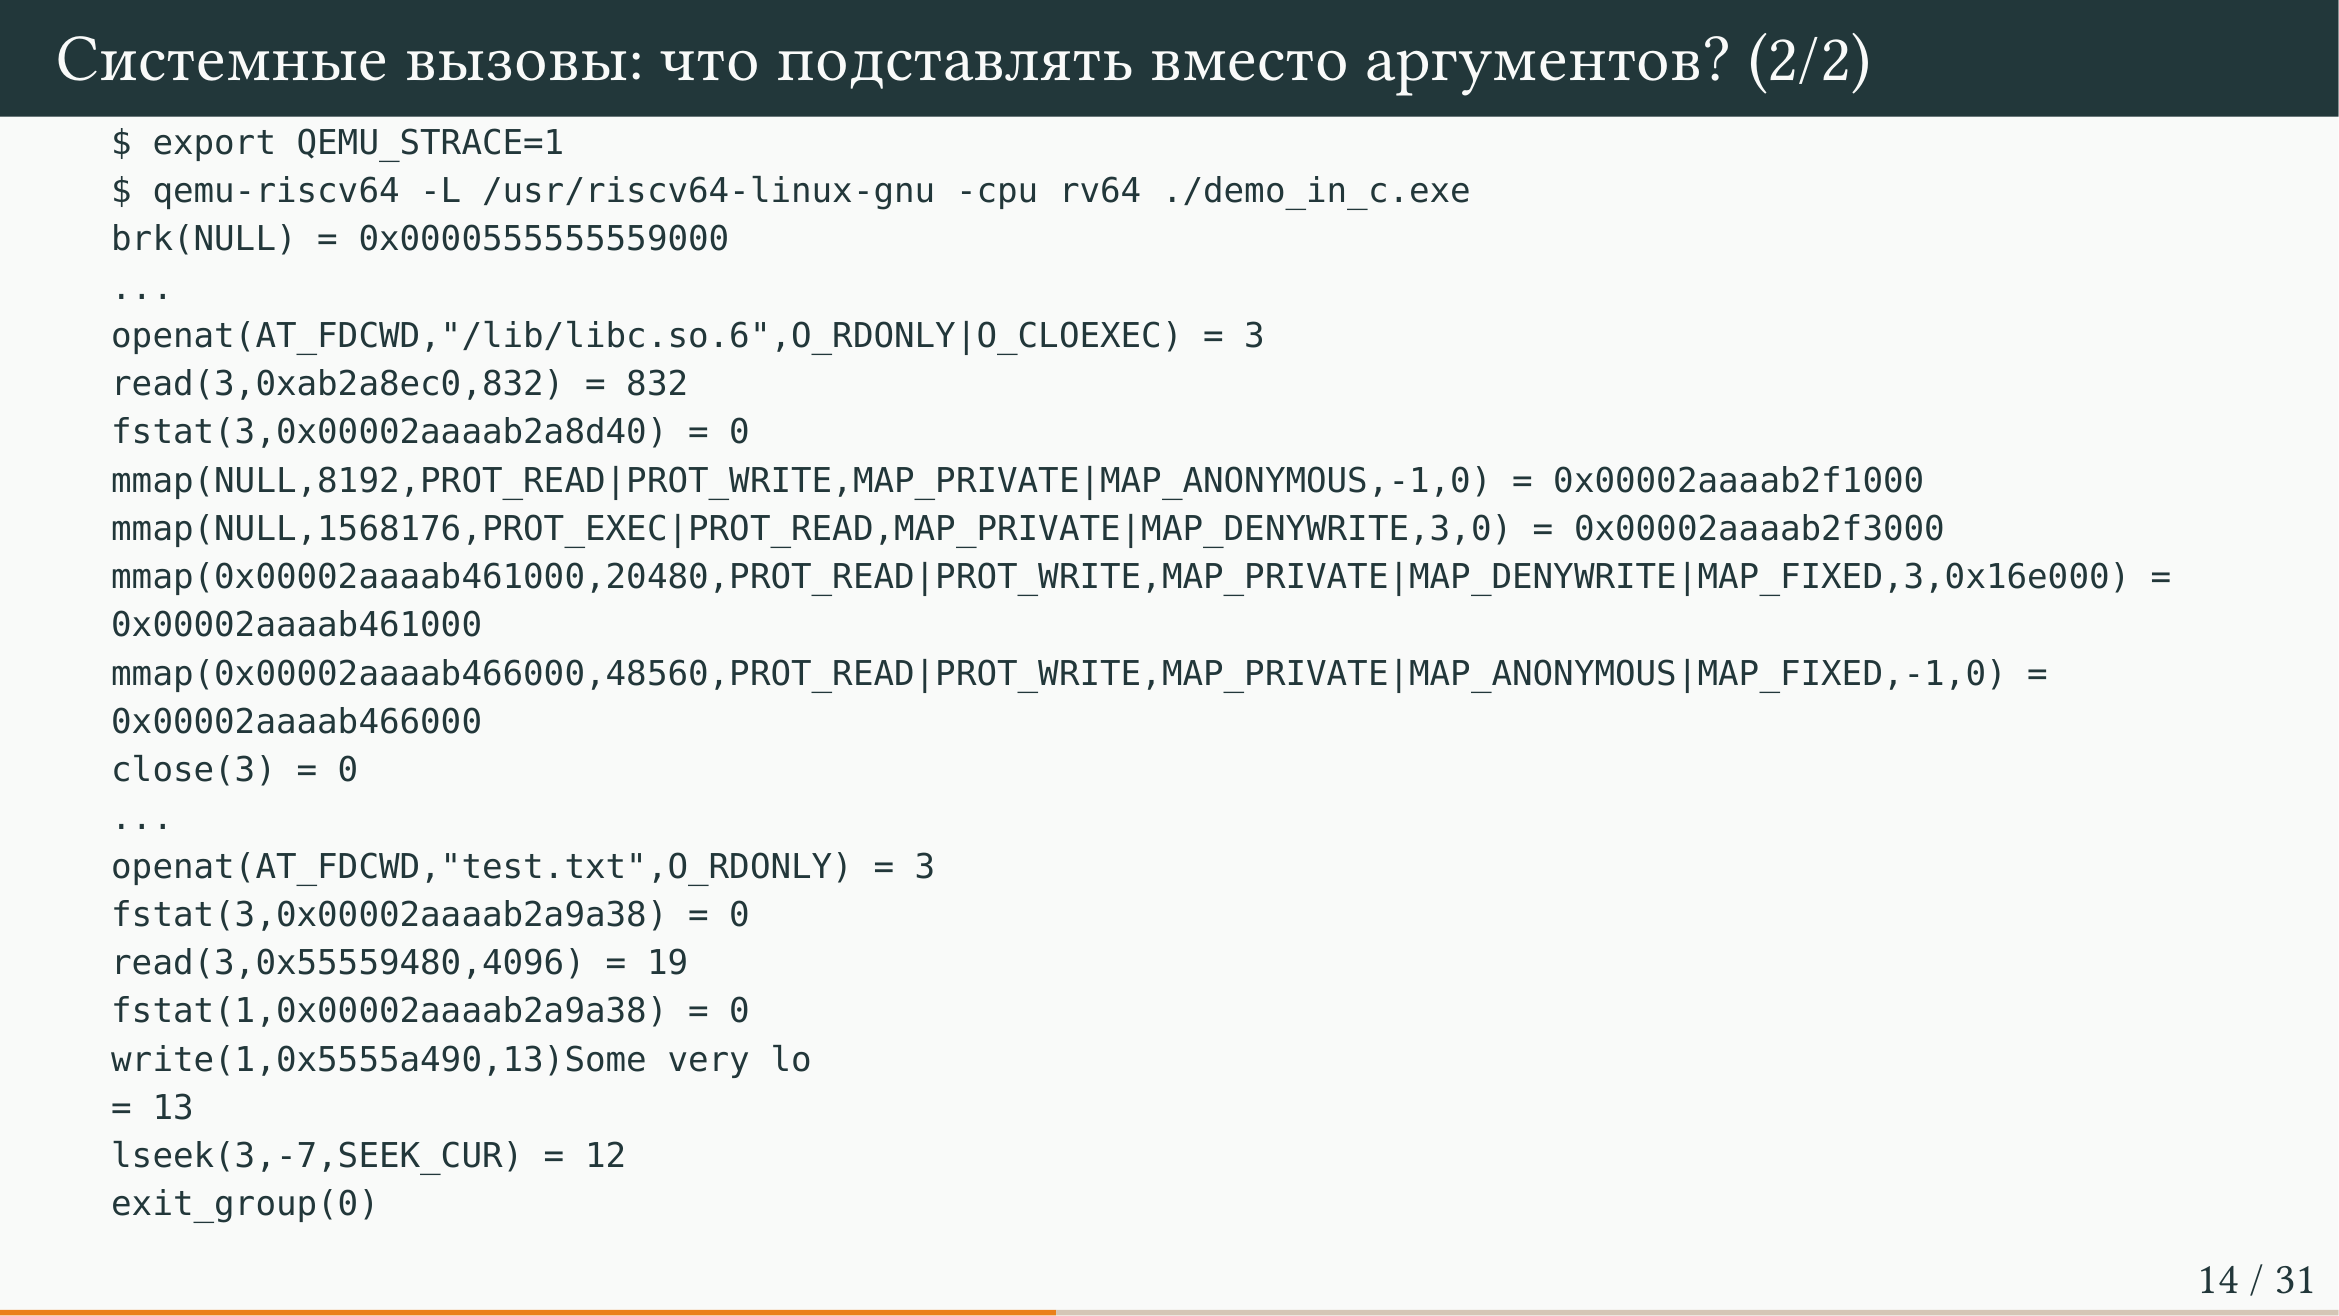
Второй способ — если вы не умеете читать маны, вам нужно программировать на C. Вы пишете программу на языке Си, которая делает примерно то, что вам нужно, а дальше начинаете трассировать эту программу, чтобы понять, какие системные вызовы она совершает. Для этого используется специальное заклинание strace (в связке с QEMU), которое будет трассировать системные вызовы, выполняемые запускаемой программой. Если скормить туда Си-шную программу, скомпилированную в ELF, можно увидеть, что она неожиданно (но вполне ожидаемо для Linux) открывает динамическую библиотеку libc.
Отступление от темы
И нельзя просто так взять и слинковать libc статический. Для этого вам нужны какие-то другие библиотеки стандартные, какие вы знаете. Что бывает вместо libc? Вместо libc — musl еще. Но обычно libc — это же libc. Есть еще какой-то micro-libc. И кажется, есть еще newlib, но я не уверен насчет newlib. Ой, какая гадость. Уйдите отсюда. Windows.
Короче говоря, вы пишете демку на C, трассируете ее и узнаете, какие системные вызовы делает программа, написанная на C, но делающая что-то похожее на то, что нужно вам. Отсюда вы достаете информацию о том, какие системные вызовы задействованы и какие аргументы они с собой забирают. strace для вас расшифровывает константы (например, __NR_read, __NR_write), чтобы было понятно, какие аргументы передаются, и в каком порядке они должны располагаться.
Разбор трассировки работы с файлами в C-программе
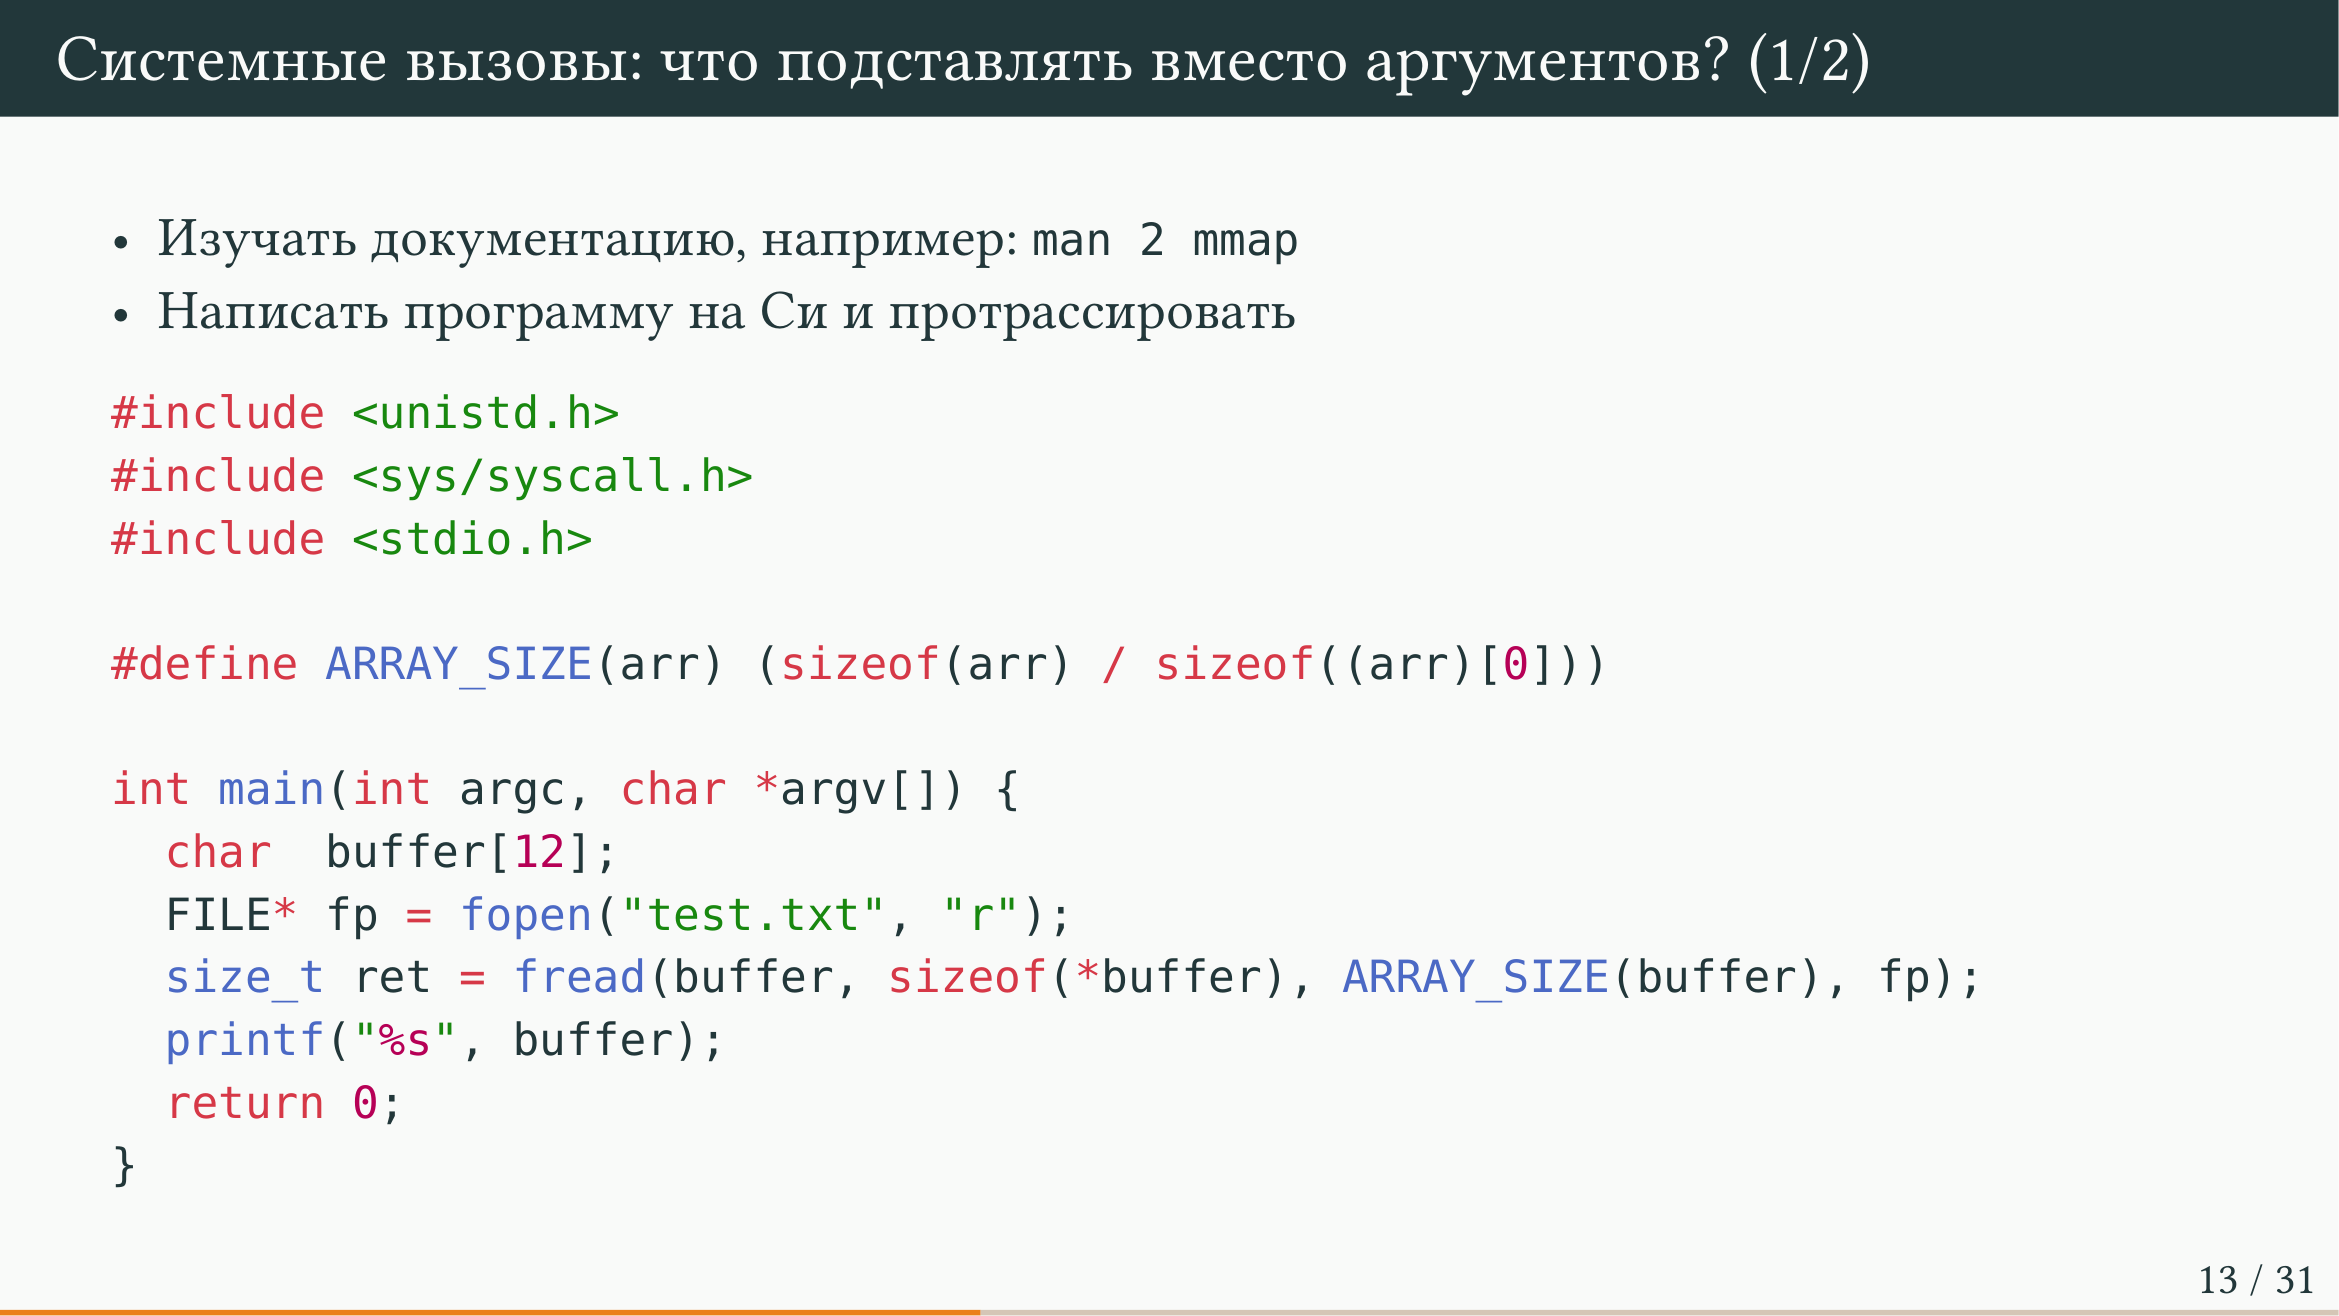
Далее рассматривается порядок системных вызовов, выполняемых программой при работе с файлами. В программе открывался файл на чтение, затем из него производилось чтение данных, а количество прочитанных байт сохранялось в переменную типа size_t. Размер буфера определяет максимальное количество значений, которые должны быть прочитаны, в данном примере максимальный размер буфера составляет 4096.
В трассировке выполнение начинается с системного вызова openat, который возвращает файловый дескриптор 3 для открытого файла. Затем вызывается fstat, после чего выполняется системный вызов read из третьего файлового дескриптора. Стоит отметить, что стандартная функция fread под капотом вызывает системный вызов read. Далее происходит системный вызов write на 13 байт — такое значение получается из суммы 12 символов и терминального нуля (\0). В результате программа неожиданно печатает на терминал кусок файла, указанного в исходном коде. В данном примере в файл test.txt была записана строка someverylongstring, программа прочитала оттуда 13 байт, и часть строки someverylo оказалась прочитанной и напечатанной на экране с помощью функции printf. После этого выполняется системный вызов lseek и системный вызов exit_group, который завершает работу программы с кодом 0. Если уделить некоторое время анализу подобной трассировки, в ней можно полностью разобраться, и главный принцип того, как на это смотреть, был продемонстрирован.
Ответы на вопросы о библиотеках C и опциях сборки
Отступление от темы
вот кинуть вопросы по ходу дела замечания если у вас один thread по моему ничем если у вас их много нужно делать резервуар по моему так возможно просто вот этот пример любит кирилл константинович рассказывать про визит групп возможно он это рассказывал но ну нет значит нет еще какие-нибудь замечания вопросы
скорее всего там лежат какие-то кроссовые libc, я думаю так чтобы он скорее динамически [неясный фрагмент], без него не работает. У меня сложилось впечатление, что умолчания, которые сделаны в Ubuntu, они не очень точно, и поэтому надо, может быть, если у вас какой-то Mac и у вас там правильный toolchain, то там это и не нужно явно указывать. Но, по-моему, для синтаковского toolchain на RISC-V 32 мне приходилось указывать тоже, даже скорее всего надо.
Отступление от темы
Окей, ладно, едем дальше. Иногда
Выделение памяти через м-мап и реализация собственного alloc
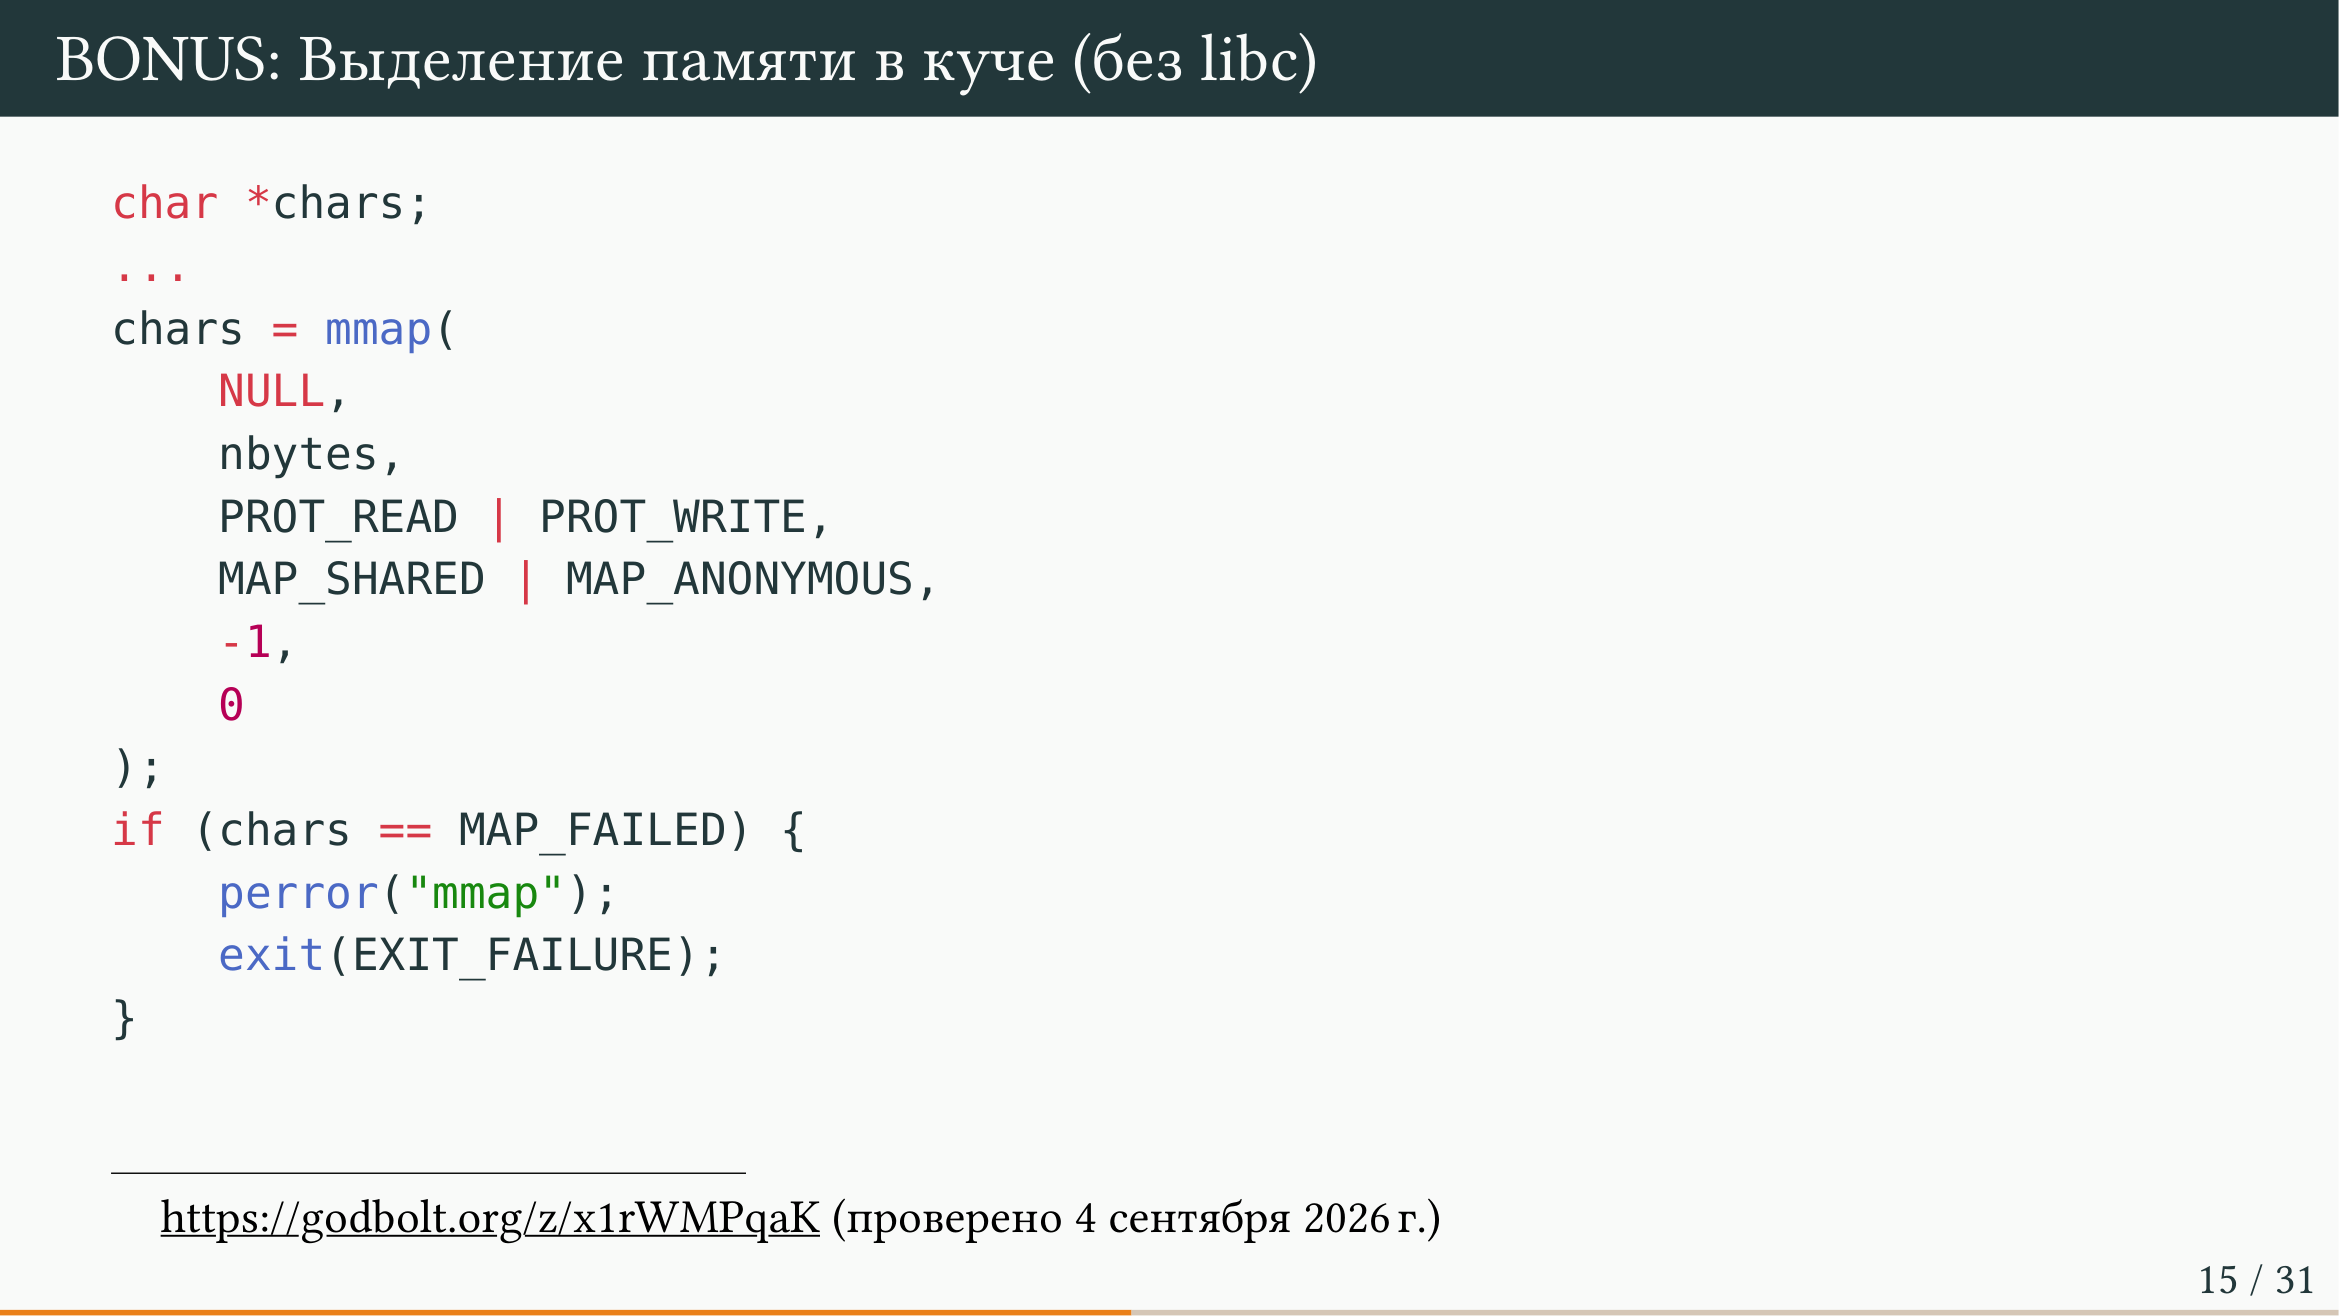
Иногда в системе нет libc, или возникает необходимость выделять память, в то время как malloc находится внутри libc, и вызвать его напрямую нельзя. Неправильным подходом в такой ситуации является попытка влинковать в себя libc, что делает исполняемый файл избыточно большим. Вместо этого следует использовать системные вызовы, поверх которых и написан malloc.
Одним из таких основных инструментов является системный вызов mmap. Он позволяет выделить у операционной системы кусок памяти, при этом предоставляя различные параметры защиты: можно разрешить чтение, запись, а также настроить разделение памяти между процессами. В результате вызова возвращается указатель на выделенный объем памяти и объем выделенной памяти, что является вполне разумным.
Стандартный malloc устроен так, что он делает один большой системный вызов mmap, после чего начинает аккурактно нарезать полученную память на кусочки и выдавать их программе на языке Си при вызовах malloc. Когда программа вызывает free, malloc помечает эти кусочки памяти как неиспользуемые и начинает управлять ими внутри себя так, чтобы уменьшить фрагментацию. Если памяти начинает не хватать, он делает еще один вызов mmap, чтобы выделить дополнительную память для пользователя, пишущего на Си.
При регулярном использовании malloc и free со временем неизбежно наступает фрагментация памяти. Когда делается новый запрос через malloc, менеджеру памяти приходится обходить эти фрагменты в поисках подходящего по размеру свободного блока, что требует определенного времени. В языках программирования с автоматической сборкой мусора ситуация выглядит иначе: там существует так называемая минорная куча, и все выделения памяти сводятся к простой операции взятия памяти с края минорной кучи и увеличению указателя. Если же свободного пространства не хватает, запускается сборка мусора, однако в нормально написанных программах это происходит редко. На вопрос о том, может ли malloc работать медленнее, чем сборка мусора, следует отвечать утвердительно, так как аккуратный обход свободных блоков в поисках подходящего фрагмента занимает процессорное время.
Для реализации собственного malloc необходимо использовать mmap, запрашивая память у операционной системы, которая возвращает выделенный участок, после чего самостоятельно распределять в нем нужные куски. При качественной реализации алгоритма распределения программа будет работать быстро.
Отступление от темы
По ссылке есть программка, которая без malloc выделяет память, и с нею можно работать. Когда-то я писал программу на ассемблере, которая делает на ассемблере mmap, выделяет память и с ней работает. Но я не приложил ссылку, если поискать, я могу ее найти. Мы рассказали про ассемблер. Теперь нужно чуть-чуть поговорить, как ваши
Трансляция языковых конструкций в ассемблер
Трансляция языковых конструкций в ассемблер
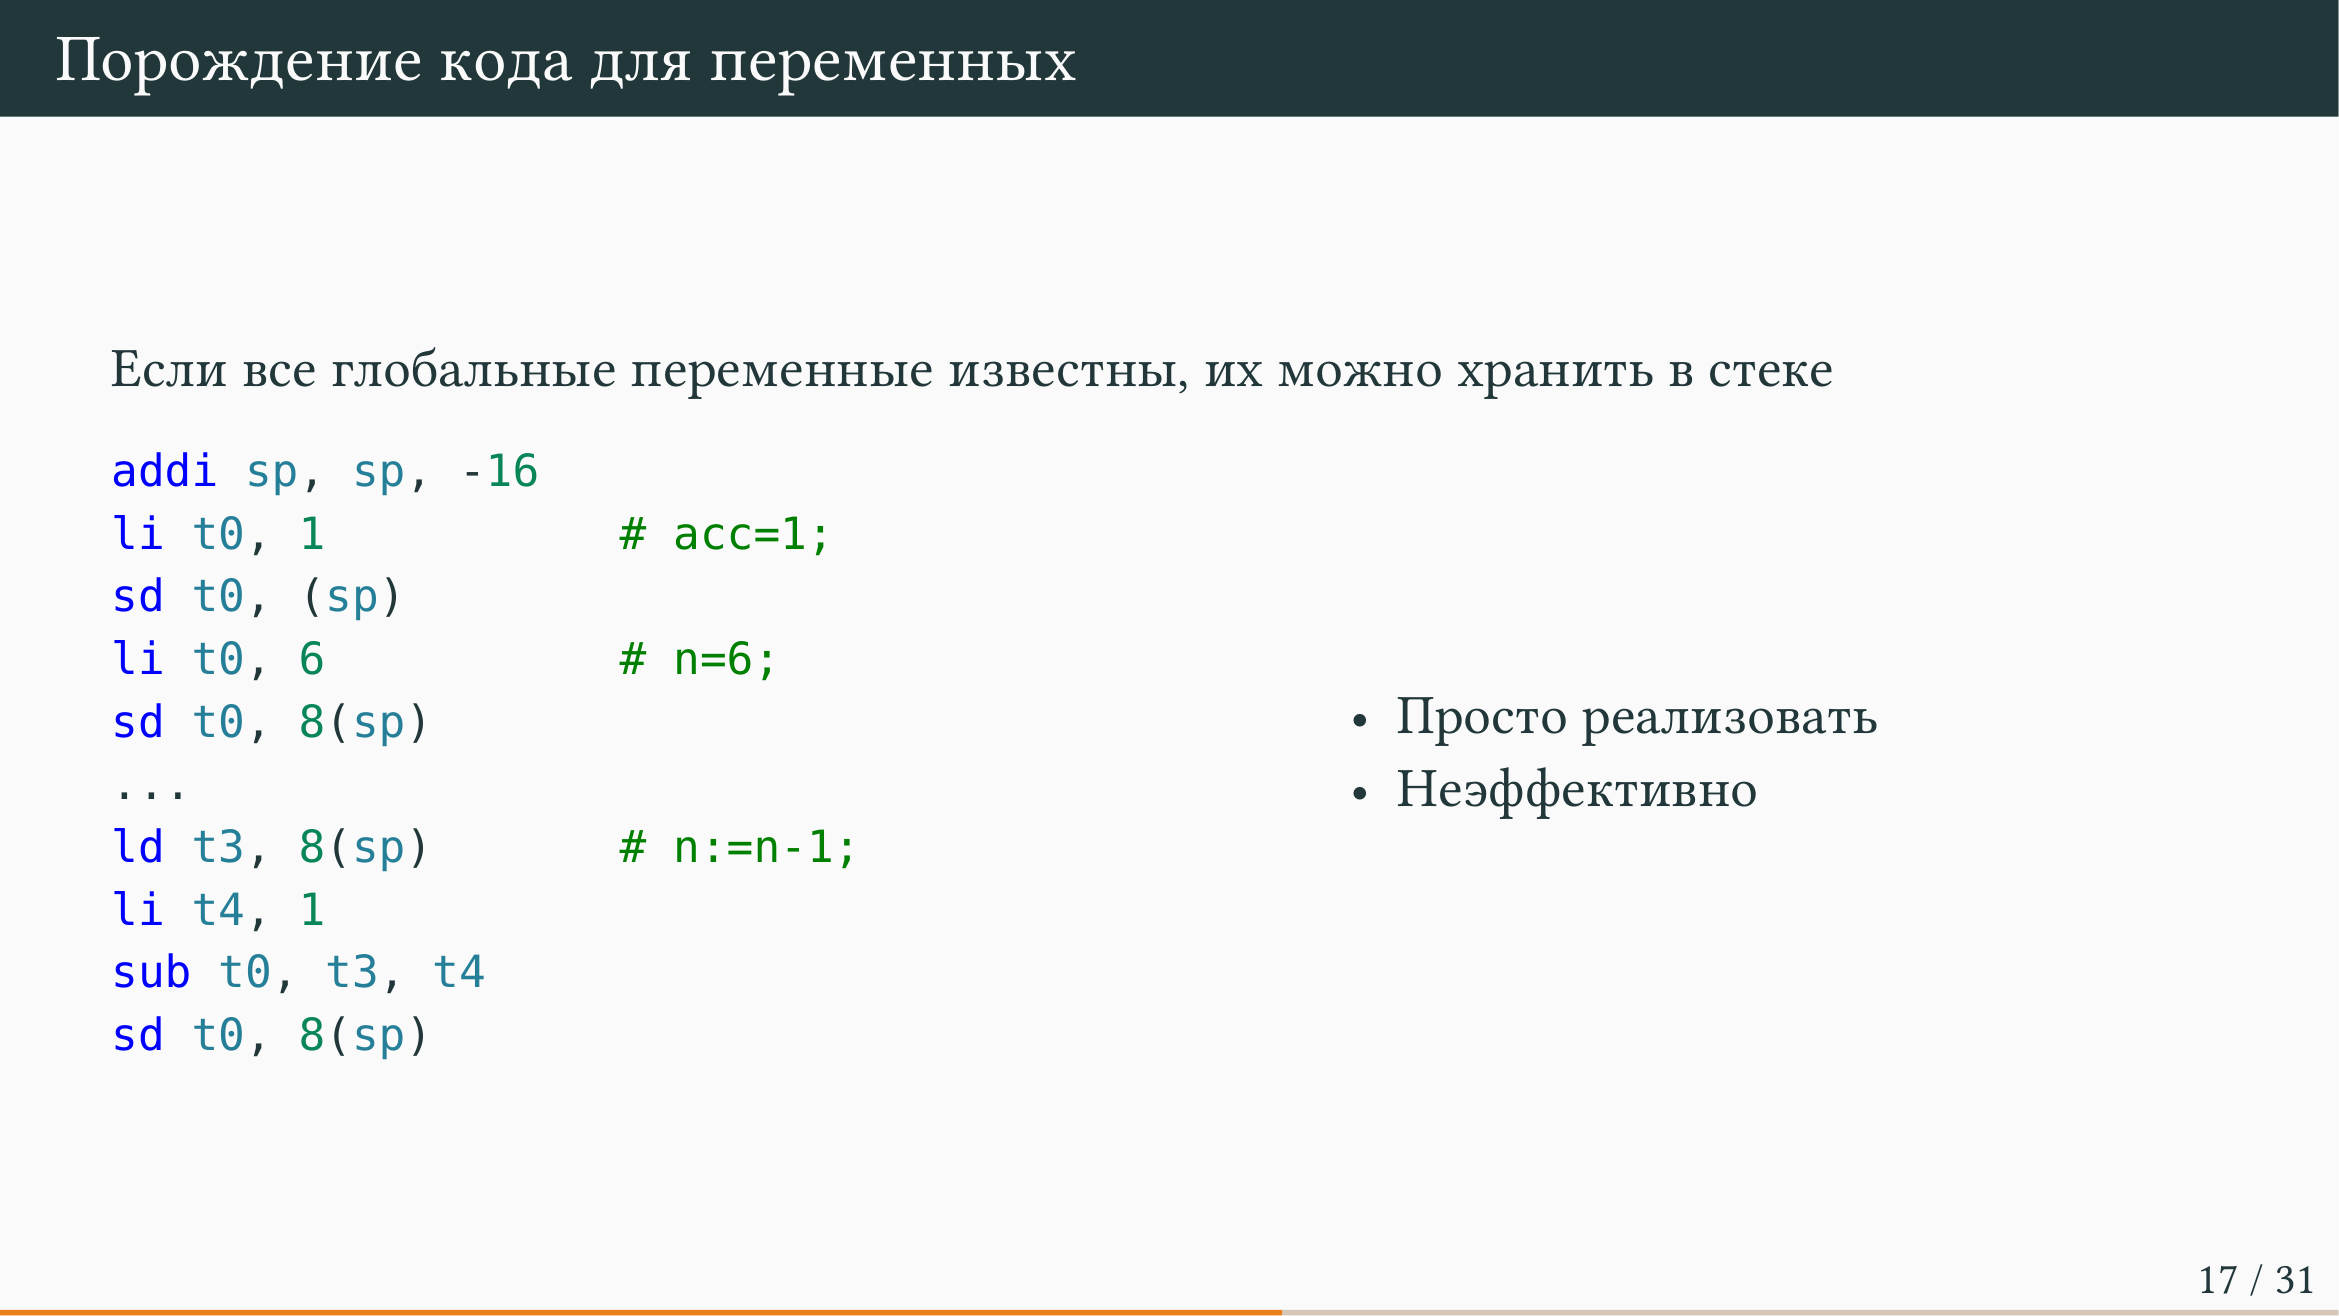
Первым шагом при трансляции конструкций языка программирования в ассемблер является решение вопроса о том, где будут располагаться локальные переменные. Самый простой и прямолинейный вариант — собрать все локальные переменные из всех веток программы и выделить под них место на стеке единовременно с помощью команды addi sp, sp, -8 * количество_переменных. После этого можно обращаться к ним по смещению от адреса вершины стека, например, с помощью команды sd t0, 8(sp), которая записывает значение из регистра t0 по смещению 8 байт от вершины стека, или аналогичной команды загрузки ld.
Отступление от темы
Лектор отвлекается на обсуждение синтаксиса обращения к массивам в языке C через квадратные скобки и задает студентам вопрос о том, понимают ли они, почему это смещение, а не номер. Отмечается специфика языков, где массивы нумеруются с единицы, в то время как в C — с нуля, что для привыкших к единичной нумерации выглядит необычно, так как в скобках указывается именно смещение. Здесь же лектор делает оговорку касательно архитектуры RISC-V. Инструкции RISC-V имеют длину 4 байта (32 бита), что накладывает ограничения на размер константы смещения. Если внимательно посмотреть спецификацию, под константу смещения от вершины стека выделено примерно 20 бит, что в десятичной системе позволяет делать смещение не более чем 2048. Это приводит к интересному эффекту при написании компиляторов: для больших программ с большим количеством локальных переменных код может успешно компилироваться и работать под RISC-V 32, но переставать работать под RISC-V 64. Причина заключается в том, что размер локальной переменной в RISC-V 64 составляет 8 байт, а в RISC-V 32 — 4 байта, при этом количество бит, выделенных под смещение в обеих архитектурах, одинаково. Из-за этого в RISC-V 64 удается выделить на стеке меньшее количество доступных для прямой адресации через стандартные команды смещения переменных. В качестве простого решения этой проблемы лектор приводит разбиение очень длинных функций на более мелкие, чтобы уменьшить количество локальных переменных в рамках одной функции.
Таким образом, для работы с локальными переменными выделяется место на стеке через инструкцию addi, для чтения используется ld с указанием регистра sp и смещения в скобках, а для записи — store double (sd) с указанием сохраняемого регистра, sp и смещения. Постоянная загрузка данных со стека в регистры, выполнение операций и сохранение обратно на стек является крайне неэффективным подходом. Возня со стеком тормозит работу программы по той же причине, по которой работа с памятью медленнее работы с регистрами. Хотя стек обычно находится в кэше процессора и это не будет катастрофически медленно, данный подход всё равно проигрывает использованию регистров, и в настоящих компиляторах так делать не следует.
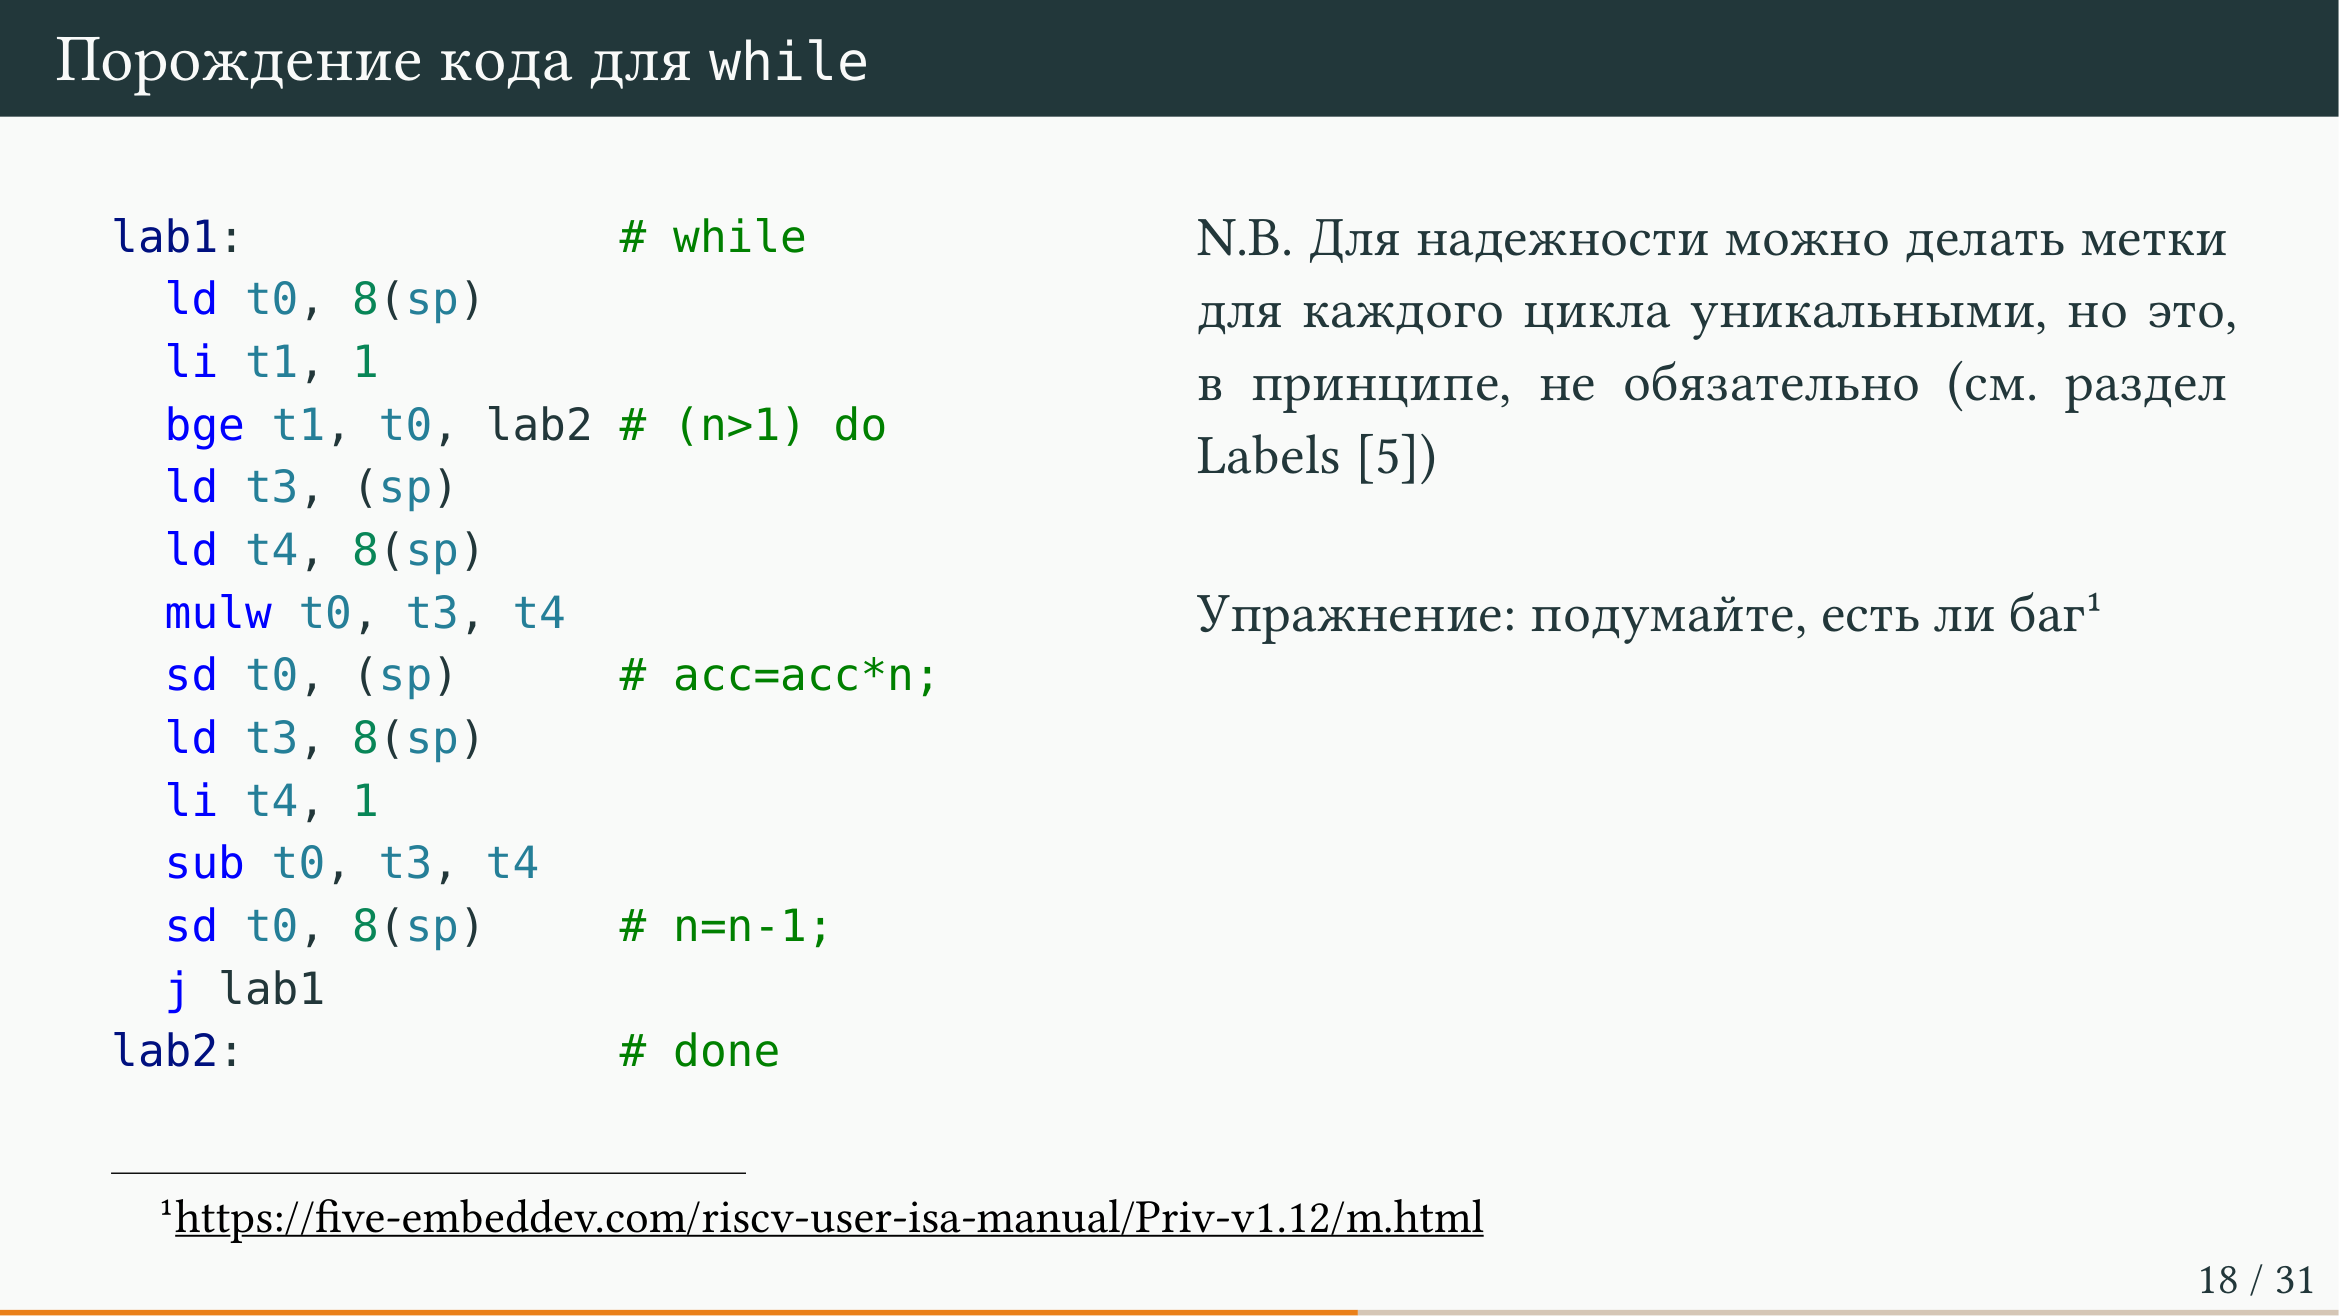
Если требуется добавить в разрабатываемый язык поддержку управляющих конструкций, например цикла while, задача становится интереснее. В цикле присутствуют условие и переходы: условный переход для завершения цикла при неверном условии и безусловный переход для возврата к следующей итерации. Для этого используются специальные метки (labels) начала и конца цикла. В начале цикла исполняется код, загружающий переменные в регистры (например, t0 и t1), после чего выполняется условное ветвление, например bge (branch is greater or equal), которое сравнивает регистры и, если условие неверно, осуществляет прыжок на метку конца цикла (lab2). Если условие верно, программа не совершает прыжок, выполнение проваливается дальше, и исполняется тело цикла. В теле цикла могут происходить арифметические операции над переменными со стека, такие как умножение (mulw) или вычитание (sub), с последующим сохранением результата обратно на стек. В конце тела цикла выполняется безусловный переход j (jump) на метку начала цикла (lab1), после чего проверка условия повторяется заново.
Отступление от темы
Лектор оставляет студентам домашнее упражнение на самостоятельное размышление: подумать, присутствует ли баг в приведённом на слайде коде реализации цикла while, отмечая при этом, что сам он точно знает, что имел в виду при написании, но для стороннего наблюдателя без аккуратного разбора инструкций это может быть неочевидно. Также упоминается, что при вызове функций в генерируемом коде обязательно требуется использовать команды вызова и прыжка (call, jump), не забывая сохранять регистры, иначе программа не будет работать.
Генерация кода через AST и Peephole-оптимизации
Генерация кода ассемблера через AST и Peephole-оптимизации
Переход к генерации кода ассемблера можно осуществлять по-разному. Самый наивный вариант — просто порождать инструкции через функции печати вроде printf, например, выводя li a0, 42. Это будет работать, но рекомендуется создать специальный AST для инструкций ассемблера. В таком случае вместо прямой печати вы будете складывать мнемоники в некоторое хранилище или очередь, которые потом будете порождать.
Отступление от темы
Лектор ведет диалог со студентами о том, рассказывали ли им на первом курсе про пипхол-оптимизации и «подглядывание в замочную скважину» на листингах ассемблера, на что студенты отвечают неуверенно.
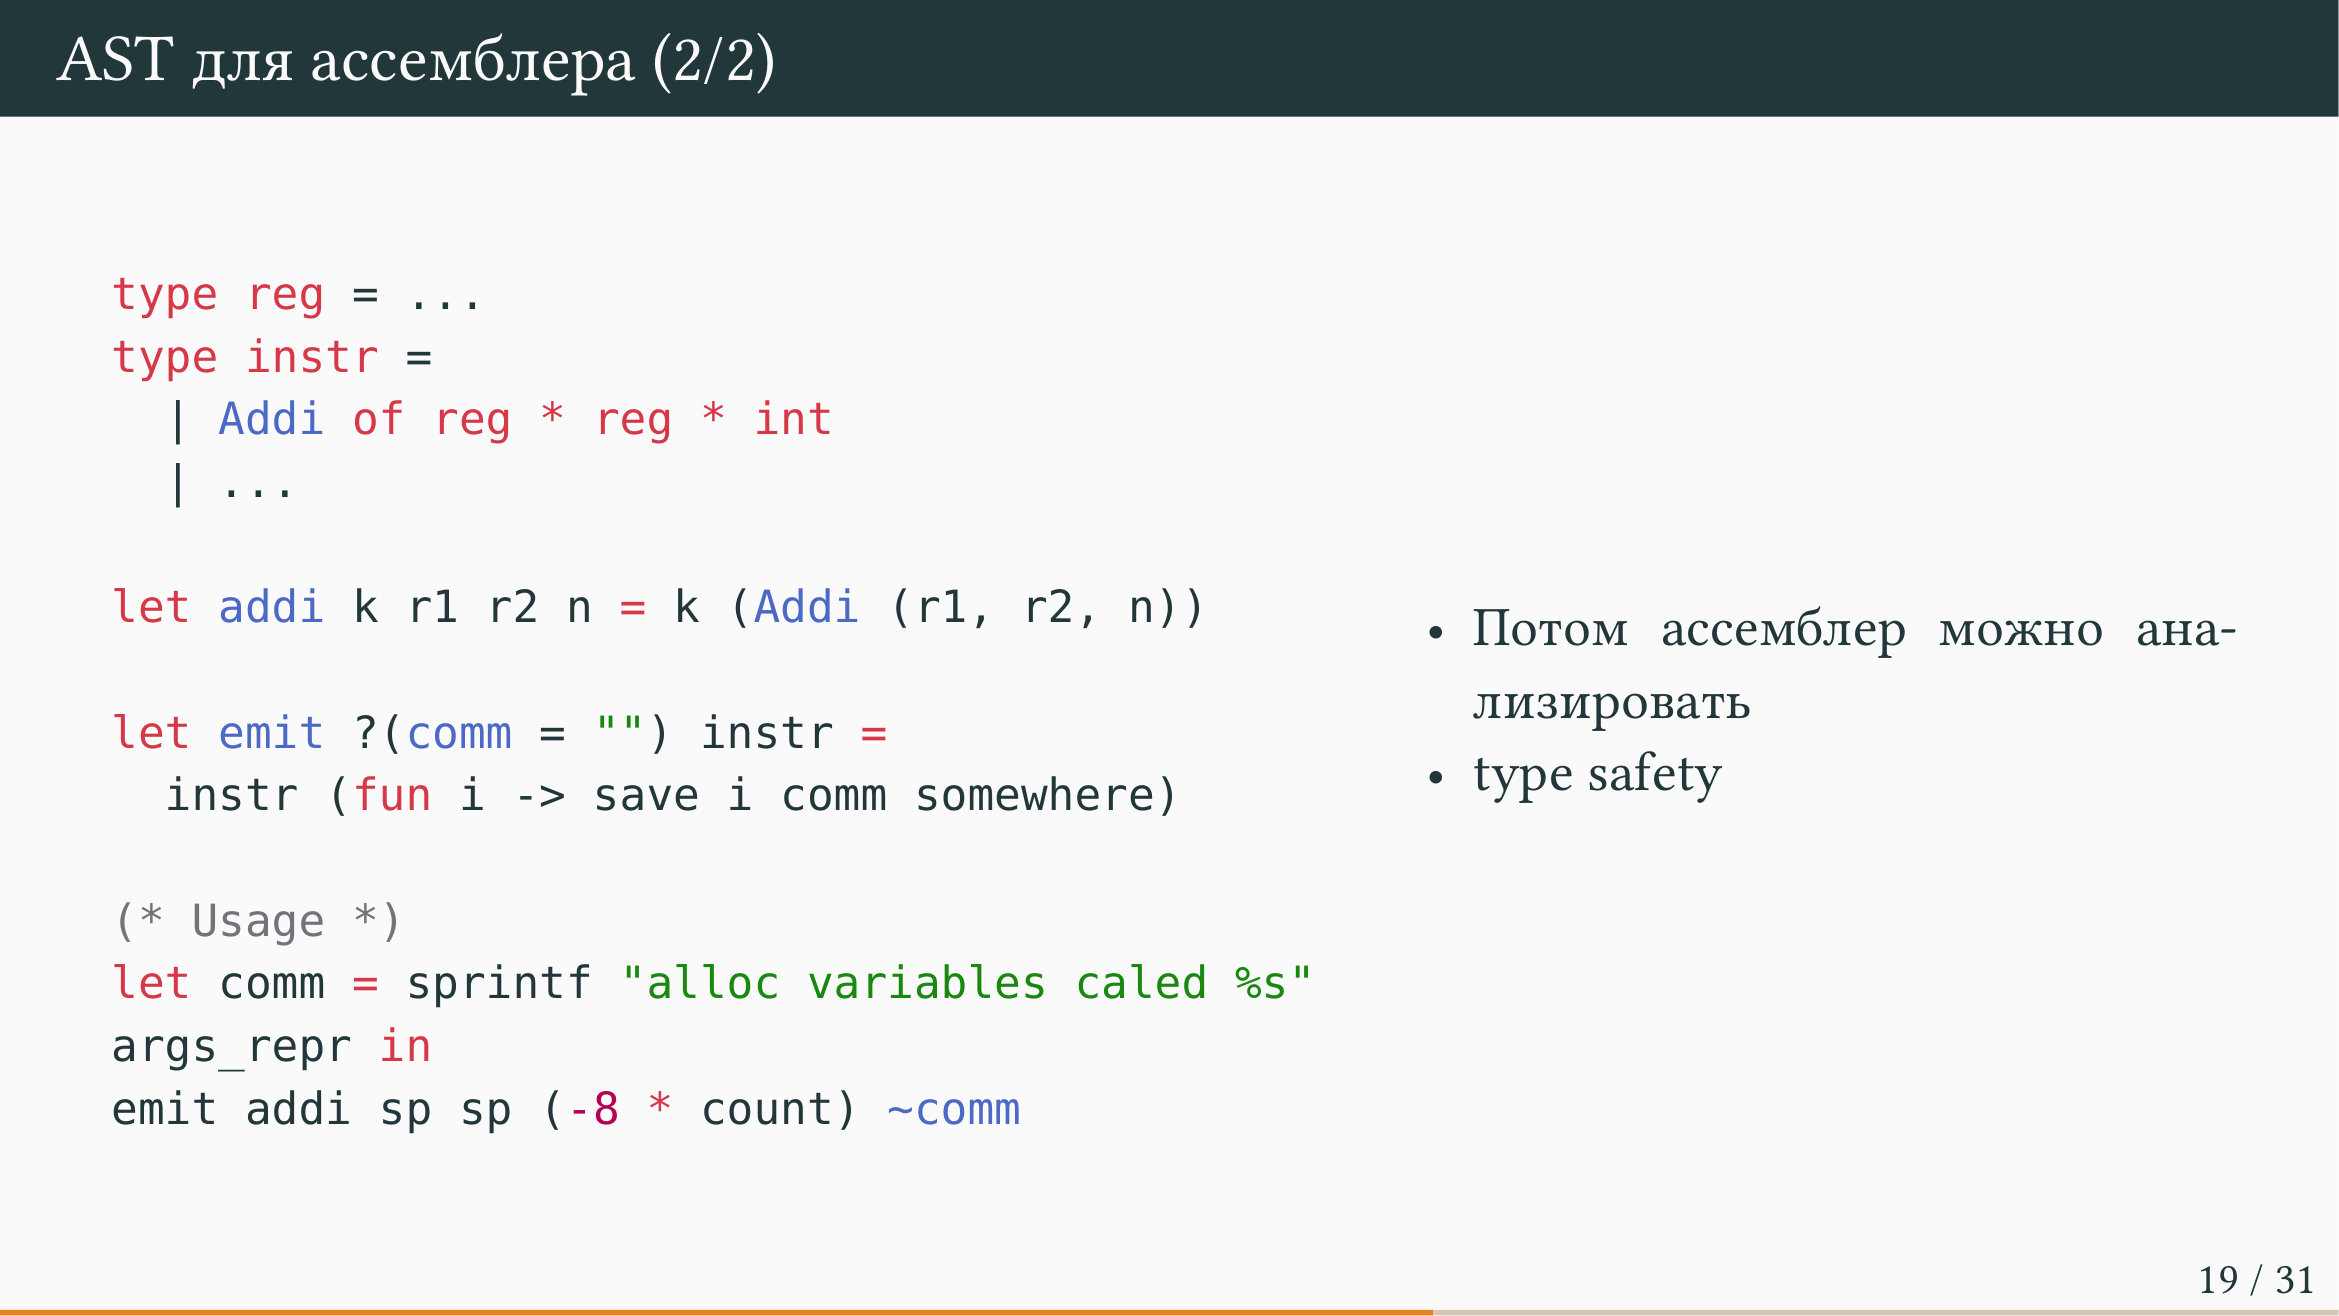
Использование AST для ассемблера дает два главных преимущества. Во-первых, этим приятнее программировать. Узел такого AST является частью типизированного алгебраического типа данных, что защищает от ошибок. Например, если инструкция принимает первым аргументом регистр, а вторым — число, система типов не позволит случайно передать туда два регистра. Во-вторых, порождая AST ассемблера, над ним впоследствии можно проводить различные оптимизации. Самая распространенная вещь, которую хочется сделать сразу, — это так называемые peephole-оптимизации (оптимизации на основе «окна» или подглядывания в замочную скважину).
Рассмотрим, откуда берутся избыточности, на примере работы с локальными переменными на стеке. Пусть мы хотим вычислить выражения 𝑦 = 𝑥 + 1 и 𝑧 = 𝑥 + 𝑦, и мы хотим породить для этого ассемблер. Будем считать, что на стеке элементы расположены в порядке: сначала 𝑥, затем 𝑦, затем 𝑧.
При наивной генерации кода для первой инструкции мы делаем загрузку load double значения 𝑥 в регистр t0 из смещения 0 от sp, затем загружаем константу 1 через load immediate в t1, выполняем сложение ADD в регистр t2 над t0 и t1, после чего сохраняем результат по адресу 8 от sp через store double, так как это не край стека.
Затем мы начинаем наивно порождать код для второй инструкции (𝑧 = 𝑥 + 𝑦). Сначала мы снова делаем load для 𝑥 в регистр t0 со смещения 0 от sp. Здесь уже можно заметить, что эта загрузка избыточна: мы только что загружали 𝑥 ровно в тот же регистр, в который хотим загрузить сейчас, и в промежуточных инструкциях значение не было затерто. Соответственно, эта инструкция загрузки не нужна. Следующая инструкция пытается загрузить 𝑦 через load t1, -8(sp). Но этот 𝑦 уже был посчитан и находится в регистре t2 (или на другом временном регистре), поэтому загружать его из памяти повторно тоже не требуется.
Peephole-оптимизация работает следующим образом. Она смотрит на некоторое количество подряд идущих инструкций (размер «окна» варьируется — сколько укажете, столько и будет обрабатываться) и постепенно сдвигает это окно сверху вниз. Внутри этого окна алгоритм ищет избыточности. Если оптимизация видит, что значение уже загружено в регистр t0, а инструкция пытается сделать это повторно, она признает инструкцию избыточной. Избыточную инструкцию можно либо полностью выкинуть (если это не нарушает адресацию переходов), либо заменить на тривиальную инструкцию, которая ничего не делает (например, move zero в zero).
Тем самым ассемблерный код становится проще и короче. Устранение кода, не влияющего на логику работы программы, приводит к ускорению ее выполнения за счет сокращения общего количества инструкций. Такой подход отлично ложится на наивный метод генерации кода, когда все локальные переменные размещаются на стеке.
Отступление от темы
Лектор упоминает, что по этой теме вполне может быть домашнее задание — сделать peephole-оптимизацию для сгенерированного ассемблера, так как в базовом примере кода чего-то может не хватать для идеальной эффективности.
Таким образом, AST для ассемблера полезно не только тем, что позволяет проводить оптимизации вроде peephole, но и тем, что дает возможность писать удобные комбинаторы кода.
Преимущества DSL и комбинаторов для генерации ассемблера
Использование AST (абстрактного синтаксического дерева) позволяет написать некоторые комбинаторы, которые будут типизированы и позволят более естественным образом порождать код. То есть вы сможете написать функцию emit (в смысле отправить, посылать инструкцию в хранилище), которая также принимает ADDI. У ADDI есть специальная функция, которая соответствует инструкции, и система выводов типов будет применять ее к emit, что будет приводить к тому, что у этого применения будет некоторая ожидаемая арность. Эта арность будет проверяться компилятором: например, что вы передали в ADDI три инструкции [возможная ошибка распознавания: три операнда] — регистр, регистр, число, а не два операнда. printf никогда вас не защитит от таких ошибок, а вот emit — такой предметно-ориентированный язык (DSL), где заведены комбинаторы, чтобы порождать ассемблер — вас защитит. Вы сможете более естественным образом и с меньшим количеством ошибок порождать ассемблер, вернее, AST ассемблера, а потом, если захочется, его еще оптимизировать.
Отступление от темы
Короче, я первый компилятор писал printf'ами. Я рекомендую, скажем так, либо не писать printf'ами, а сразу делать вот так, либо попробовать написать printf'ами, поверить мне, что это плохо, и начать писать вот так. Это примерно как с Java. Нужно попробовать написать на Java, чтобы понять, что это полное говно, и больше на этом не писать. Так что можете считать, что Java — это примерно то же самое, что printf.
Какие-нибудь вопросики, замечания, предложения? В принципе, мне нужно сходить будет за летучкой. Ну и рассказать какие-то слайды еще. Вот, вы хотите перерыв или потом? Потом. Хорошо, что хотите, я не слышу, значит, потом.
Динамическая генерация кода и битовое кодирование инструкций
Динамическое порождение кода и вызов функций из памяти
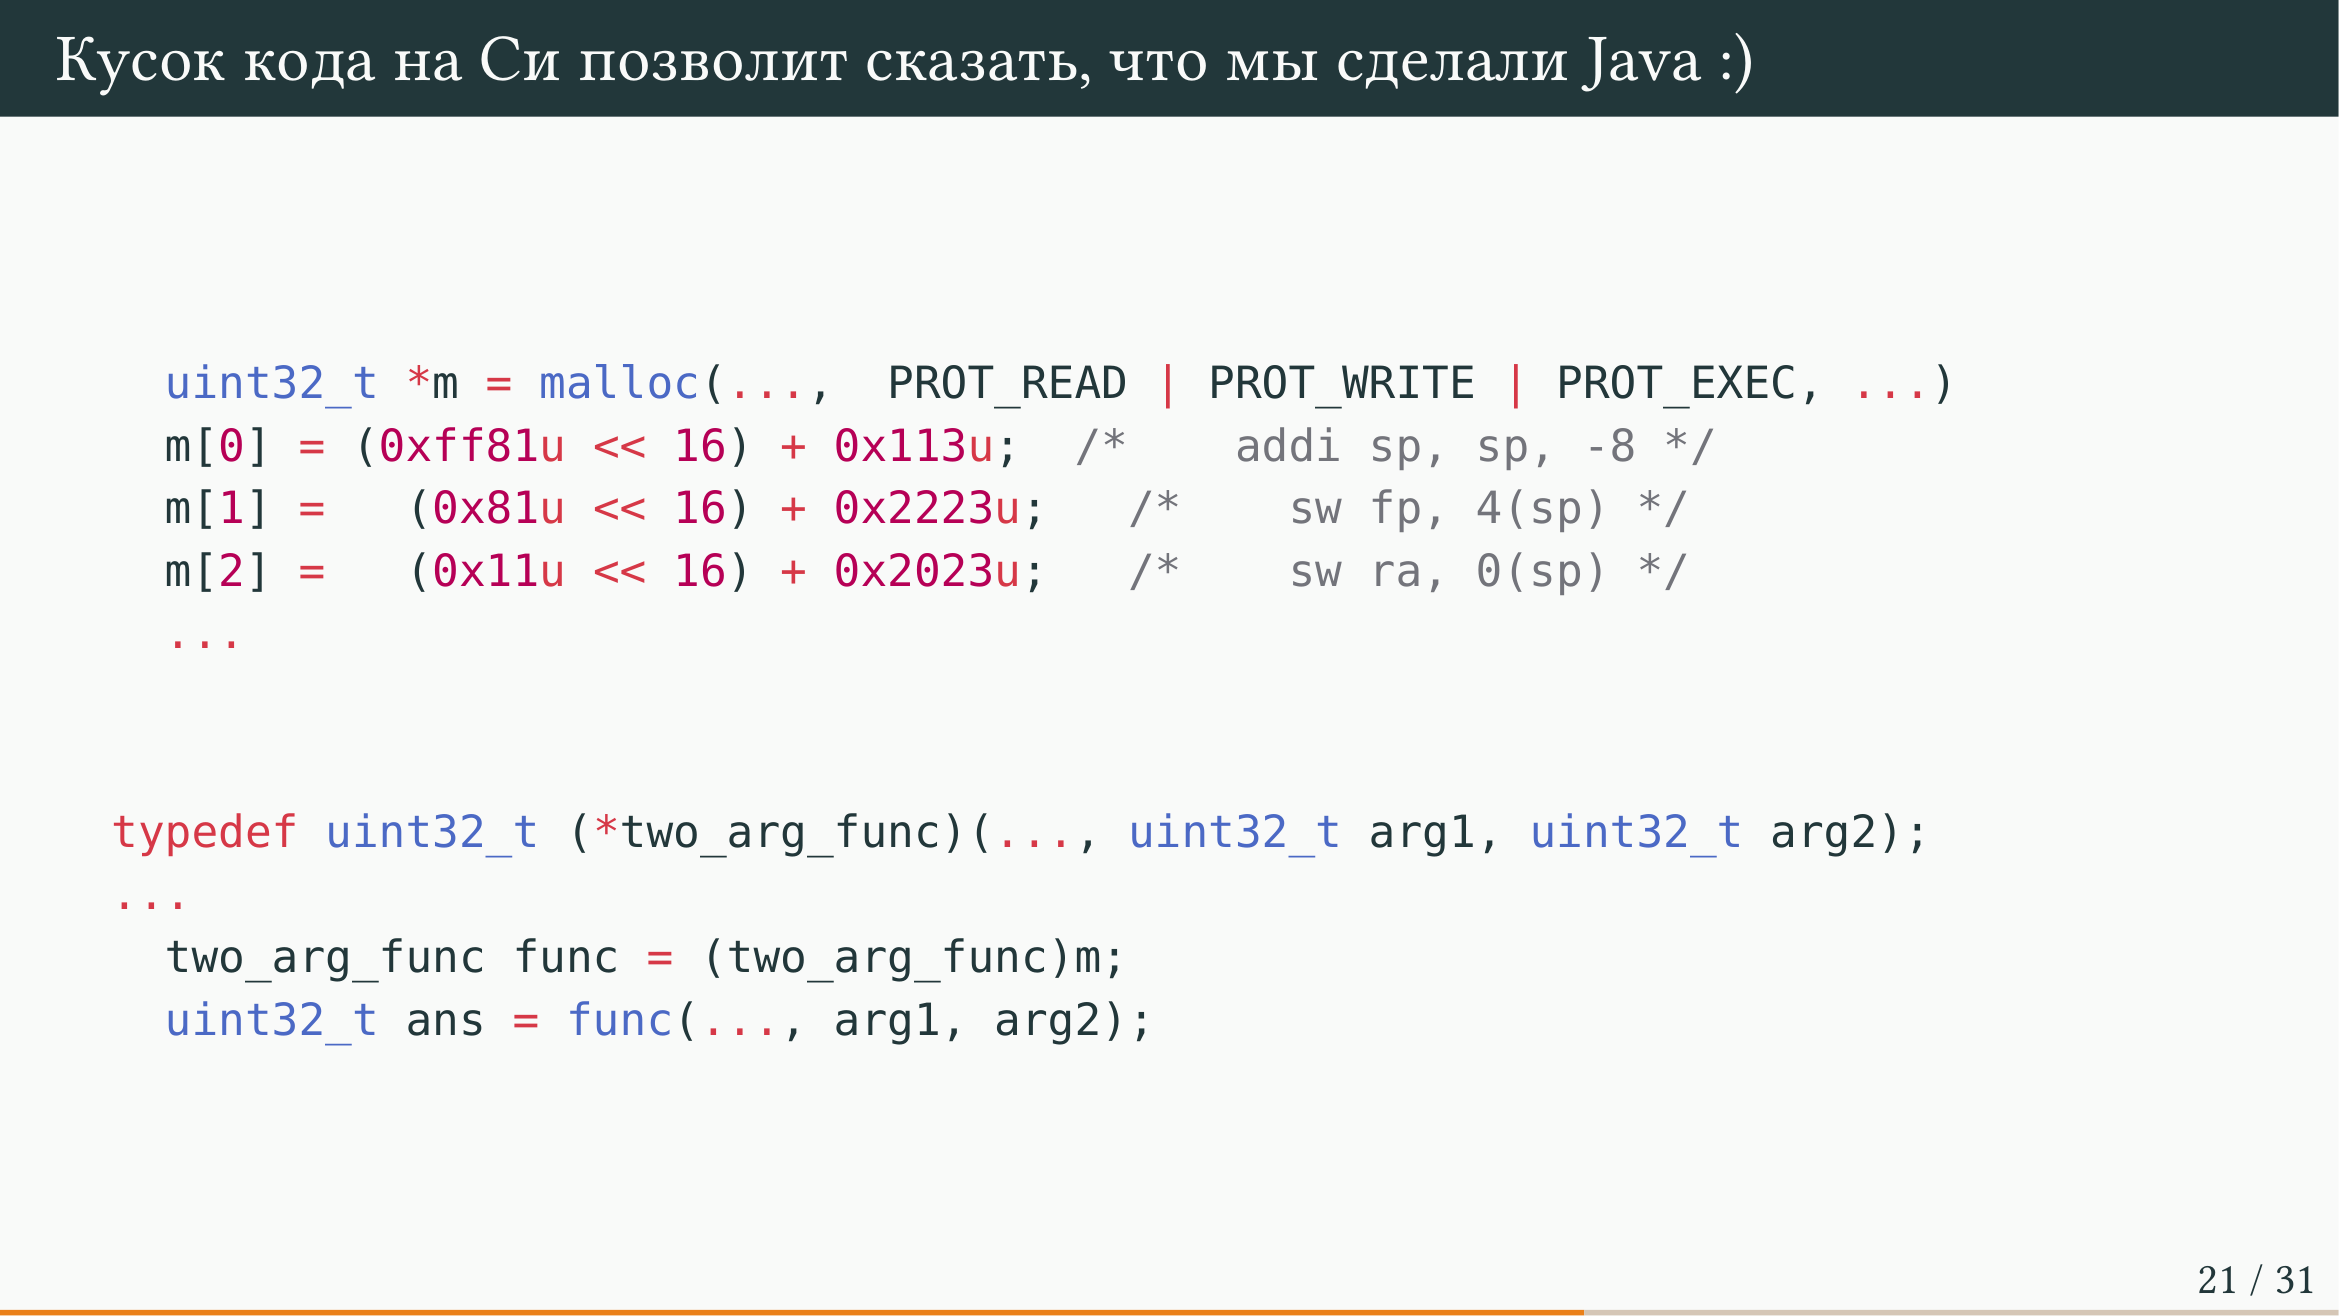
Идея динамического порождения кода заключается в том, чтобы не создавать промежуточные файлы (вроде объектных файлов или исполняемых файлов формата ELF), не возиться с файловой системой и не вызывать внешние компиляторы вроде GCC, а порождать инструкции прямо в памяти во время выполнения программы, как это делает Java.
Чтобы реализовать динамическое порождение кода, необходимо завести массив с инструкциями, в который кладутся байты. Например, верхняя половина из двух байтов и нижняя половина из двух байтов могут соответствовать определенным инструкциям ассемблера (таким как addi sp, sp, -8, sw fp, 4(sp) и sw ra, 0(sp)). Полученный массив байтов затем кастуется к сигнатуре функции, принимающей, например, два аргумента, после чего эту функцию можно запустить. Если в памяти записаны инструкции факториала, программа посчитает факториал; если чисел Фибоначчи — посчитает Фибоначчи.
Таким образом можно написать собственный компилятор, который парсит исходный код, занимается порождением байтов в памяти, не дергая внешние утилиты, кастует полученный результат к сишной функции и передает ей управление. Это позволяет динамически компилировать и исполнять язык, который перед этим парсился. Такой подход можно встроить в собственный компилятор, получив нечто, похожее на работу виртуальной машины Java. В Java используется байт-код, в данном же случае вместо него может выступать промежуточное представление (IR), которое преобразуется в байты и отдается на исполнение сишному коду. При корректной реализации программа выполнит вычисления и выдаст ответ, исполнив скомпилированный код на динамически переданном языке программирования.
Существует разница между понятиями динамический компилятор и Just-In-Time (JIT) компилятор. Динамический компилятор — это общее понятие, означающее, что компиляция программы происходит во время ее исполнения. Just-In-Time компиляция подразумевает более гибкую стратегию: программа может не компилироваться сразу полностью, а начать компиляцию в определенный момент времени, когда это становится необходимым. Например, Java в начале работы пытается интерпретировать байт-код (или промежуточное представление), но если обнаруживает, что какая-то функция исполняется слишком долго, она компилирует ее описанным выше способом в машинный код и в дальнейшем передает управление уже скомпилированной версии.
Реализация такого подхода достаточно проста, если речь идет об изолированных функциях вроде школьного факториала, который выполняет вычисления самостоятельно и не вызывает другие подпрограммы. Однако возникают дополнительные сложности, если функции вызывают друг друга или требуют обращения к функциям стандартной библиотеки (например, вывода на печать через print). В этом случае необходимо либо внедрять вызовы функций стандартной библиотеки внутрь порождаемого кода, либо «захардкоживать» в него реальные адреса, по которым располагаются эти функции.
Технически для реализации динамического исполнения кода в памяти требуется правильно выделить память. Обычный malloc по умолчанию создает память, которую нельзя просто так взять и исполнить, так как страница памяти не имеет соответствующих прав защиты. Чтобы код стал исполняемым, нужно выделить память с правами на чтение, запись и исполнение (например, используя PROT_READ | PROT_WRITE | PROT_EXEC). Последовательность действий выглядит следующим образом: выделяется защищенная память, туда записываются необходимые байты инструкций, полученный указатель кастуется к типу функции, и функция запускается на выполнение. Единственная реальная сложность при этом заключается лишь в том, какие именно байты требуется сгенерировать.
Кодирование инструкций и смещений в RISC-V
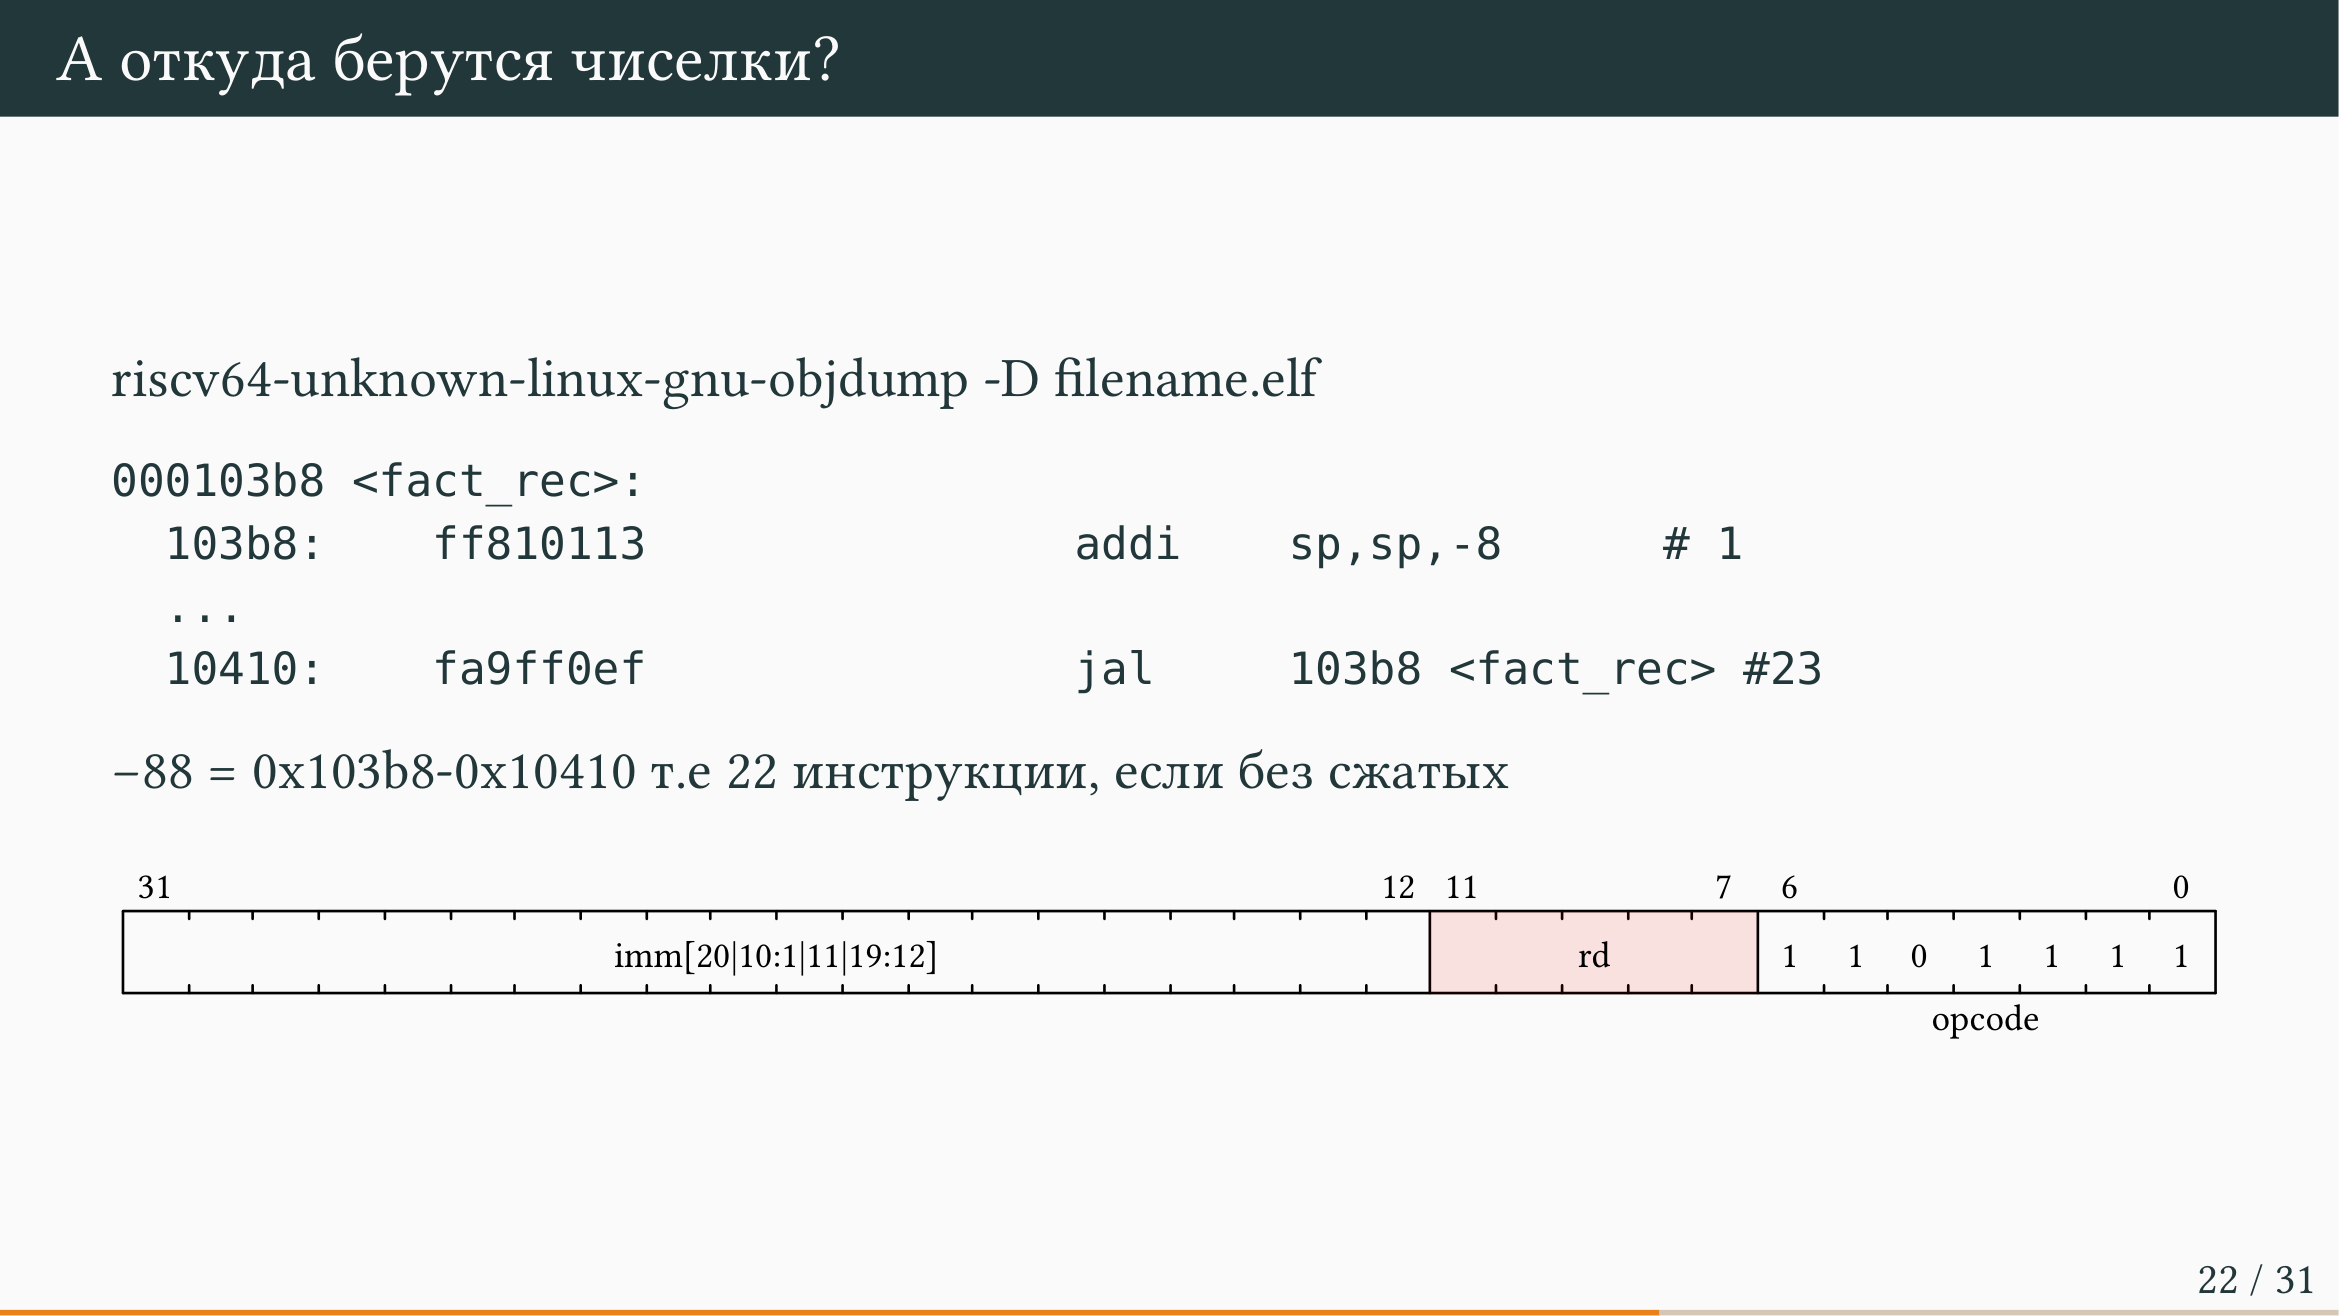
Единственная сложность при работе с функциями и их запуске заключается в байтиках, так как человек плохо предназначен для манипулирования байтиками и битиками. Например, можно легко перепутать, кто из них старший, а кто младший (в данном контексте старшие байтики находятся слева). Сами байтики состоят из битиков, и раскладка этих битиков по байтикам требует чтения мануала, после которого возникает ощущение, что она сделана немножко по-дебильному. Обычно в младших битах пишется код инструкции. Если у нас используется какая-то инструкция JAL (то, во что компилируется call), то под неё отведены первые 7 бит (от 0 до 6), соответствующих JAL. JAL иногда умеет делать прыжки в зависимости от некоторого регистра. Если в регистре назначения (destination, под который выделено 5 битов — от 7 до 11, что примерно соответствует количеству регистров в RISC-V 32) будут одни нули, это означает, что регистр не учитывается при прыжке.
Отступление от темы
Вы слышали истории, как индийский программист проверяет число на чётность? Он пишет максимально простой и понятный код: если 0 — return true (чётное), если 1 — return false (нечётное), если 2 — return true (чётное), и так далее. На самом деле, программисты не так далеки от нас, как вы думаете. Несколько лет назад тут был на PE один студент. Он занимался буквально на вот этом курсе, ему нужно было реализовать вызов функции в рантайме. И он аккуратно написал: если один аргумент, то кастуй к одноаргументноиу функции, вызывай её. Если два аргумента, кастуй к двухаргументной функции, вызывай её. Спустя некоторое время, если у вас 100 аргументов, кастуй к 100-аргументной функции, вызывай её. А если больше у вас 100 аргументов, то exit 1 — не поддерживается. Не надо так делать. Это немножко...
Далее, если мы заняли первые биты под код инструкции и регистр, у нас остается 20 бит на смещение (offset), на которое мы будем прыгать. Ранее упоминалось, что между RISC-V 64 и 32 есть некоторая тонкость: вам будет сложнее доставать значения из стека, если они будут больше. Это происходит как раз из-за конечного количества бит, выделенного под это смещение. Мало того, что их там всего лишь 20, проблема ещё в том, что они расположены не подряд: с краю лежит 20-й бит, потом с 10-го по 1-й, потом 11-й, и с 19-го по 12-й — то есть биты смещения перемешаны. Почему так сделали, лектор не помнит, и кому интересно, могут пошерстить интернет и разобраться, почему инструкции закодировали именно так. Важно то, что из этих битиков нужно собрать смещение, если вы генерируете динамический код. Когда лектор ковырялся с этим в Lua, он написал это максимально тупо: проверял, какое смещение порождает такие-то битики, а другое — другие битики. В принципе, если сделать нормально, можно воспользоваться побитовыми операциями и красиво разложить смещение в 4 байта. Но в Lua пока побитовые операции не добавлены, поэтому пришлось бы заниматься программированием в стиле того самого индийского программиста.
Декодирование смещения инструкции JAL и использование дополнительного кода
Чтобы аккуратно представить 4 байта для инструкции JAL, которая выполняет прыжок назад (например, на минус 88, то есть адреса вычитаются), необходимо разбираться в том, как перемешаны биты. Если адрес инструкций 10410, и из него вычесть 103b8, то как раз получится примерно минус 88. Минус 88 делится на 4, так как все наши инструкции занимают 4 байта, поэтому никакой коллизии в чётности не происходит.
Да, в архитектуре RISC-V существуют так называемые сжатые инструкции (compressed instructions), которые занимают 2 байта, а не 4. Короткие программы быстрее исполняются, поэтому сжатые инструкции хороши для перформанса. Но здесь мы рассматриваем простой вариант, когда инструкции занимают 4 байта. Поэтому 88 делится на 4, и получается прыжок на 22 инструкции.
Отступление от темы
Возможно, в домашке у вас будет какая-то домашка про сжатые инструкции, но скорее всего нет. Но если вам очень хочется, ее можно придумать.
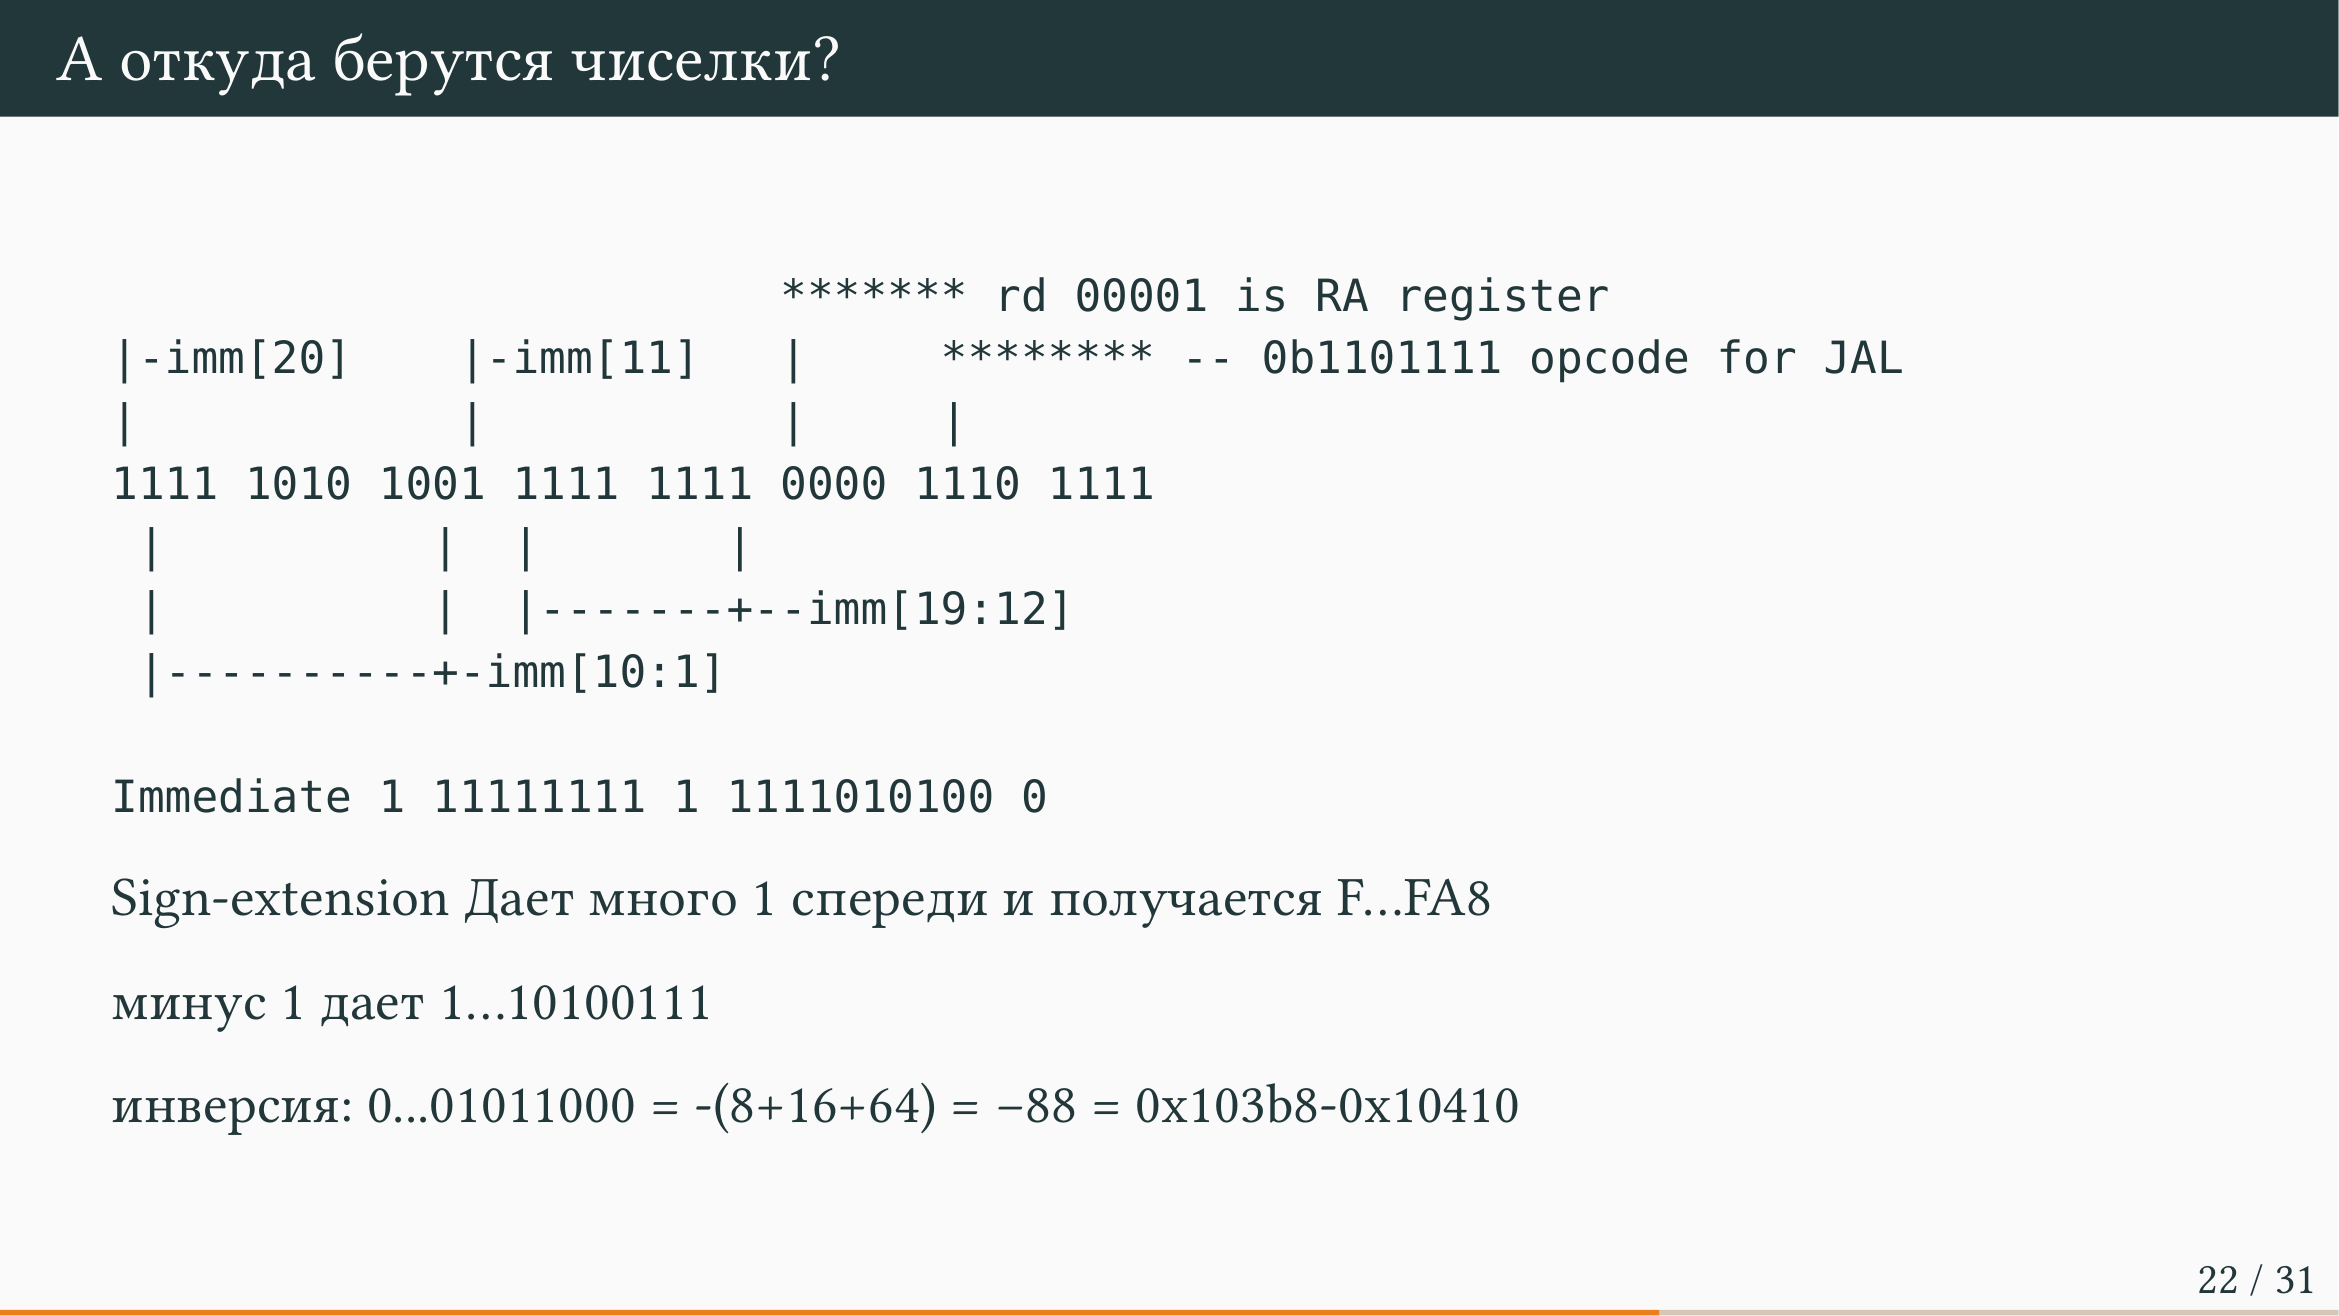
Если аккуратно во всём этом разбираться, то нужно эти 4 байтика выписывать в 32 битика и смотреть, кто что значит. В инструкции JAL биты распределены следующим образом: с краю у нас 7 бит под код инструкции, дальше идет номер регистра, а дальше идут вперемешку биты 19–12, 11, 10 по 1, и 20 — самый старший бит прыжка.
Возможно, вас смущает отсутствие кое-чего, например, для константы кое-что забыли указать. На самом деле здесь не совсем очевидно, что такое нулевой бит константы. Но так как у нас прыжки осуществляются по инструкциям, а инструкции занимают либо 2, либо 4 байта, то они находятся на чётных адресах. Поэтому будем считать, что нулевой битик всегда равен 0, и давайте его не указывать, раз он всегда 0.
Дальше мы берем эти биты, переставляем их в правильном порядке и выписываем константу. Старшая единица означает, что у нас число отрицательное. Если вы распространите эти единицы на старшие разряды (sign-extension), сделаете вычитание единицы, а потом инверсию, то вы получите искомое значение: $8 + 16 + 64 = 88$, то есть минус 88. То, что сейчас было сделано — это обратное раскодирование дополнительного кода (two's complement): мы вычли единицу и сделали инверсию.
Дополнительный код буквально используется в кодировании констант в инструкциях RISC-V.
Отступление от темы
Если вы подумали, что дополнительный код на первом курсе был нужен исключительно для того, чтобы укрощать студентов, то он нужен не только для этого, а еще чтобы инструкции кодировать с отрицательным смещением. Так что то, что вас спрашивали на первом курсе, это не то чтобы абсолютно бесполезное знание, оно иногда пригождается. Вы, конечно, подумали, зачем это нужно, но вот лектор объясняет, зачем: чтобы компиляторы писать, динамические компиляторы в RISC-V — лучших в мире языках программирования, которые похожи на кампуктеры.
Когда я пыталась взломать вот это вот кодирование с нейронками, нейронки выдавали разные ответы, что как бы намекает, что они врали. Если вы будете пытаться разобраться с этим с помощью нейронки, будьте осторожны: вы и я плохо считаем битики, и нейронки тоже иногда косячат, будьте осторожны.
Так, кто-нибудь хочет спросить что-нибудь? Замечание, предложение? Просто дальше осталась некоторая поверхностная информация, которая может быть вам пригодится, непосредственно может быть нет при написании компилятора. Ну ладно, едем дальше.
Макрооперации, псевдоинструкции и сравнение с x86-64
Сравнение x86-64 и RISC-V: слияние макроопераций
Эволюция архитектур x86-64 и RISC-V во многом была обусловлена удобством для человека. Изначально создавались более простые инструкции, а затем — сложные, которые выполняют сразу много действий и позволяют выразить некоторую высокоуровневую конструкцию одной инструкцией. Самым простым примером такой инструкции является fused multiply-add, когда складываются значения из двух регистров и результат умножается на третий. Когда такая инструкция исполняется процессором, начинает работать микроядро, которое перемалывает её в микроинструкции для последующего исполнения. Для эффективной работы этого процесса необходимо, чтобы парсинг инструкций, их разбиение на микроинструкции и последующий конвейер работали быстро.
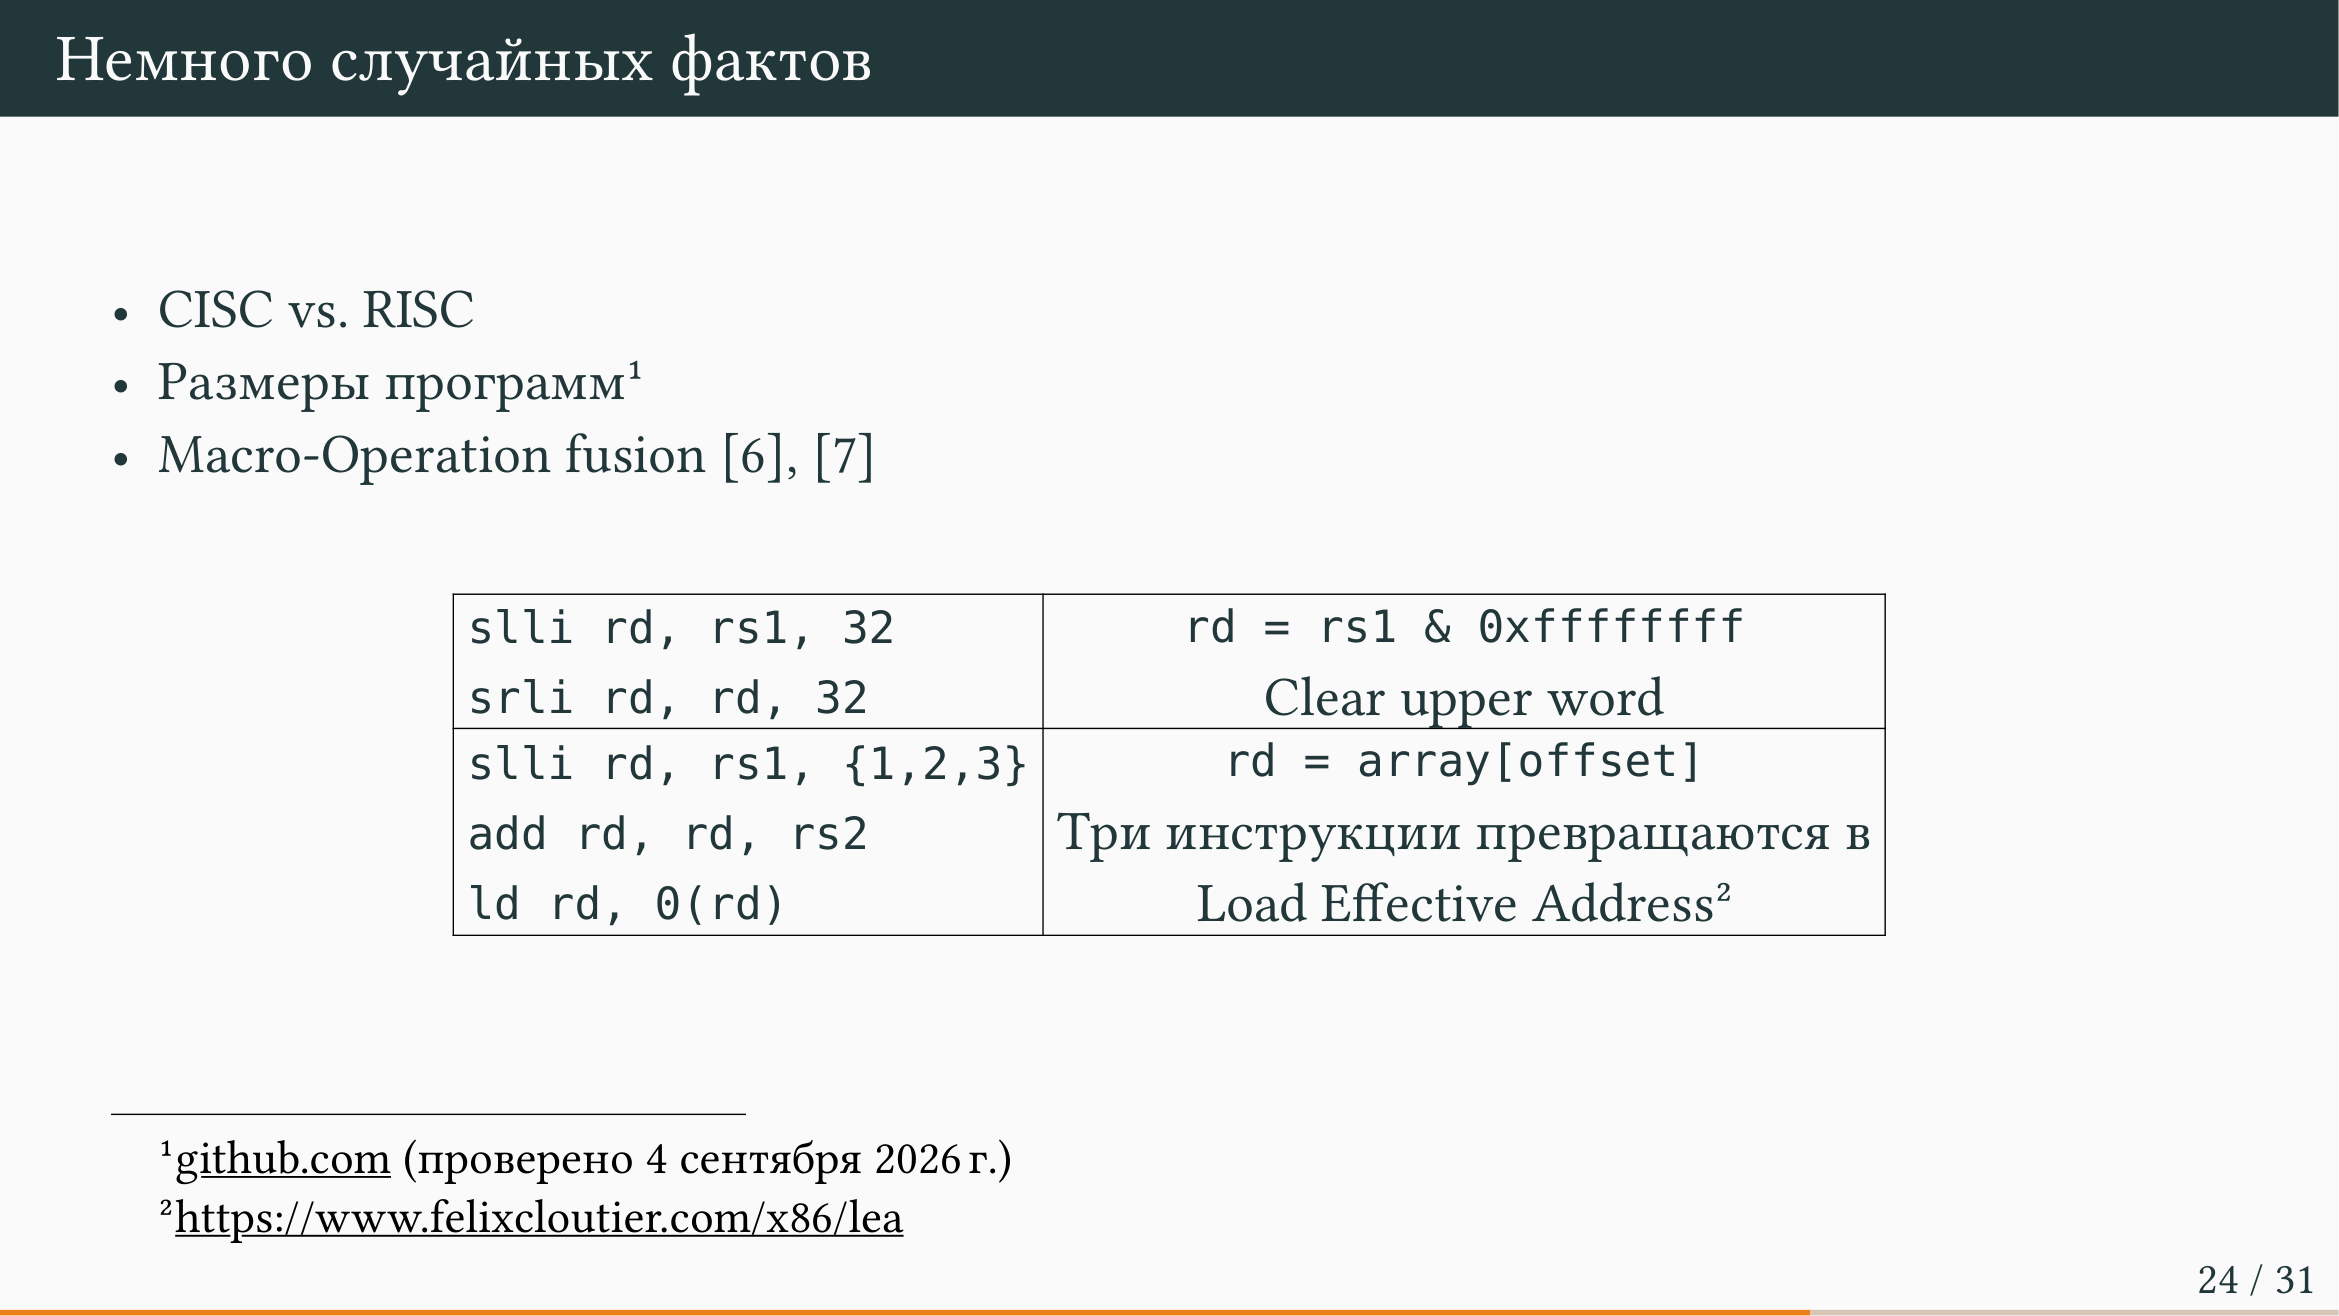
В RISC-V больших и сложных инструкций по сравнению с x86-64 нет. Из-за этого некоторые сложные операции на RISC-V преобразуются в бо́льшее количество инструкций, чем могло бы быть в x86-64. Сторонний наблюдатель может сказать, что код на RISC-V становится длиннее, поэтому данная архитектура by design исполняется медленнее, чем x86. Однако на практике здесь начинают действовать эффекты, связанные с микроядром, а именно macro operation fusion (слияние макроопераций). Микроядро способно декодировать не только отдельную инструкцию, но и целую последовательность инструкций, написанных подряд, распознавая в них некоторую высокоуровневую идею. В результате несколько инструкций архитектуры RISC-V могут быть объединены в одну микроинструкцию микроядра с последующим исполнением — то есть выполняется операция, обратная тому, что делает x86.
Отступление от темы
если вдруг когда-то вы пойдете на собеседование и вас спросят про вот это вот, вы сможете выпендриться и выглядеть лучше, чем на самом деле. На спецобедах это обычно приветствует, так что имейте в виду, бывает macro operation...
Тем самым в микроархитектуру процессора закладываются определенные хаки относительно того, какие последовательности инструкций можно исполнять эффективно и быстро. Поэтому для высокой скорости выполнения программы важно не просто сгенерировать корректный код, а расположить рядом ровно те комбинации инструкций, которые являются удачными для конкретного процессора, чтобы он смог их распознать и исполнить быстро. Конкретный список таких комбинаций зависит от процессора. Туда может входить, например, очистка верхней половины регистра, которая достигается сдвигом значения в регистре наполовину влево, а затем наполовину вправо (поскольку при сдвиге вправо старшие биты заполняются нулями). Другим примером может служить комбинация инструкций сдвига slli, сложения add и загрузки ld, которая превращается в Load Effective Address для вычисления адреса элемента массива.
Псевдоинструкции и оптимизация вызовов функций в RISC-V
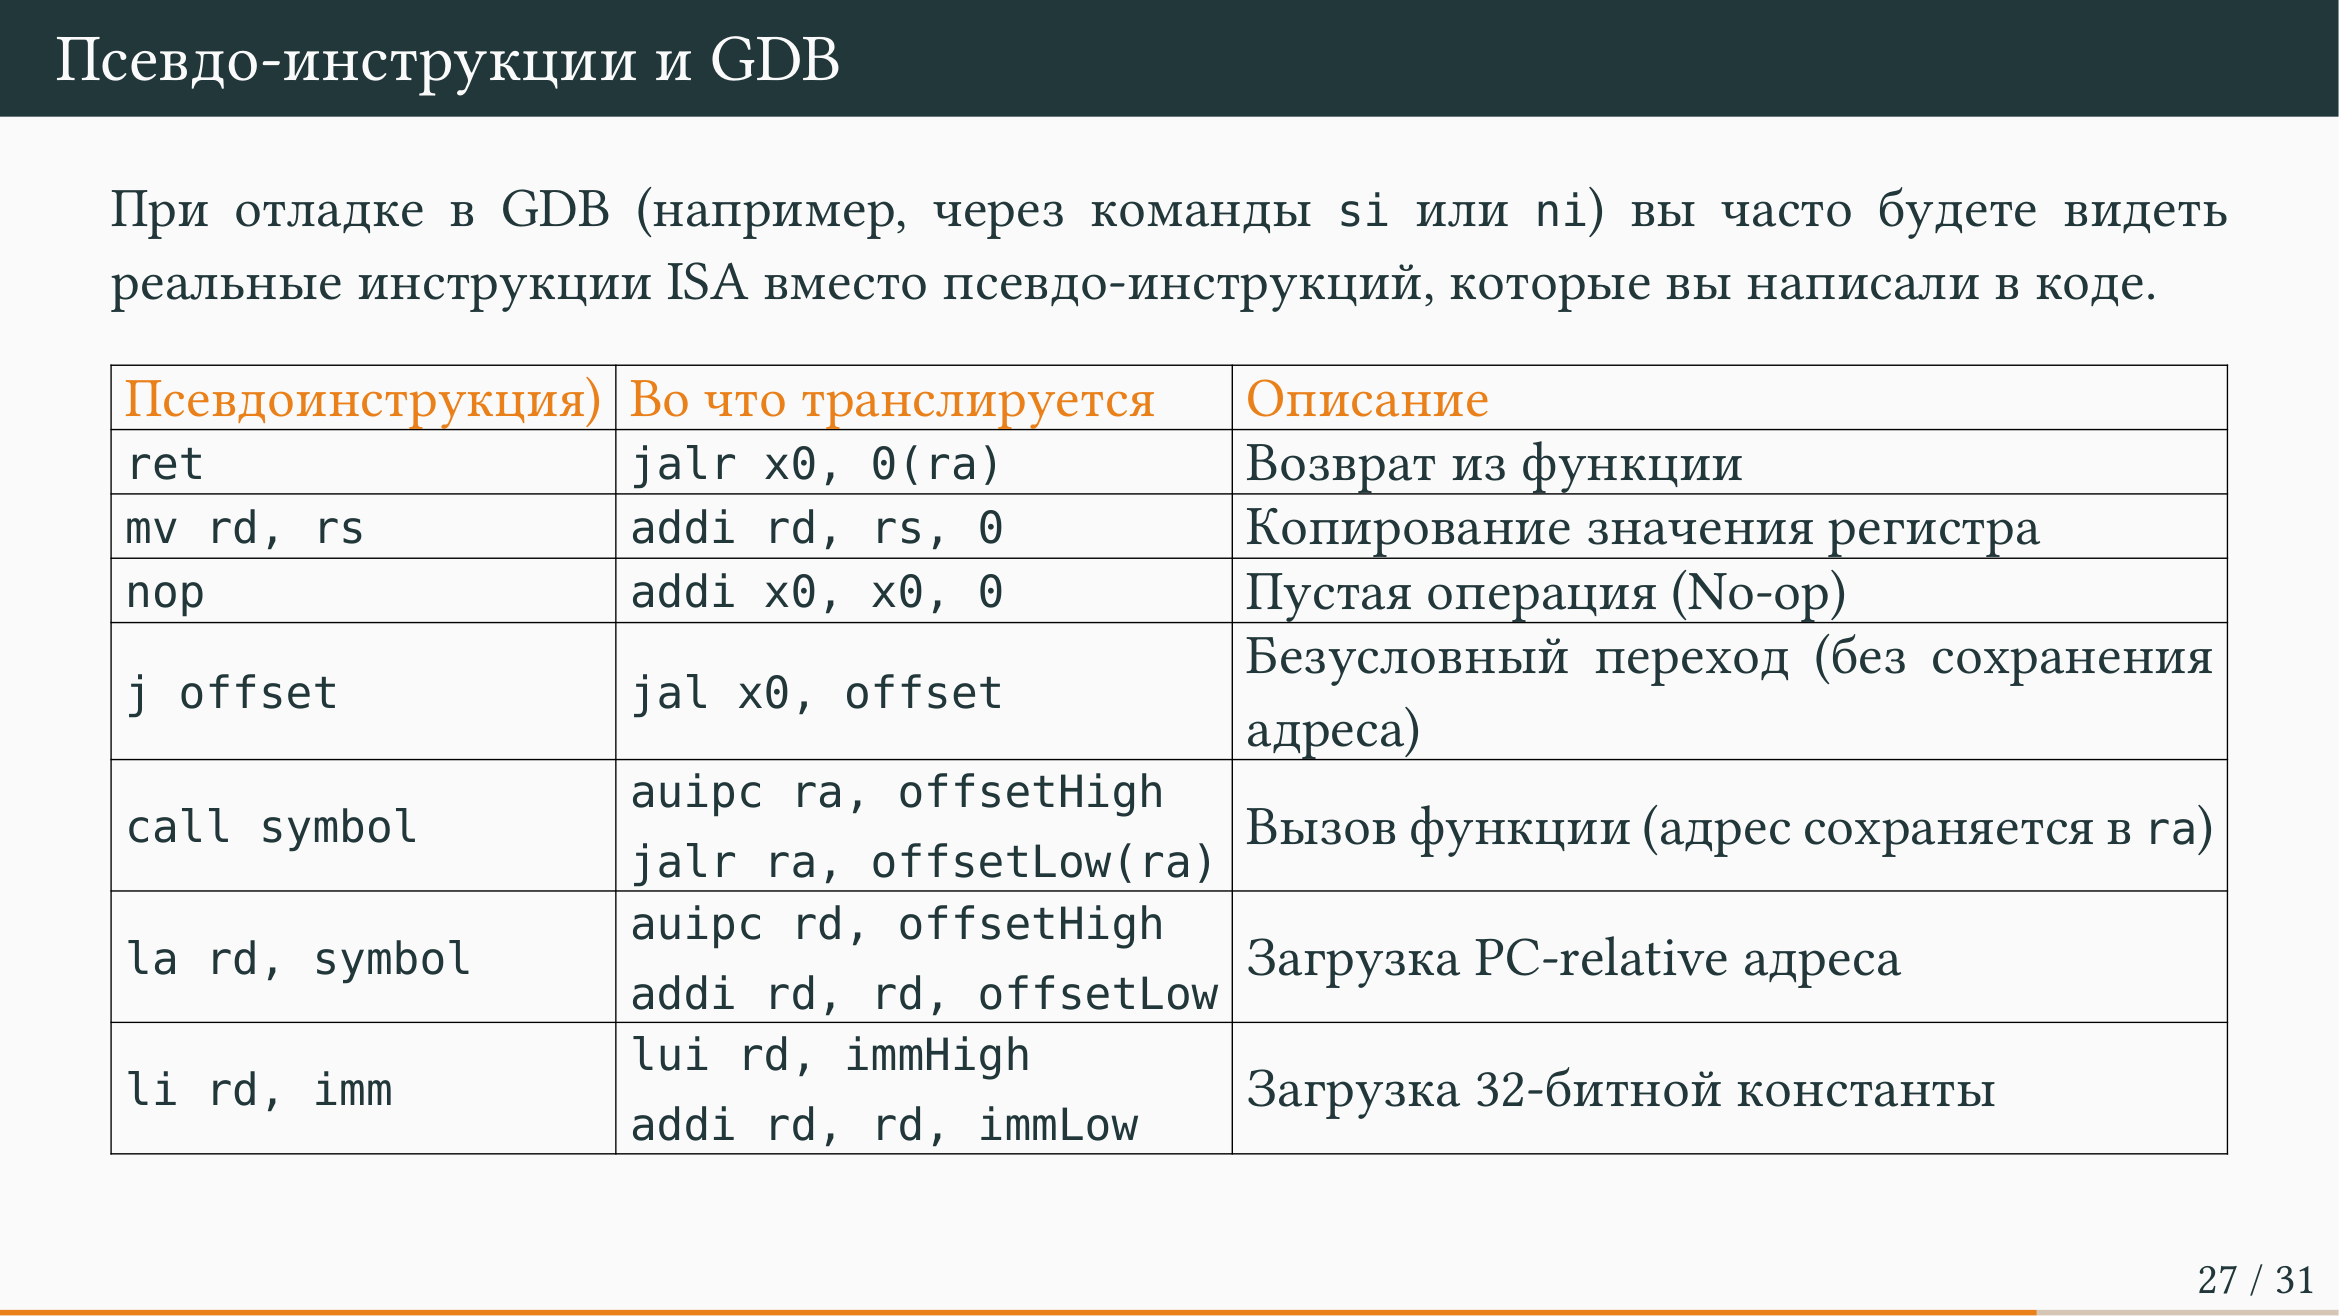
Понятие псевдоинструкций возникает из необходимости упростить написание и чтение кода для человека, поскольку физически запихнуть все возможные команды в архитектуру невозможно. Поскольку команды имеют фиксированную длину 32 бита, мы ограничены числом $2^{32}$ возможных инструкций. Кроме того, часть бит необходимо выделять под указание регистров (операндов бывает два или три), а также под константы. Теоретически можно было бы сделать бесконечно много 32-битных инструкций, но практически это абсолютно бесполезно, поэтому реальных инструкций в процессоре мало.
Некоторые последовательности инструкций или удобные алиасы называются псевдоинструкциями — это команды, которые принимаются ассемблером и на самом деле раскрываются в две или три реальные инструкции. Например, для возврата из функции не нужно иметь отдельную сложную инструкцию return — обычно это компилируется в jalr x0, 0(ra) (jump and link register), то есть переход в регистр ra (return address), куда нужно вернуться после исполнения функции. Поскольку при переходе на ra дополнительное смещение не нужно, оно равно нулю. Другой пример — псевдоинструкция mv rd, rs, которая перекладывает значение из одного регистра в другой (где destination указан слева, а source — справа). Отдельную инструкцию move делать необязательно, так как уже существует инструкция addi (сложение регистра с константой): ассемблер просто берет константу 0 и превращает move в addi с константой 0 (addi rd, rs, 0).
Вы обязательно увидите это на практике. Если в ассемблерном листинге написать команду move, а затем запустить отладку программы с помощью gdb (например, используя команды si или ni), то в отладчике распечатается инструкция addi вместо move. Это сделано для того, чтобы вы не доумевали, куда делся ваш move, и понимали, что псевдоинструкции на самом деле раскрываются в другие одиночные инструкции либо в целые пачки инструкций.
Аналогичным образом обстоит дело с вызовами функций (call). Если вы делаете call на адрес, который находится довольно далеко, в 32 битах нельзя поместить константу целиком — помещаются только младшие биты (например, 20 бит). Поэтому для дальнего прыжка вначале приходится загружать верхнюю часть адреса, а затем нижнюю, и такой вызов скомпилируется в две инструкции. Короткие же вызовы компилируются в одну инструкцию. Когда вы компилируете отдельные объектные файлы (.o), в них появляются длинные инструкции. Затем, когда вы компонуете эти объектные файлы в единый ELF-файл, линкер внимательно смотрит на прыжки и функции и выполняет процедуру, называемую link relaxation. Линк релаксация заменяет сложные инструкции прыжка на короткие там, где это возможно — если при статической линковке оказывается, что две функции находятся близко друг к другу и можно обойтись прыжком, загрузив только младшие биты смещения. Понятие link relaxation часто спрашивают на собеседованиях, поэтому рекомендуется изучить его самостоятельно.
Отступление от темы
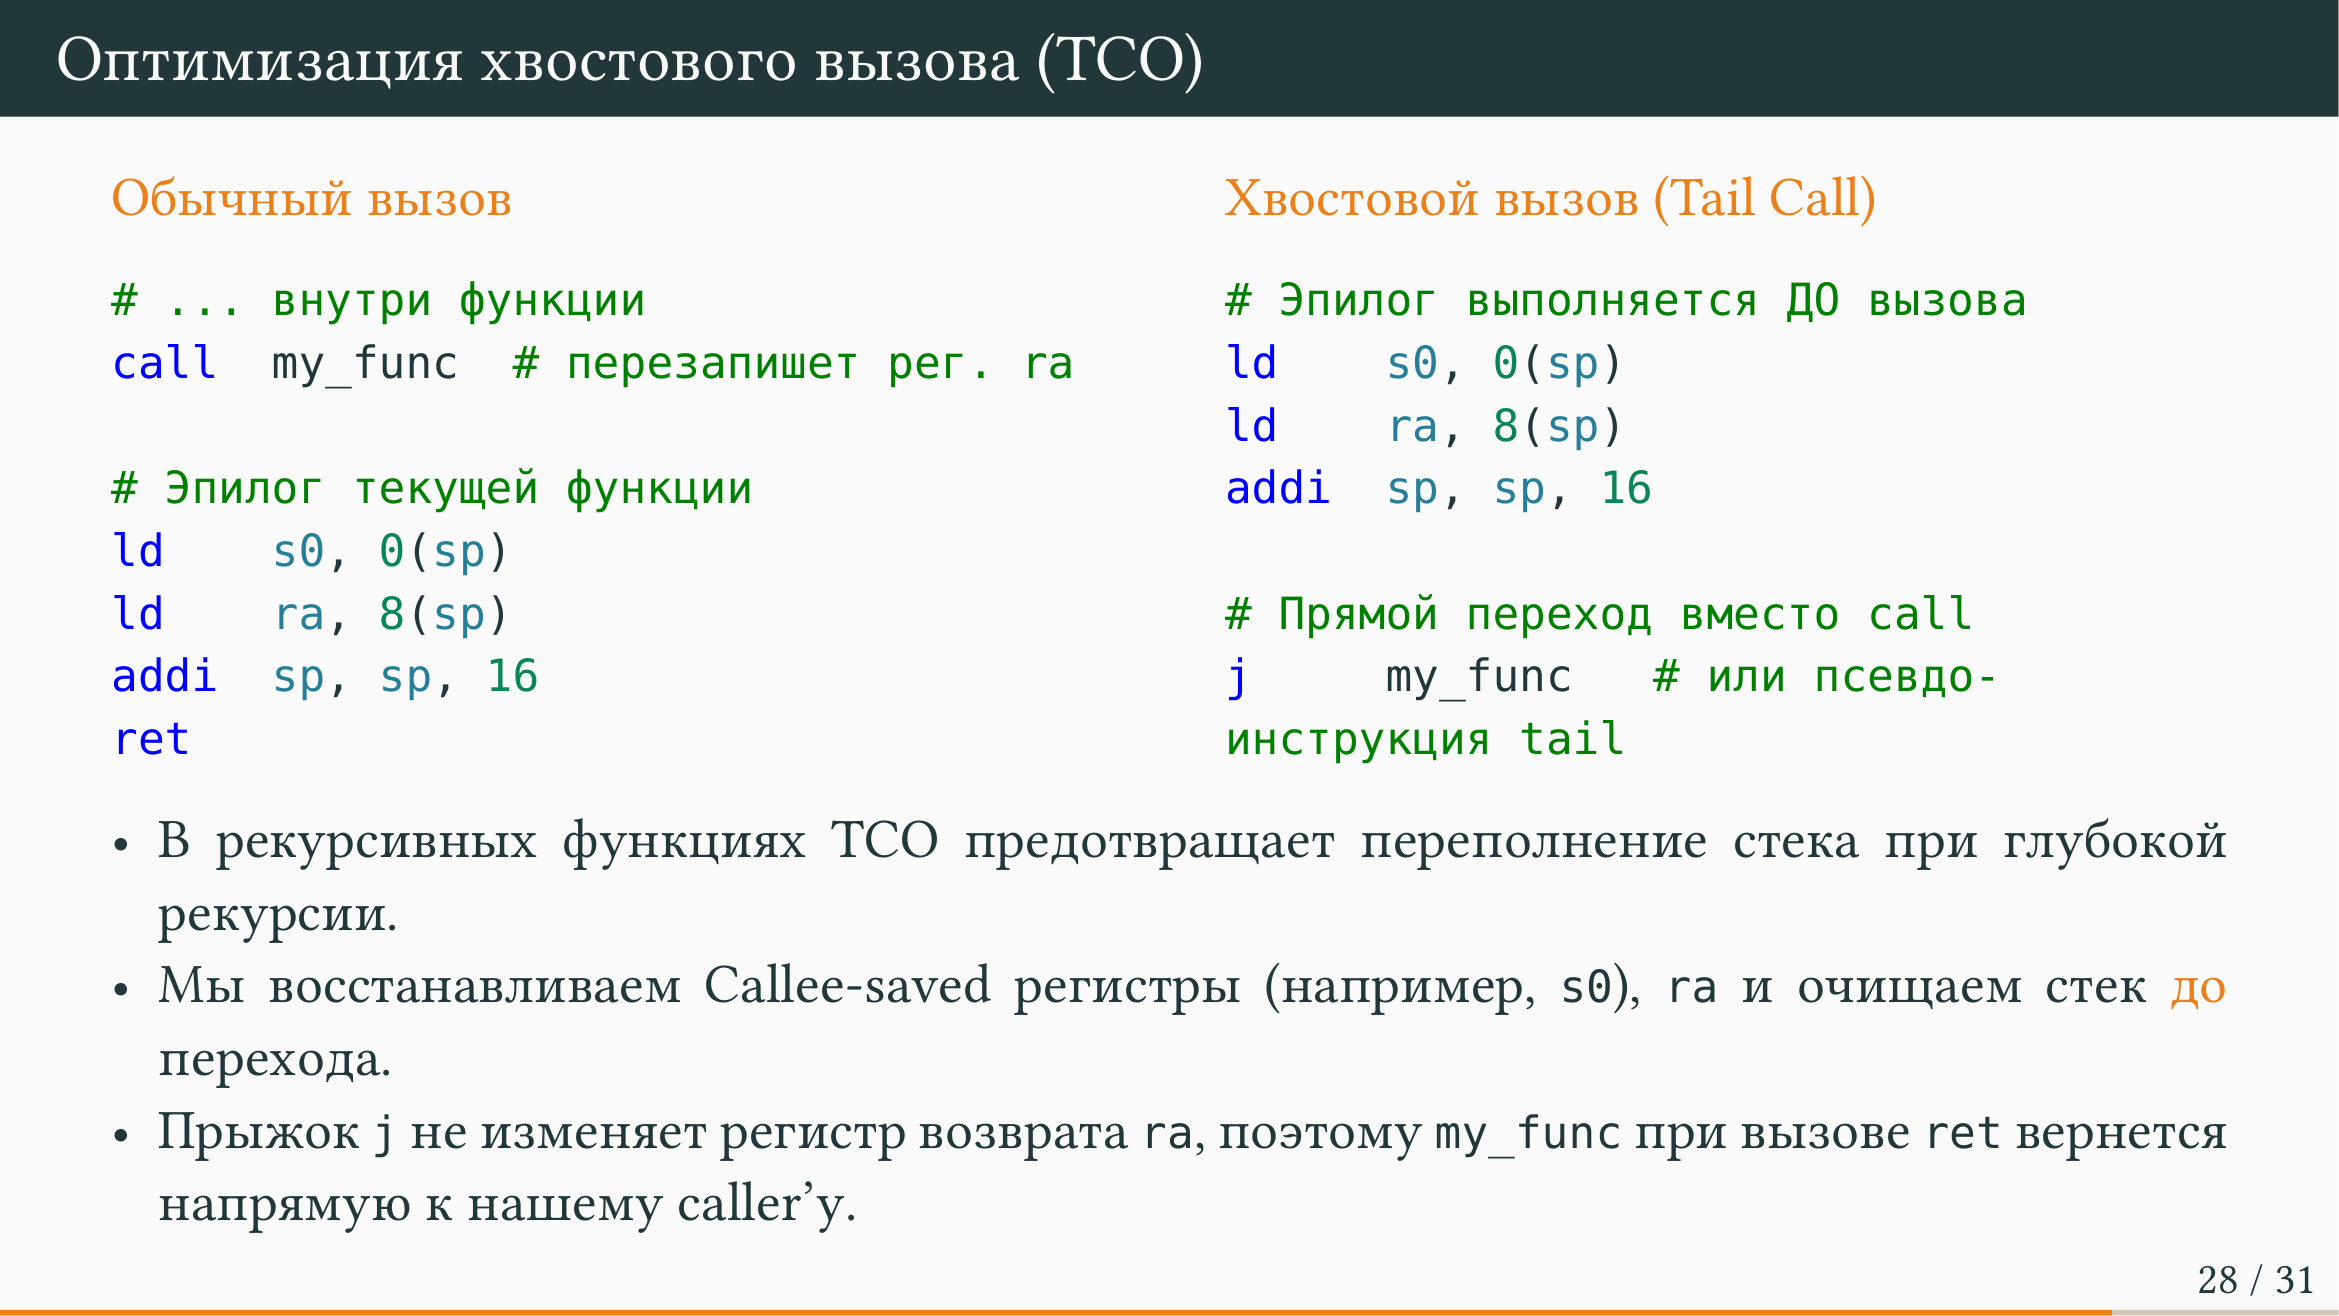
Скорее всего, в этом году появится некоторая домашка про оптимизацию хвостовой рекурсии. Я надеюсь, что вы помните, что такое хвостовая рекурсия, зачем она нужна. Чтобы не жрался стек, чтобы наши программы исполнялись быстро. И лучше всего, чтобы все программы, которые мы используем, исполнялись быстро, иначе это будет грустно. Поэтому не нужно писать на питоне.
В RISC-V существуют специальные инструкции, позволяющие вместо обычной инструкции call делать более эффективные переходы. Существует псевдоинструкция tail, которая делает прыжок, но специально предназначена для явного указания на то, что здесь имелся хвостовой вызов (Tail Call). Хвостовые вызовы в коде нужно внимательно детектировать (убеждаясь в начале, что они действительно хвостовые), чтобы порождать код, использующий jump вместо call. Инструкция jump исполняется быстрее, в то время как call работает с регистром возврата и «пожирает» стек. Пожирание стека приводит к замедлению работы программы, а в худшем случае — к переполнению стека (stack overflow).
Отступление от темы
Если в вашем железе, на котором вы исполняете код, всего лишь мегабайт оперативной памяти, у стека переполнится шансов гораздо больше. Вот. Такие железячки бывают. Маленькие-маленькие. Отличные процессоры, VG. нет, K1921WG1T, например. Tail call optimization — важная часть функционального программирования, без него это утюг. Ну вы сами догадываетесь, что стек переполняется, скорее всего, на сишечке, вы эти ошибки ловили или не на сишечке, ридонли код ли писали, но я верю, что вы их ловили. Вот.
Быстрая аллокация памяти в куче и регистры x86-64
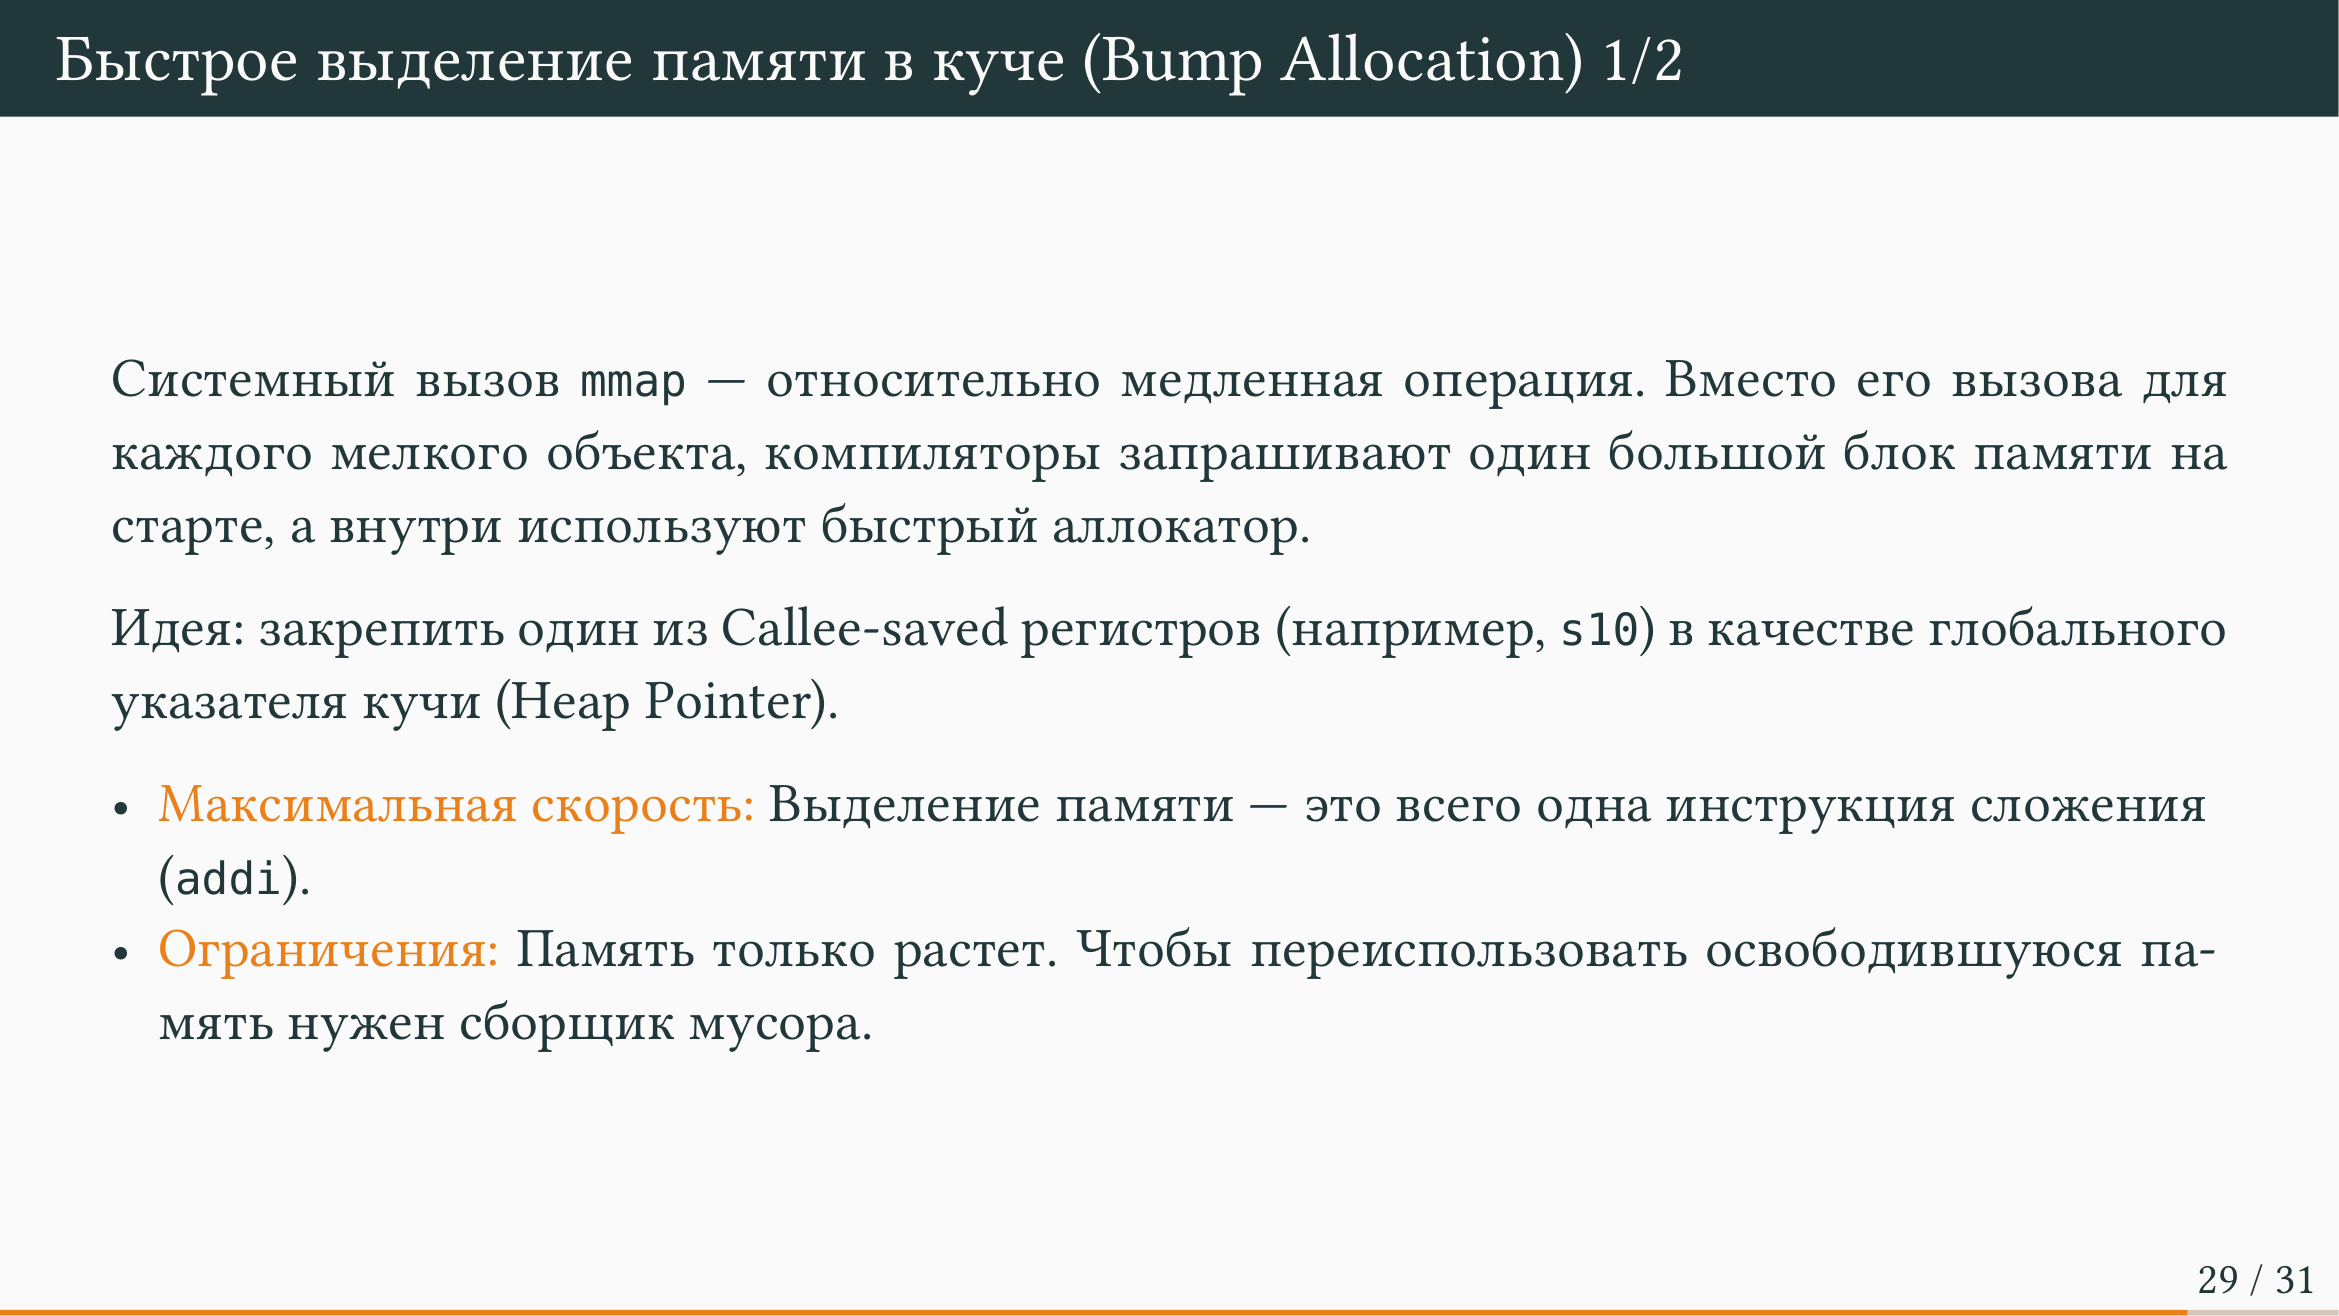
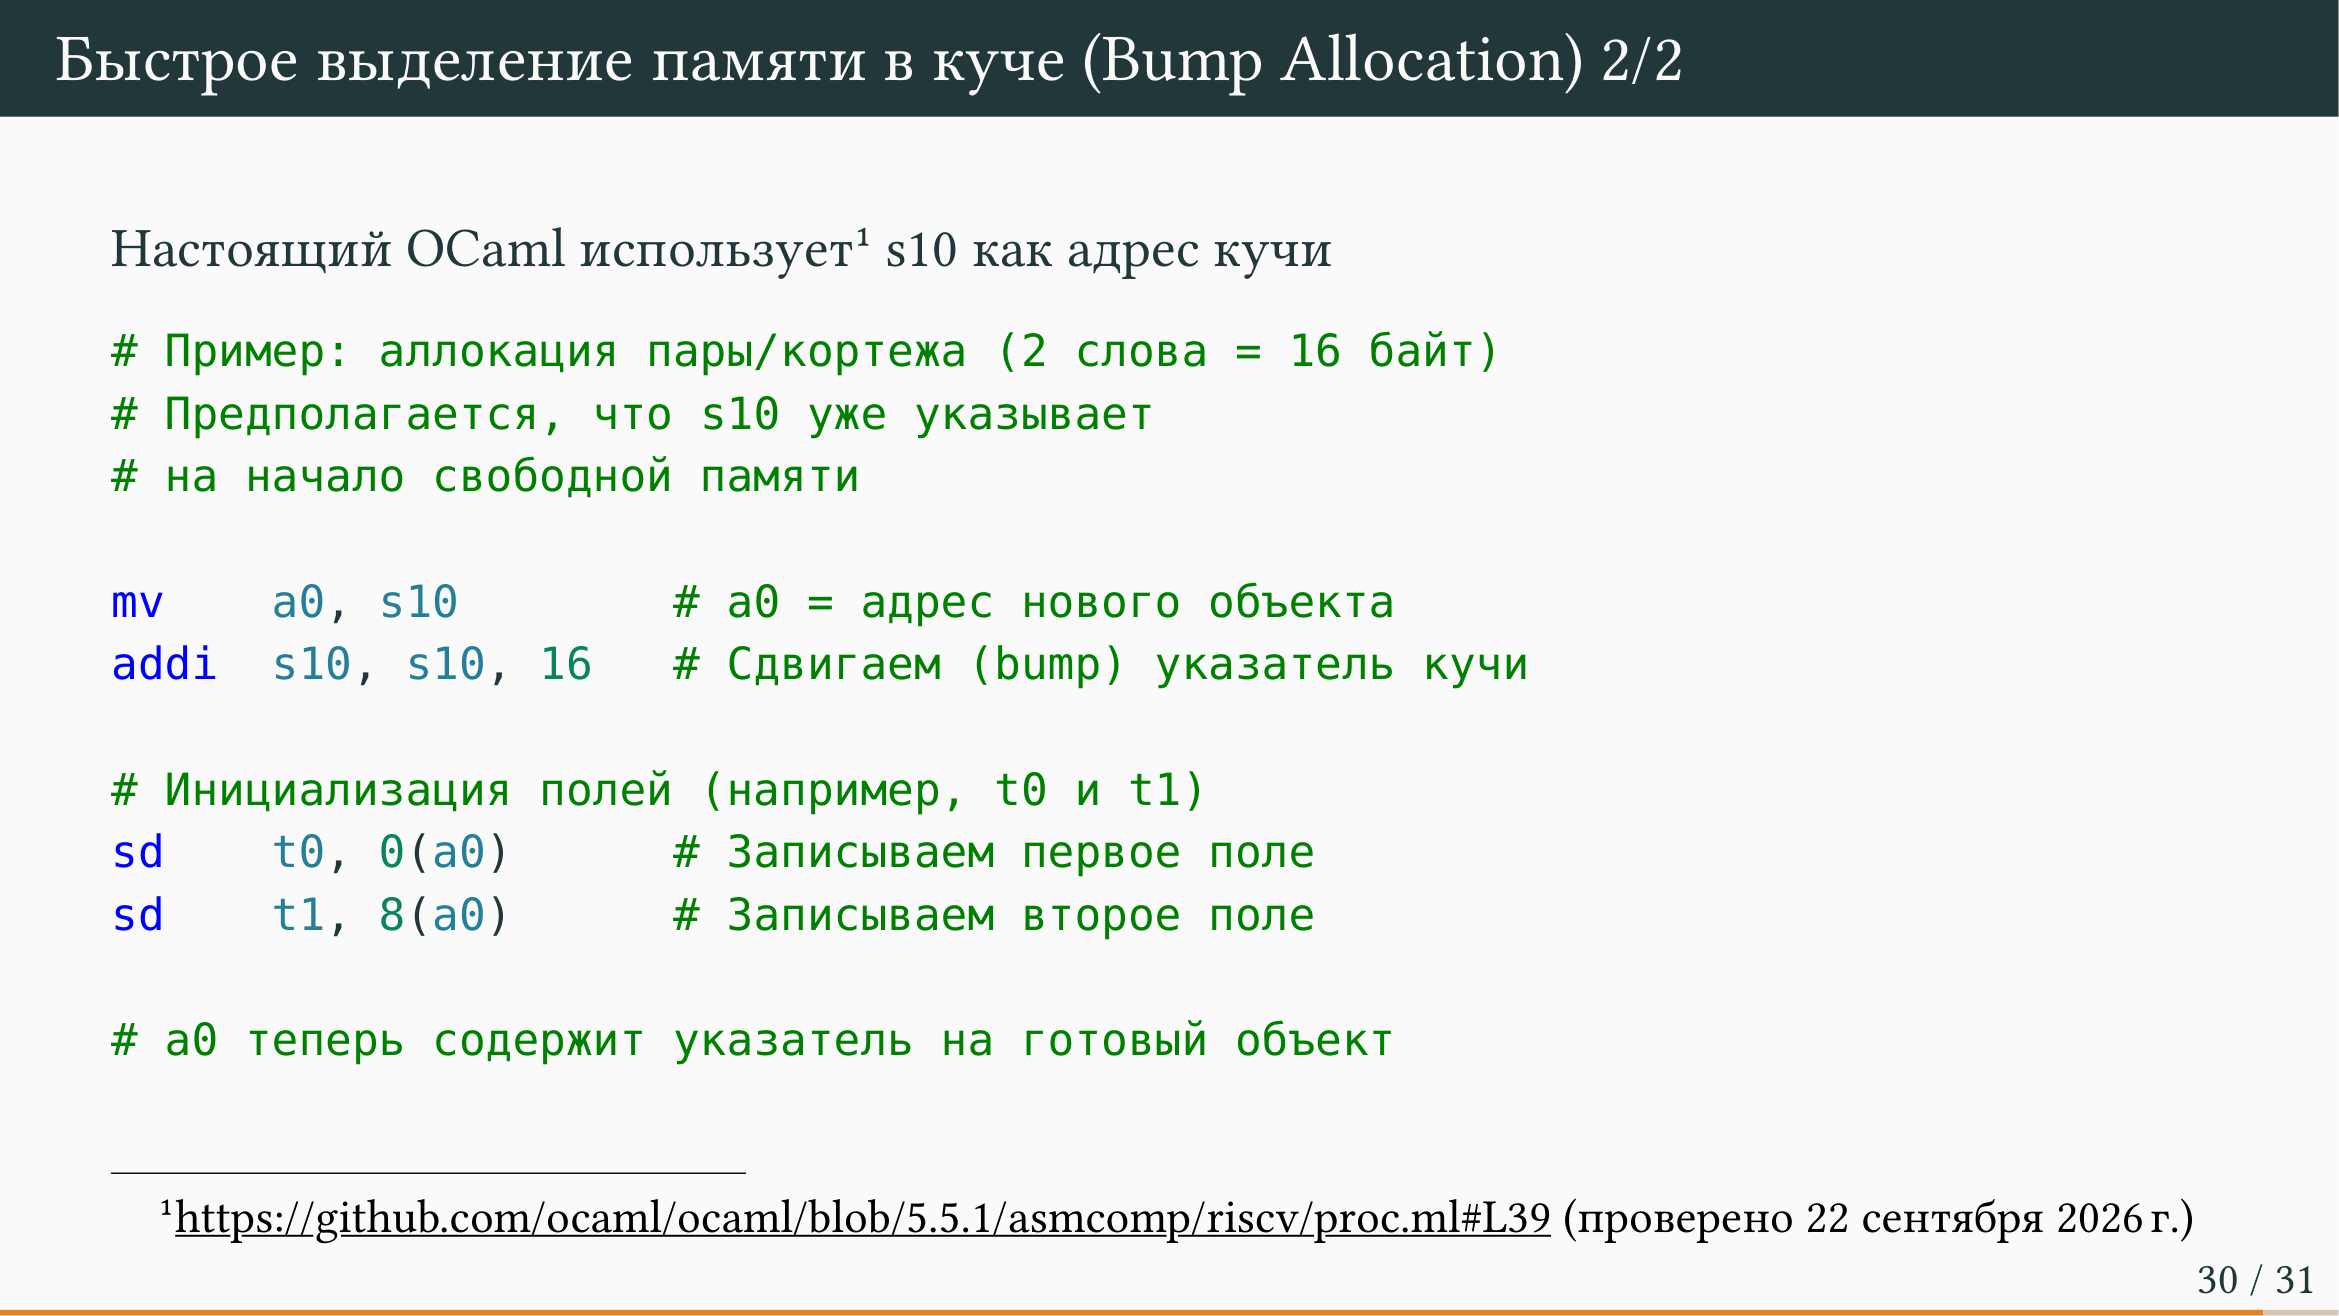
Если у вас есть младшая куча, там можно делать аллокацию просто дописыванием в конец кучи. Это довольно быстро, потому что вам не нужно прыгать по всяким свободным блокам. Если вы возьмете какой-нибудь настоящий язык программирования — это не Kotlin, а OCaml, конечно же, — то там будет специальное соглашение о вызовах, где в специальном регистре будет находиться адрес младшей кучи, малой так называемой. И если вам нужно будет выделить память в малой куче, вы просто делаете плюс на размер объекта, предварительно загрузив из регистра s10 то место, где будет лежать новое значение.
Например, мы сохранили этот s10 в a0, увеличили s10 на 16, увеличили размер малой кучи, но дальше с a0 можем работать: в первое поле положить первый элемент пары, во второе поле положить второй элемент пары, если мы захотели на куче выделить пару. И это примерно вот так работает. Разумеется, где-то должны быть всякие проверки, не переполнилась ли малая куча, ну и тогда запускается сборка мусора. Но если не переполнилась, можно вот так брать и быстро выделять на малой куче ваши объекты.
Отступление от темы
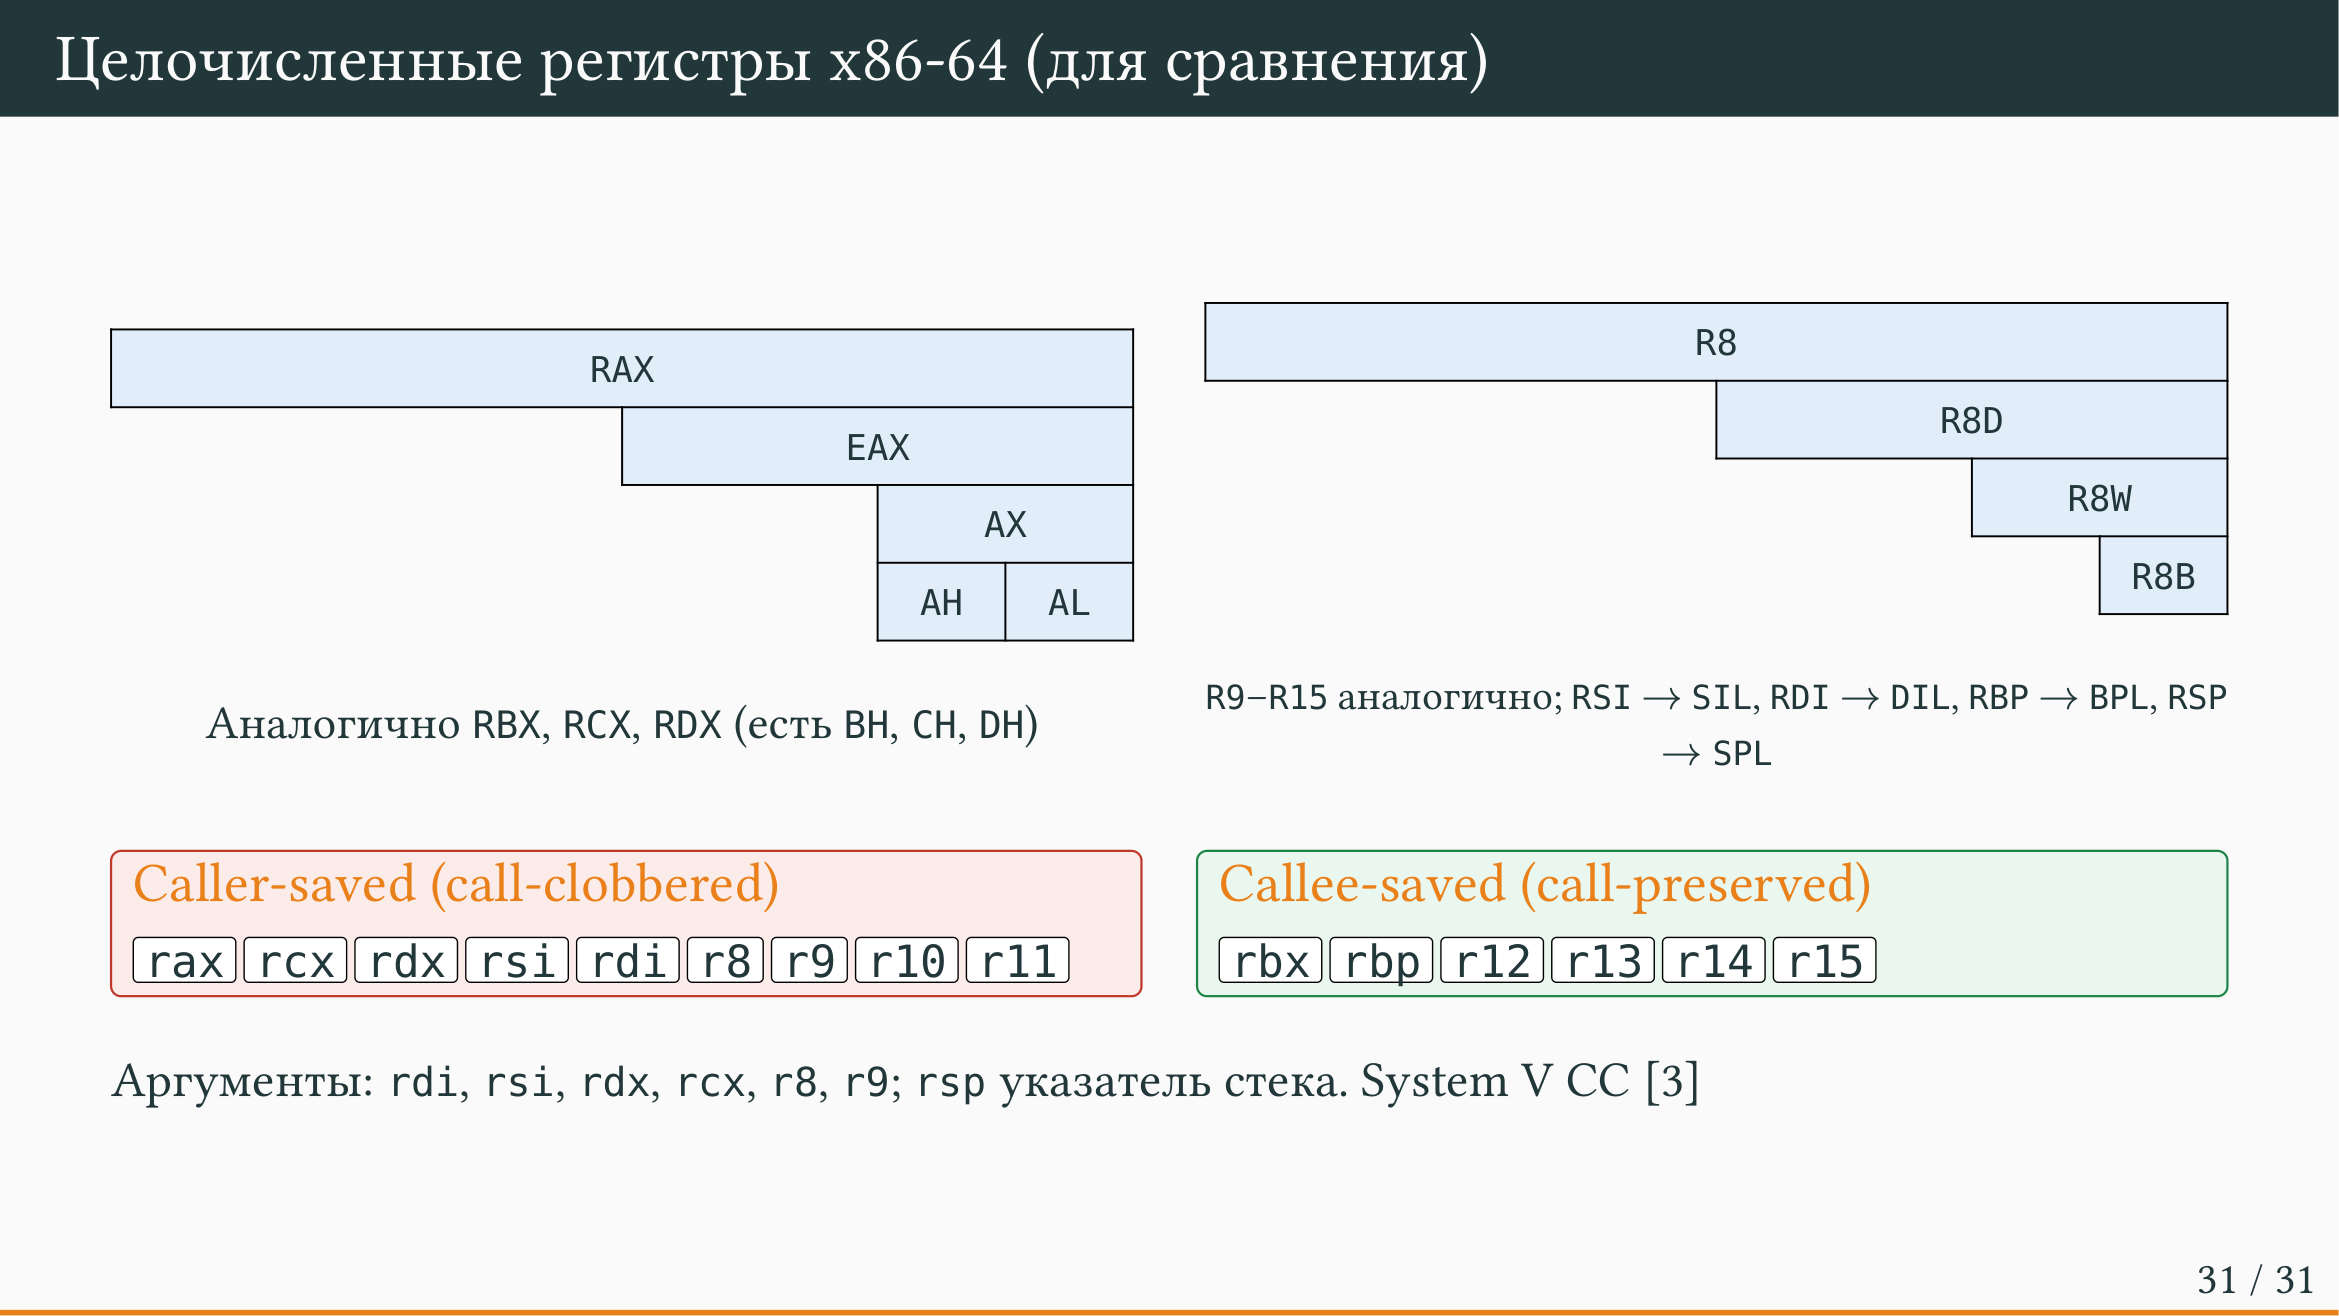
Проходной слайд, что бывает еще... Проходной и последний слайд, что бывает еще AMD64. Наверное, вам эту картинку уже показывали.
Что на AMD64 там очень сложные регистры. Можно адресовать половинки регистров, можно адресовать четвертинки регистров, регистры бывают разного размера. Чтобы общаться с разными, загружать данные из регистров разного размера, нужно писать немножко разные команды mov, которые указывают, собственно, размер регистра.
Исторически, когда у 8-битных процессоров регистров было довольно мало, они именовались буквально буквой A или буквой B. Дальше был регистр C, регистр данных D — то есть регистры были однобуквенные в 8-битных системах. Когда перепрыгнули с 8 бит на 16, регистры для обратной совместимости остались однобуквенными, но как-то нужно было именовать регистры, которые стали 16-битными, и туда начали дописывать букву X. Так A стал AX, B стал BX, C стал CX, D стал DX.
А потом она все прыгнула до 32 битов, и появился префикс E (Extended) — расширенный 32-битный EAX, расширенный EBX, и вот эти все EBX, EAX есть до сих пор в архитектуре x86. В какой-то момент количество регистров увеличилось, и кроме A, C, D, B, SI, DI, в некоторой момент регистры начали нумеровать циферками. Поэтому у вас появилась нумерация первых 8 регистров от 0 до 7, которые исторически именовались буковками. А потом количество регистров увеличилось, и появились 8, 9, 10, 11 регистры, их начали нумеровать циферками. Вот по именованию регистров вы можете наблюдать некоторое legacy, историю развития x86, которая произошла в XX веке.
В современных архитектурах просто циферки от x0 до x31, и как-то это всё выглядит пока менее сложно. Возможно, с эволюцией мы увидим, как RISC-V превращается в такой же полный трэш-угар, как есть в x86-64 сейчас. Живем — увидим.
Отступление от темы
Короче, вот сейчас со слайдами точно конец. Я думаю, нам стоит пересчитаться, написать ревью-стучку и пойти домой. Кроме, может быть, шинки ремеля. Там нужно с CI разобраться. Разобрались? В pull request? Что давайте после летучки посмотрим, что там происходит.