Конспект лекции
Комп 2
Организационные вопросы и обсуждение домашнего задания
Вступление и организационные моменты
Отступление от темы
Что? Мне. ДИНАМИЧНАЯ МУЗЫКА короче если короче
Обсуждение домашнего задания по парсеру
Отступление от темы
Лектор начинает с вопроса о том, начали ли студенты делать домашнее задание про парсер, и просит поднять руки тех, кто еще не приступал к работе. Выясняется, что больше половины аудитории задание еще не начинали, на что лектор замечает, что шансов сделать его остается мало. На вопрос о том, есть ли вопросы у тех, кто все-таки начал, никто не отвечает. Далее следует обсуждение того, где студенты будут делать pull requests, упоминается SourceForge, после чего лектор иронизирует на тему того, всем ли всё понятно и написала ли им код нейросеть. Также обсуждается требование к командной работе: желательно, чтобы коммиты в репозитории были не только от одного человека, сопровождающееся шутливой отсылкой про то, что «не только лишь все могут это понять».
По содержанию самого домашнего задания содержательных вопросов у студентов не оказалось.
Задачи Middle-end компилятора и подготовка AST к ассемблеру
Разрыв между AST и ассемблером: роль Middle-end
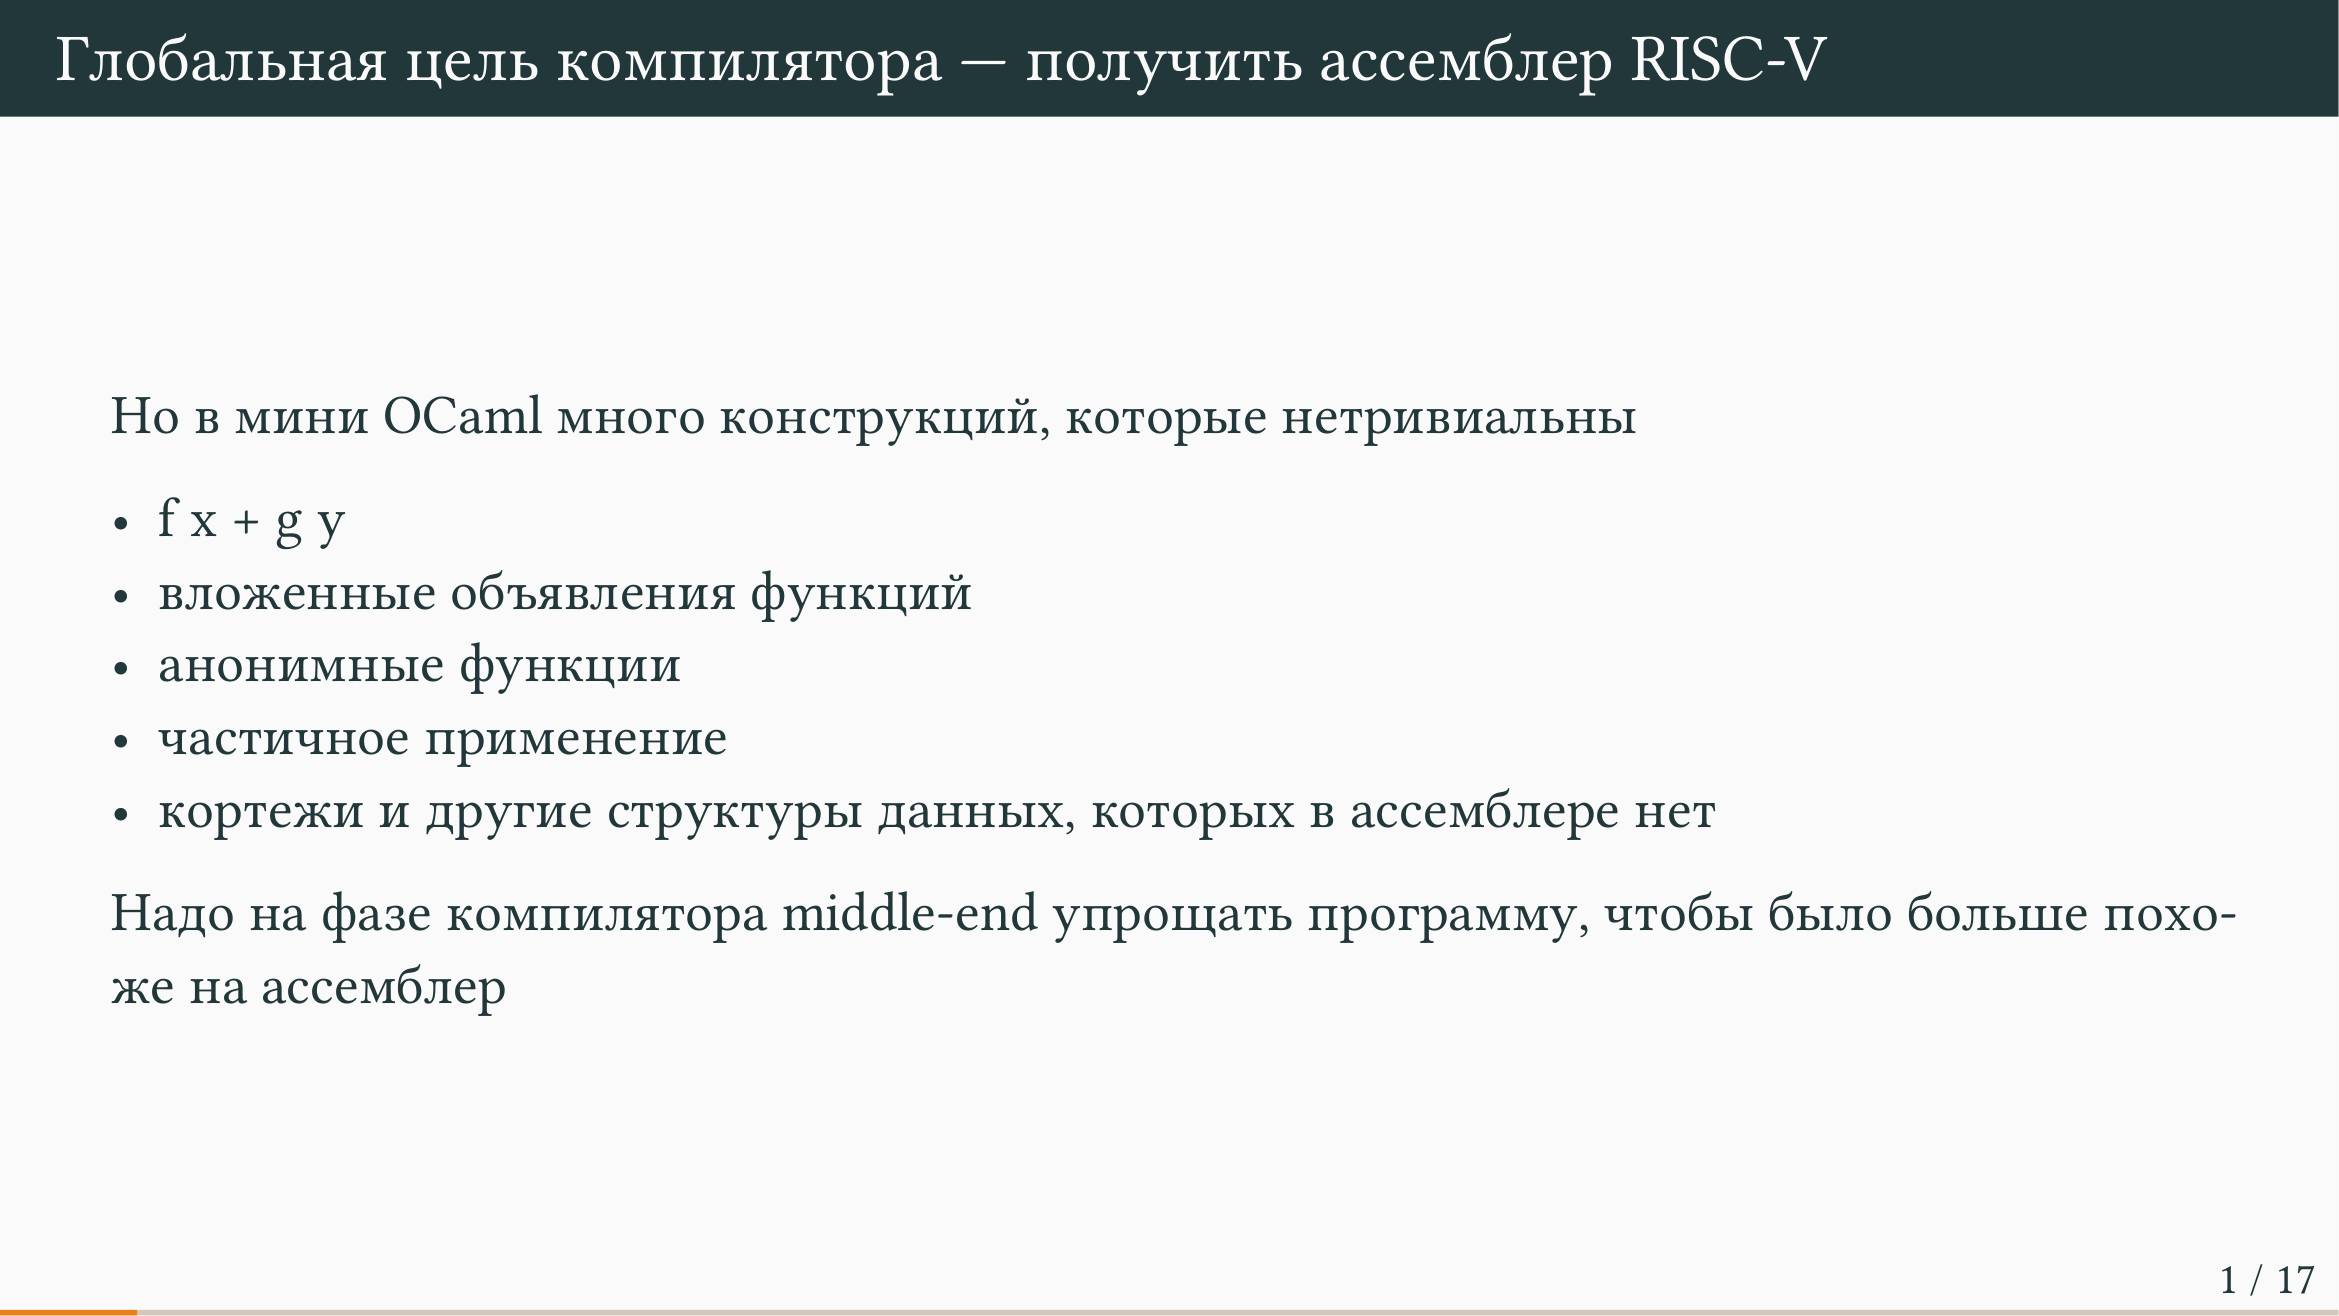
Глобальная цель компилятора заключается в том, чтобы получить ассемблер. В ассемблере есть мнемоники и регистры, где мнемоники более-менее соответствуют операциям, а простые операнды представляют собой регистры. В ассемблере невозможно напрямую написать сложение вроде $f(x) + y$, так как для этого требуется отдельно строить аргумент, помещать его в регистр и задействовать отдельные команды для вызова функций.
Однако в синтаксическом дереве языка программирования OCaml (в мини-версии языка, с которой предстоит работать) содержится множество конструкций, которые напрямую не ложатся на ассемблер и слабо на него похожи. Среди них можно выделить инфиксные операции, вызовы функций с аргументами, вложенные объявления функций (чего не умеет делать даже язык Си), возвращение функций из функций, анонимные функции, частичное применение, а также различные структуры данных, такие как кортежи, которых в ассемблере нет. Для работы со структурами данных в ассемблере доступна лишь память, поэтому их тоже необходимо соответствующим образом подготовить.
Чтобы преодолеть этот разрыв, используется пачка преобразований, которая в компиляторах традиционно называется middle-end. Задача middle-end состоит в том, чтобы постепенно и потихоньку переписывать и упрощать программу, подготавливая сложные конструкции языка программирования к порождению кода, чтобы в дальнейшем код успешно сгенерировался, а затем исполнялся.
Нормальная форма A-Normal Form (ANF) и способы преобразования
Введение в A-normal form (ANF) и типы выражений
Для улучшения читаемости программы и облегчения прохождения кода используется специальное представление программ — ANF (A-normal form). ANF придумано относительно недавно, в начале 90-х годов, по причине того, что вначале люди придумывали что-то сложное, а затем придумывали ANF, которое является относительно простым.
Основная идея ANF заключается в том, что если у вас есть какие-то сложные аргументы у функций, будь то вызов факториала или сложение чисел, вам нужно сделать эти аргументы попроще. Простыми аргументами считаются переменные и константы. Чтобы этого добиться, вы заводите пачку let-выражений и даете имена всем сложным аргументам, в результате чего получаете программу с кучей let-выражений. Нечто подобное вы делали, когда на втором курсе изучали CPS. Там, конечно, можно взять и переписать напрямую, но если не получается, вы всякие сложные аргументы делаете пачкой let-выражений, и после этого код становится проще.
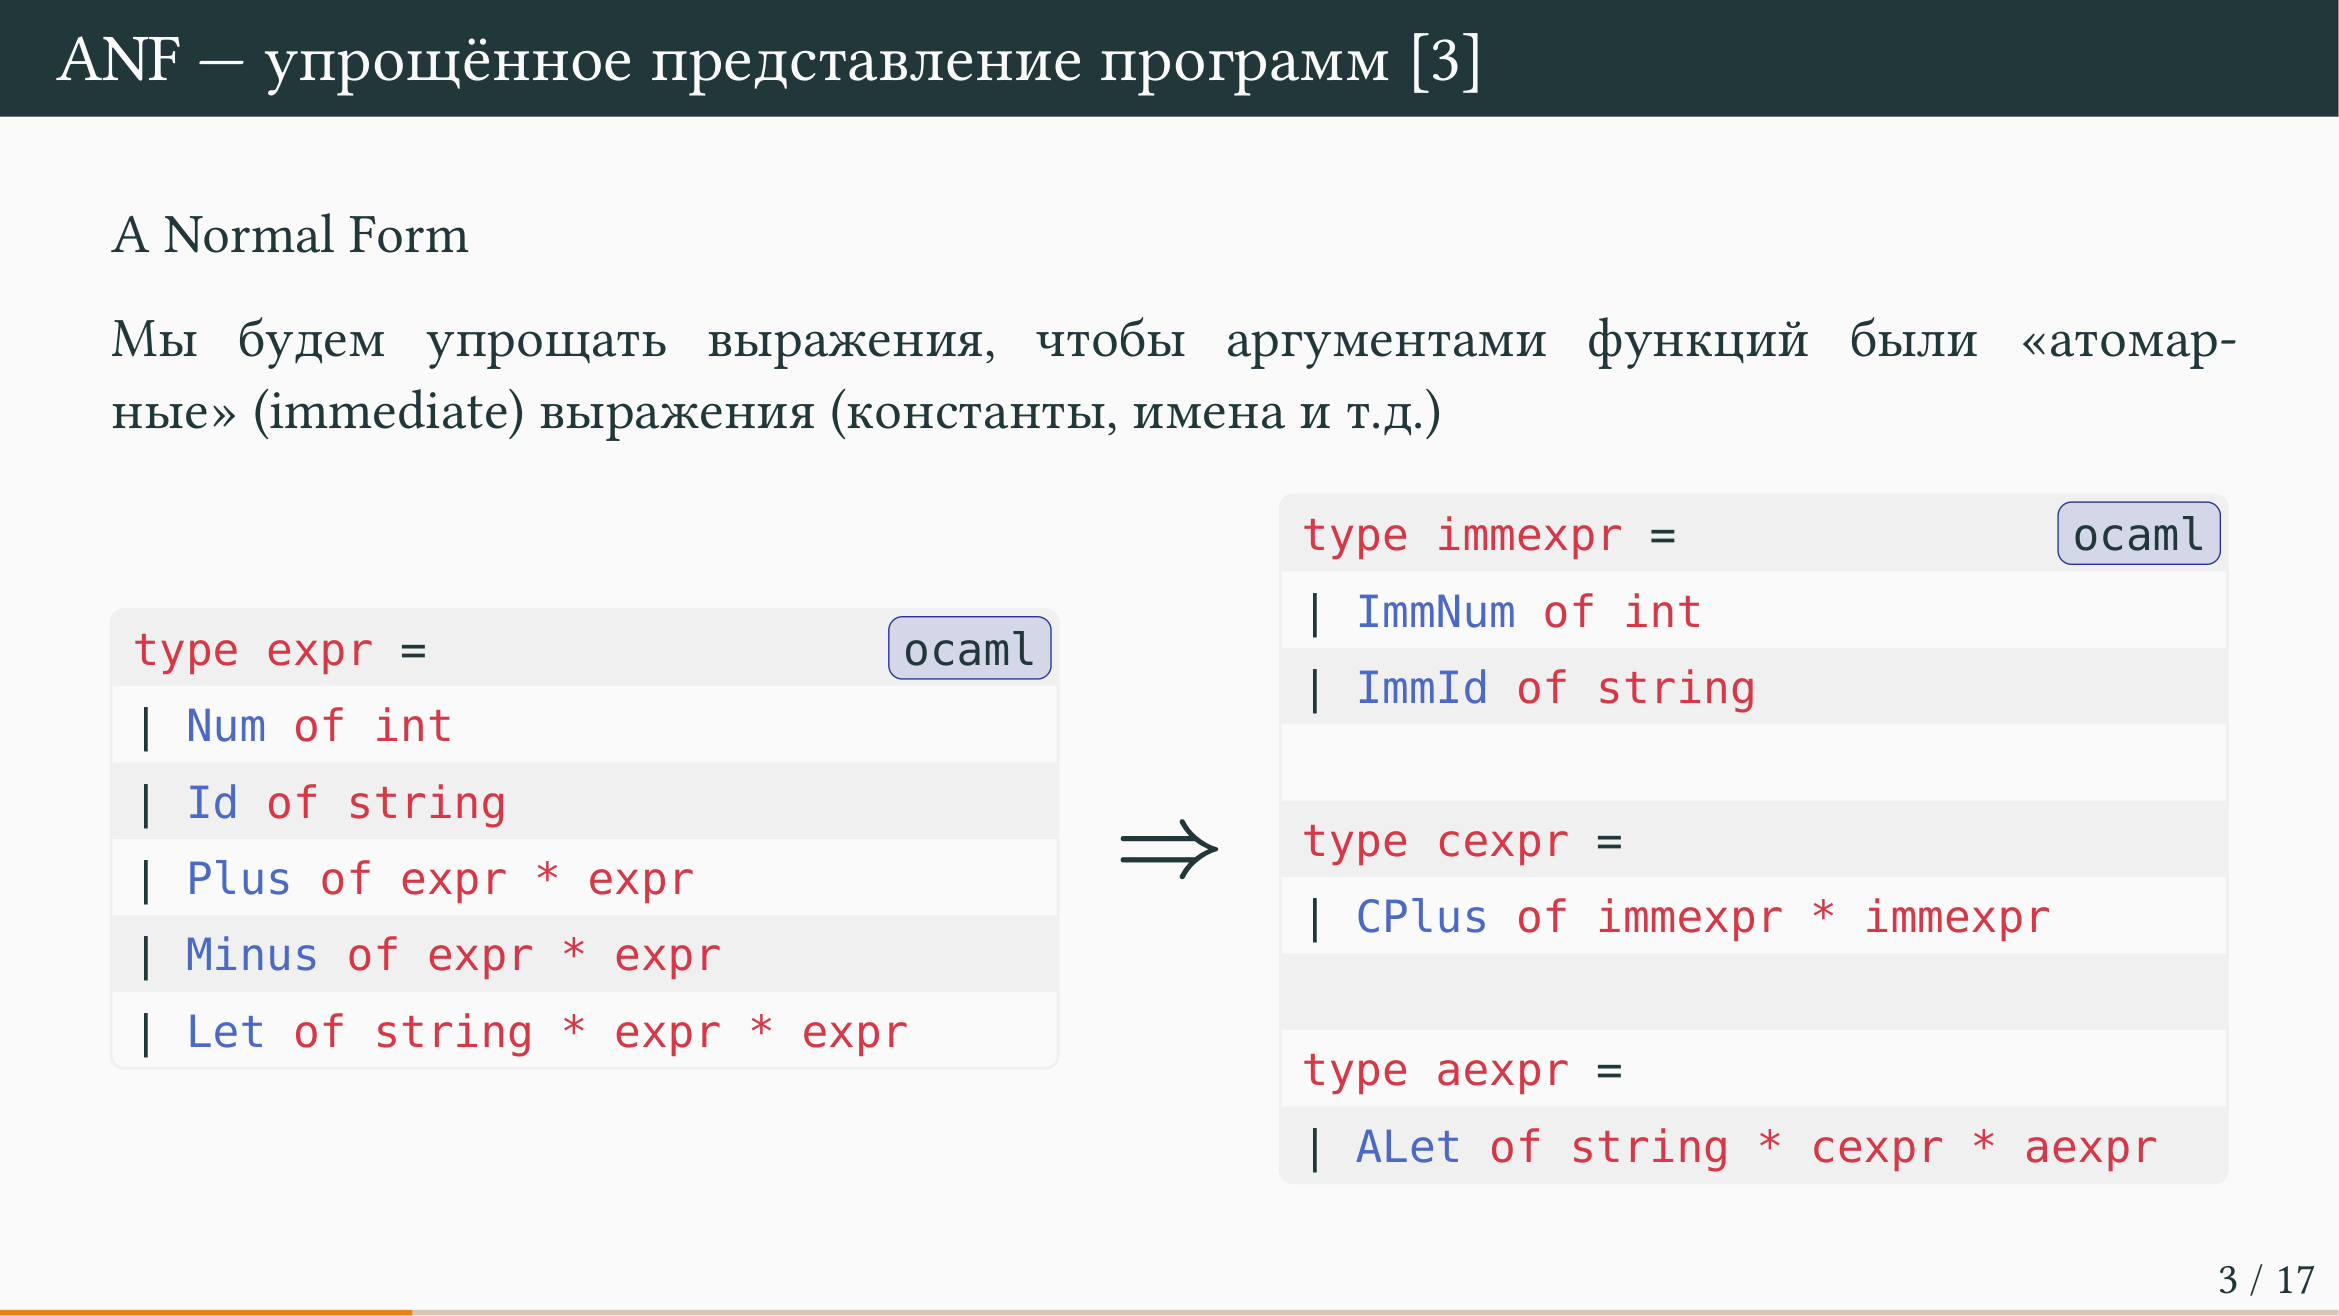
Глобально ANF означает, что дерево представления вашей программы разваливается на три вида конструкций.
Первое — это что-то очень простое, а именно константы и имена переменных. Такие выражения называются immediate (или атомарные выражения). Вообще термин immediate означает, намекая на это, что значение хранится как есть, то есть его, грубо говоря, можно положить в регистр и что-нибудь с ним сделать, никаких сложных вещей при этом не требуется. Если вы будете добавлять к языку строки, тут уже возникают вопросики: является ли строка immediate-выражением? Имеется в виду строковая литерала, которая у вас есть в программе. Либо вы в каждом месте, где создаете строку, выделяете память по байтикам и инициализируете её, либо вы все строки, которые есть в программе, собираете во время компиляции, складываете куда-нибудь рядышком в данные и потом просто в нужном месте используете указатель на эти данные вместо самой строки. Так что если вы будете работать со строками, тут есть варианты: должна ли строка быть immediate или нет. Но если у вас есть только факториал, то в immediate-выражения попадают переменные и числа — и всё нормально.
Кроме immediate-выражений, у нас есть всякие сложные выражения, обозначаемые буковкой C (комплекс). Это всякие сложения, вызовы функций. Также у нас есть произвольные выражения — от слова arbitrary, где присутствует пачка let-выражений. Кажется, в комплексные выражения еще должно попасть выражение if-then-else, но лектор почему-то его здесь не написал, наверное, для простоты или чтобы никто ничего не понял. Короче говоря, у вас есть тип данных AST, и ANF задает для него особую структуру.
Структура типов данных AST и ANF в коде
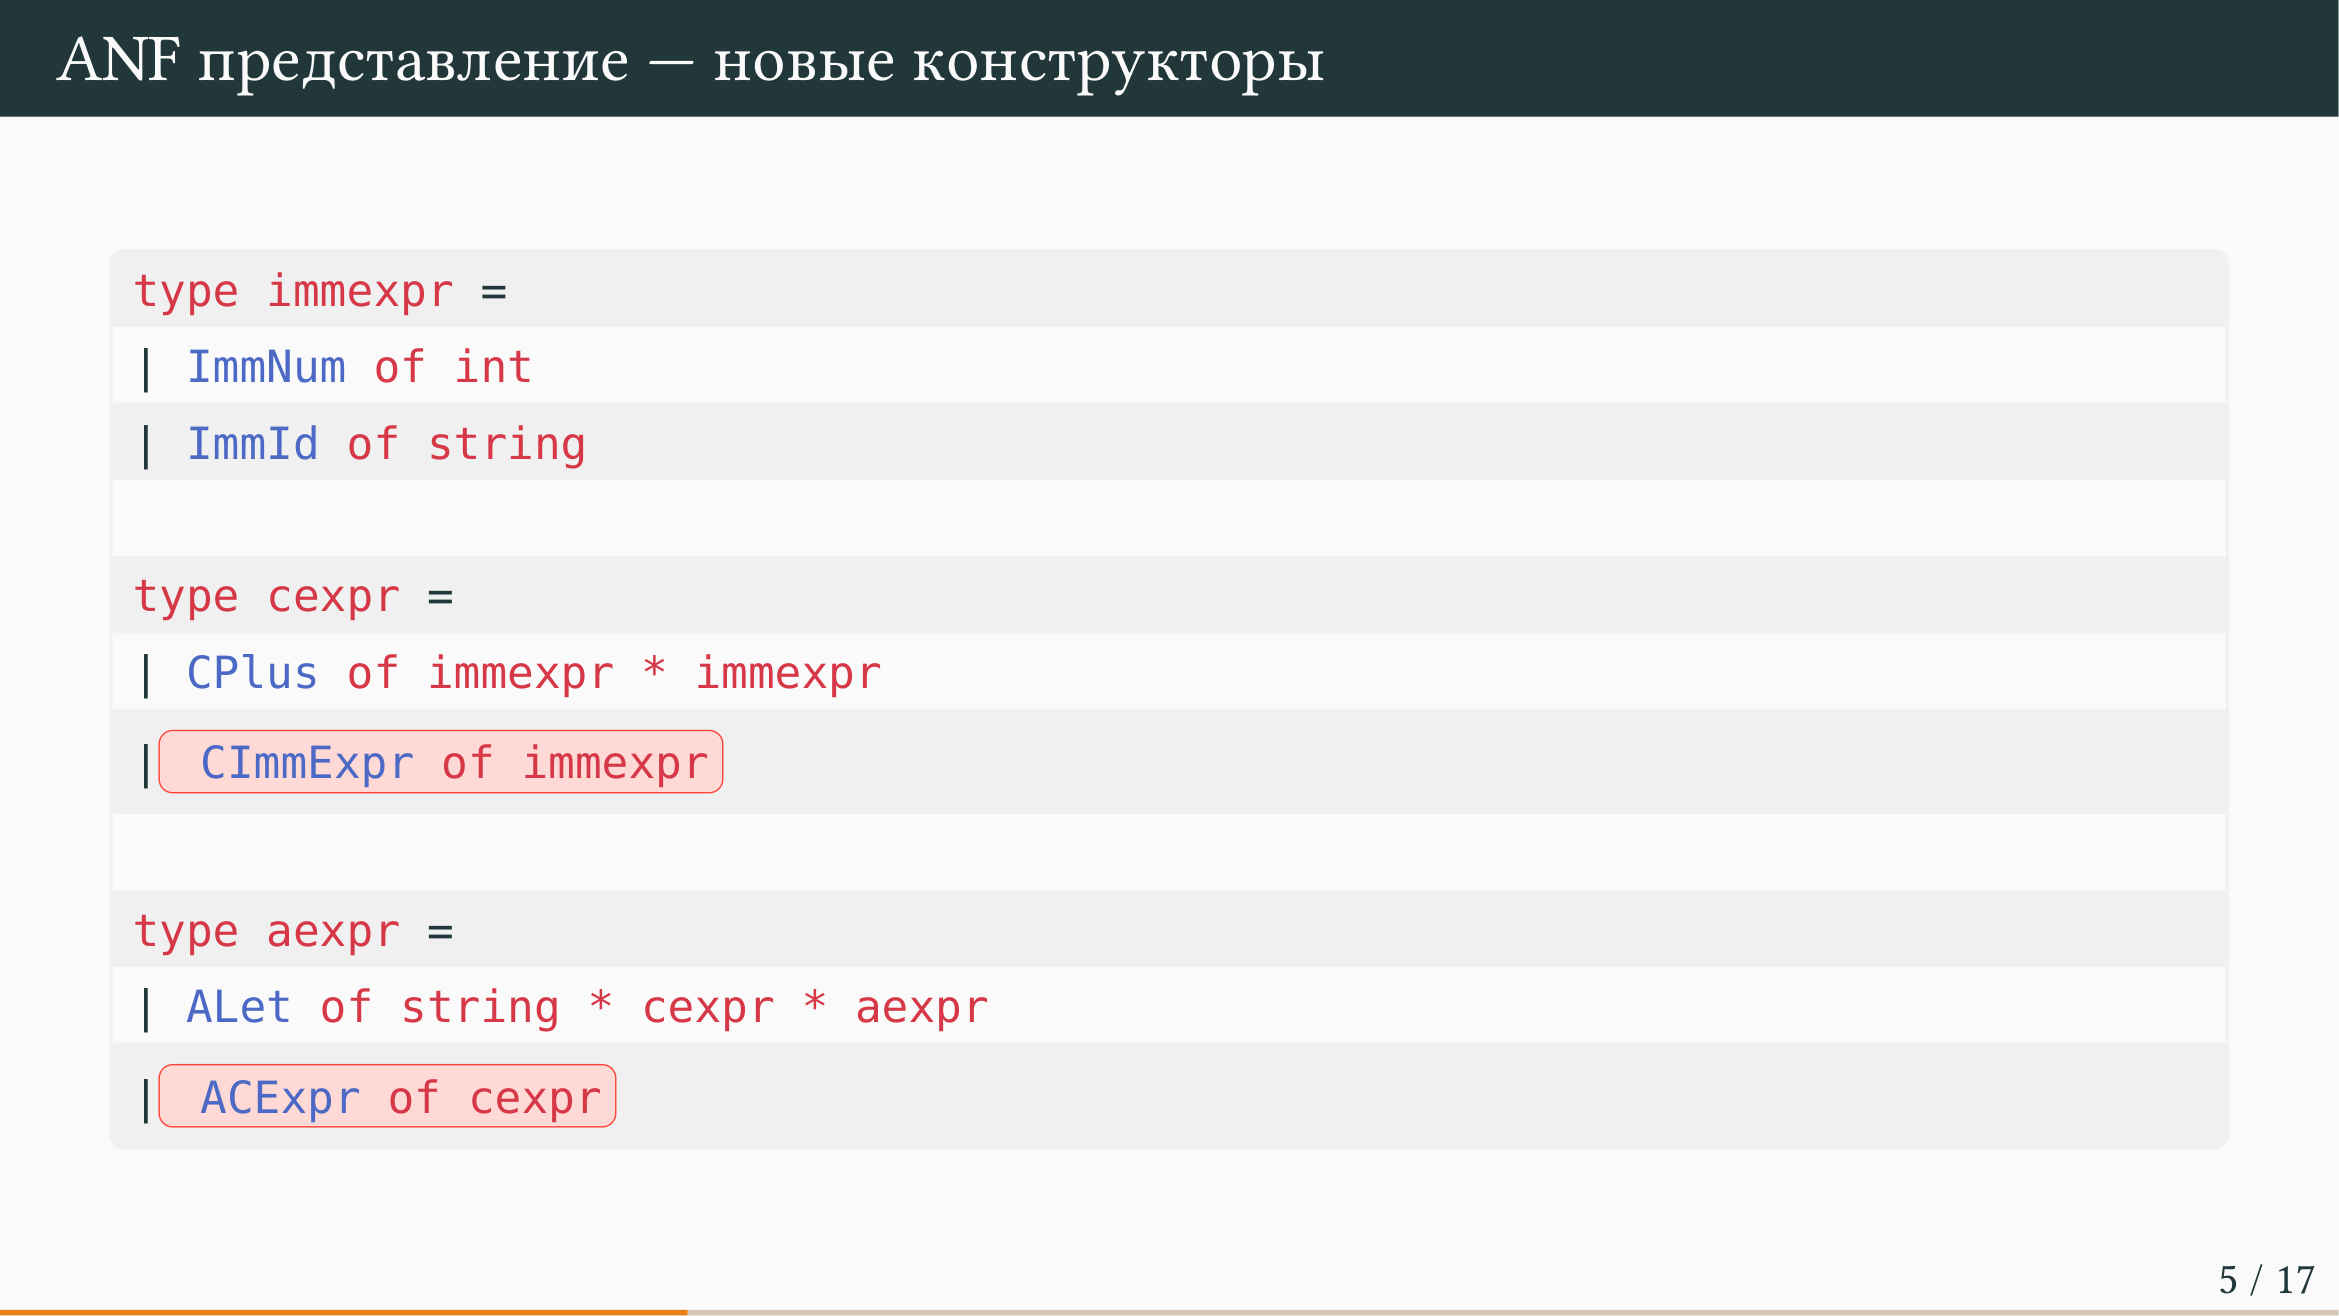
При преобразовании типа данных AST в ANF на выходе получается тип данных aexpr, причем промежуточные типы проименованы соответствующим образом (например, cexpr, immexpr), то есть вся программа разбивается на три типа данных, и необходимо написать это преобразование.
Отступление от темы
Мотан сдали, вы в этом разберетесь.
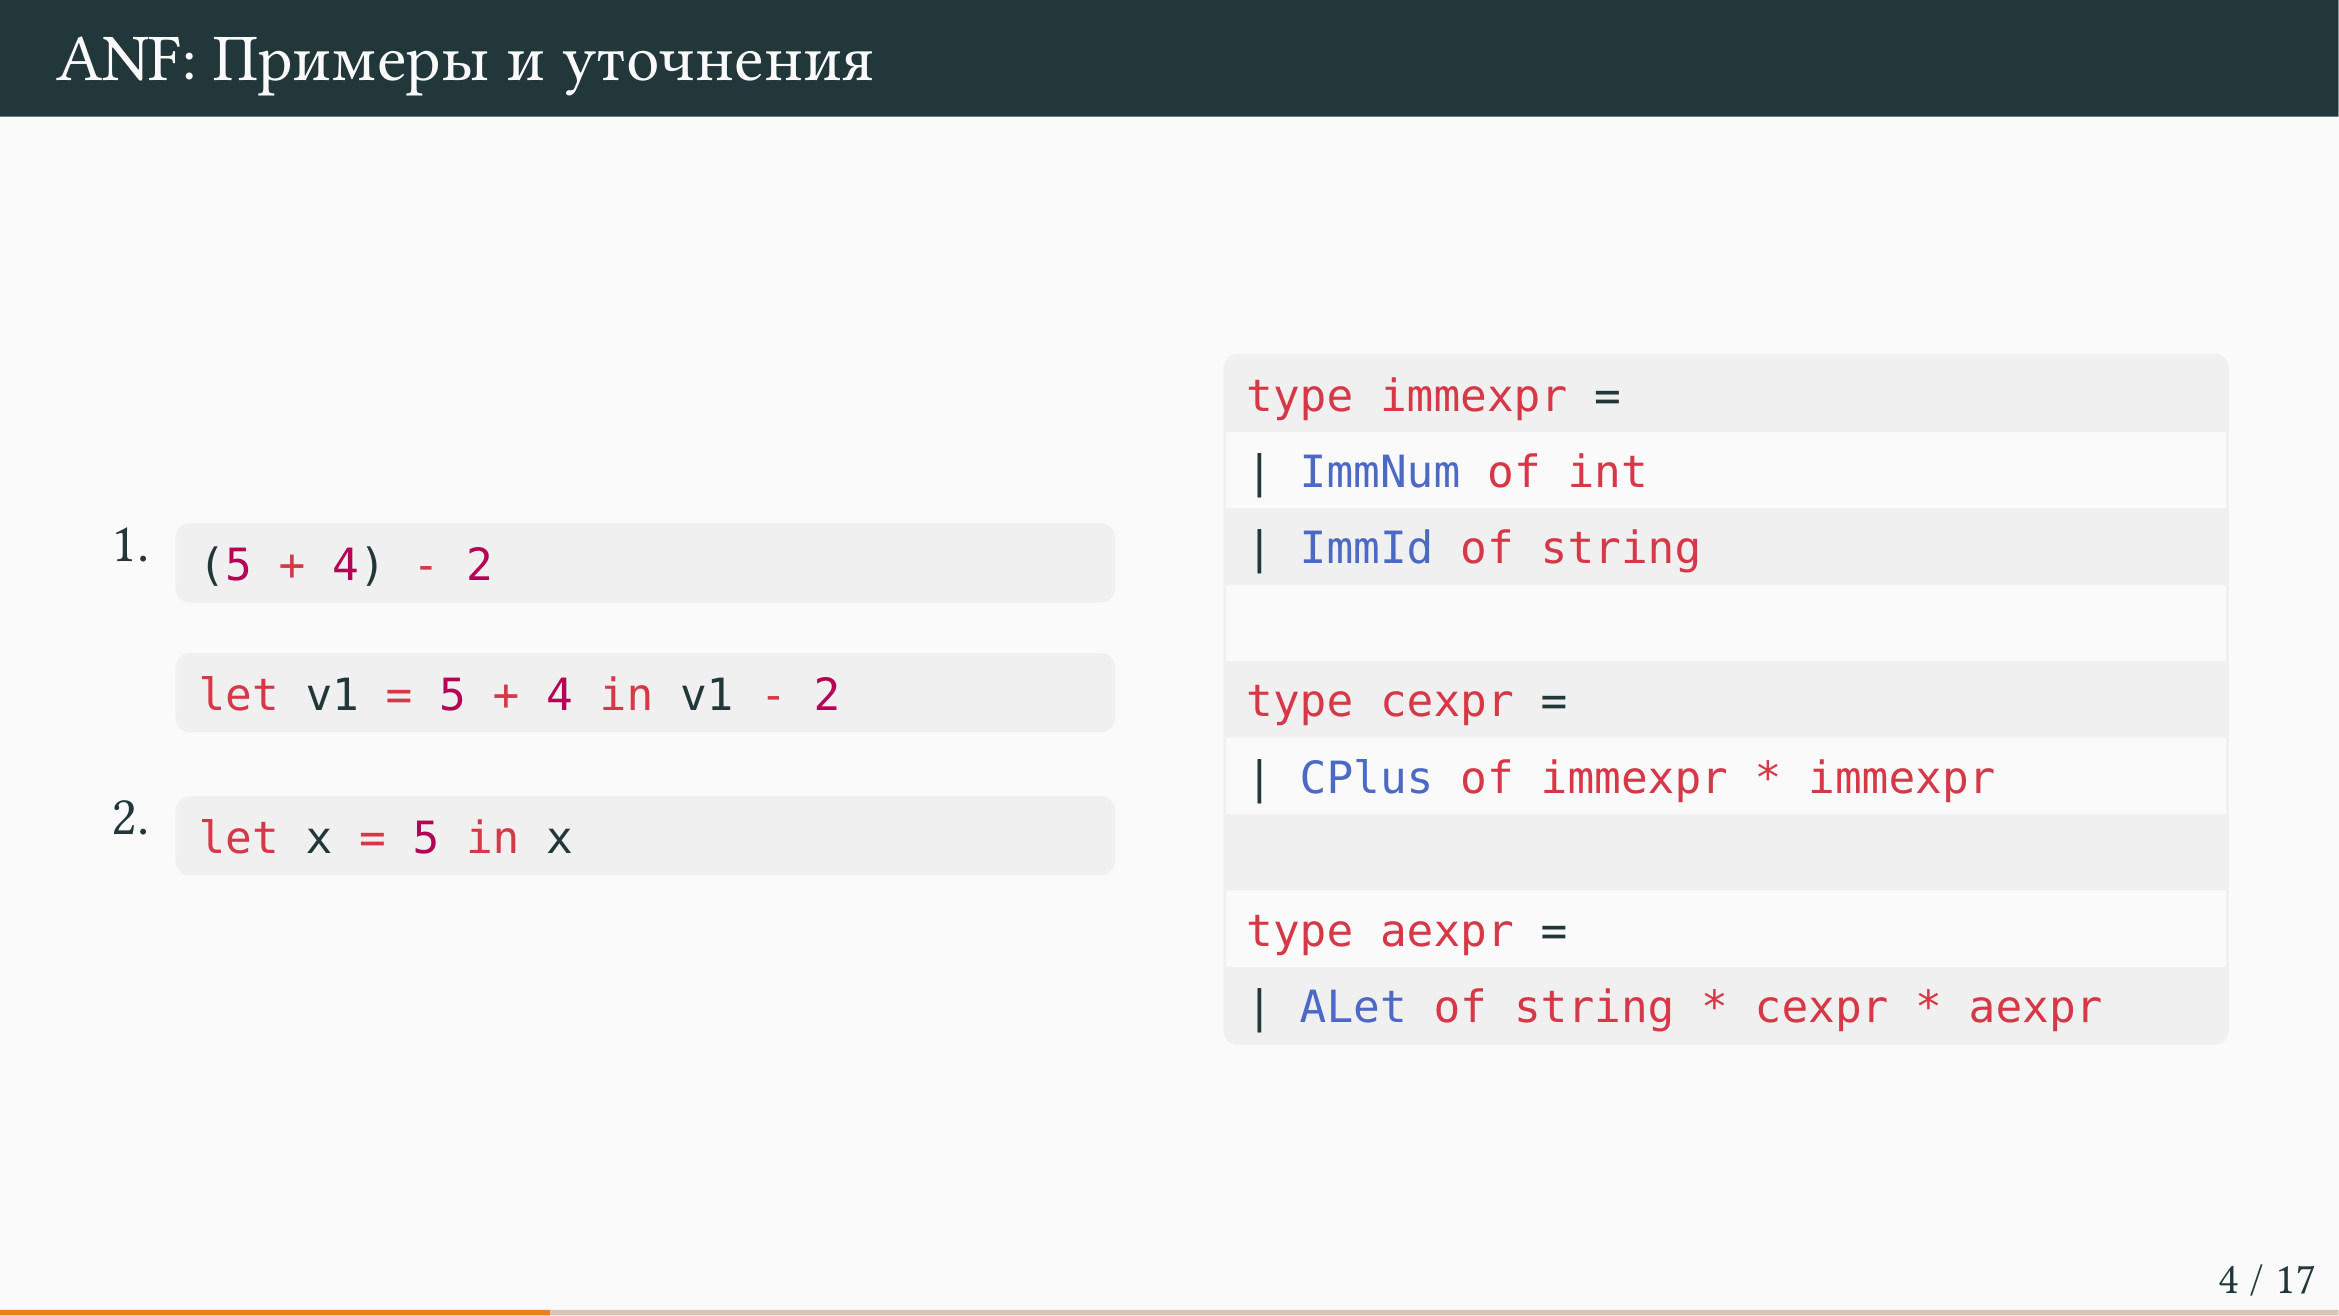
В качестве примера рассмотрим выражение 5 + 4 - 2. Оно является довольно простым, и при попытке избавиться от сложных подвыражений мы заводим конструкцию let для суммы, в результате чего получается что-то более простое, например, let v1 = 5 + 4 in v1 - 2. При этом имена должны быть новыми, потому что если завести имя, которое уже встречается, и перекроить старое значение в области видимости, могут наступить конфузы, поэтому нужно быть аккуратным с именами. Выражение вроде let x = 5 in x уже находится в ANF (в транскрипте ошибочно inf), и делать с ним ничего не нужно.
Однако при внимательном рассмотрении возникает относительно тривиальная проблема. Суть её заключается в том, что нельзя просто так взять и подставить произвольное выражение в те части типа aexpr, где по структуре требуется конкретная подкатегория (например, в конструкции let, состоящей из имени, части между let и in, и части после in). Из-за этого приходится добавлять фейковые конструкторы (такие как CImmExpr или ACExpr, видимые на слайде), которые позволяют заворачивать и имитировать простые выражения в сложных, а сложные — в произвольные, чтобы с помощью такого типа данных можно было записать программу.
Хотя это некоторый синтаксический мусор, который приходится писать, попытка сделать без него привела бы к тому, что система типов превратилась бы в непереваемое, сложное и невыносимо страшное нечто. В итоге получается немного больше бойлерплейта (в транскрипте — рпэйта). Для удобства можно реализовать вспомогательные функции, конструирующие наше AST, в которых будут заложены абстракции вроде arbitrary expression of integer или arbitrary expression of variable, прячущие навешивание этих конструкторов, чтобы не видеть их в дальнейшем во время порождения ANF.
Реализация функции преобразования в ANF с помощью Continuation Passing Style (CPS)
Реализация функции преобразования в ANF (Administrative Normal Form) на основе типизированного дерева синтаксиса или дерева абстрактного синтаксиса представляет собой достаточно сложную задачу. Для простых случаев, таких как обычные константы и имена переменных, ничего особенного делать не нужно, поскольку они имеют прямой образ в ANF и являются так называемыми immediate выражениями. В этих случаях функция просто возвращает примитивные кусочки ANF.
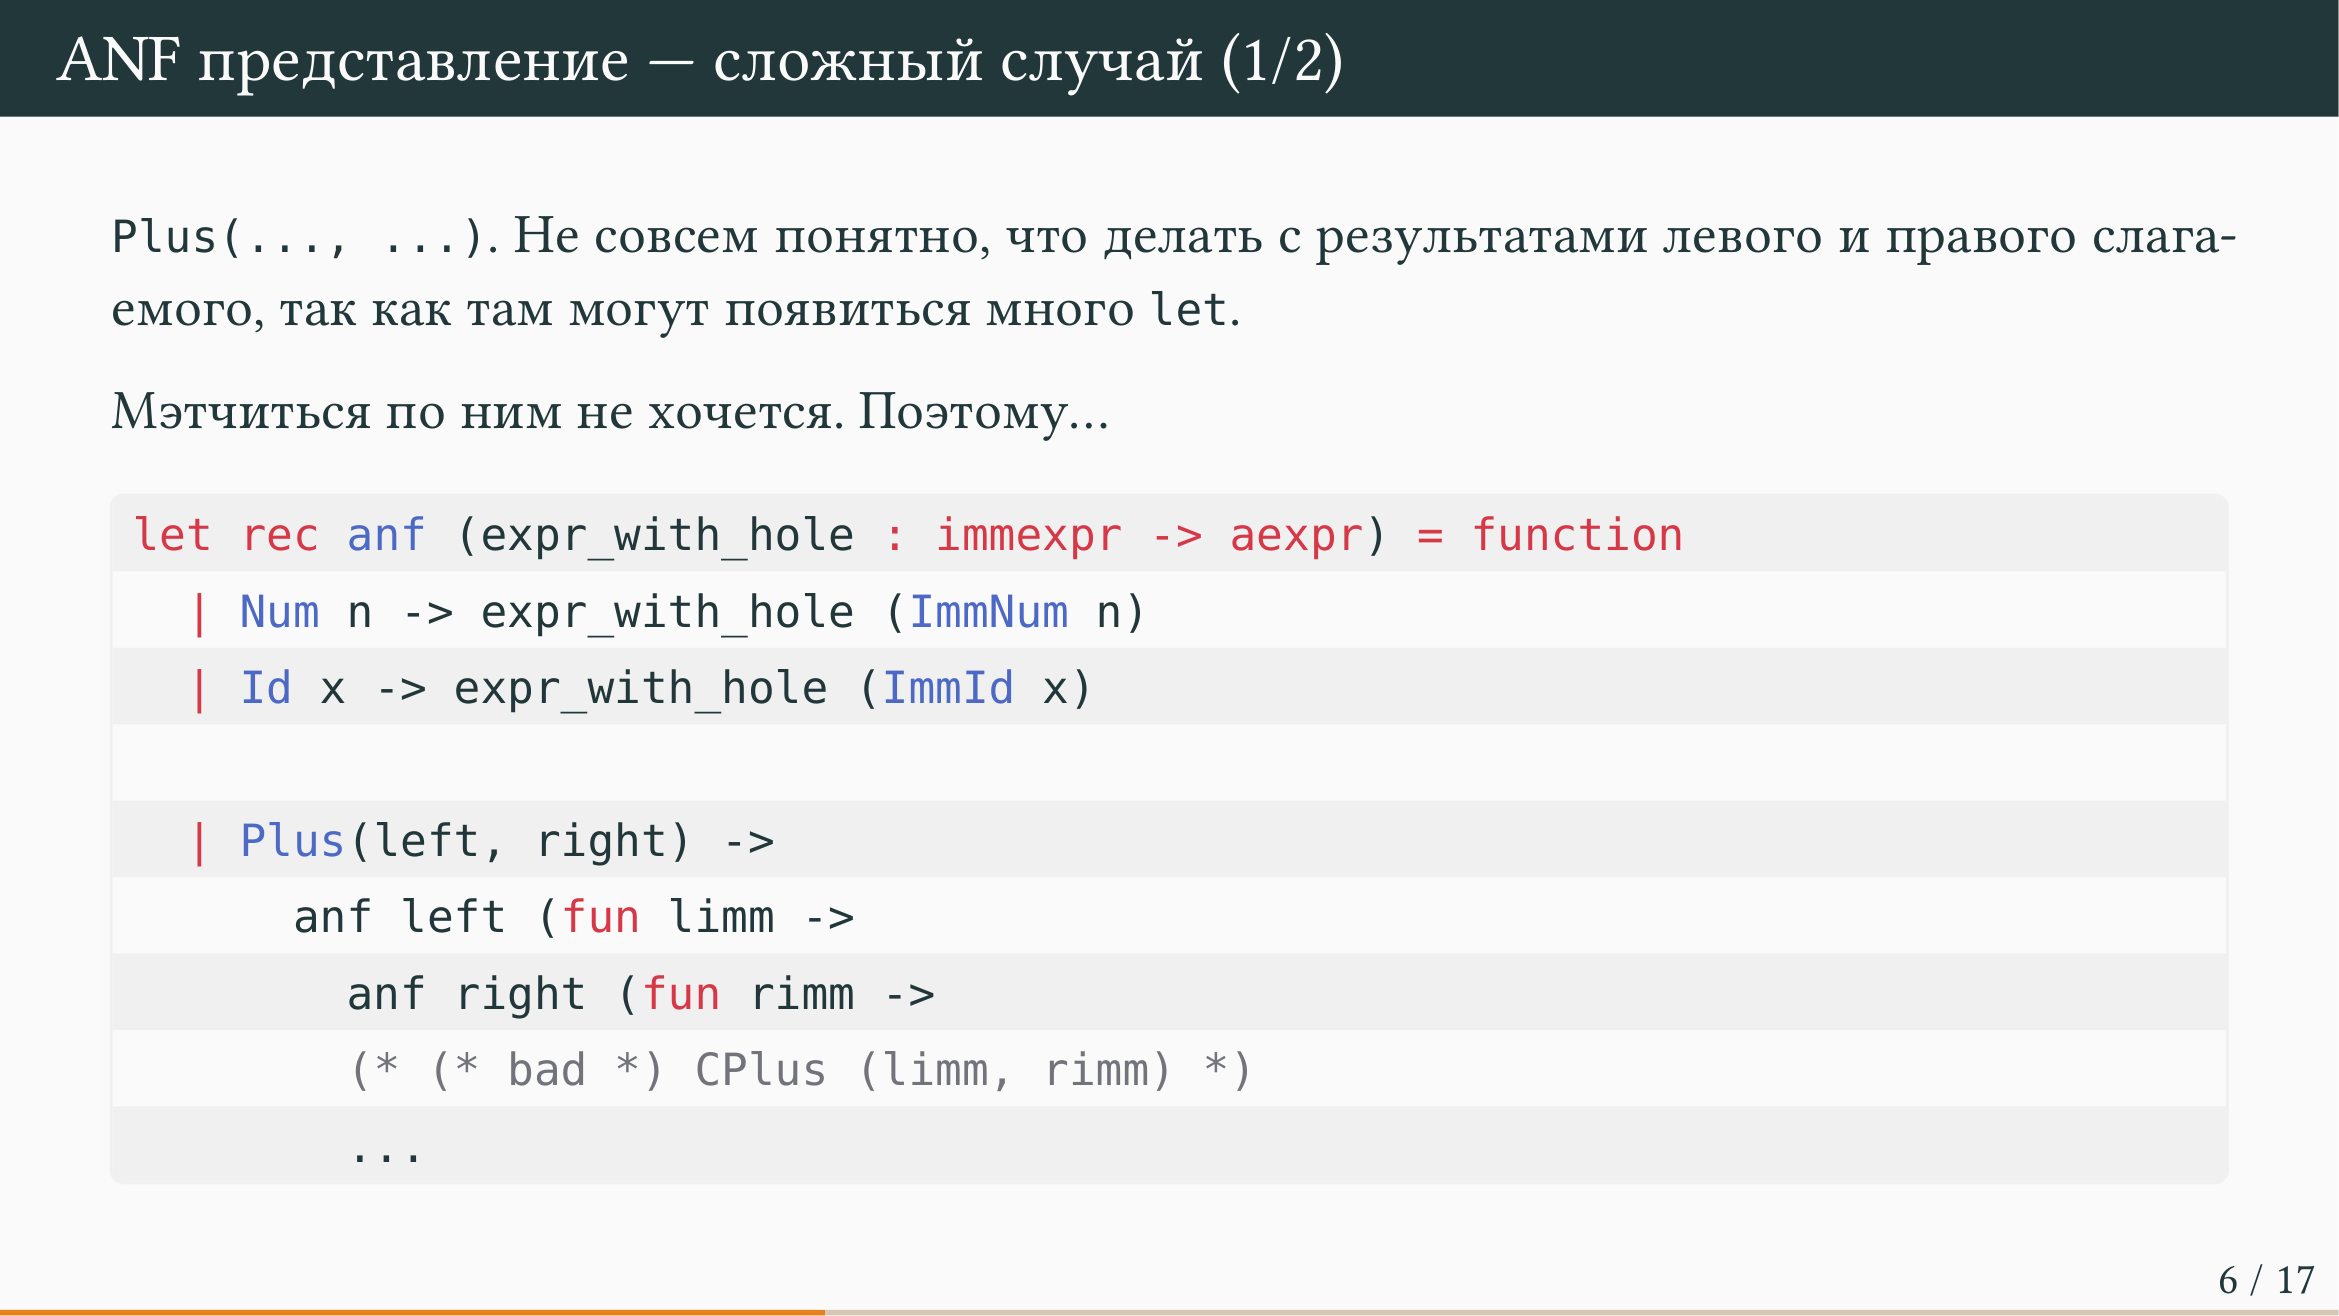
Однако при попытке обработать более сложные конструкции, например операцию сложения (Plus), выясняется, что она должна превратиться в сложное выражение, а не в immediate. Если бы в первых двух ветках сопоставления с образцом просто возвращались примитивные кусочки, не сошлись бы типы, так как при сопоставлении с образцом все ветки должны возвращать примерно одинаковые типы.
Для решения этой проблемы применяется трюк, очень сильно напоминающий Continuation Passing Style (CPS). В этом подходе в функцию дополнительно передается некоторая функция, которая обозначает выражение типа aexpr с дыркой (типа immexpr). Всякий раз, когда строится immediate выражение (в частности, для констант или чисел), вызывается эта функция, и дырка затыкается immediate выражением в нужной форме.
Отступление от темы
И главное, что без багов, и чтобы CI проходил. А то, знаете ли, тут бывают всякие товарищи, которые делают pull-request и говорят, проверяйте. А там все они проходят, или линтер орет, или и то, другое, или он требования не читал. А в требовании к чему-нибудь типа, написано, не сдавайте две задачи одним pull-request. Обычно это двоечники, у которых четвертый курс, у которых май месяц, они до сих пор компилятора не сдали. Вот такие бывают. Их, к сожалению, бывает много. Много – это больше нуля.
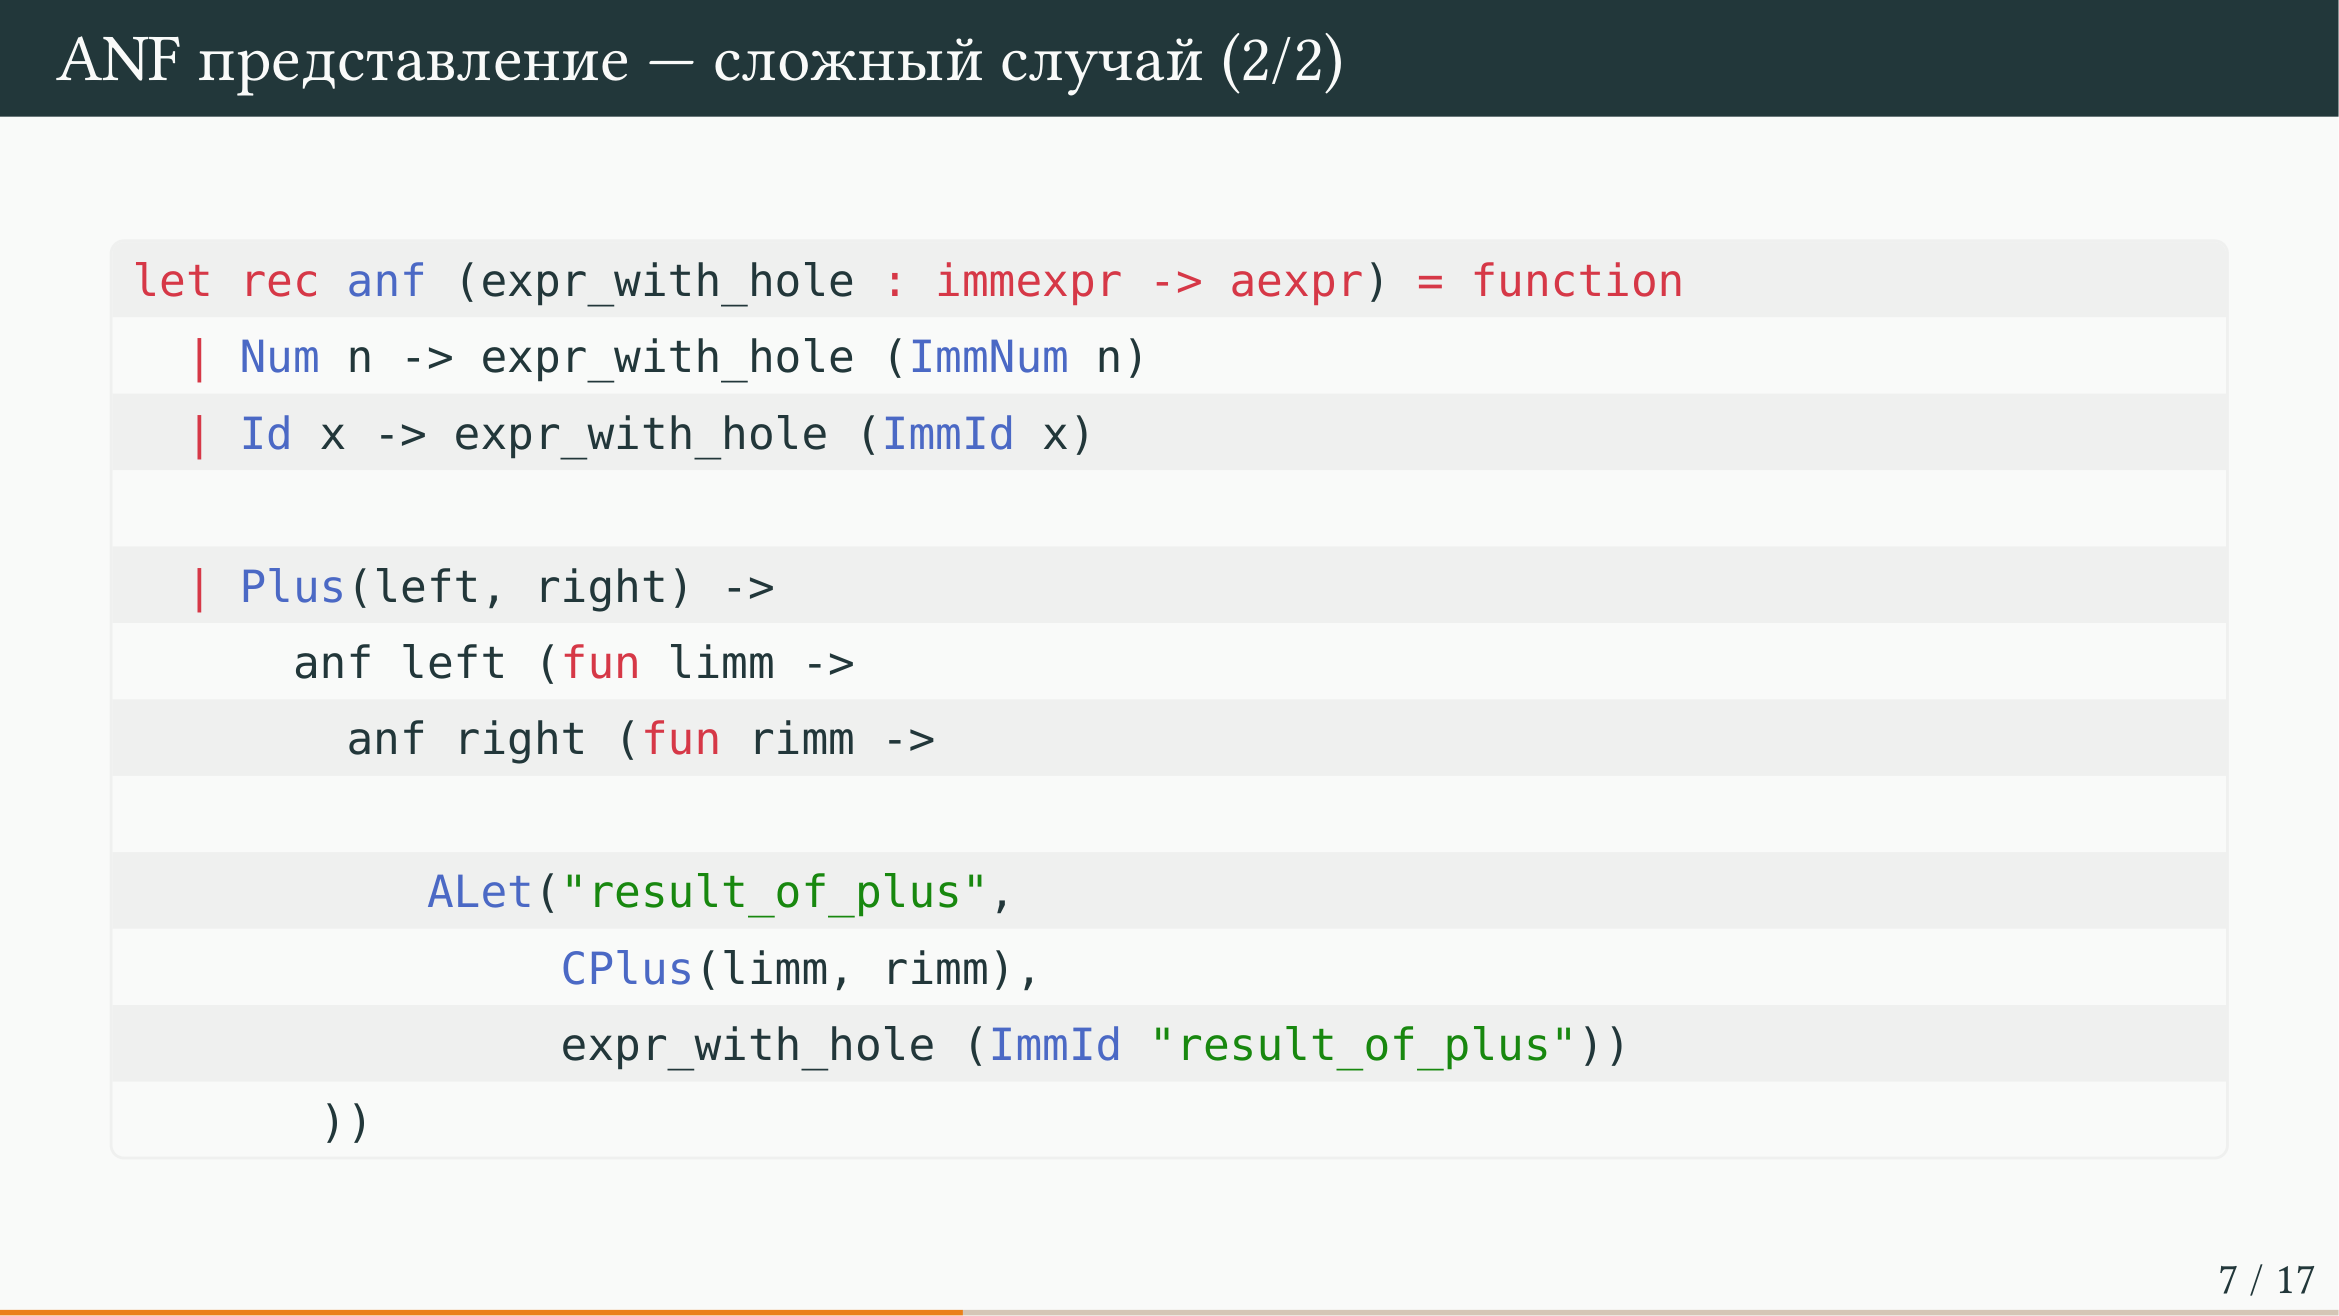
Когда выполняется что-то более сложное, например операция плюс, необходимо рекурсивно посчитать левую и правую части. Если просто построить комплекс выражения, не вызвав функцию-дырку, потеряется информация из кусочков абстрактного синтаксического дерева (AST). Поэтому функцию, заполняющую дырку, необходимо вызывать в каждой ветке паттерн-матчинга из тех же соображений, из которых продолжение в CPS нужно было вызывать в каждой ветке функций.
Однако сложным выражением эту дырку напрямую заткнуть нельзя, так как она принимает immediate выражение. Для этого заводится специальное новое имя, которому присваивается сложное выражение (например, сумма А и Б), только что посчитанное, а дырка затыкается этим новым именем. Разумеется, это новое имя должно быть уникальным, «свежим» во всей программе, иначе произойдет слияние идентификаторов, и программа перестанет работать. Программы должны работать правильно, быстро и без багов. Преобразование в ANF нетипизированного или типизированного представления программы рекомендуется осуществлять описанным образом.
Практические рекомендации по написанию ANF и обсуждение его назначения
Преобразование в ANF (administrative normal form / administrative normal form) нетипизированного или типизированного представления программы рекомендуется осуществлять с помощью подходов, похожих на CPS: заполнять дырки именами и выражениями, строить дерево, а потом то, что получилось, будет более пригодно для порождения кода на ассемблере. Именно это вам предстоит делать в третьем домашнем задании.
Отступление от темы
А чё здесь не хватает? Чё здесь не хватает? Здесь в принципе всё хватает. Я нарочито выбрал очень простой язык, чтобы тут, короче, было всё относительно несложно. У вас начнутся некоторые сложности с if-then-else ну и с паттерн-матчингом, если вы будете его делать, но они преодолимы, они преодолимы, они преодолимы. Всё-таки вы должны как-то, не знаю, собраться, медитировать, откуда чего вы понять и делаете, а то всё на лекциях невозможно рассказать, вы его всё равно потом забудете.
Основная идея заключается в следующем. Лектор задает аудитории вопрос о том, кому нужно повторить и кто помнит, зачем нужен ANF и ради чего он используется, а также почему нельзя написать трансляцию в лоб. Один из студентов отвечает, что ANF служит в качестве дополнительной абстракции, дополнительного представления, хотя возражает, что оно дополнительно тормозит компиляцию. Лектор отмечает, что идея хороша, но конкретно в данном случае дело не в торможении.
Отступление от темы
Окей, ну хотя бы один человек, два человека слушали. Это хорошо.
Самые сложные места при преобразовании — это конструкции let, if, then, else.
Арность функций и частичное применение в контексте ANF
Оптимизация ANF и синтаксический мусор
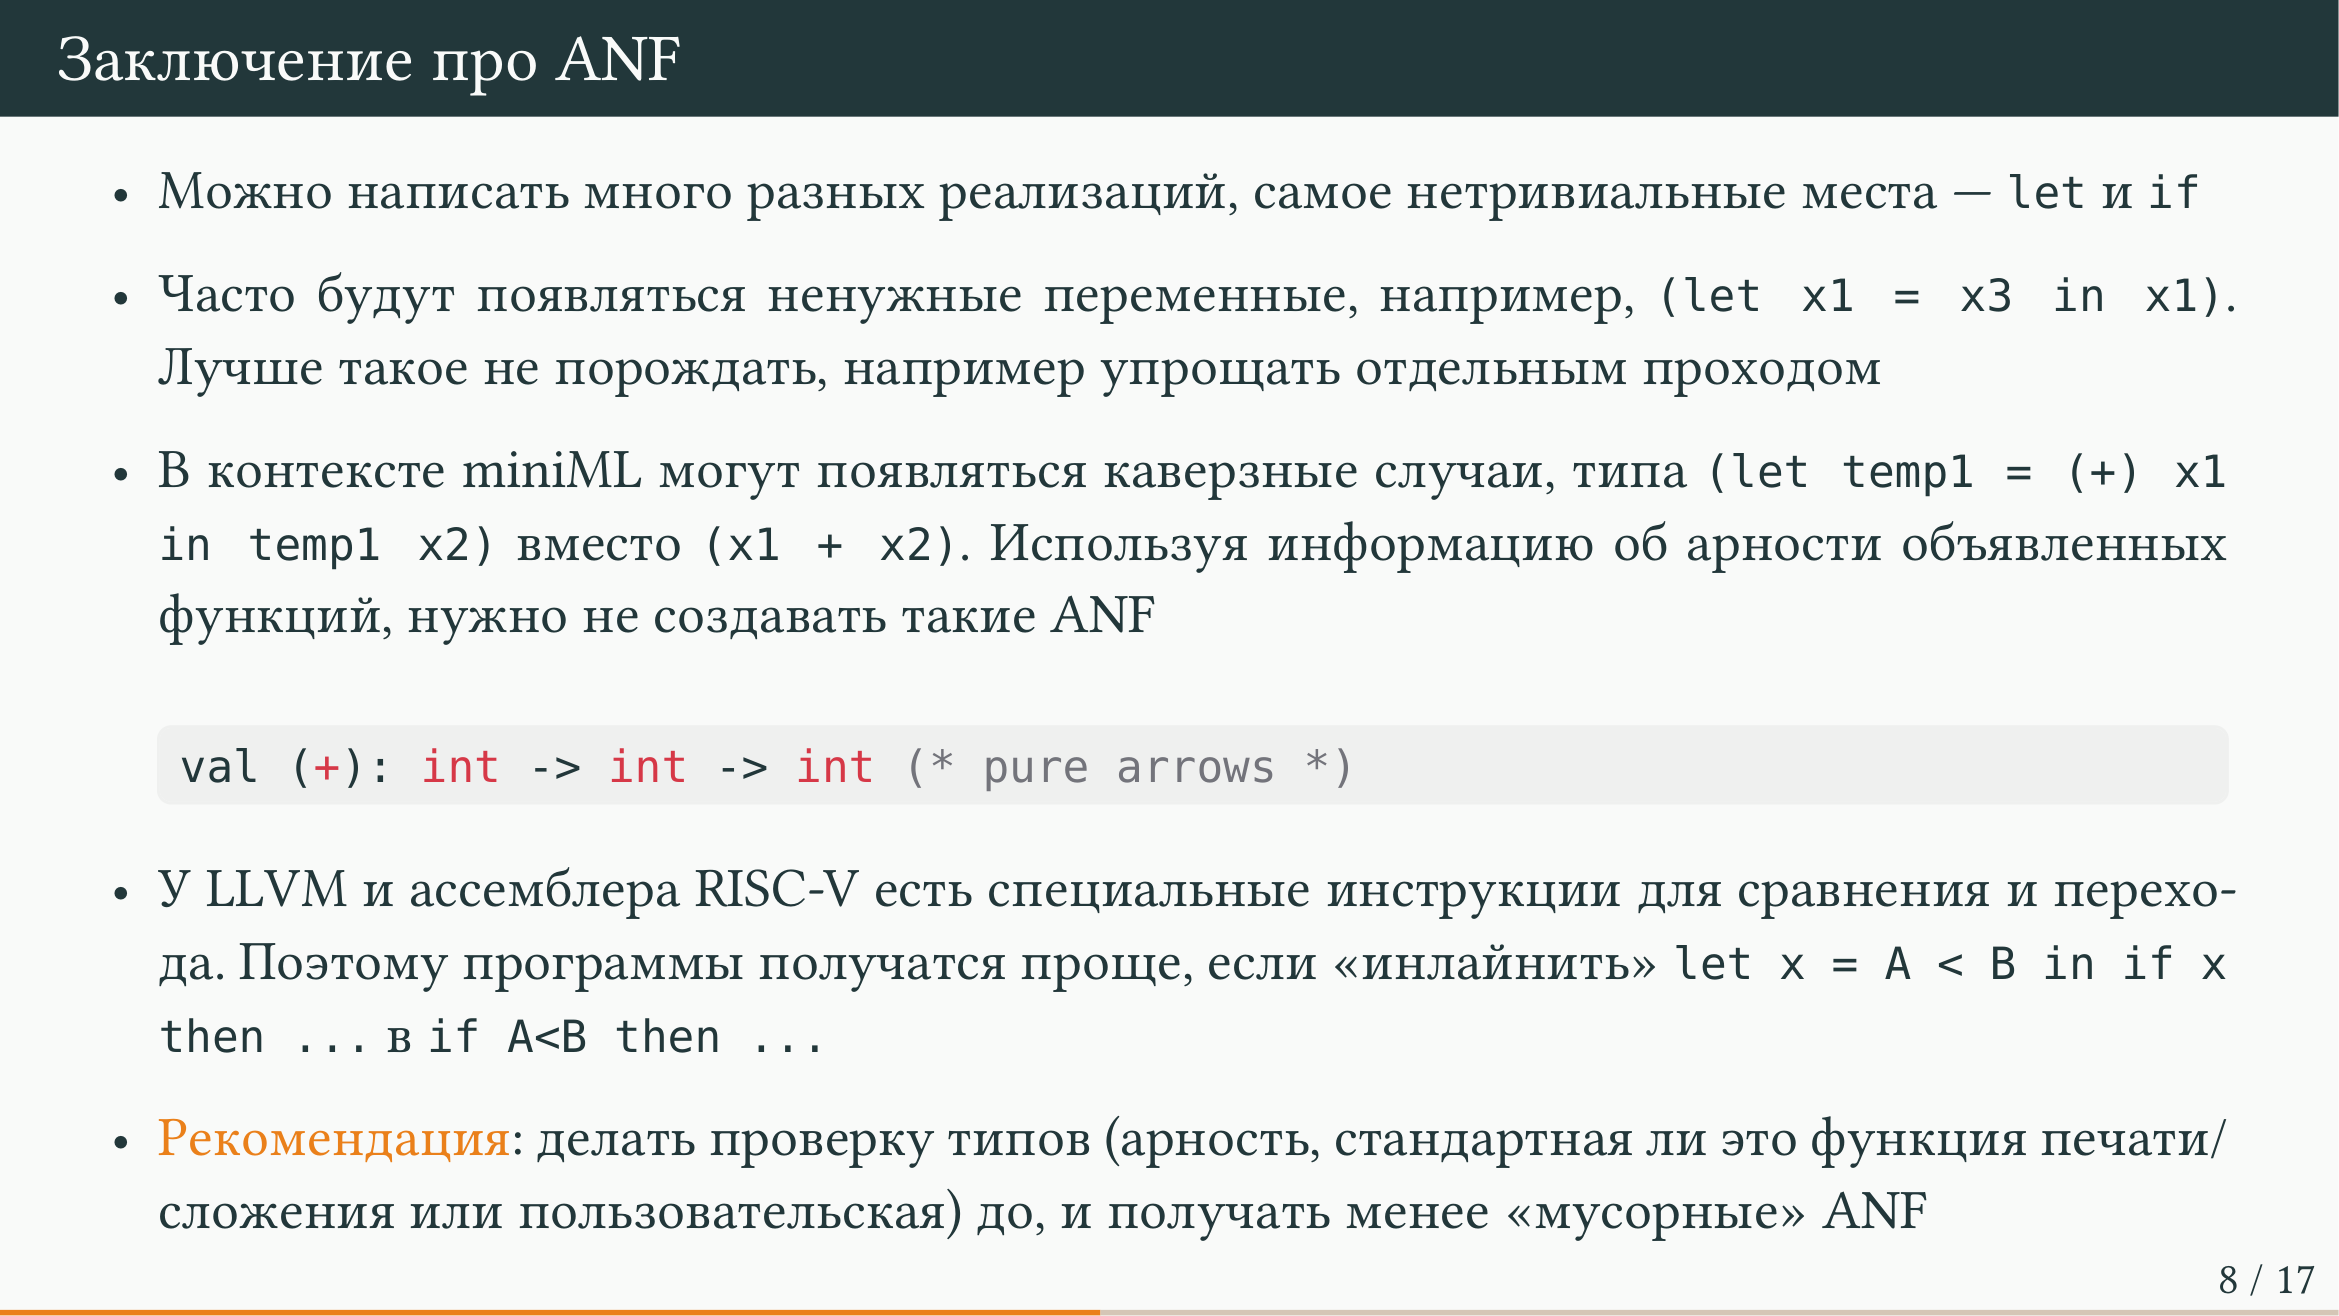
Самые сложные места преобразования ANF — это let, if-then-else, а также matching, если оно присутствует. Во время преобразования может получаться всякий синтаксический мусор, например, выражение вроде let x = y in x, которое можно записать просто как y. Этот синтаксический мусор рекомендуется как-нибудь взять и не доводить до ассемблера. Если вы породите код на ассемблере с этим синтаксическим мусором, и он будет работать — то ладно, а вот если не будет, вы задолбаетесь в этом разбираться. Тем более, если вы не писали на ассемблере, вы, наверное, его еще и не читаете.
Отступление от темы
По крайней мере, я не читал, пока не начал писать. Каждая строка начинается заново с "> ".
Синтаксический мусор — это очень плохо. Он требует создания более больших программ на ассемблере, а большие программы на ассемблере тормозят. Программы должны работать быстро.
Существуют всякие каверзные случаи, специфичные для функционального программирования с каррированием. Классический вариант сделать AST — это завести применение одного выражения к другому: выражение, которое является функцией, применяется к одному аргументу, потом то, что получилось — ко второму аргументу, то, что получилось — к третьему аргументу и так далее. Если делать каррирование просто «в лоб», то для каждой такой частичного применения одного аргумента будет создаваться дополнительный let. Это, конечно, будет работать, но здесь срабатывают ровно те же соображения, что и про let x = y in x: слишком большие программы будут слишком много вызывать кода в рантайме.
Проблема каррирования и частичного применения аргументов
слишком большие программы будут вызывать слишком много кода в рантайме, и если там что-то пойдет не так, это будет плохо. Поэтому желательно в тех случаях, когда вы знаете, что у функции гарантированно несколько аргументов (например, пять) и передается ей ну хотя бы больше одного аргумента, передавать сразу несколько. Делать это по одному сложнее, сделать плохо будет проще, чем сделать хорошо.
Предположим, у вас есть функция f типа int -> int -> int. И вы встречаете где-то в программе вызов f от 42 и 43.
Отступление от темы
Другие варианты есть? Кто еще слушает лекцию кроме Самодурова? Вы хотите дать имя 42 и 43... Ну, это будет работать, просто это немножко избыточно, потому что у нас в памяти это уже есть. Переменные, константы — они равносильные, там не нужно усложнять на пустом месте. Но это будет работать. Еще какие-нибудь варианты? Ну, наверняка есть много неправильных вариантов. Но просто есть очевидный вариант, который вы не назвали.
Оставить как есть. Ну, у функции два аргумента, вон, int, int, а тут два аргумента мы принимаем. Вариант «оставить как есть». Ну, просто я ожидал, что его назовут первым. Я не знаю, вы его не назвали, потому что он вам в голову не пришел, или вы считаете его каким-то неправильным, или вы просто сидите и ждете, когда пара кончится. Ну, просто, ну, буквально вот так: да, оставить, вот первое, что приходит в голову.
Ну, у функции два аргумента. Ну, два аргумента и применили. Вот только что я вам говорил, что там не применяйте по одному, если у функции есть вон два. Вот только что я это рассказывал. Вот. Ну, представьте, что f — это, я не знаю, плюс. Но тут просто f. Понятно, что плюс, наверное, вы не будете там делать дополнительно вот так вот. Ну вот, в чем разница между плюсом и f? И там два аргумента, и там два аргумента, там int, int. Вот. Просто я ожидал, вот что вы этот вариант «оставить как есть» назовете первым и быстро, а тут из вас его придется воскогубцами доставать. Кто-нибудь, издайте какое-нибудь рассуждение на тему вот...
Дискуссия об арности функций и вариантах передачи аргументов
Отступление от темы
Кто-нибудь, издайте какое-нибудь рассуждение на тему вот этого вот оставить как есть. Желательно кто-нибудь, кроме Самодурова. В плане, то есть, ваканная? в плане почему это плохой или хороший вариант. Как-нибудь оцените, допустимый это вариант или недопустимый. Если допустимый, то какое-нибудь объяснение, почему его не упомянули. А если недопустимый, то в каких условиях он недопустимый. Ну вы начали думать, это хорошо. Осталось подумать еще. Ну, подсказывайте залу, что ли. Вопрос был... возможно здесь какой-то конфуз возможно вы поймете что я считаю услышать из подумать что такое какая Какая-то. Угадай-ка. Так, что такое F? Какое F бывает? Откуда [неясный фрагмент]
Ну, потому что это кажется логичным. Функция, два аргумента. Оба аргумента имеют выражение, ничего с ними не делаем. Берем и вызываем. Вот. Ну, в AST, конечно, нужно будет подготовиться к тому, что у функции бывает много аргументов сразу. Но это, в принципе, не проблема, это понятно, как делать.
Но функции два аргумента, мы передаем две константы, потому что зачем сложности. И константа — это имеет два аргумента, это не пара, да, нет никаких списков... ну берешь и передаешь так. Зачем принимать первый аргумент, принимать сразу все? Ну как все работает, ну вот значит можно это будет нормально.
Разбор типов и фактической арности функций
Что такое F и каким оно бывает, откуда оно может взяться в нашей функции? Оно может взяться из двух мест, и первое из них — это когда кто-то написал функцию. Если задана сигнатура, возвращающая int с двумя аргументами, то очевидно, что арность равна двум. Но здесь может возникнуть ошибка, если мыслить как сишник или как растаман.
Отступление от темы
ну что вы мыслите как сишник или как растаман например Каждая строка начинается заново.
Рассмотрим пример с тремя числами: пусть функция имеет вид x y z равно x плюс y плюс z. Значит, можно передать два аргумента, и проблемы нет. Но если было три аргумента, один частично применили — поели там в одном ресторане суп, осталось два, в другом ресторане нужно доесть до двух и запить чем-нибудь — вот два аргумента берем и применяем, проблемы нет. А если цепочка длиннее, путь потом пять аргументов, то я ее не вижу. Тут я делаю полное применение, а если вернулось частично, то результатом частичного применения было три аргумента, один применили, значит, можно применить еще два. Почему я не могу применить два, а вынужден принимать их по одному? Вот вопрос в этом.
Отступление от темы
ну вы придумали очень и так сарна sti и сколько уар на все такой функции Каждая строка начинается заново.
Такая ситуация возникает потому, что функция синтаксически записана в каррированном виде (curried). То есть функции с арностью два такого типа не бывает, но если вы сказали, что арность один, а там два аргумента — почему один? Потому что синтаксически. А как пример можете сделать? Вы просто назвали плюс, да, ну плюс очевидно ест два аргумента.
Функции высшего порядка и возврат функций из функций
Да плюс очевидно есть два аргумента, вот их можно передать например [неясный фрагмент]. Функцию... погодите, первому моменту написано Int или... вы имеете в виду, но то тип в типе должна торчать функция. Так, короче, сделайте, предъявите мне функцию арности один с таким типом. Подсказал вот вообще максимально-максимально вот явно. Любую. Вы плюс-плюс назвали, но это не плюс-плюс, очевидно, арность два, просто вы путаете синтаксическую нотацию про арность и фактическое количество аргументов [неясный фрагмент] функция с номером...
Отступление от темы
От вас матлогикой тянет, все эти вот эти теоремы о неполноте, кого там, первая, вторая теорема о типах, не знаю, забыл Гильберта, вот там тоже мы гедали [возможная ошибка распознавания: гёделировали], а должен нумеровали функции. Ну короче, это какой-то [неясный фрагмент].
Так, ну давайте, давайте функцию с одним аргументом и таким типом. Но не плюс-плюс, два аргумента, очевидно. Минус тоже не подойдет. Это значит, стрелочка означает, что вы можете применить один, два аргумента, или [неясный фрагмент] она не говорит о том, как она объявляет. Нет, стрелочки правоассоциативные. Функция принимает Int, а потом еще Int, то есть вы [неясный фрагмент] не туда, а нужно... Помните, что язык функциональный, и функции можно возвращать из функций.
Примеры функций с арностью 1 и типом с несколькими стрелочками
Помните, что язык функциональный, и функции можно возвращать из функций. Плюс — это функция двух аргументов, которая делает сложение, а вы просто вырожденный случай предъявляете. В языке Си есть функция memcpy, она принимает destination, source и количество, но вы же не говорите, что эта функция от одного аргумента, который принимает еще два аргумента. Но с плюсом то же самое.
[неясный фрагмент] возведение в степень принимает int, как это выглядит? У меня в картине мира функция возведения в степень принимает основание и степень, которые вообще-то float, и это очень сильно напоминает плюс, и возвращать... Ну, плюс, если что, вы знаете, квадрат... Ну, плюс, который игнорирует первый аргумент. Почему я не могу туда передать два аргумента? Я думал, что это очень простой вопрос, оказывается, нет.
Мы уже поняли, что если у функции такой тип, у нее, возможно, арность 2, возможно, не 2. С арностью 2 разобрались, это плюс. Нам нужен пример, когда арность не 2. Капитан очевидность намекает, что вы должны принять первый аргумент, а потом не принимать сразу второй и что-то сделать.
[неясный фрагмент] я клоню к тому, что если вы видите тип int -> int -> int, вон как на доске, то вы не знаете арность наверняка до [неясный фрагмент] количество формальных параметров. Ну, если у нее было формально три параметра, частично применили один, осталось два, мы вполне можем еще передать. Так что проблемы здесь вроде бы нет. Менять просто функцию [неясный фрагмент] аргумента.
Определение арности передаваемых аргументов-функций
Отступление от темы
победа наконец-то здравствует тапочки на самом деле я ожидал увидеть что-нибудь типа и в n равно нулю тогда плюс 1 else плюс 1 неожиданно это тоже бы сходилось никаких никак не нужно к чему-то я ожидал увидеть что здесь у вас формально аргумент один и вы не можете сюда передать 2 ну что она не принимает конечно
Если вы написали где-то глобально в модуле let f что-то там равно плюс, например, вы можете вот так сделать. Но если вы написали, не знаю, let k от f равно и передали f как аргумент, уже фиг знает, какая у него аргумент. Ну, либо один, либо два. Поэтому вы должны танцевать от самого плохого случая и делать частичное применение по одному. Потому что неизвестна какая арность у функции той, которую передали, несмотря на то, что в типе две стрелочки. Но этого мало.
Отступление от темы
еще вопрос к залу почему это сложный вопрос я не понимаю объясните мне потому что но она формально принимает один
У вас в ассемблере будет написано: загляни в регистр, где первый находится аргумент, и если в регистре, где находится, где должен лежать второй аргумент, что-то лежит, туда просто не заглянет, так как код так написан. Вы можете написать на сишечке факториал, вы можете скастить factorial к функции, которая принимает 5 аргументов, 5 int, и передать 5 туда int. Но это все работать равно будет как factorial, который смотрит только на первый аргумент. И даже несмотря на то, что вы скастите и передадите 5 аргументов, он будет работать как factorial, который смотрит только на первый. И всё.
Отступление от темы
Вот. почему это сложный вопрос объясните мне филички хватит тереть свой нос объясните мне почему это сложный вопрос что он ладно самодуров почему сложный вопрос то есть понять что вы не понимаете возможно вы не понимаете что из функций можно взять функция [неясный фрагмент] Ну ладно. Короче, едем дальше.
Так, значит, с частичным применением мы обговорили.
Стратегия обработки частичного применения в ANF
Отступление от темы
Ну ладно. Короче, едем дальше.
Если вы применяете какую-то функцию, и она объявлена в глобальной области видимости, то вы знаете ее арность, и вы можете применить вот столько аргументов, сколько там арности. А если эта функция пришла как аргумент, несмотря на то, что у нее тип есть две стрелочки, арность там может быть либо один, либо два. И вы должны танцевать от худшего случая, в первую очередь делая так, чтобы работало корректно, а потом — чтобы работало быстро. И тут вот в данном конкретном случае, когда функция пришла как аргумент, вы делаете, чтобы работало корректно, и останавливаетесь. Потому что как сделать так, чтобы работало быстро в контексте ANF — никак, нужно какие-то другие методы. Но это не то что проблема, у нас особенность вот такая, потому что система знает, что один аргумент есть точно, но она не уверена, если два, что функции могут возвращать функции, и они с точки зрения типа неотличимы от функций, которые принимают два аргумента.
Более того, если вы наворотите какую-нибудь хитрую систему типов, например, которая отличает стрелочку, которая чистая, от стрелочек с side-эффектами, то все равно могут быть некоторые проблемы по той причине, что это вот все ещё чистая функция, но тут применять сразу два аргумента не получится. Это реверанс в сторону Haskell, который пытается делать разные виды стрелочек, то есть выделять с помощью типов всякие side-эффекты, которые происходят при вызове функции.
Оптимизация конструкций If-Then-Else и условных переходов
Если делать If-Then-Else аккуратно классическим способом, то выражение, которое находится в If-Then-Else, вы тоже должны ему давать имя и оставлять ifx1 или что-нибудь такое. Если вы так сделаете, это будет работать. Но ассемблер, который вы будете порождать в домашках для RISC-V, там ветвления — они все вида: если одно меньше другого, если одно равно второму или не равно второму, и такого рода вещи. И с точки зрения читаемости порождаемого кода желательно, чтобы если у вас в условии стоит там целочисленное меньше, равно, больше, равно и такого рода вещи, их оставить внутри if, потому что вам будет проще порождать человекочитаемый ассемблер. Но это будет некоторый отход от классического ANF ради более аккуратного порожденного кода и компактного кода разумеется.
Верно это все для целочисленных сравнений: сравнение на равенство, неравенство, больше, меньше. Если бы у вас в языке были флоты, то это было бы верно, наверное... Наверное, не было бы верно, я не знаю, как в RISC-V флоты сравниваются, так что на флоты забьем. Ну разумеется, если у вас в языке появится переопределение операторов, и вы переопределите свое «меньше» как проверку на то, что два числа взаимно просты, то это тоже не стоит инлайнить внутри. То есть желательно отличать «меньше», объявленное в стандартной библиотеке, от «меньше», которое вы объявили как пользовательский оператор. То есть здесь становится важно не только тип, а то, откуда функция пришла, какой она является в семантике.
Отступление от темы
попал попал попал попал короче мусорная н.ф. требует большого ассемблера большой ассемблер невозможно прочитать моем экспириенсе большой ассемблер обычно работает бог баги баги вот значит
Вот теперь что с ANF не так? Это довольно простая штука, но
Ограничения ANF: условные выражения (if-then-else) и сравнение с CPS
Проблемы преобразования условных выражений (If-Then-Else) в ANF
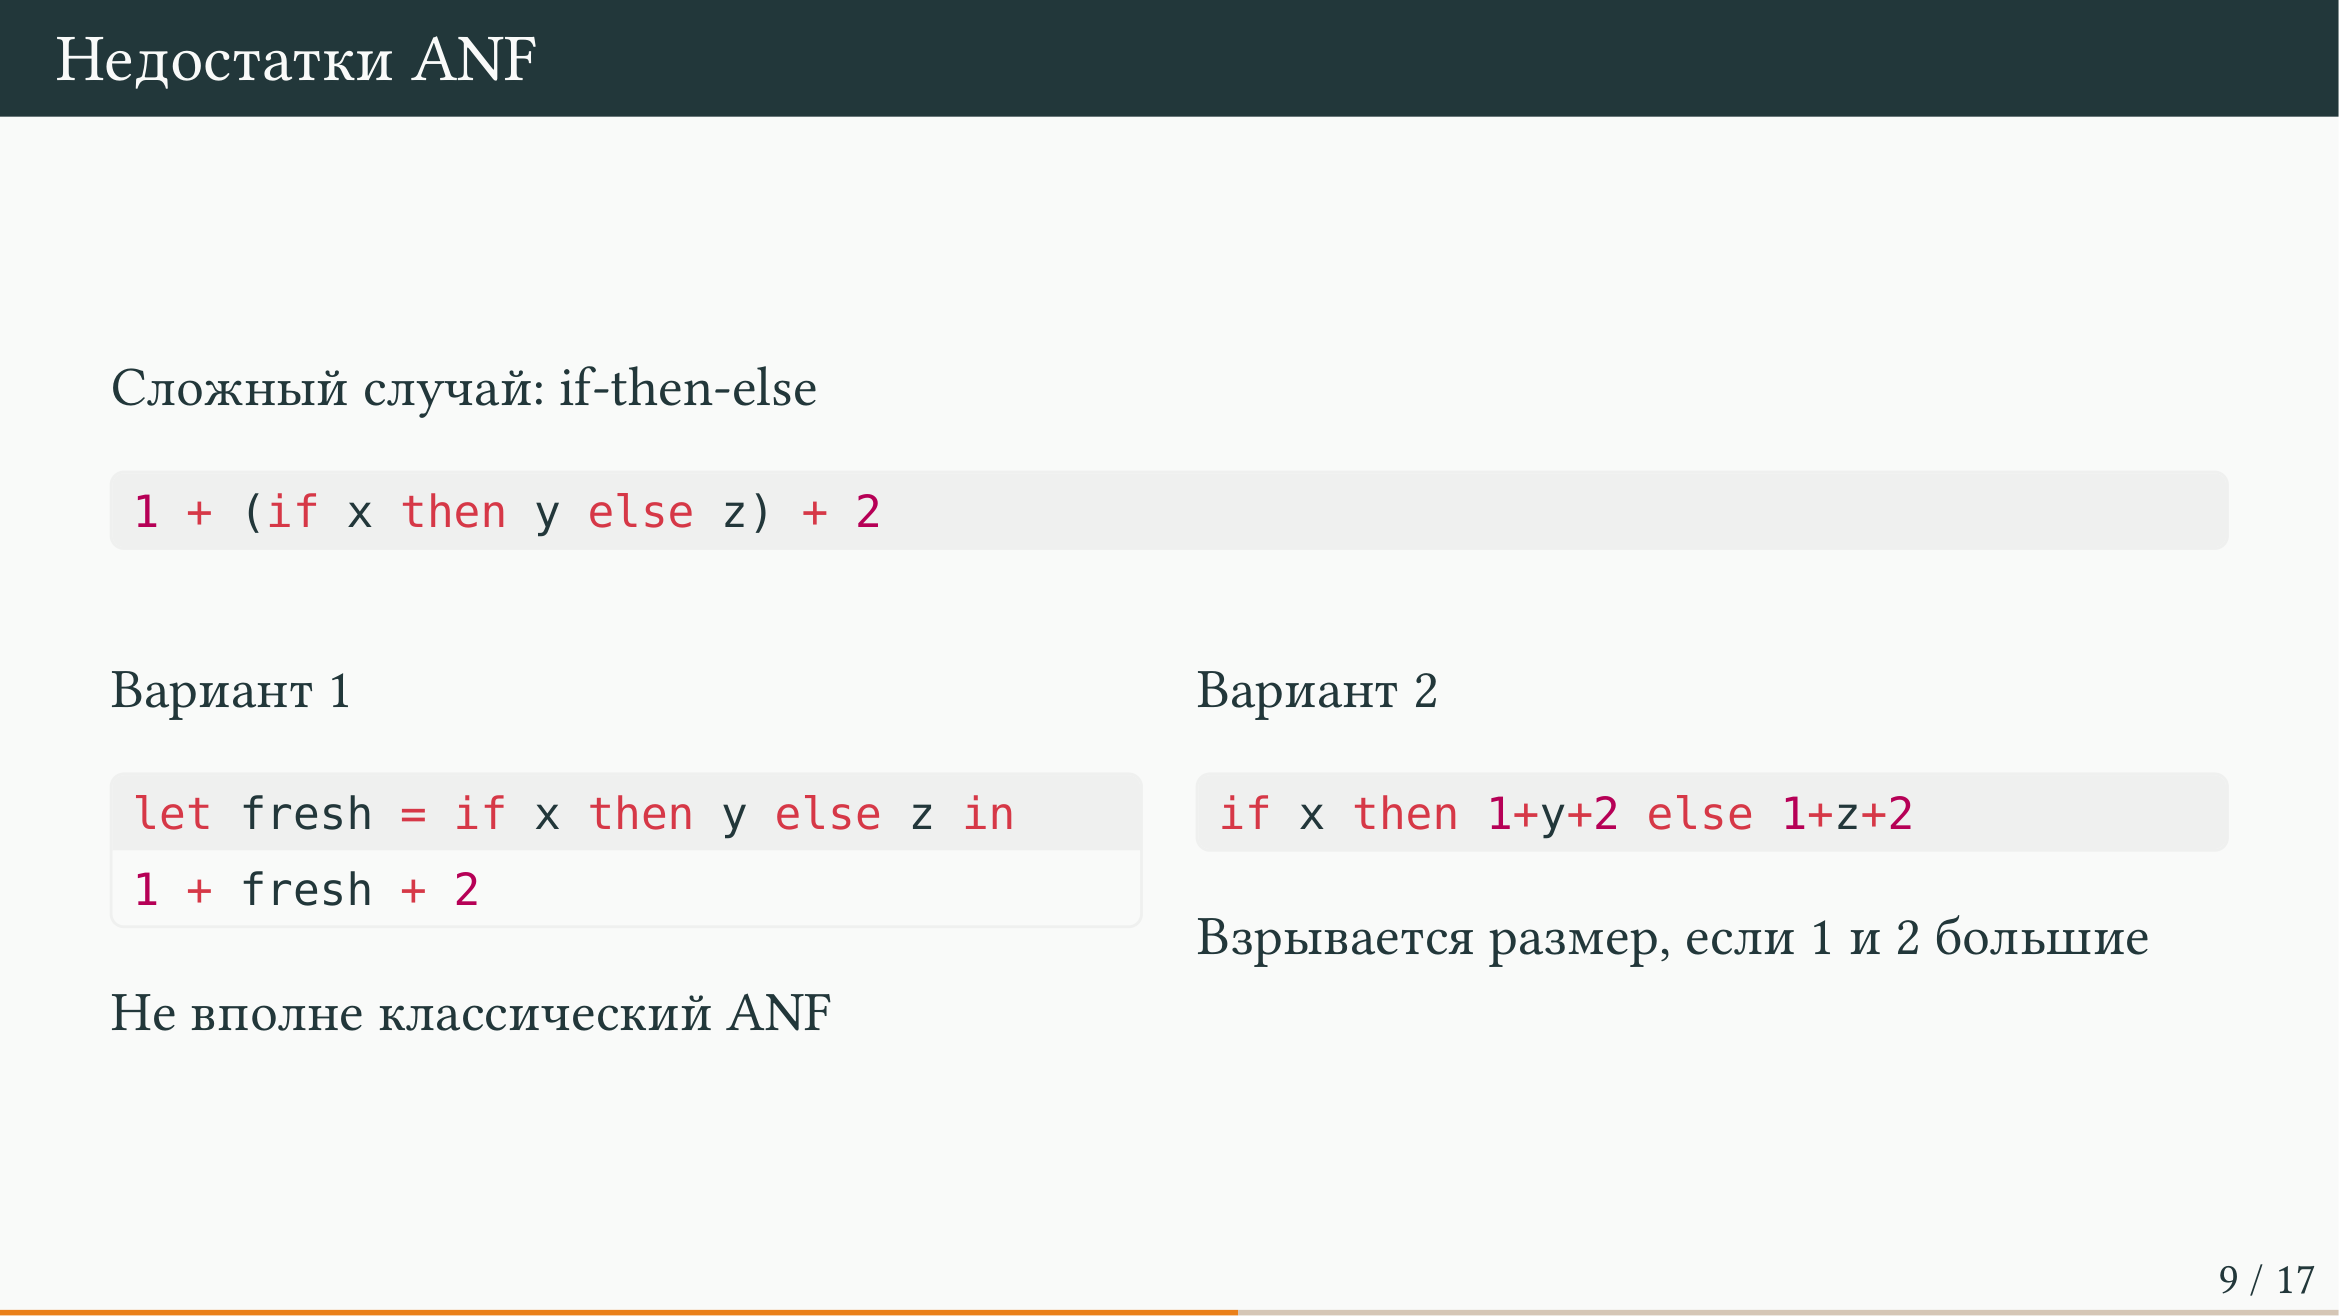
Некоторые вещи, связанные с if-then-else в ANF (когда он записан как выражение вроде 1 + (if x then y else z) + 2), начинают выражаться сложным образом. При попытке перегнать такое выражение в ANF первый вариант предполагает заведение переменной через let: let fresh = if x then y else z in 1 + fresh + 2. Однако это не приводит к успеху, так как справа от let нельзя писать if, поскольку ANF не поддерживает if как выражение (expression), в нем if выступает только как statement (инструкция) в терминах стековых машин. Таким образом, первый вариант ничего не дает, и выражение требуется переписывать дальше, чтобы оно стало соответствовать ANF, где условные конструкции должны быть аля statement.
Второй вариант заключается в том, чтобы вытащить if наружу, а тот код, который должен был работать с результатом if, запихнуть внутрь в обе ветки. Это дает преобразование вида if x then 1 + y + 2 else 1 + z + 2. Данное преобразование корректно, однако здесь код взрывается по размеру: если выражением 1 и 2 являются здоровенные куски кода, их приходится дублировать (раскопировать) в обе ветки (then и else), что приводит к генерации огромного объема кода на ассемблере. На этом преимущества такого подхода заканчиваются, поэтому применяются более хитроумные преобразования, о которых написаны приличные статьи.
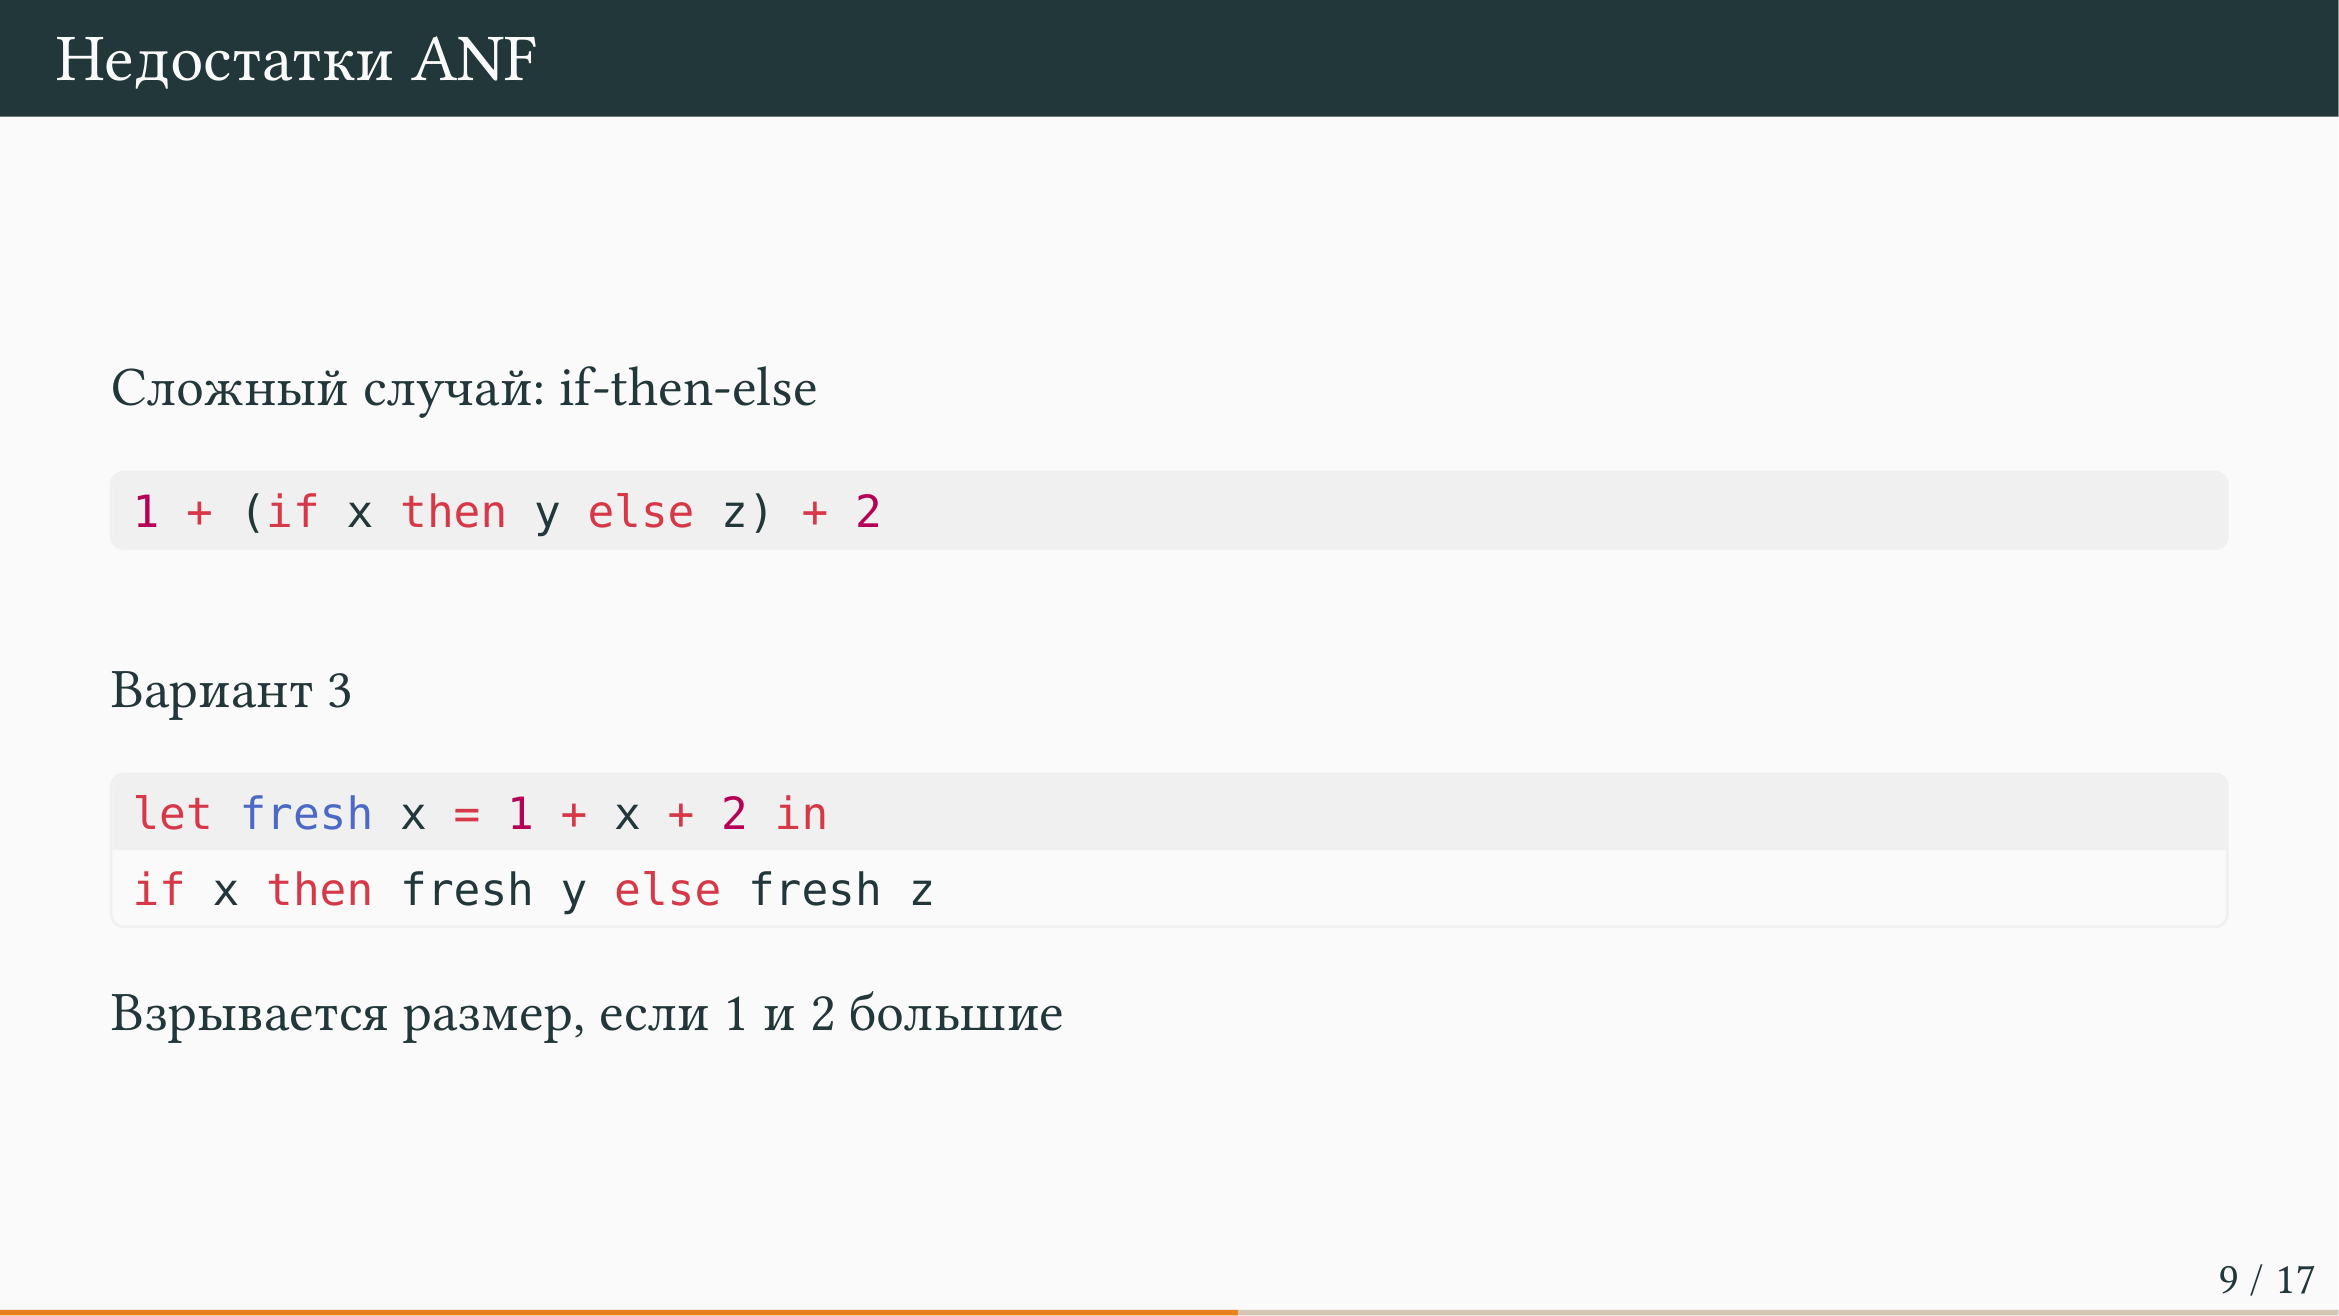
Хитрое преобразование (третий вариант) на самом деле заключается в том, что условное выражение if-then-else протаскивается внутрь функции, где сама функция представлена идентификатором, поэтому код особо не взрывается, а саму функцию можно синтаксически построить понятным образом. По сути, отчасти переписывание в CPS (continuation-passing style) помогает сделать хороший ANF, а переписывание в ANF позволяет руками переписать в CPS так, чтобы оно эффективно работало. Между ними существует некоторая связь, поскольку и то, и другое является промежуточным представлением для функциональных программ, они оба активно применяются и конкурируют друг с другом.
Связь ANF с CPS и проблема незамкнутости при инлайнинге
Сложности с заведением множества CPS-функций выглядят избыточными, однако заведение простых let-связываний для аргументов не подходит в случае конструкции if-then-else. Условный оператор if является чрезвычайно важным случаем, поскольку он сильно напоминает pattern matching, из которого в основном и состоят функциональные программы. Если в этом месте программы будут «взрываться», то эффективные программы просто не будут порождаться, что является серьезным недостатком. При переписывании программы в CPS необходимо выбирать такой вариант трансляции в фенилс [возможная ошибка распознавания: имеется в виду if-then-else], чтобы код не «взрывался». Появление вложенных анонимных функций, которые потенциально создают замыкания (если в ветках then и else сложные переменные), создает определенные трудности, однако с этим можно бороться, и способы борьбы с замыканиями будут рассмотрены в дальнейшем. Борьба со «взрыванием» тела программы важна, так как более короткие программы исполняются быстрее.
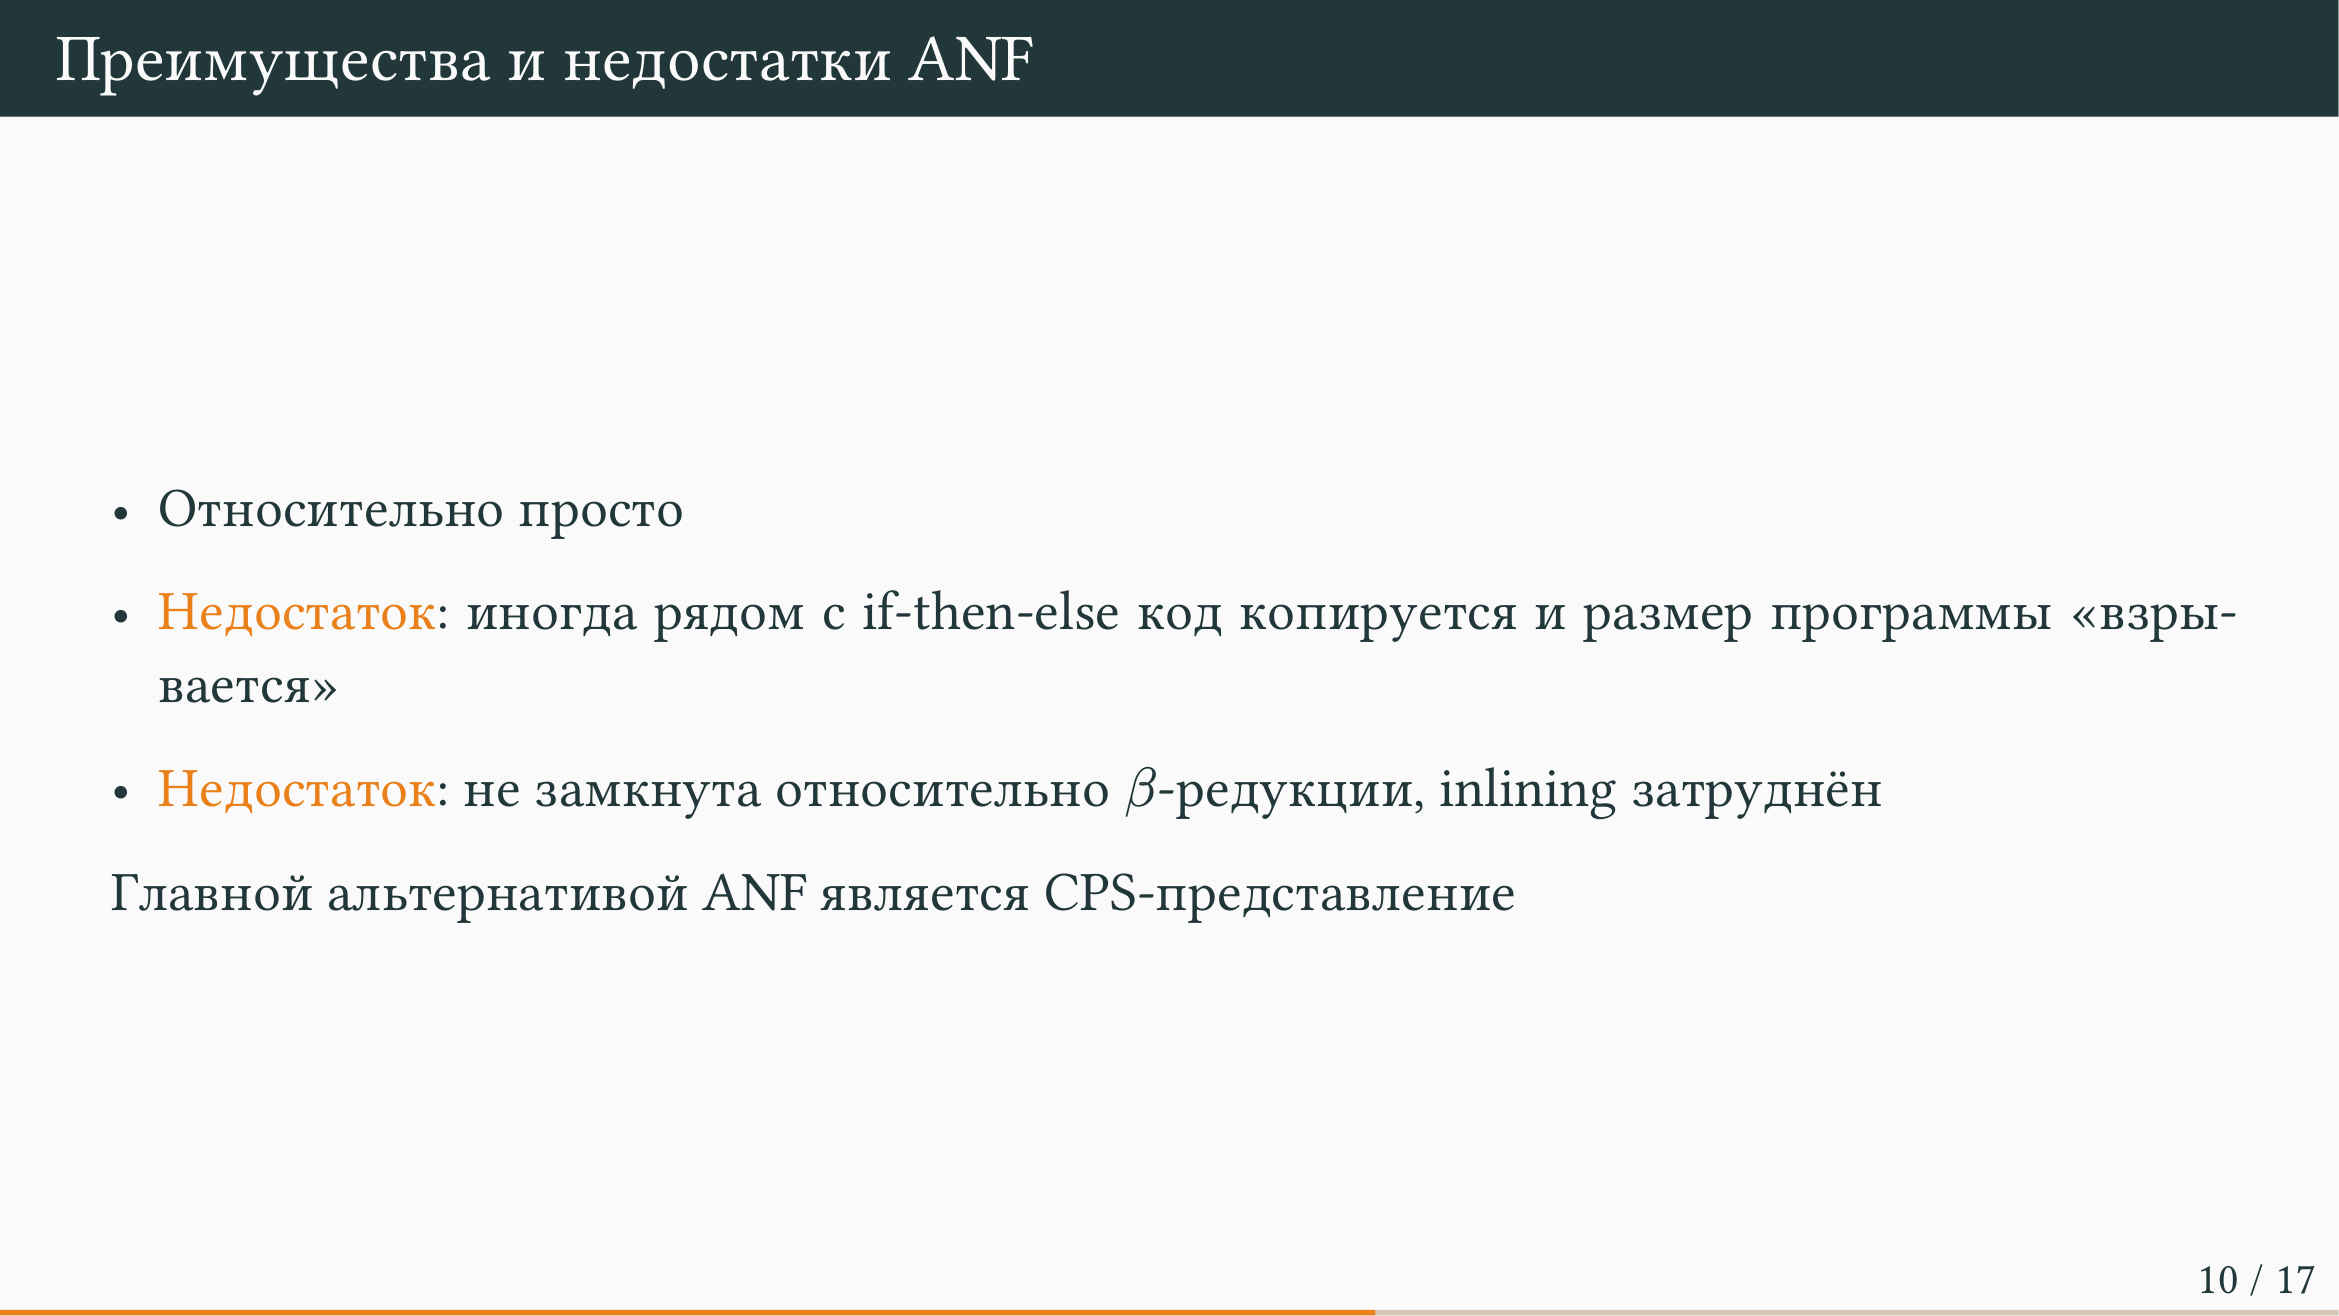
Вторым важным недостатком ANF является затрудненность проведения некоторых оптимизаций. В частности, при попытке выполнить inlining одних функций в местах их использования обнаруживается, что нельзя просто так взять и подставить тело функции. Получившийся результат перестает быть каноничным ANF, из-за чего после операции inline приходится заново переписывать программу в ANF. В математических терминах это означает незамкнутость относительно операции inline: применение inline к ANF-функции внутри ANF-представления не дает в результате ANF, то есть налицо свойство незамкнутости.
С CPS-представлением возникают другие проблемы. Нельзя просто так взять и аккуратно переписать программу в CPS, так как в получаемом коде часто возникают возможности для проведения $\beta$-редукций, которые теоретически могли бы сделать программы короче. Если эти $\beta$-редукции «протекут» в ассемблер [возможная ошибка распознавания: вероятно, имелся в виду этап генерации кода], это будет означать, что промежуточное представление потребовало больше работы, а исполняться программа будет медленнее, что нежелательно. Поэтому требуется такое переписывание в CPS, которое не порождает эти «мусорные» $\beta$-редукции, а добиться этого непросто. Трудность заключается в том, что даже если в одном и в другом месте преобразование выполняется нормально, при их совмем применении друг к другу всё равно возникает $\beta$-редукция.
Недостатки CPS-представления и ответы на вопросы
Проблема INF в ANF заключается в том, что inline-подстановка работает ненормально. То есть проводить inline на этом представлении неудобно: конечно, можно, но неудобно. Скорее всего, после ANF дальше нам нужно повозиться с замыканиями. Я бы сказал, что там всё просто, но после вот этого вопроса я уже воздержусь это говорить. Если у вас есть какие-то вопросы по ANF...
Отступление от темы
...свобода вам взять и варганить преобразование того, что вы напарсили в ANF. Сколько кандидатских диссертаций вам нужно получить, чтобы написать преобразование в ANF? А без нейронки? А на OCaml? Что? На бумажке? Бумажка вам ошибки не сообщит. Ну, вообще, бумажка связана с некоторыми сложностями. Потому что я не уверен, что вы готовы соединять манипуляторы с нейронкой, чтобы она писала вам ручкой на бумаге решение. Возможно, вы, конечно, запаритесь до стока, чтобы программировать с нейронкой на бумажке, но что-то я думаю, что вам будет лень. Что? Чего люди только не придумают, чтобы не программировать.
Ещё какие-нибудь вопросы? Как это называется, только при if? Ну, то есть, какого самого частого кейса? Ну, насколько я понимаю, при if'е и при match'е, возможно, он взрывается где-то еще, я про это забыл. Ну сделайте, расскажите. Вот, возможно, взорвется, если вы туда добавите какую-нибудь гадость. Не знаю, к языку можете добавить гадость на async/await, они вряд ли, скорее всего, трюк с CPS поможет. Вот. Короче,
Управление замыканиями: Closure Conversion и Lambda Lifting
Устранение замыканий: Lambda Lifting и Closure Conversion
Перед генерацией ассемблера возникает задача обработки сложных аргументов функций, таких как выражения вида f(x + y). Кроме того, дополнительную сложность представляют вложенные функции, анонимные функции, а также конструкции let и let rec. Для борьбы с этими сложностями используются преобразования Lambda-лифтинг (Lambda Lifting) и преобразование замыканий (Closure Conversion). Эти преобразования можно запускать как на типизированном, так и на нетипизированном дереве. Однако преобразование INF, поскольку ему требуется информация об арности функций, желательно запускать на том представлении, где арности уже известны, заодно изучая типы. Конкретный момент запуска этих этапов зависит от реализации в домашних заданиях.
Необходимость преобразования замыканий обусловлена тем, что в процессоре и в ассемблере нет понятия замыканий, поэтому программы необходимо переписывать так, чтобы замыкания представлялись явно. Данная концепция разрабатывалась примерно в 1980-х годах, и при обращении к оригинальным статьям можно встретить алгоритмы, которые интуитивно приходят в голову при самостоятельной реализации.
Отступление от темы
Когда я это писал, я написал от балды какую-то штуку и потом узнал, что оказывается, была в году так 85-м статья, где сделали примерно то же самое. Отсюда я заключил, что, видимо, задача не такая сложная, как мне казалось.
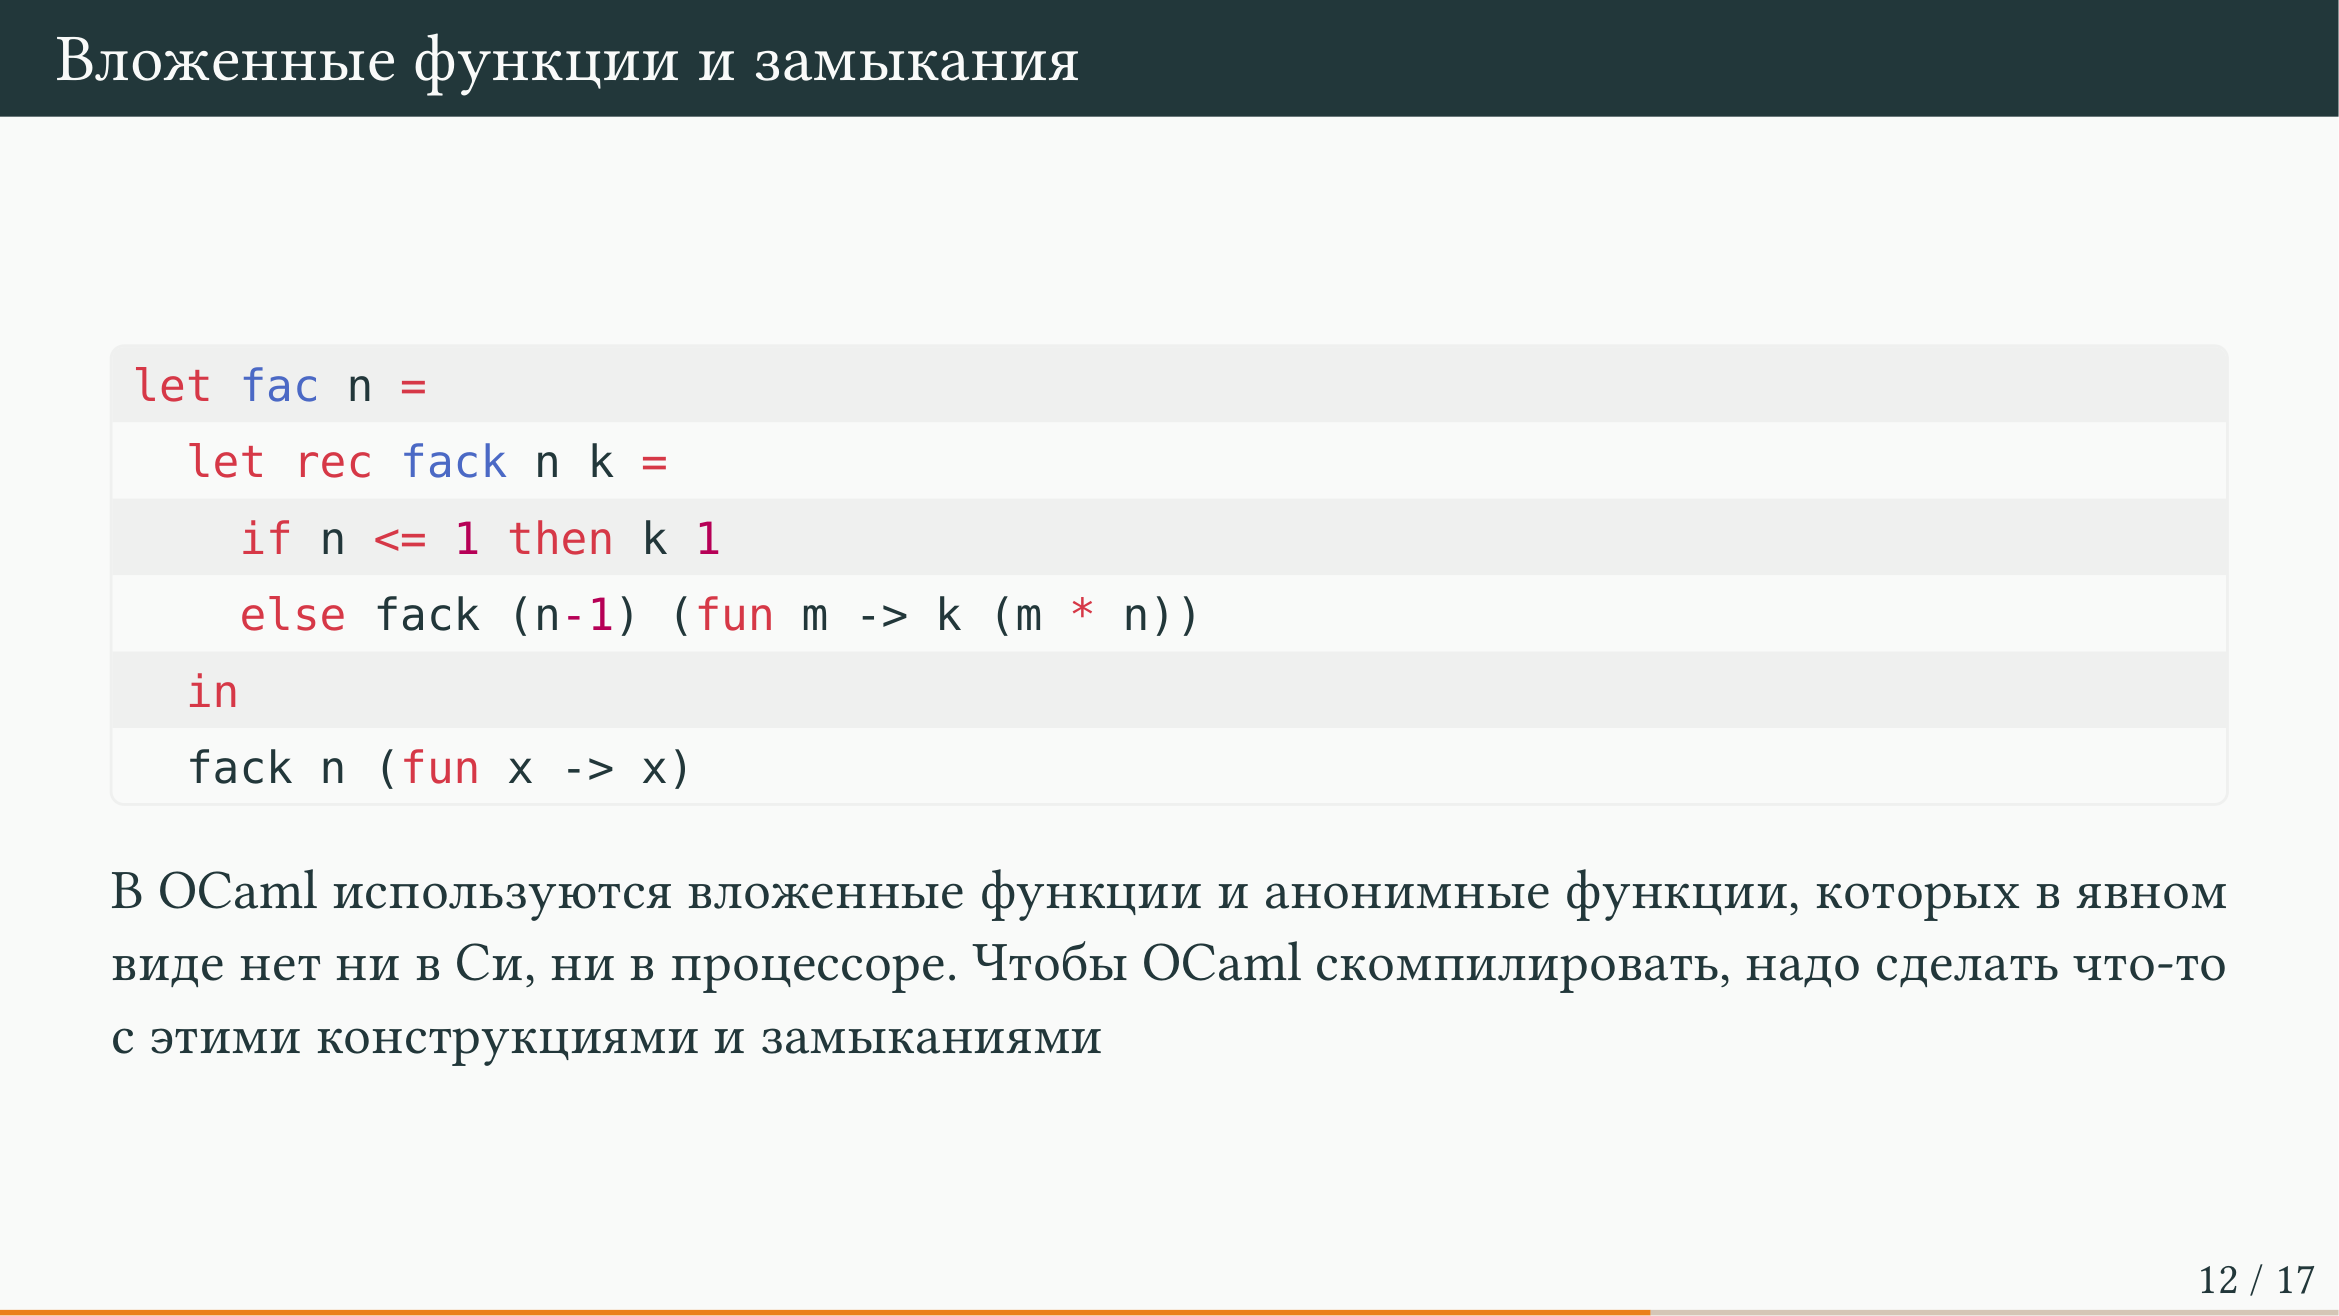
Проблема заключается в том, что в коде присутствуют замыкания. Например, в рассматриваемом примере на четвертой строчке запускается анонимная функция как продолжение, в которую через замыкание попадают переменные k и n. Нельзя просто взять и написать на ассемблере функцию, которая принимает м и делает к от произведения, потому что аргумент м есть, а как передать остальные два аргументы непонятно.
Чтобы с этим справиться, в первую очередь нужно определить, какие аргументы передаются через замыкание. С точки зрения терминологии, такие аргументы являются свободными переменными (привет из математики и теории лямбда-исчисления). В рассматриваемой большой анонимной функции переменные k и n входят свободно, поэтому их нужно явно передать.
Алгоритм работы идет от листьев к корню дерева. Сначала собираются все свободные переменные: при обнаружении переменной она добавляется в множество, а константы не добавляются, так как не являются переменными. Когда алгоритм доходит до лямбда-абстракции, переменная, которая в листьях была свободной, перестает быть таковой и удаляется из множества. При этом стандартные функции, описанные глобально в стандартной библиотеке (например, плюс), добавлять в множество не нужно, так как они не могут содержать свободные переменные, особенно в языке без возможности объявления пользовательских операций сложения.
Когда алгоритм доходит до объявления функции, получается некоторое множество свободных переменных, которые передаются через замыкание. Самый очевидный вариант работы с ними — явно добавить их в качестве аргументов функции.
Способы передачи свободных переменных и представление замыканий
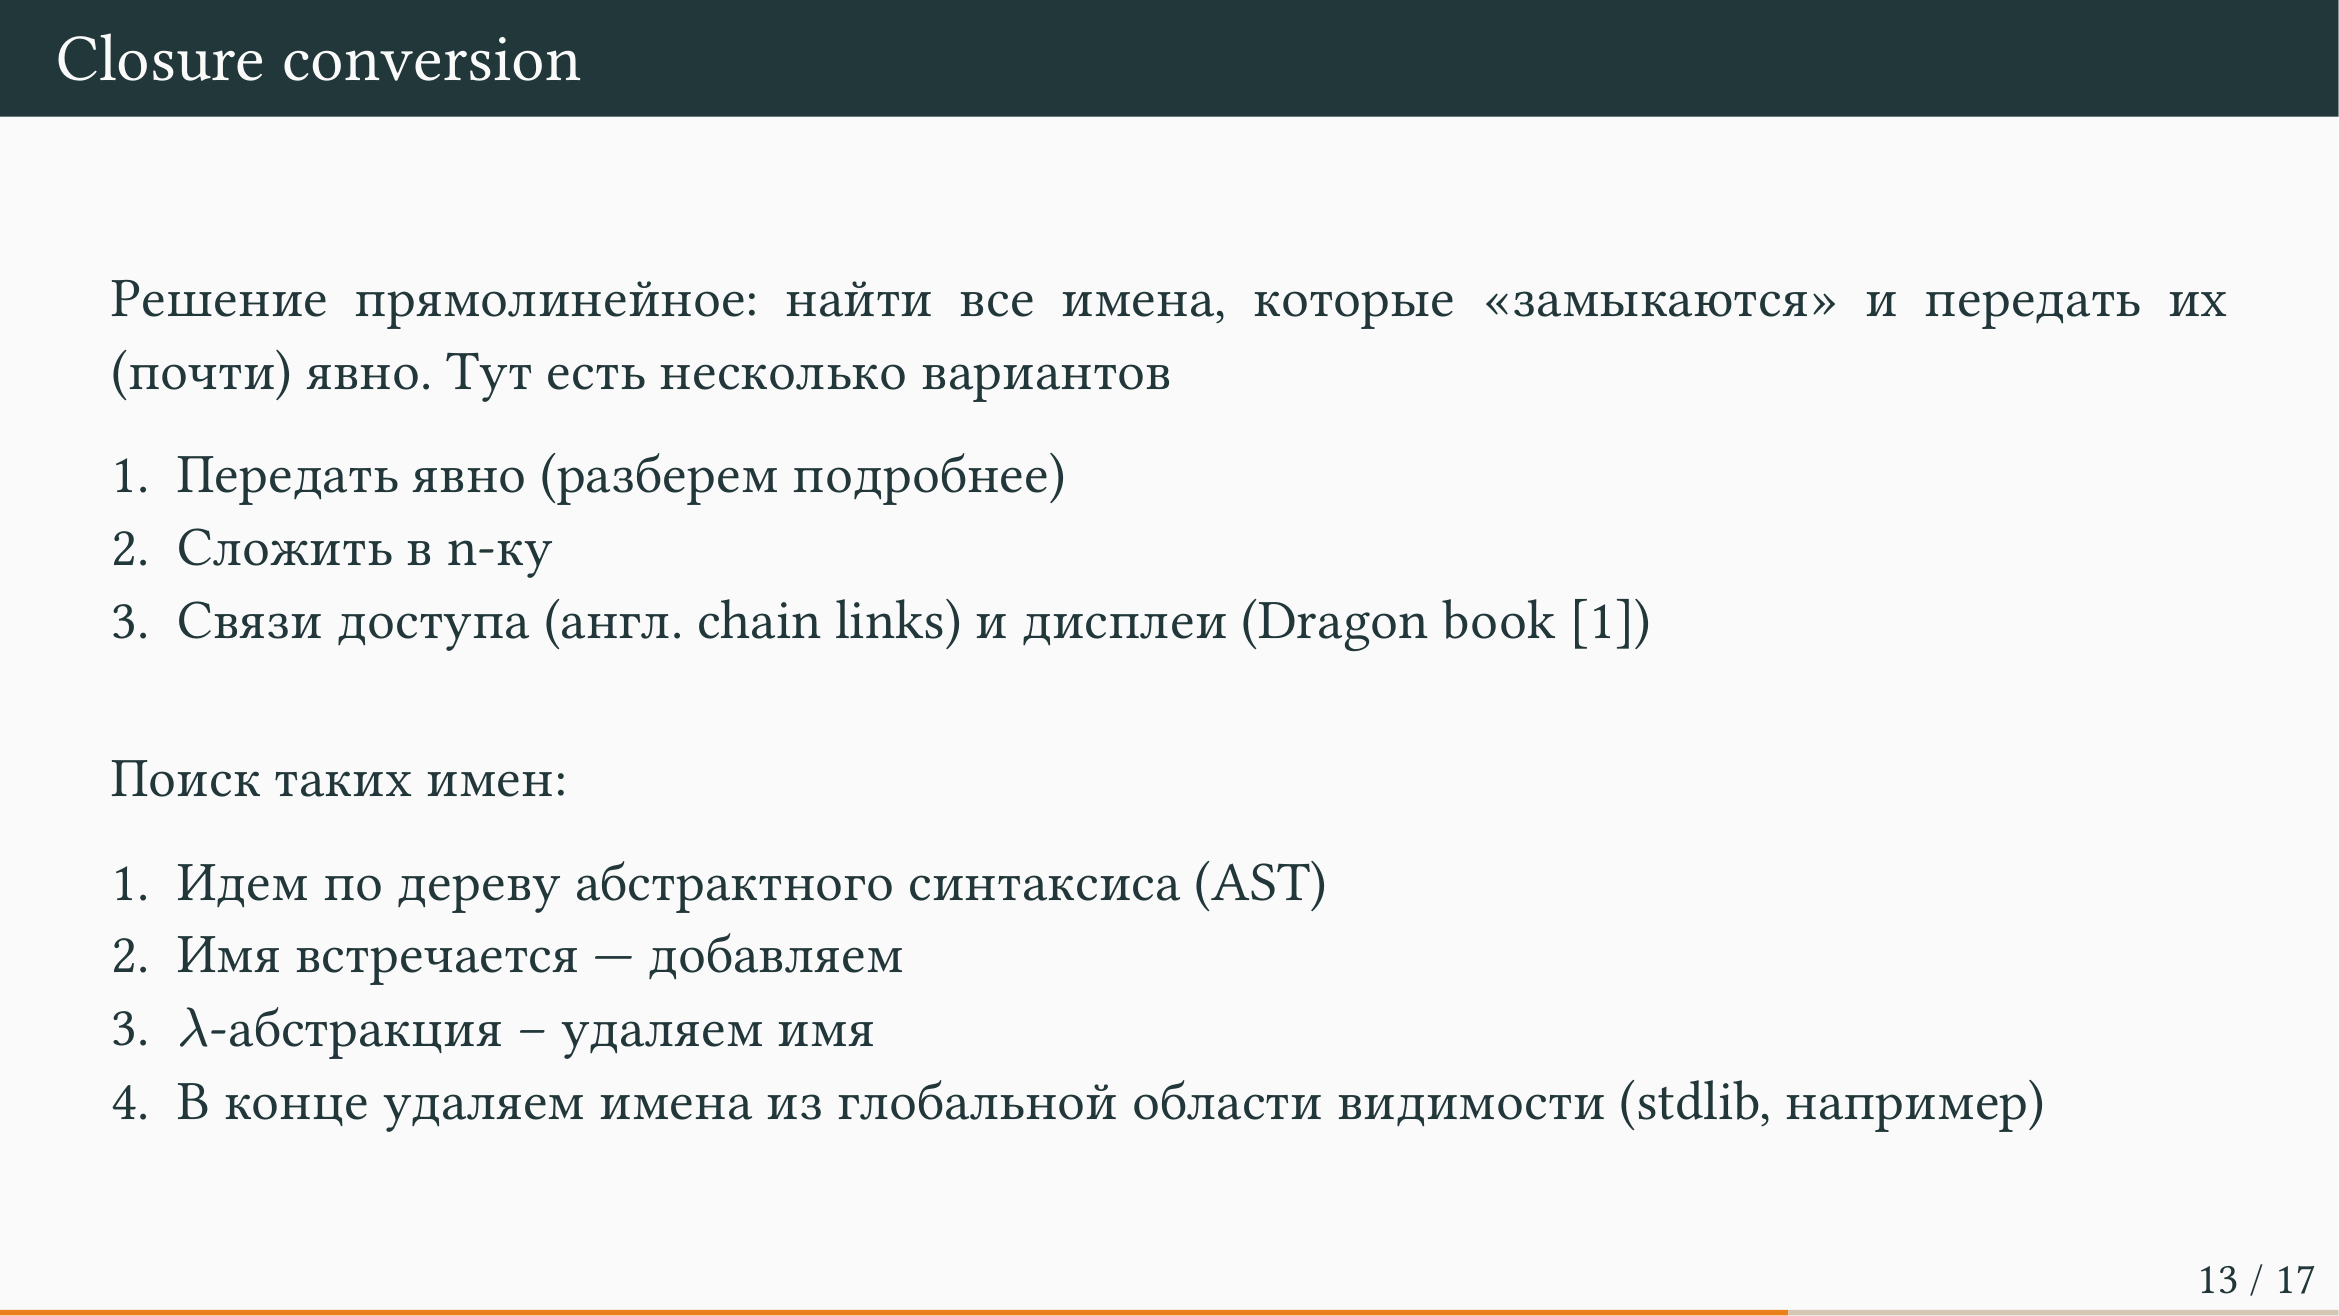
Рассмотрим способы передачи свободных переменных и представление замыканий. Прямолинейное решение заключается в том, чтобы найти все имена, которые «замыкаются», и передать их (почти) явно. Здесь есть несколько вариантов.
Первый вариант заключается в том, чтобы добавить пару аргументов функции, а в месте, где эта функция вызывается, передать на пару аргументов больше. Однако этот подход имеет существенный недостаток: если передать функцию много аргументов, то в современных компьютерах они скорее всего будут передаваться через стек. Например, в AMD64 через регистры передается около 6 аргументов, в ARM (в новых процессорах) пусть будет 8, а в старых пентиумах, наверное, вообще 4. Таким образом, большое количество аргументов приводит к замедлению работы.
Второй вариант заключается в том, чтобы все свободные переменные складывать в $n$-ку и эту $n$-ку передавать как один аргумент. Это лучше с точки зрения использования регистров, но имеет свои недостатки. Во-первых, в языке должны быть $n$-ки. Во-вторых, в языке должна быть куча, где эти $n$-ки будут аллоцироваться. Это превращает код уже не в код на условном OCaml, а во что-то промежуточное представление, в котором появляются замыкания. При этом становится непонятно, как эти $n$-ки отображаются в исходный язык, особенно когда они могут содержать внутри себя другие $n$-ки, которые могут быть замыканиями функций, объявленных выше. Из-за этого начинаются сложности.
Настоящие компиляторы работают иначе. Замыкание выделяется на куче, в нем хранится некоторое количество переменных, и к этой куче можно обращаться по некоторому смещению, чтобы брать оттуда значения. Через замыкание можно передавать нормальные аргументы, мутабельные аргументы и многое другое. Если передать мутабельные аргументы в виде указателя на кучу внутри замыкания и изменить их там, то они изменятся и в оригинальном месте своего появления, и все будет работать нормально.
Отступление от темы
Ах да. В книжке Dragon Book есть еще всякие дисплеи и чейн-ринки. Связи доступа, я не знаю, как это правильно переводить. Это выглядит стрёмно, но кажется, в Dragonbook так и перевели. Я вчера долго боролся, чтобы это выделение красным не съезжало в строке вниз, оказывается, она теперь заработала нормально. Я вообще не помню, почему, либо разобрался, потому что я с этой проблемой... и потому что это скомпилировано на другом компьютере, надеюсь, первое.
Такие механизмы, как связи доступа (англ. chain links) и дисплеи (описанные в Dragon Book), представляют собой вариацию на тему доступа к аргументам вышележащей функции из функций, которые объявлены внутри. Это актуально для алголоподобных языков, которые отличаются от функционального тем, что в них нет first-class функций (то есть их нельзя вернуть из функции), но можно объявлять функции внутри функций, и вложенная функция имеет доступ к аргументам охватывающей функции. Если вам придется когда-то писать компилятор, возможно, в этой книге вы найдете что-то полезное.
Отступление от темы
Пример. Пример. Примеры у нас в факториале... Который... В кач... вызов конечно было два свободных переменных... Ну ка, ну ка, да ладно...
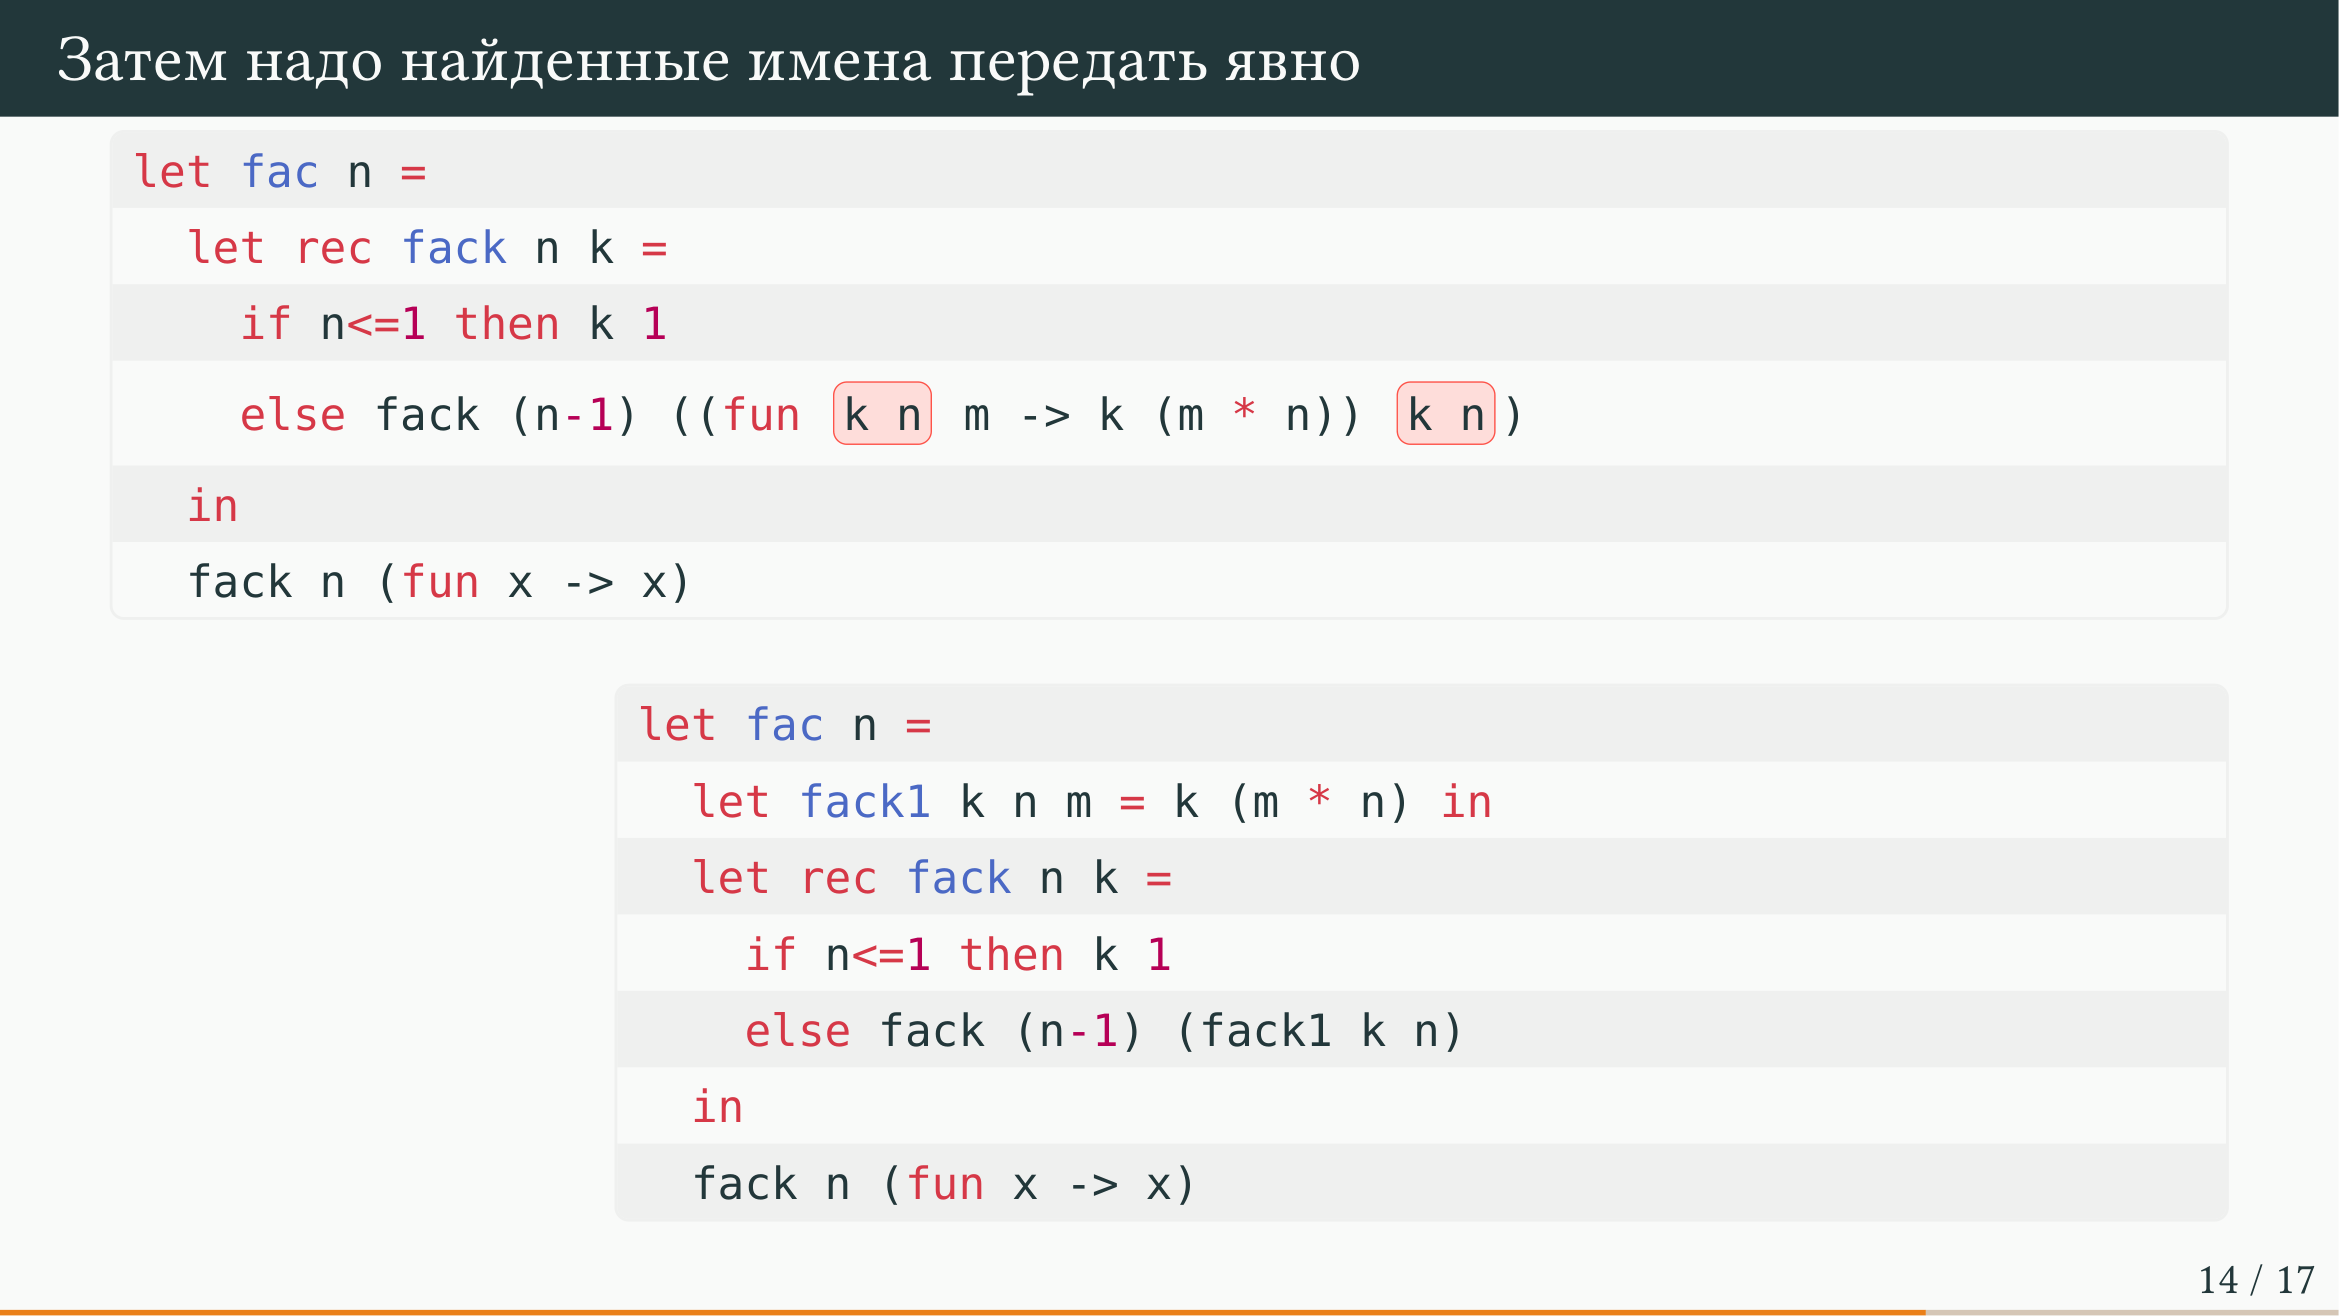
Как вы видите, для анонимной функции было сделано два дополнительных аргумента.
Пример преобразования функции и вопросы организации работы
Как вы видите, для анонимной функции были сделаны два дополнительных аргумента, и в том месте, где она вызывается, эти два аргумента были переданы. В результате получилась анонимная функция, которая ничего не принимает в качестве замыкания. То есть это обычная функция, которую можно вытащить из фактора с x. Получилась функция трех аргументов, которая берет и запускает первый аргумент на произведение второго и третьего, и никаких проблем нет. Таким образом происходит избавление от замыканий, но остается частичное применение. Обработка частичного применения должна быть сделана в рантайме. В рантайме вы будете принимать значение вашего мини-языка программирования.
Отступление от темы
Вы выбрали название для ваших языков. Я самую сложную задачу так и не спросил — название придумать? Вам же командно на него нужно как-то писать? Я помню, что в прошлые годы люди довольно часто повторяются в названиях, то есть фантазии довольно мало, обязательно кто-то повторится. Вы, главное, не называйте свой мини-язык каким-нибудь именем, которое уже застолблено. Называть подмножество какого-нибудь языка — это плохая идея. Вот, мол, тоже muSQL — тоже плохая идея. Чем вы смеетесь? Да, это какая-то вариация Standard ML, который разрабатывали в 90-е, вот так вот. А я просто ожидаю, что вы сделаете pull request, в котором вы запишетесь в файлик с названиями ваших компиляторов. Учитывая, что задание на данный момент не выложено, вопрос останется без ответа. Вот в те годы нужно было... просто желательно это сделать просто одним pull request-ом, потому что если вы всей толпой начнете изменять один файл, начнутся конфликты. Но вы знаете, у питонистов, когда они впервые поступали на первый курс — какая интересная формулировка! — давали задание на git попробовать групповым образом поменять один и тот же файл игрести конфликты. Я не знаю, дают ли сейчас это питонистам, вот питонистам раньше давали, так сказать, ознакомительная задача по гиту. Вот вы понимаете, в чем проблема? А что, если вы всей толпой поменяете YAML-файл, наверняка будут какие-то конфликты, и задача их решать — это задача ваша, не моя. Вы же то самое через два года будете дипломированными специалистами, закончив математико-механический факультет, программная инженерия. Между строк: знает, как запускать OpenCode.
> [!tangent]- Отступление от темы
> Текст болтовни/оффтопа здесь.
> Каждая строка начинается с "> ".
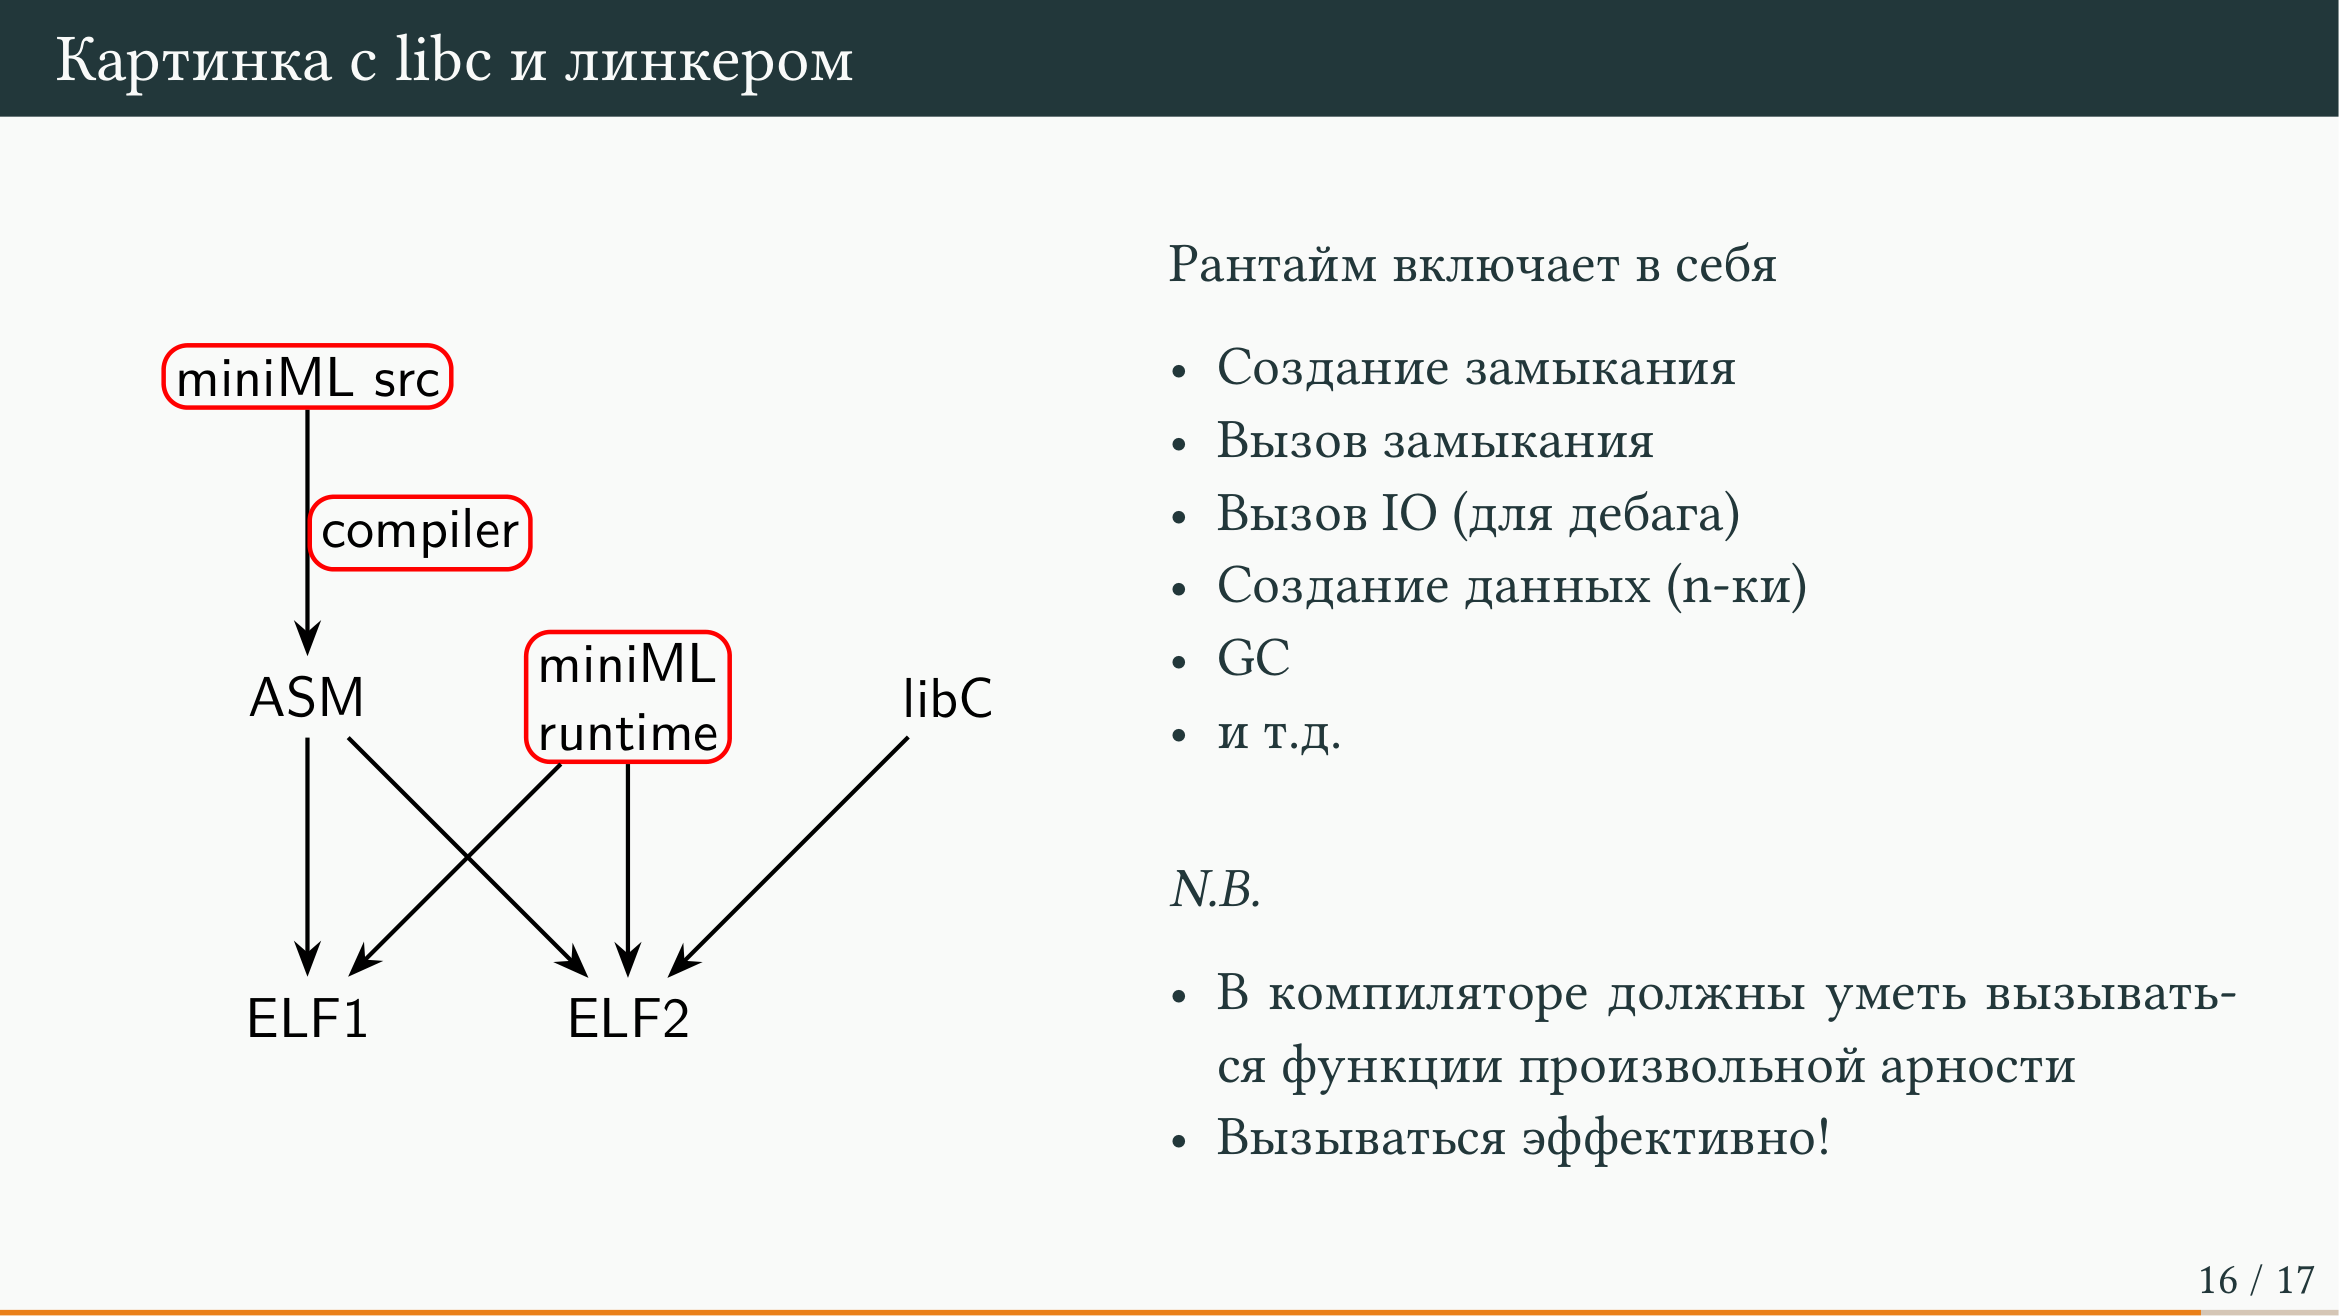
Генерация целевого кода и рантайм-поддержка
Преобразования кода: Closure Conversion и Lambda Lifting
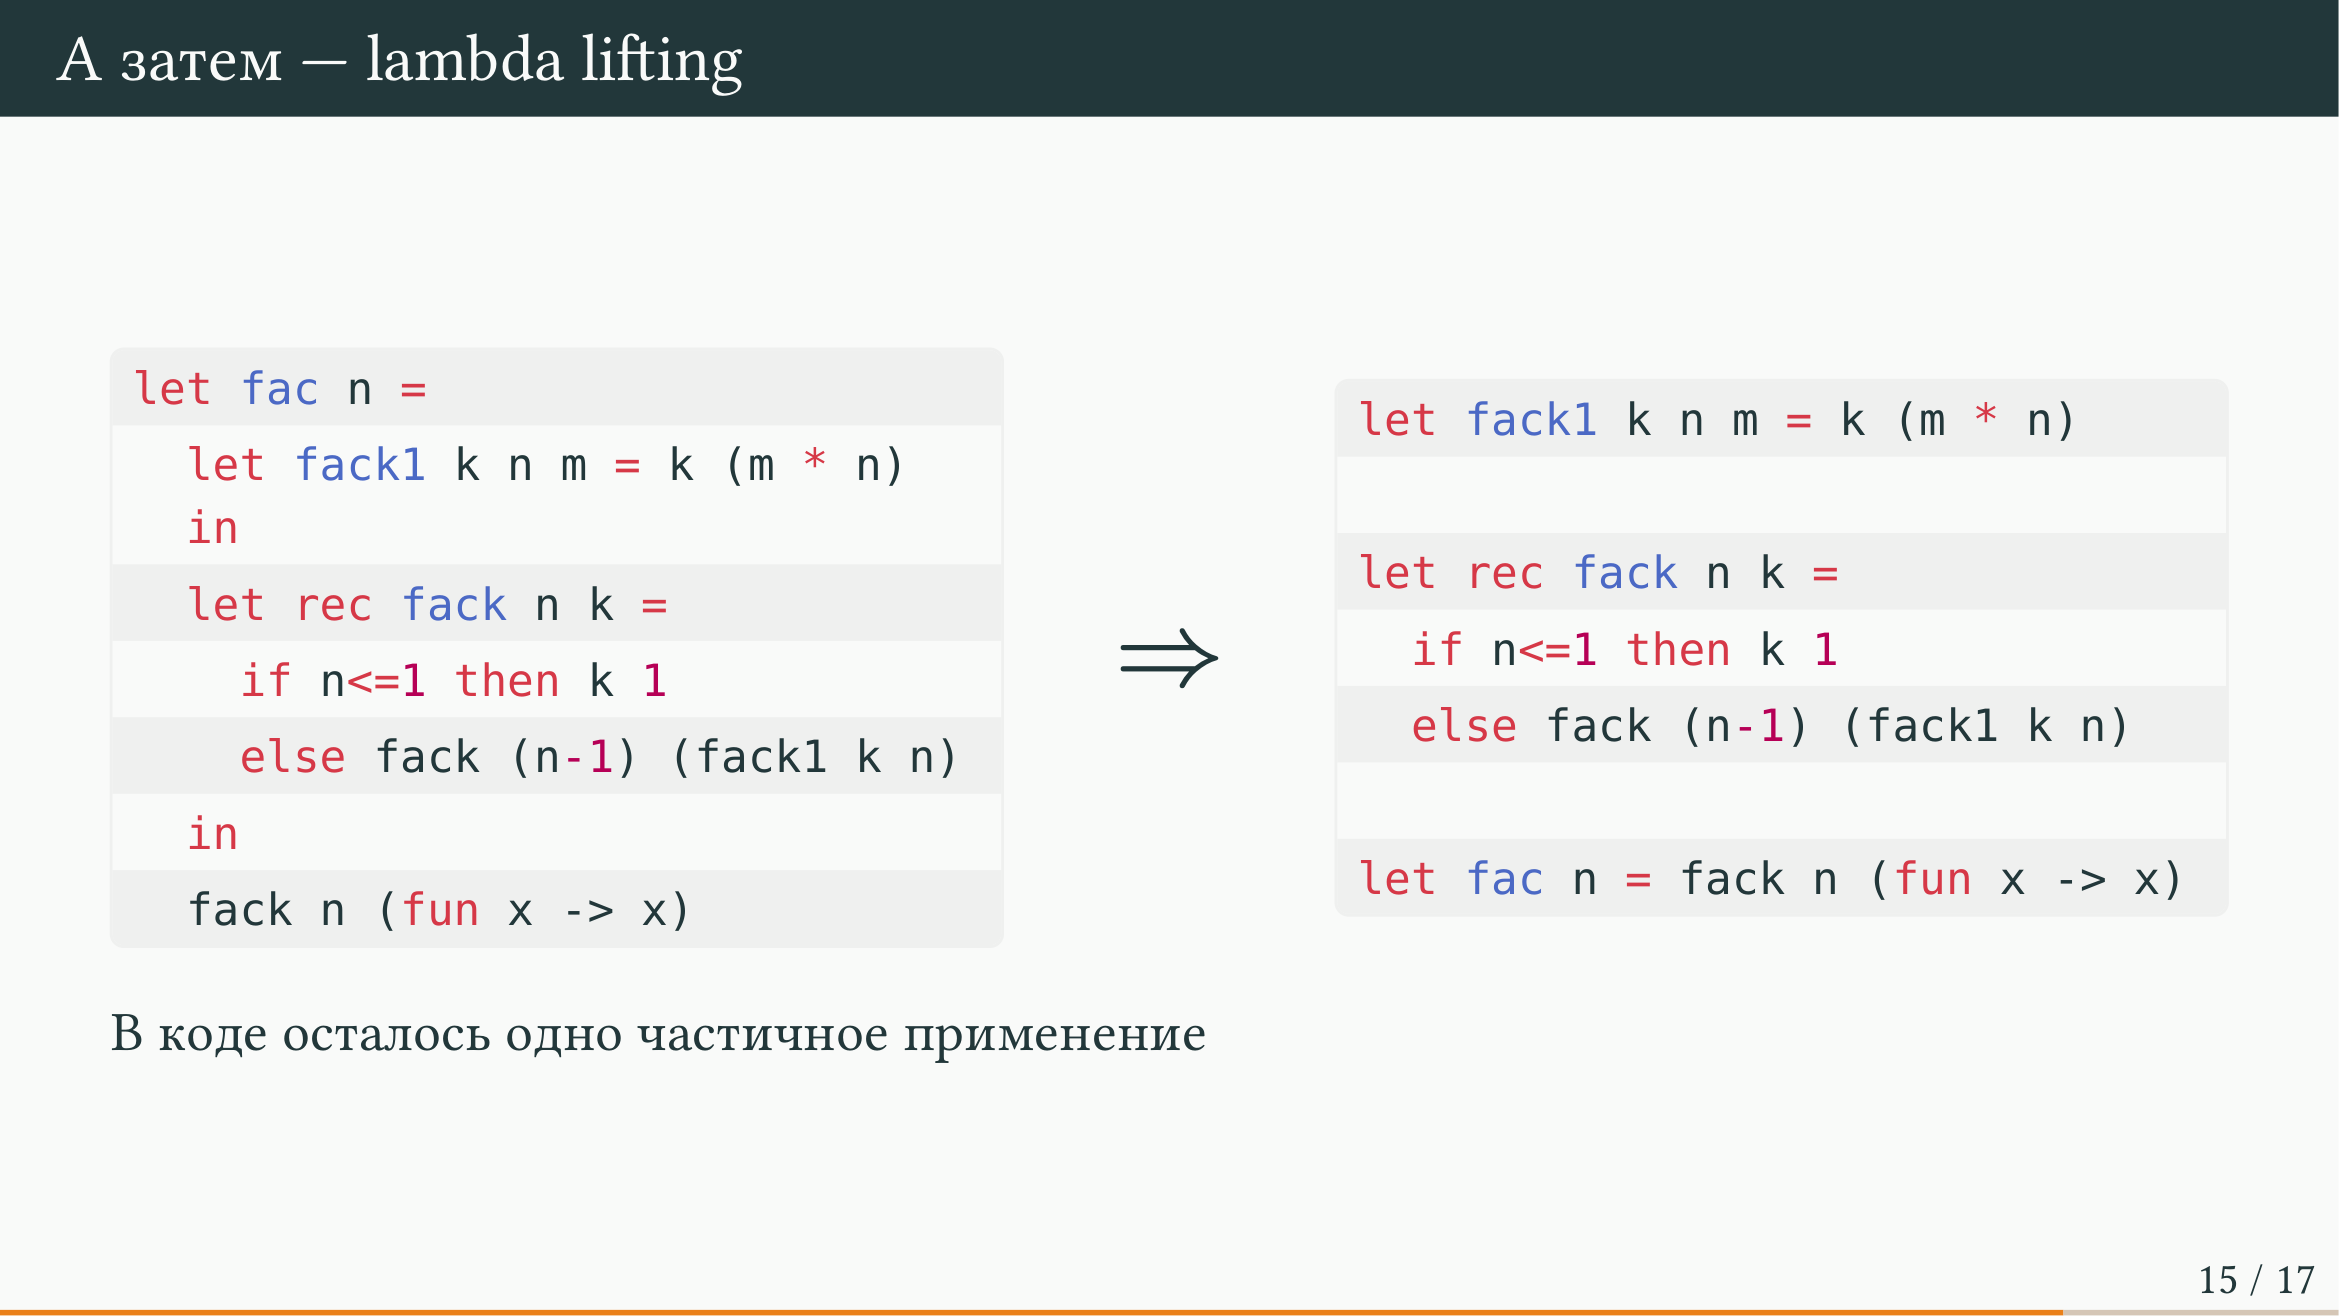
Так вот, мы берем, делаем closure conversion (конвертацию замыканий): дописываем в анонимные функции кучу аргументов, после чего анонимные функции перестают быть замыканиями. Грубо говоря, они начинают использовать пустое замыкание. Если замыкание пустое, это можно описать в самом верху файла на верхнем уровне, как на Си. Значит, мы можем сделать так называемый lambda lifting (лямбда-лифтинг), и все вложенные функции, а также все анонимные функции, которые только что стали вложенными, сделать верхнеуровневыми. И в итоге факториал, который запускал continuation и identity, использовавшиеся, чтобы превратить факториал с континуациями в обычный человеческий факториал со стрелочным типом Int -> Int, плюс еще вот эти анонимные и вложенные функции вы делаете на верхнем уровне. И это начинает выглядеть как код, который можно написать на Си, потому что никаких функций анонимных по дороге не объявляется, никаких замыканий нет, вы это пишете вот так вот, а дальше вы это можете отправить в ассемблер, вы можете
Генерация C-кода и Ассемблера компиляторами
Полученный код вы можете отправить в ассемблер, а можете превратить в код на Си. Некоторые компиляторы не занимаются рождением ассемблера, они занимаются генерацией кода на Си и говорят, что сделали переносимый язык за счет того, что порождают Си-код. Работает она так, но им приходится тянуть за собой все особенности Си, которые есть в языке Си, отойти от него будет не так просто. Она работает, вы делаете вот такие штуки, вы делаете closure conversion, вы делаете lambda lifting, и всё становится более похожим на ассемблер, вы тем дальним этапом порождаете код на ассемблере и получаете скомпилированный вариант вашего факториала, записанного в форме CPS. Потому что если вы просто пишите факториал как рекурсивную функцию, то вот этот lambda lifting и closure conversion не нужны, потому что анонимных лямбд нет и замыканий тоже. Про diff assembler он, скорее всего, работает, ну, по модулю того, что вы
Реализация частичного применения и рантайма
Реализация частичного применения и ранتاйма работает следующим образом. Для реализации замыканий и частичного применения необходимо аккуратно написать рантайм. Сделать это не так сложно: вы храните указатель на код, формальную арность, а также частично примененные аргументы в небольшом массивчике. Как только количество собранных аргументов приближается к формальной арности, происходит вызов функции. Указатель на код есть, в качестве функции передаются аргументы с соблюдением выбранного соглашения о вызовах, после чего код запускается и работает. Конечно, код нужно написать сильный; в прошлые годы студенты иногда писали на Rust или спрашивали про возможность использования Zig.
Отступление от темы
короче если вы настроитесь а это да вот теперь а теперь а теперь я хочу сходить попить чаю распечатать световую точку которая проверяет посещаемость и закончить ну короче слайды дальше не интересно Сейчас.