Конспект лекции
БД Лекция 1
Введение в курс и его программа
Введение, организационные вопросы и об авторе
Отступление от темы
Так, сейчас видно? Да. Ну, отлично. Если вдруг меня там перестанет быть слышно, или перестанет быть видно презентацию, вы мне, пожалуйста, как-нибудь маякните, и я постараюсь отреагировать. Каждая строка начинается с "> ".
Итак, курс у нас называется «Базы данных у магистрантов». Я буду говорить «магистранты», «магистры» попроще. У магистров этот курс называется «Системы управления базами данных». Мы поговорим на нашем курсе и про базы данных, и про системы управления базами данных, то есть ничего не обделим вниманием. А у бакалавров, если я ничего не путаю, курс называется «Основы баз данных».
Немножко информации обо мне. Я являюсь старшим преподавателем кафедры системного программирования нашего любимого факультета СПбГУ. Прошел я в свое время разнообразный путь, такой вот интересный: был разработчиком, потом ушел в архитектуру, потом меня занесло в управление. Управлял различными проектами, программными портфелями и так далее. После этого я являлся руководителем направления искусственного интеллекта одной из дочек Ростелекома, и в настоящее время я являюсь руководителем направления разработки программного обеспечения в компании «Газпромнефть Цифровые решения».
Отступление от темы
Здесь приведены мои контакты, можно мне, если у вас возникают какие-то вопросы, и вы не дописываетесь, я вам не отвечаю в телеге, но могу там и пропустить сообщения, много их обычно приходит. Пишите на почту, я тогда увижу, что кто-то мне написал, и, наверное, где-то что-то пропустил. Лучше пока писать на личную почту, потому что корпоративную почту каждый год надо активировать, и я пока до этого вопроса еще не добрался. Ну, это я, в принципе, вам уже все сказал.
В конце будет устный экзамен. Курс состоит из лекционных и практических занятий, проходит одна пара лекций в неделю. Для бакалавров еще раз подчеркну, что допуск к экзамену выдается по результатам практики. Об остальном вам уже сказали, но вот также можете писать мне в личку.
Программа курса и основные темы
Отступление от темы
в личку. Что будет у нас на нашем курсе?
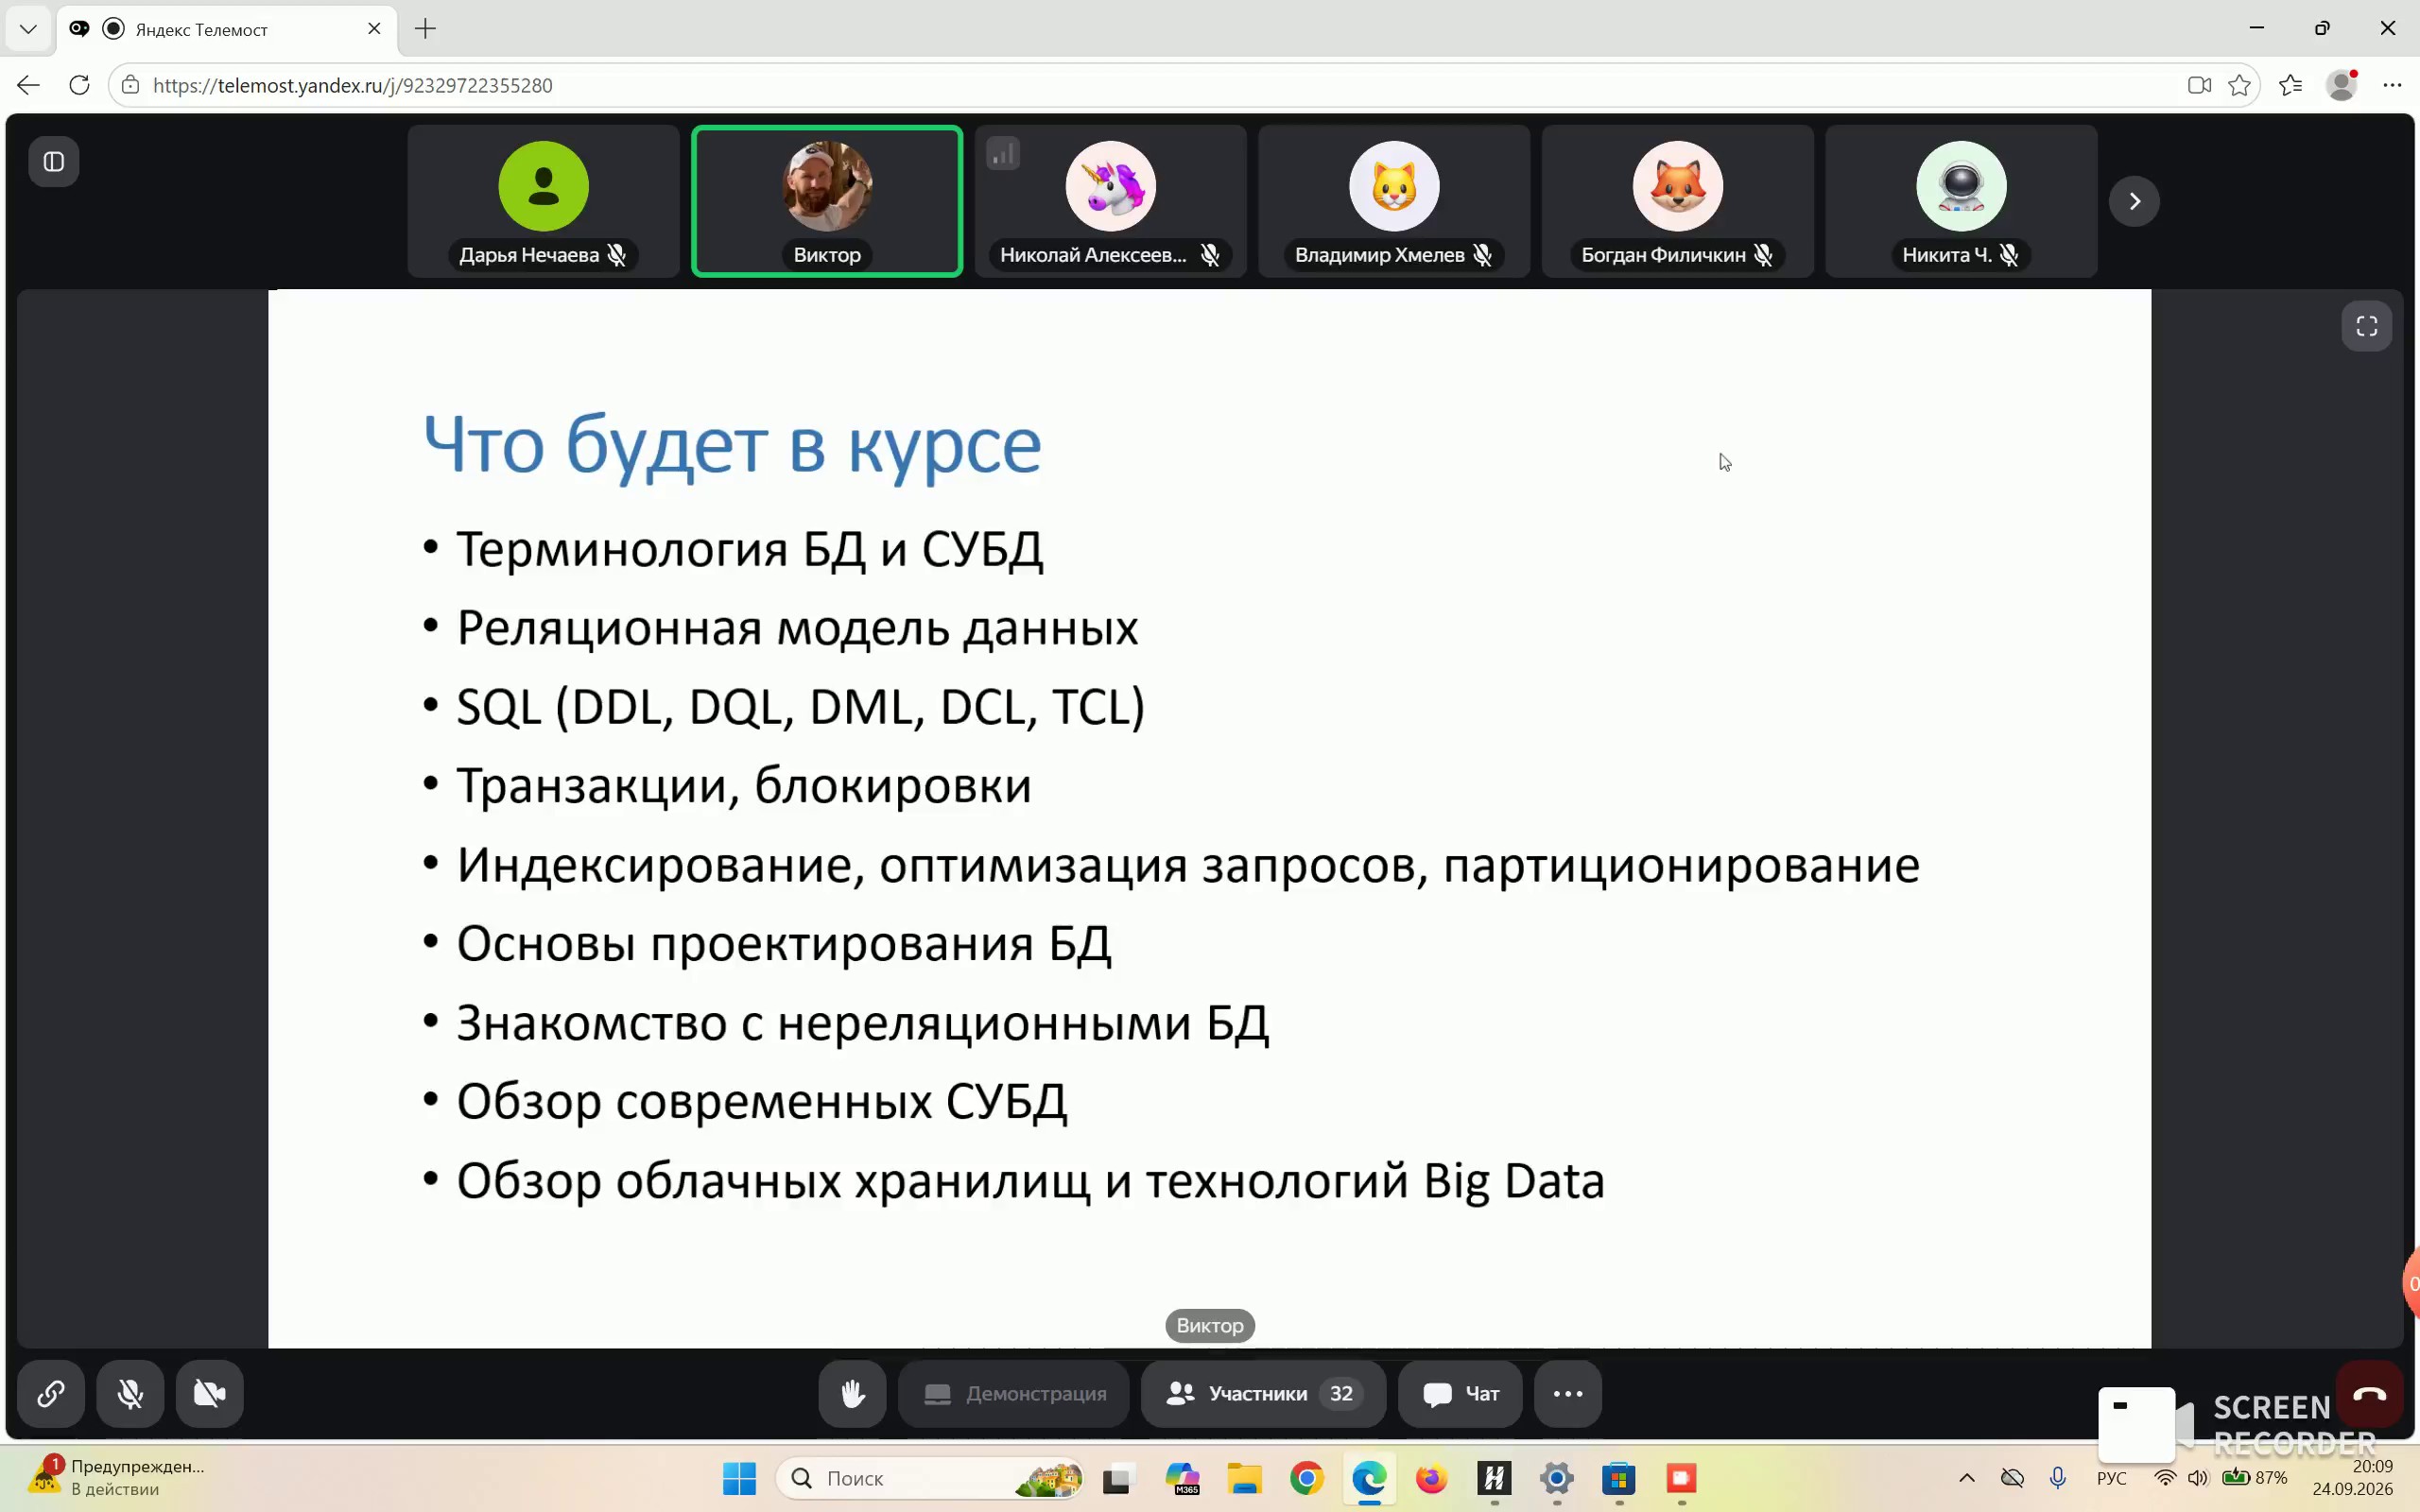
Мы с вами осветим некоторые аспекты, связанные с терминологией баз данных и системами управления базами данных. Мы поговорим о реляционной модели данных. Но вообще, тот курс по основам баз данных не предполагает знакомство с нереляционными базами данных, но я вам про них всё равно расскажу, потому что это надо знать, это интересно, и где это сейчас используется. Мы поговорим про язык SQL в целом, про его подязыки и подмножества языка SQL, каждый из которых является по сути отдельным языком. Мы поговорим достаточно основательно про транзакции и блокировки. Мы, конечно же, затронем вопрос индексирования, оптимизации запросов и профилирования. Мы поговорим про основы проектирования баз данных. Как я уже сказал вам, познакомимся с нереляционными базами данных. Ну и уже ближе к концу нашего курса более конкретно затронем определенные современные системы управления базами данных. Будет у нас также обзор облачных хранилищ, технологий Big Data. И еще некоторые интересные вещи я вам тоже постараюсь рассказать.
Цели обучения: знания и навыки после курса
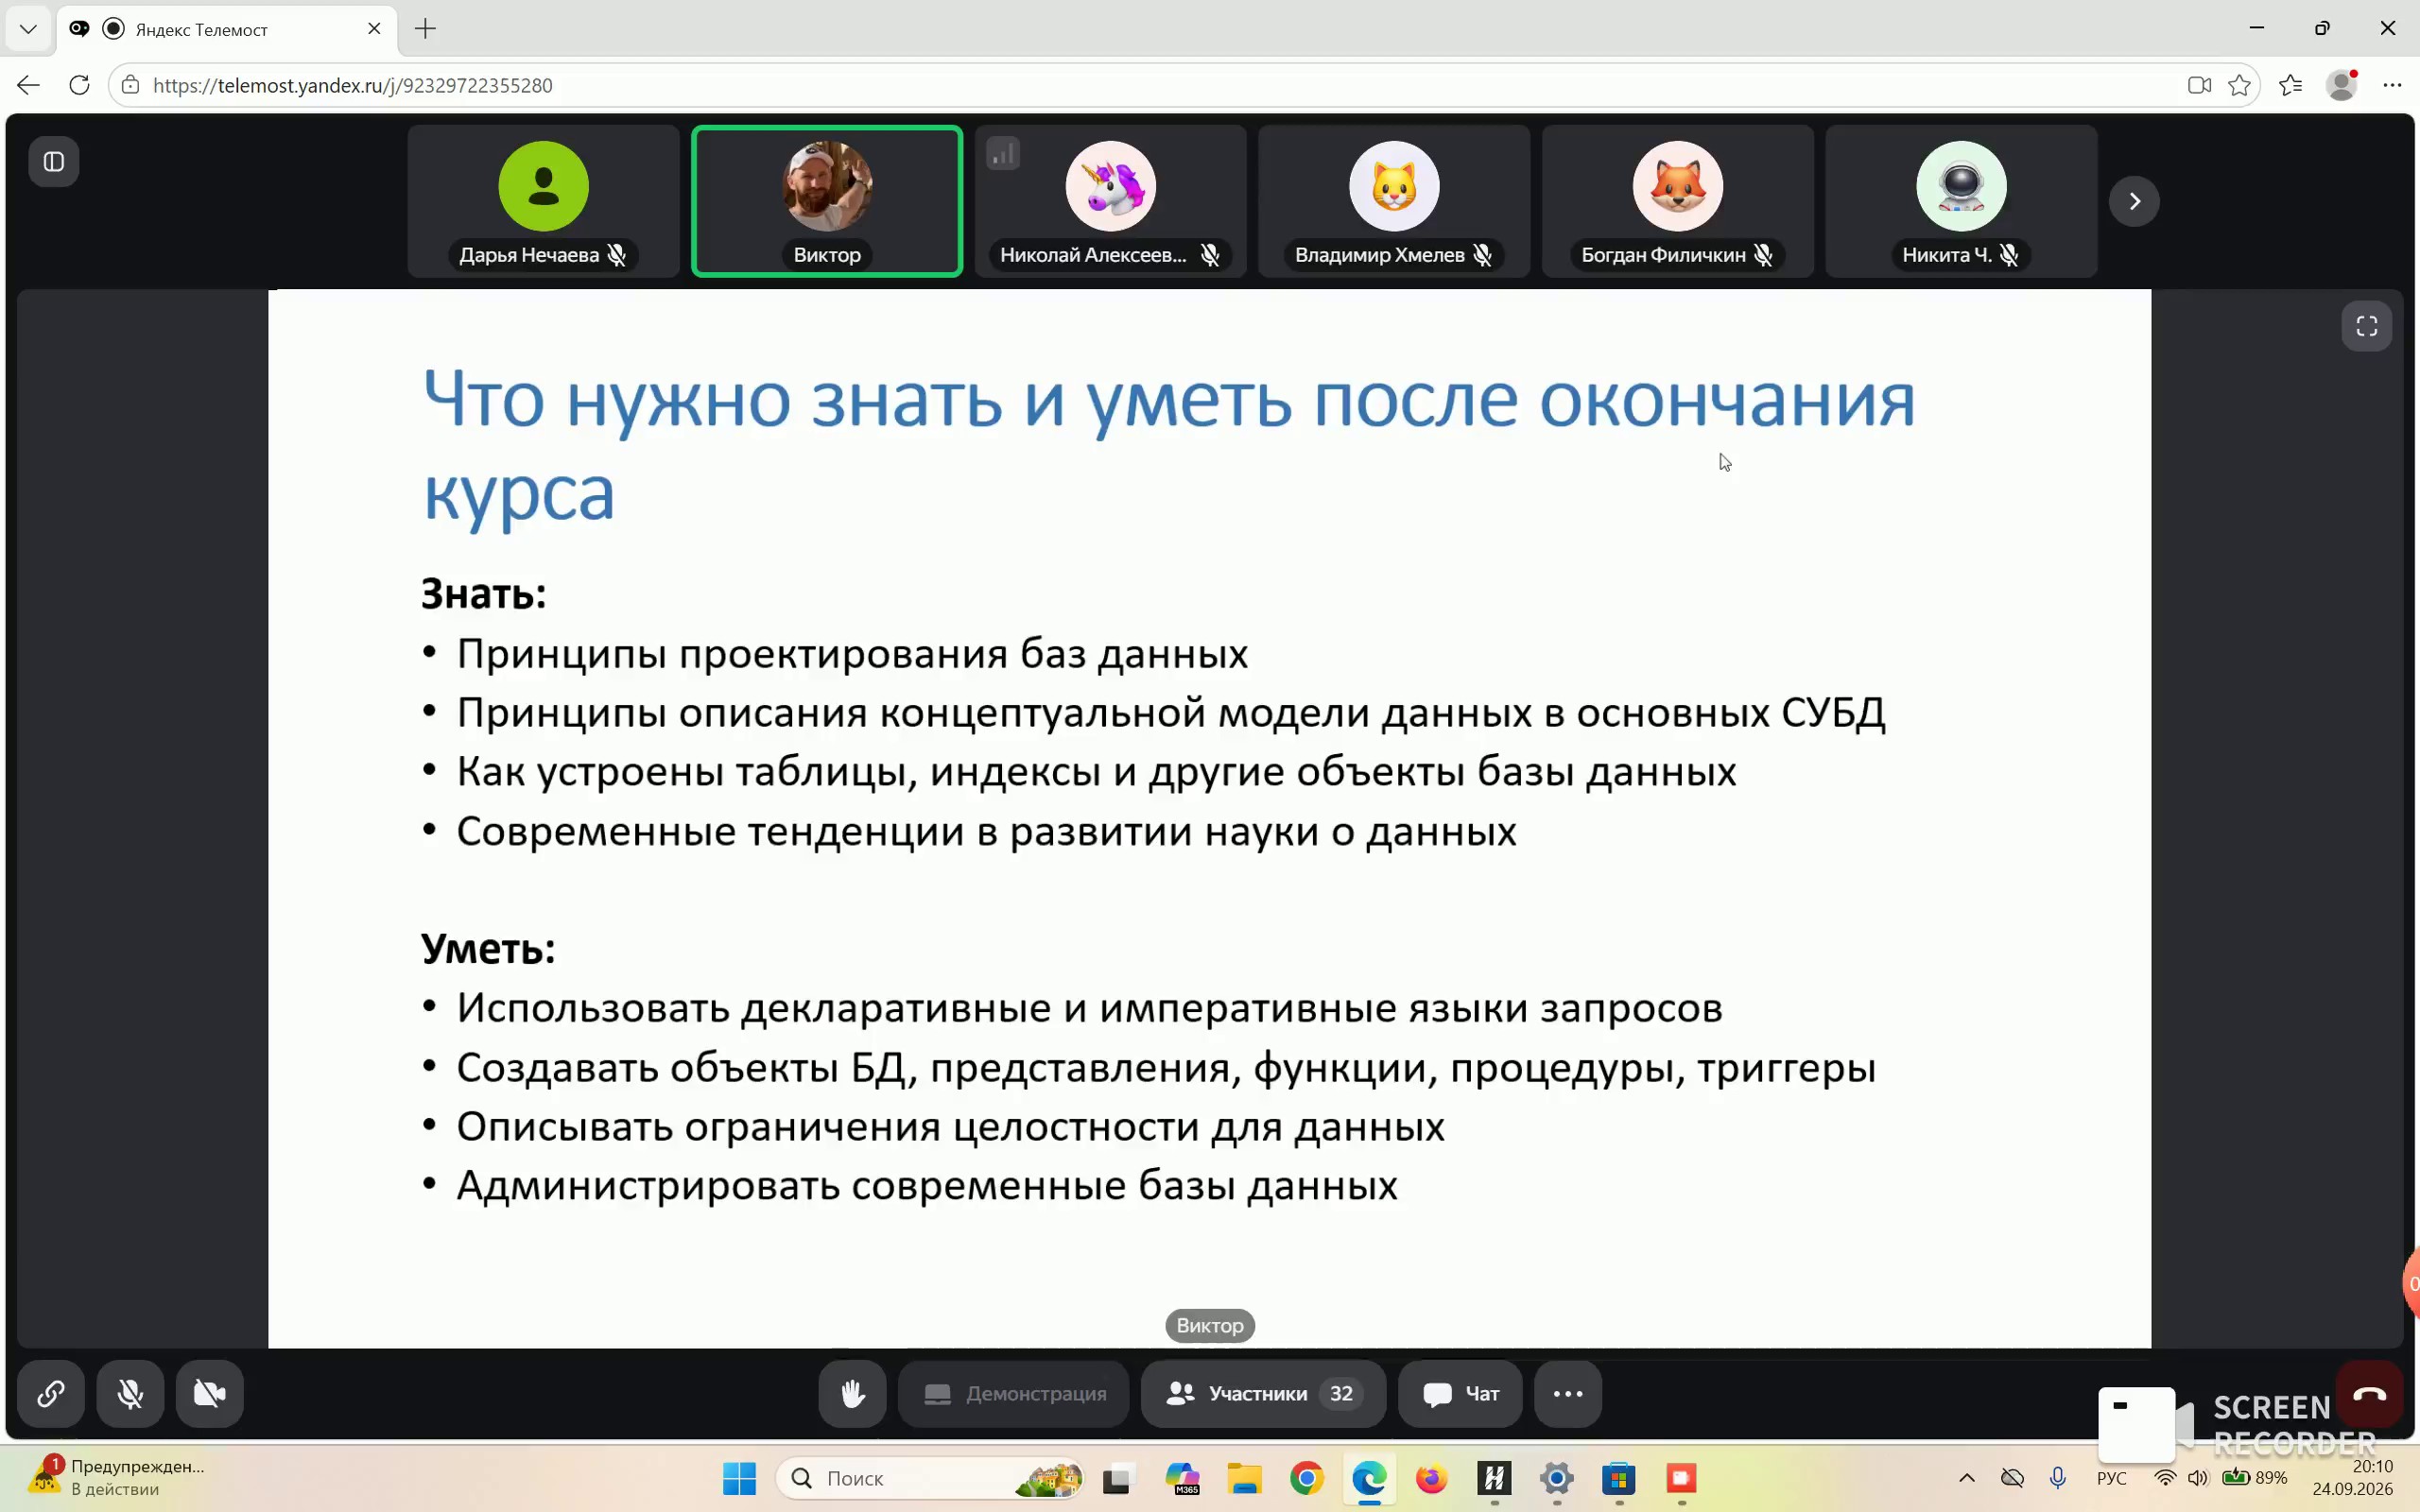
Что нужно знать и уметь после окончания курса? После прослушивания курса по базам данных необходимо знать принципы проектирования баз данных и то, как это происходит на различных этапах. Нужно знать принципы описания концептуальной модели данных в основных СУБД, а также то, как устроены таблицы, индексы и другие объекты базы данных. Кроме того, необходимо знать современные тенденции в развитии науки о данных, в частности, облачные данные и Big Data.
Что касается практических навыков, нужно уметь использовать различные декларативные и императивные языки запросов, создавать объекты базы данных, такие как представления, функции, процедуры, триггеры и другие. Нужно уметь описывать ограничения целостности для данных, и, конечно же, нужно понимать, как происходит администрирование современных СУБД, то есть работа с различными пользователями, правами, резервным копированием и так далее. Всё это представляет собой стандартные вещи, которые необходимо знать и уметь после того, как вы прослушаете этот курс по базам данных.
Рекомендуемая литература по СУБД и SQL
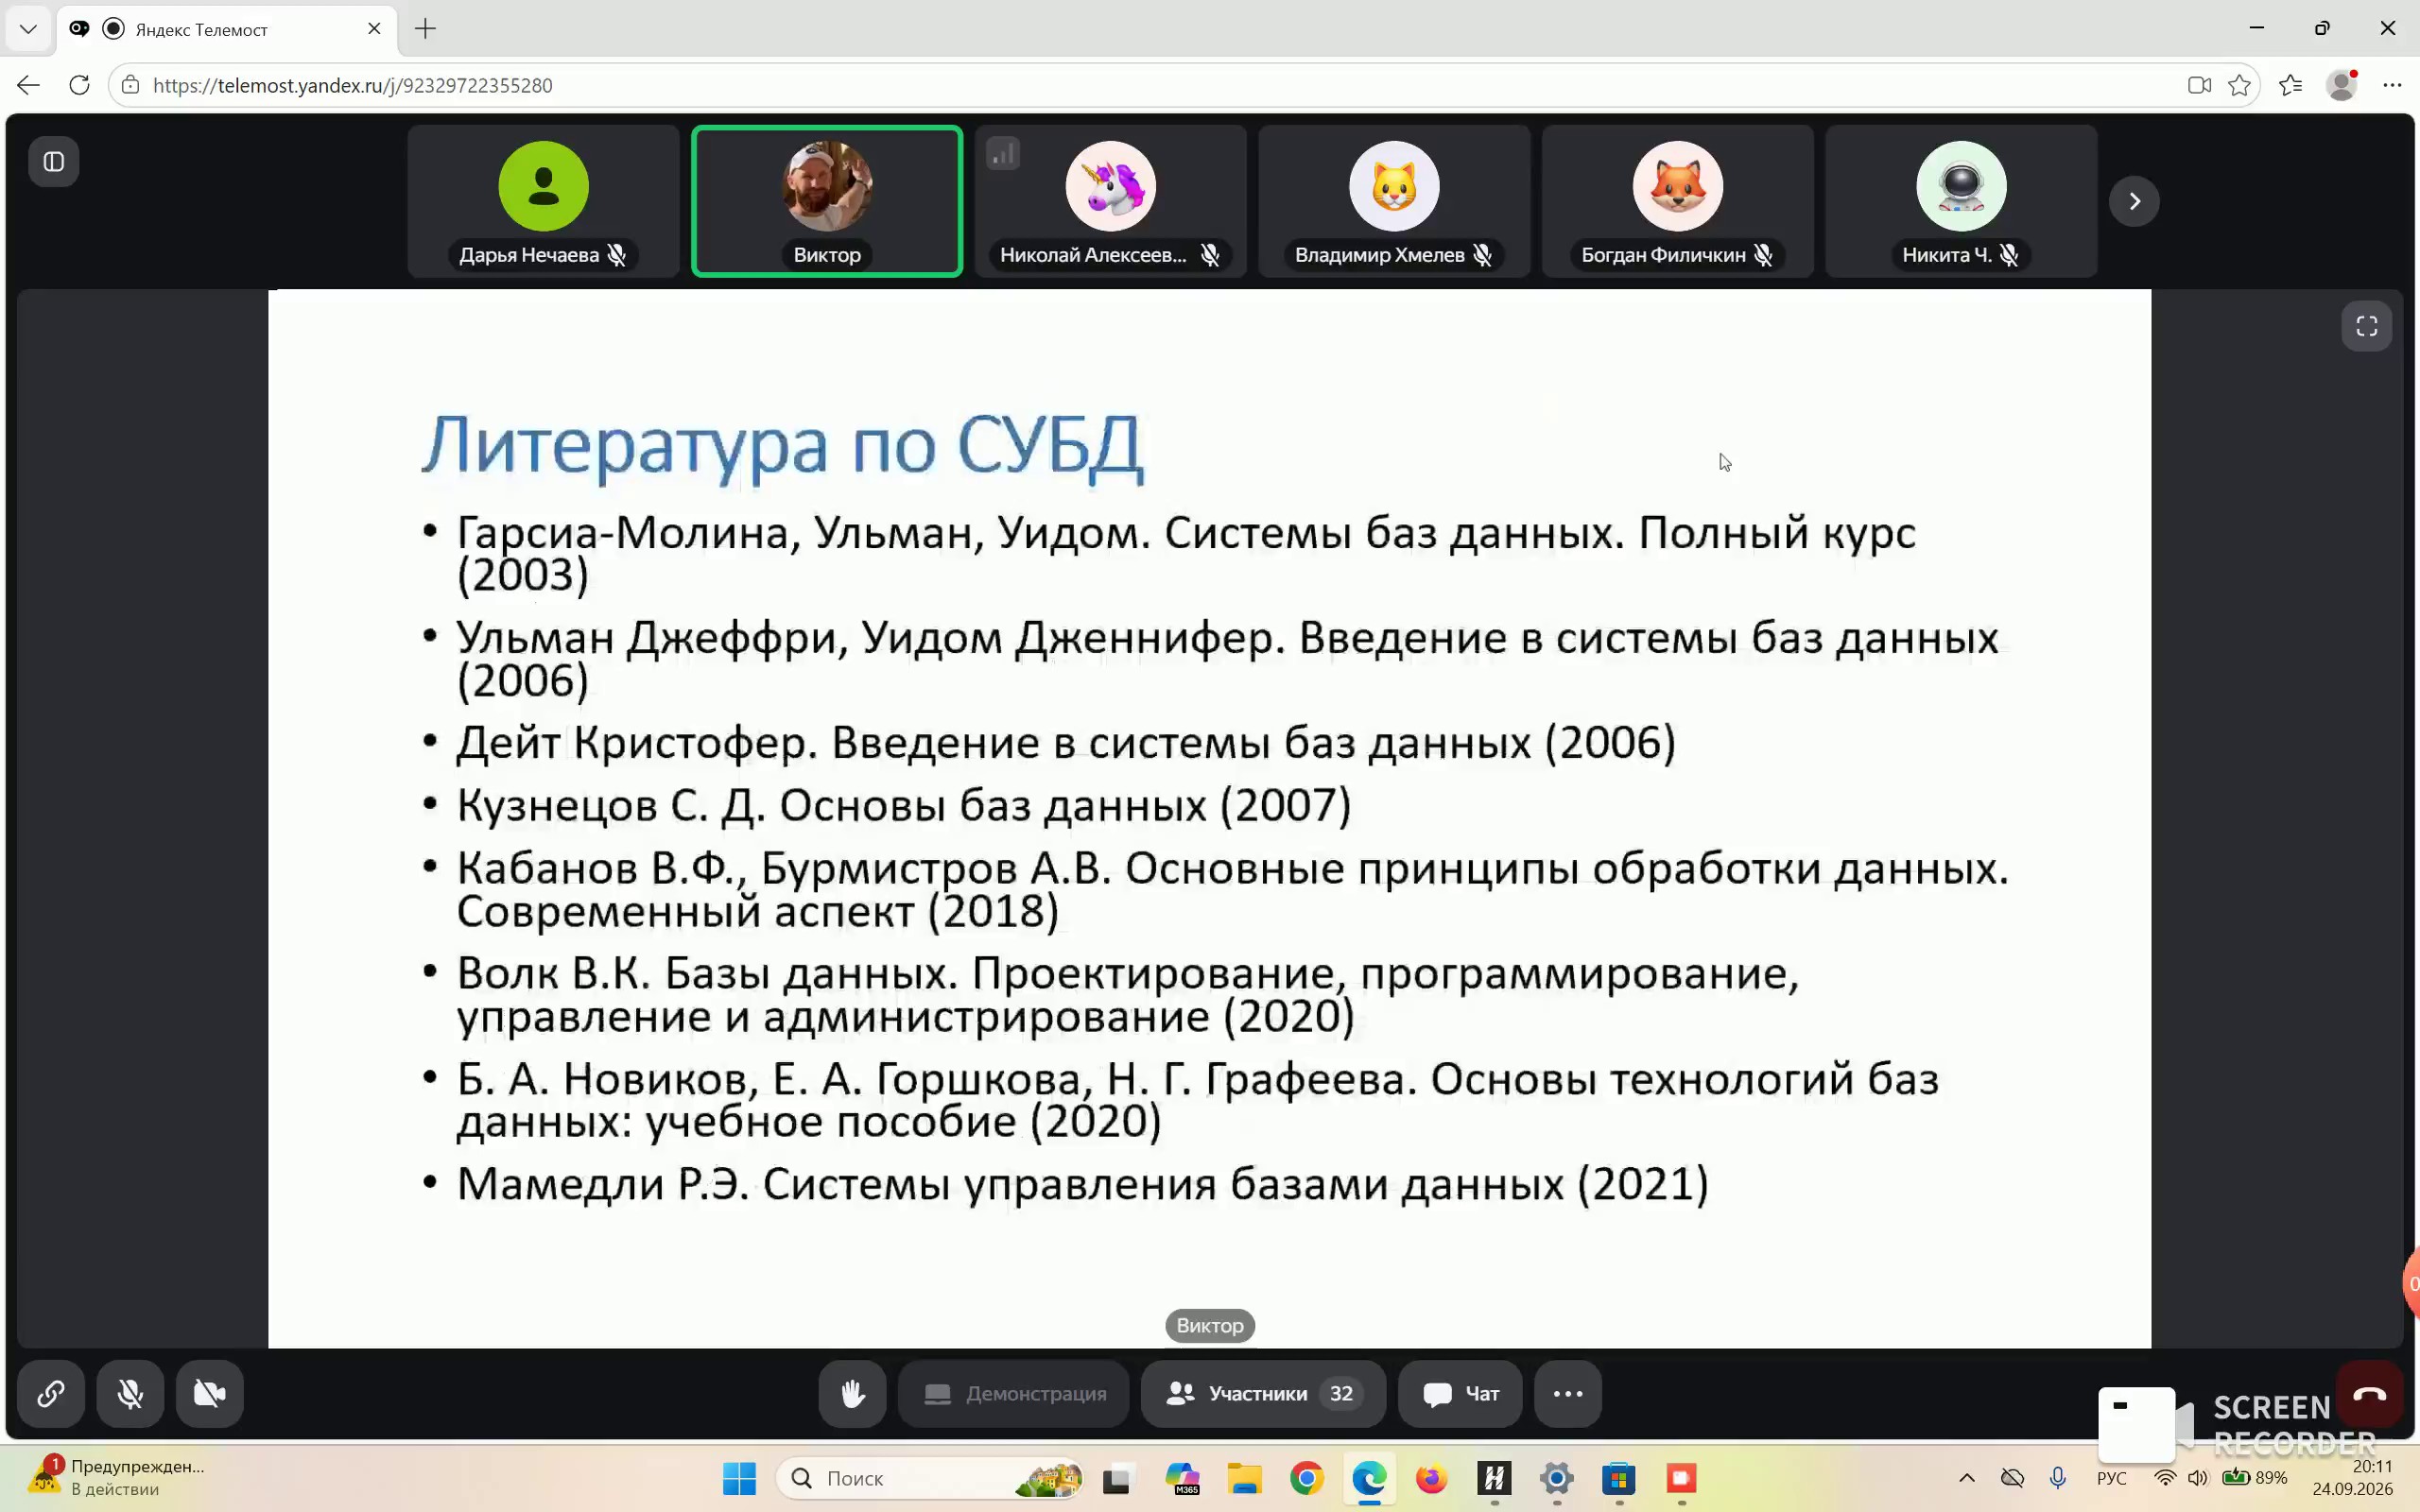
На данном слайде приведена литература по системам управления базами данных. Первая книжка является фундаментальной классикой по устройству теории баз данных. Книга «Дэйта» – это классика по реляционной модели. Дальше приведены тоже некоторые книжки, которые, на мой взгляд, стоит полистать, почитать хотя бы по диагонали и получить какое-то представление о том, что же такое база данных. Помимо нашего курса я вам настоятельно рекомендую ознакомиться с этой литературой, как я сказал, хотя бы по диагонали, и получить какое-то представление помимо моих лекций.
Также помимо литературы по базам данных я привожу здесь литературу по языку структурированных запросов. Такие тоже, наверное, многим знакомые книжки здесь представлены.
Отступление от темы
вот конечно же есть и другие интересные хорошие книжки на вот по различным диалектом на языка искренно [возможная ошибка распознавания: на языке SQL] вот что вам нравится то берите и читать изучать и вот но особое внимание я все-таки сейчас уделил по сгрессу [возможная ошибка распознавания: по PostgreSQL] вот всеми любимым нами импортозамещением в том числе да и соответственно как-то обратим на это на эту но с тем управление базами данных [возможную ошибку распознавания: систему управления базами данных] внимание
Начнем мы изучение баз данных с
Понятие и эволюция информационных систем
Понятие и определения информационной системы
Изучение баз данных начинается с понятия информационных систем, поскольку база данных является подмножеством информационной системы. Развитие баз данных неразрывно связано с развитием информационных систем. Если посмотреть на определения информационных систем, становится понятно, что они необходимы для взаимодействия с пользователем, обработки данных и их хранения.
Простое определение информационной системы звучит как программно-аппаратное решение, обеспечивающее надежное хранение информации, обработку информации, специфическую для данного приложения (поскольку каждое приложение работает со своими специфическими данными), и предоставление пользовательского интерфейса для доступа к ним. Таким образом, работу информационной системы можно кратко описать тремя ключевыми функциями: сохранение, обработка и представление данных.
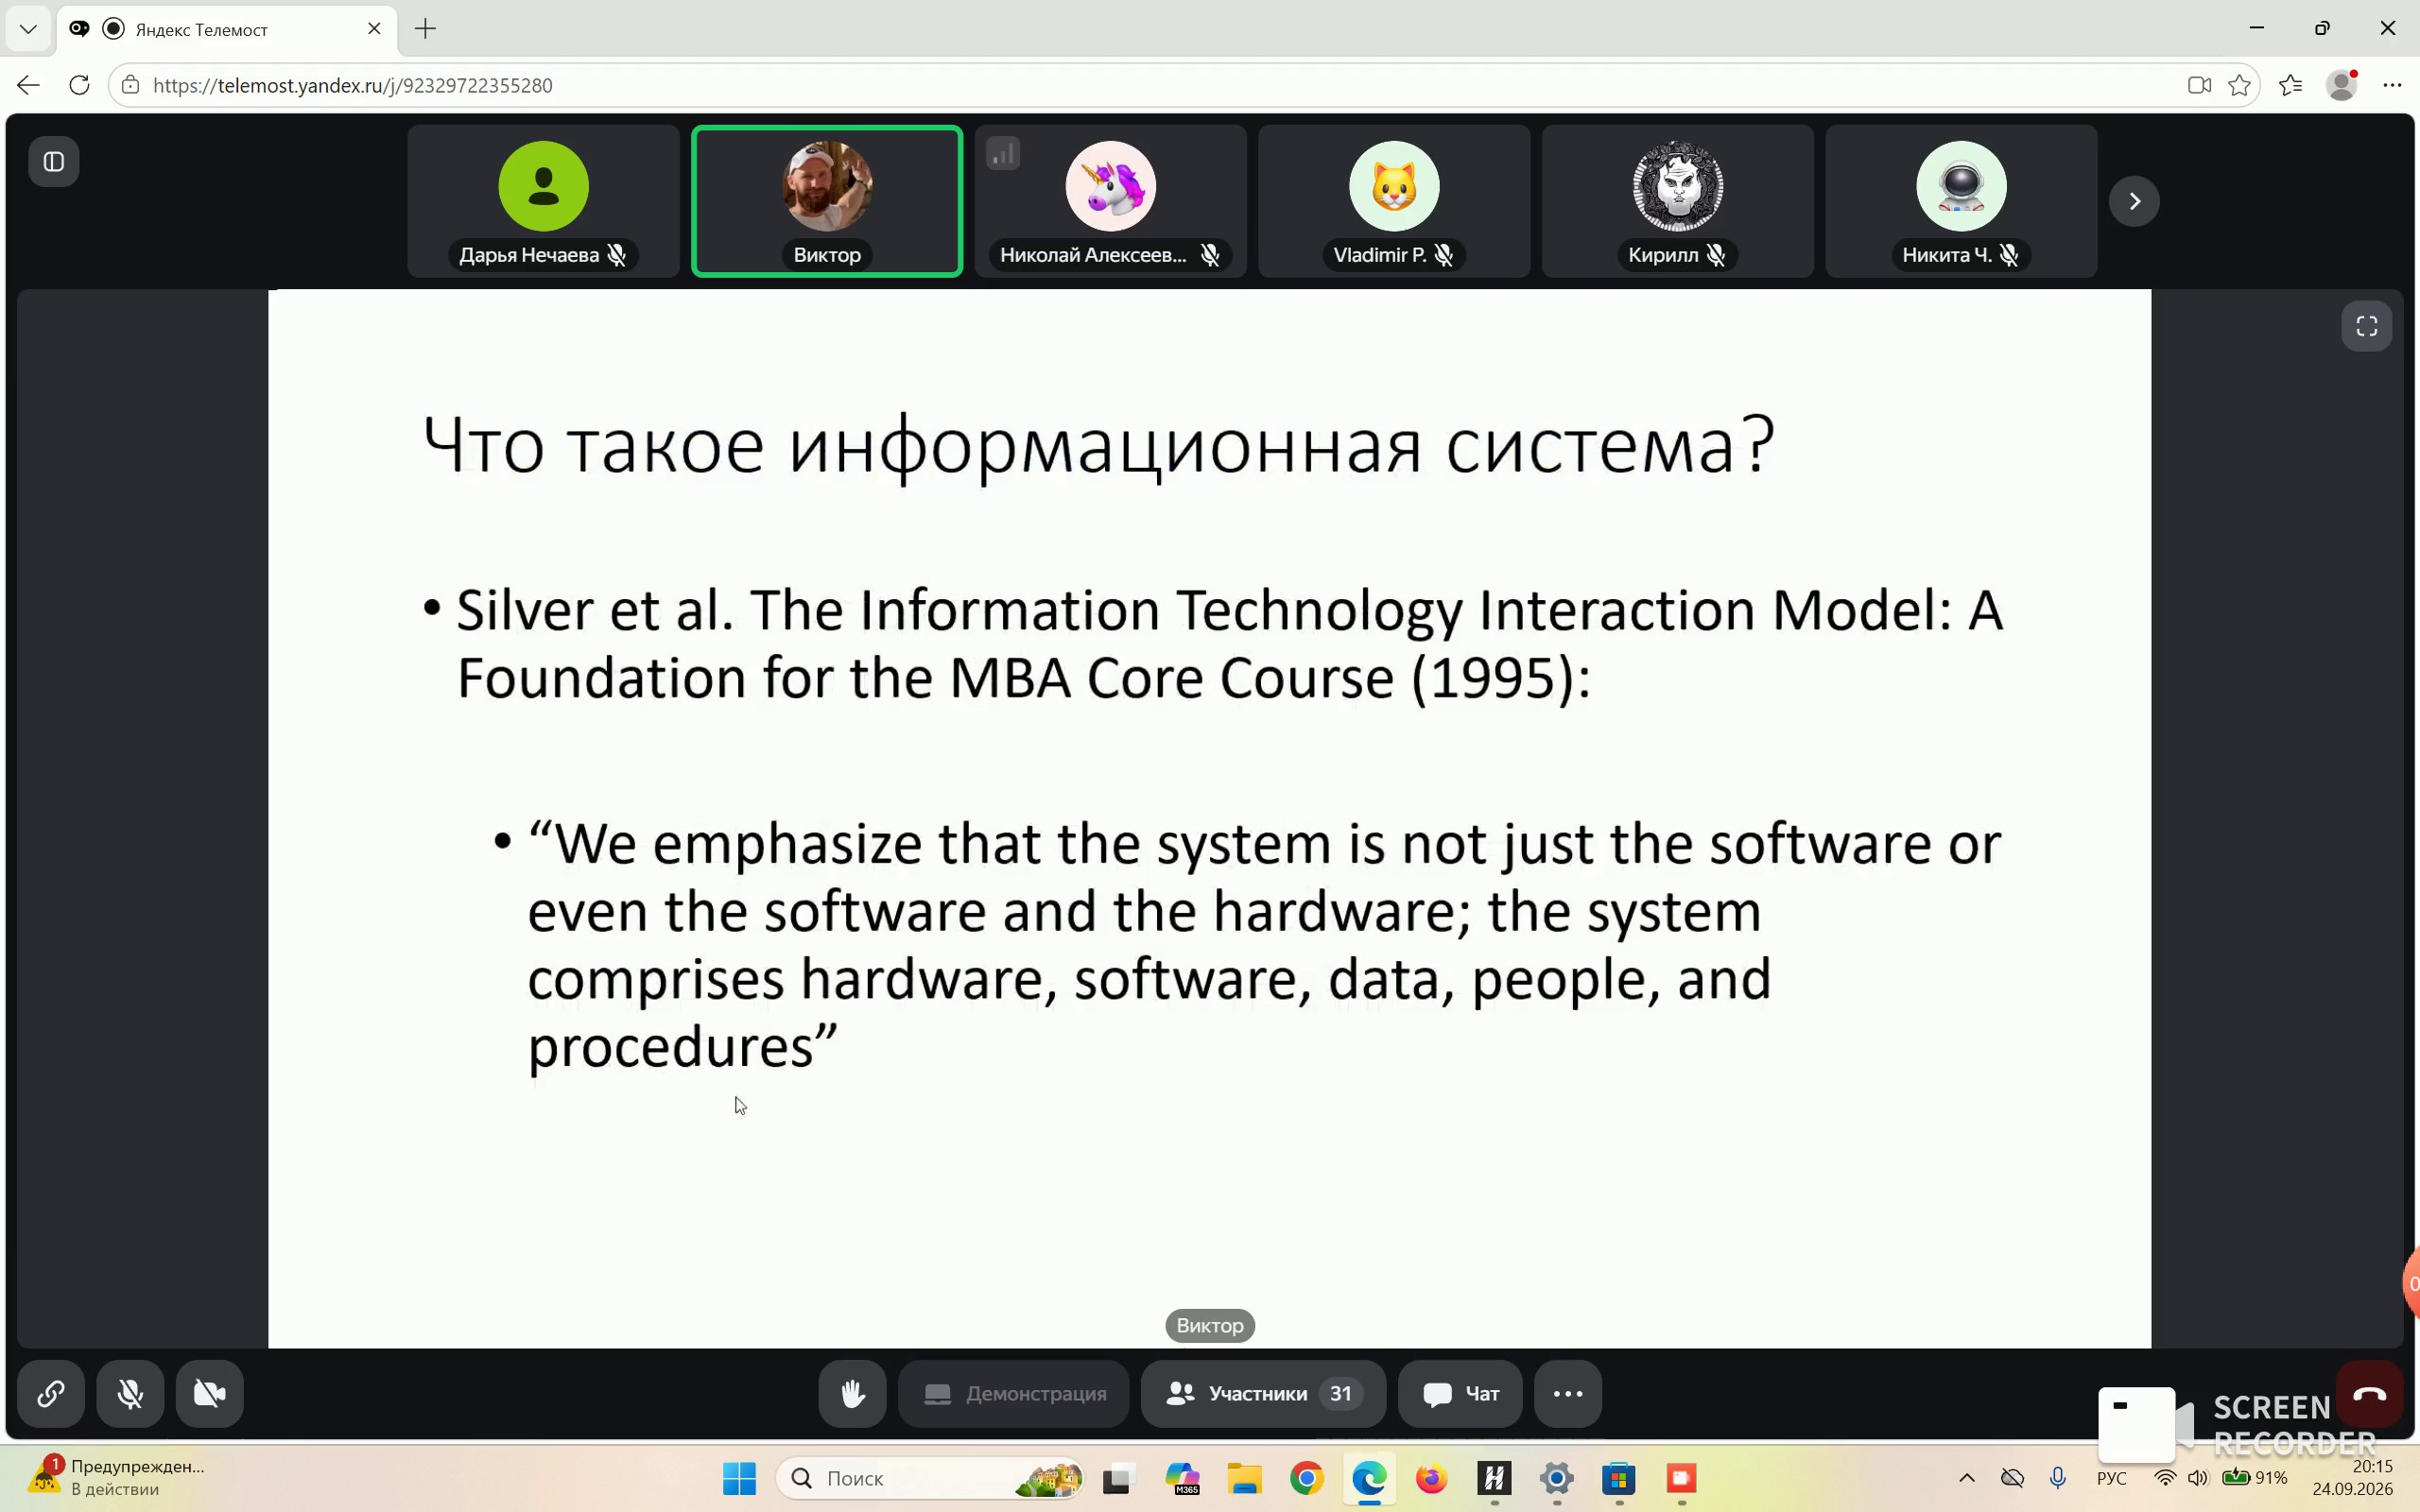
Существуют и более академические определения. Первое из них приводится из модели взаимодействия информационной технологии — базы базового курса MBA 1995 года. В соответствии с этим подходом система включает в себя аппаратное обеспечение, программное обеспечение, данные, людей и процедуры. Здесь делается акцент на том, что информационная система представляет собой не просто программное или программно-аппаратное обеспечение, а широкую совокупность всех перечисленных компонентов.
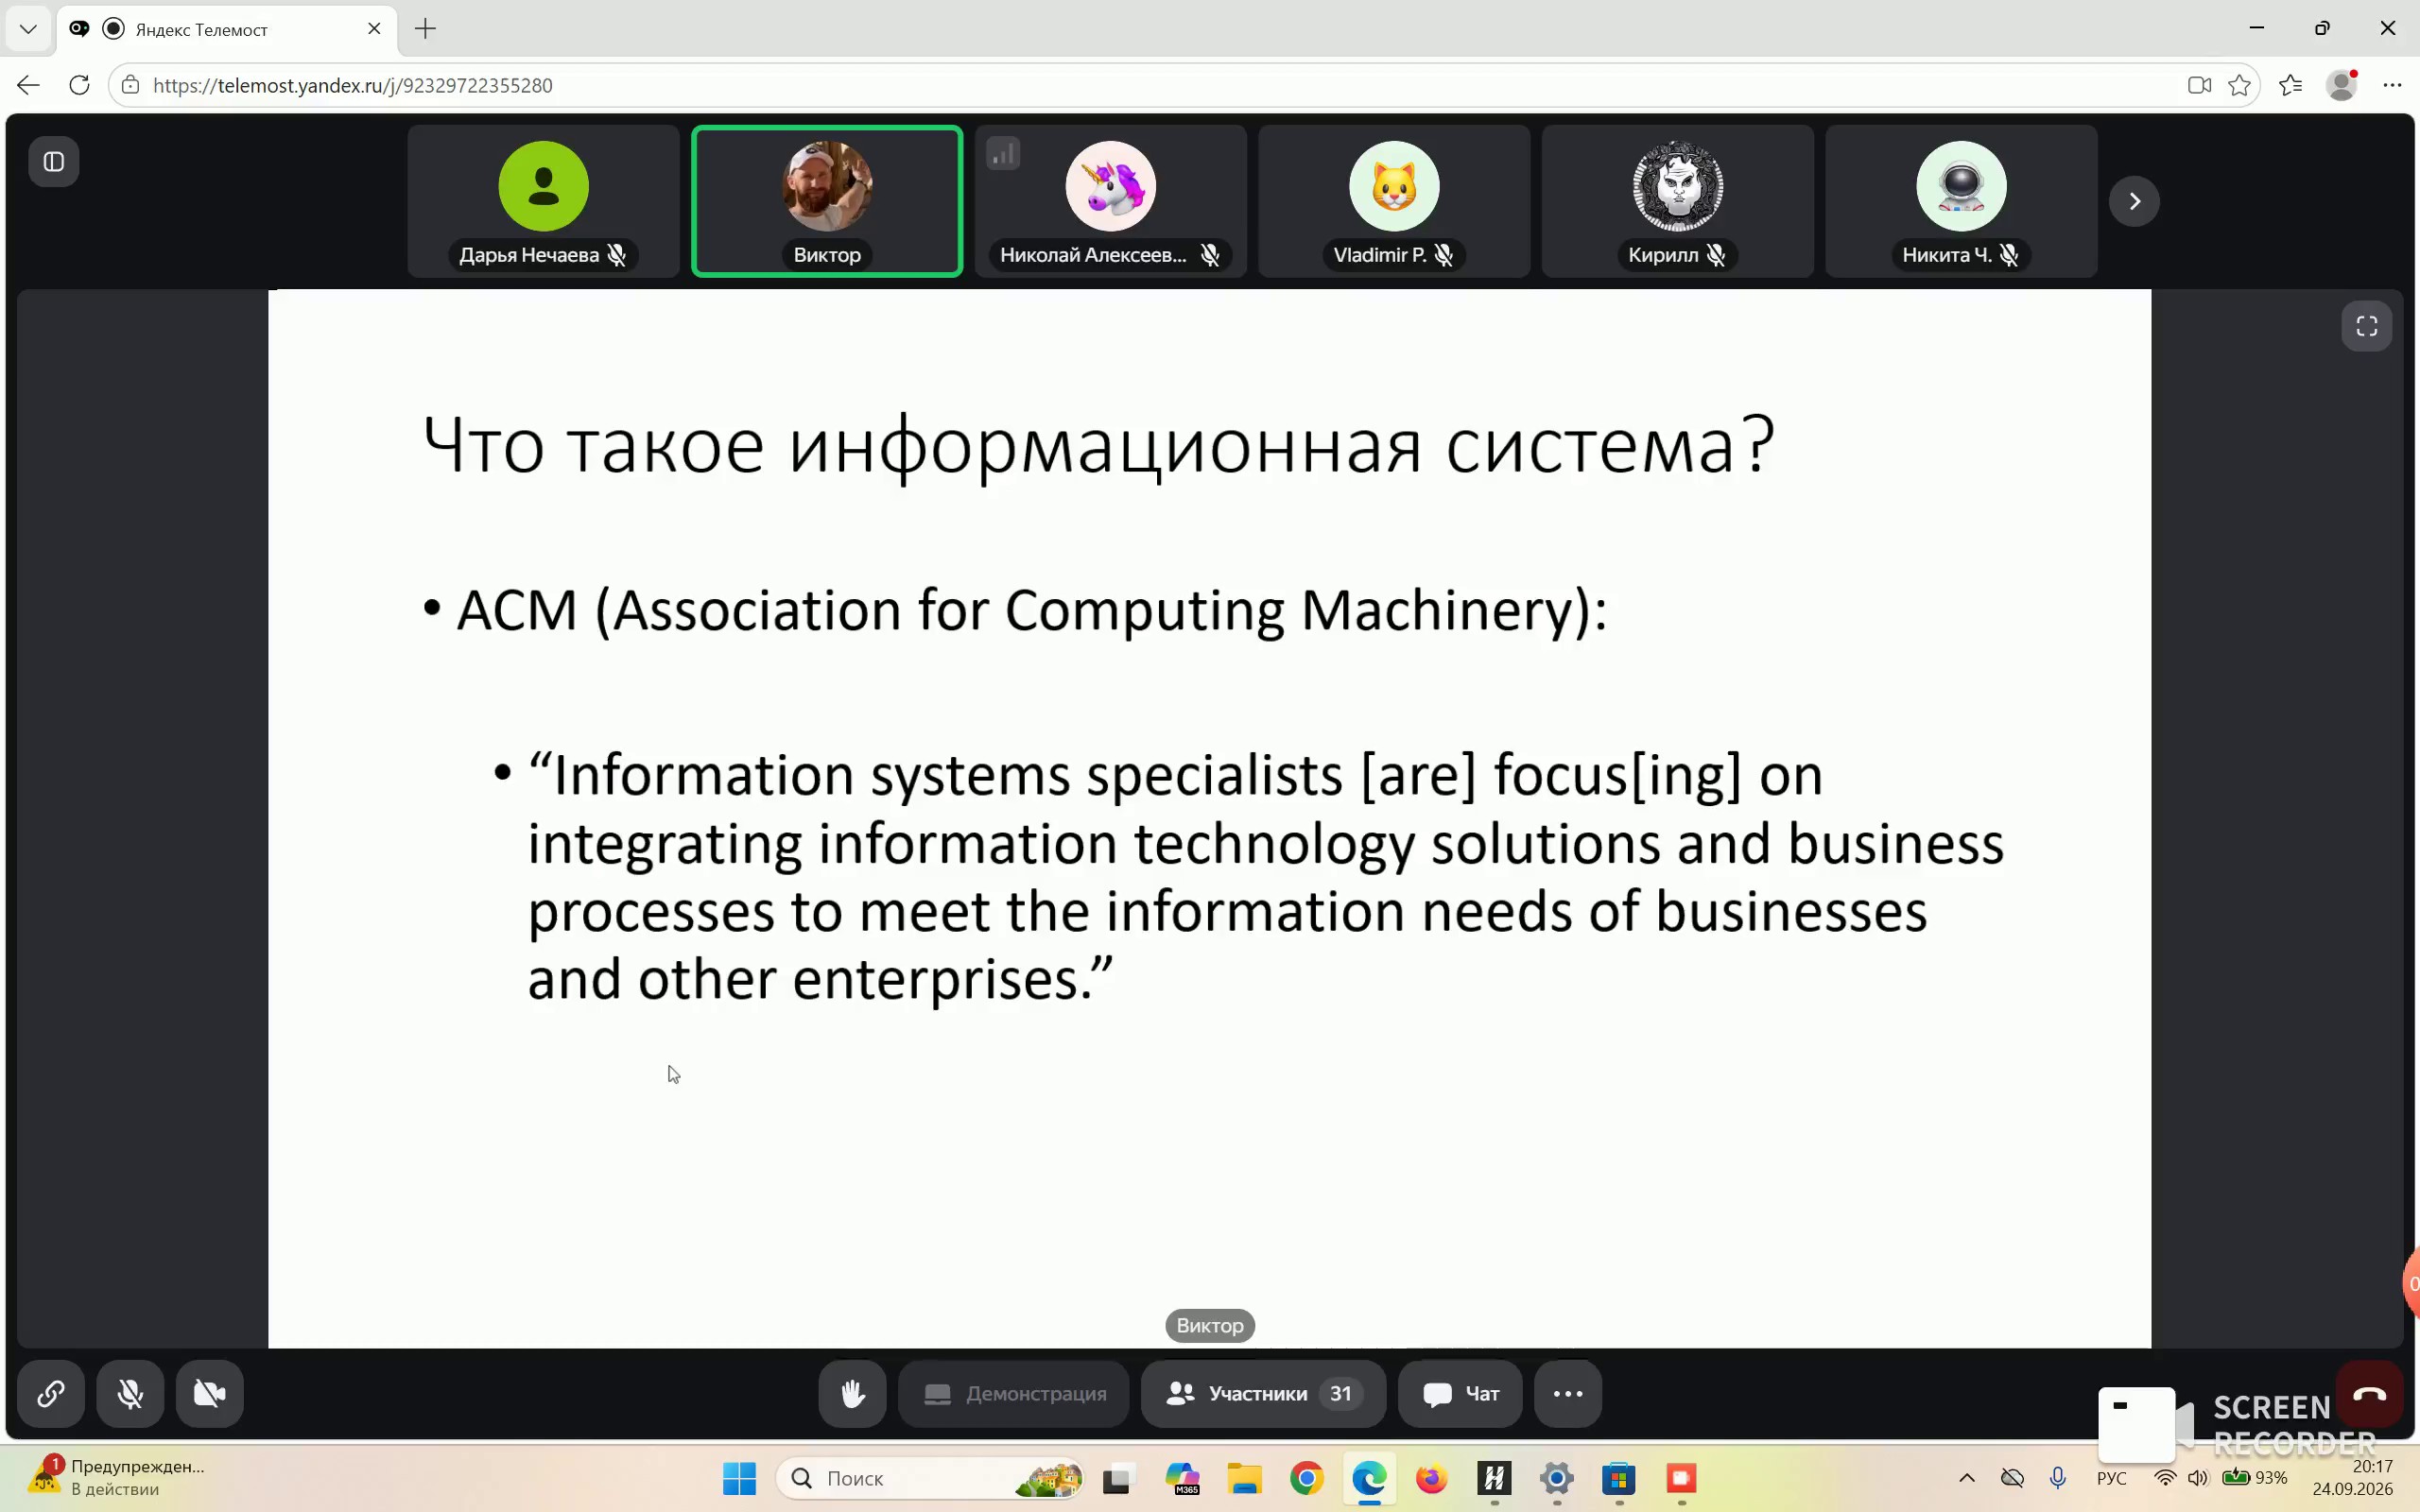
Другое определение дается Ассоциацией вычислительной техники. Согласно этому определению, специалисты по информационным системам сосредоточены на интеграции решений в области информационных технологий и бизнес-процессов для удовлетворения информационных потребностей компаний и других организаций. Это демонстрирует иной взгляд на информационную систему как на симбиоз информационных технологий и бизнес-процессов, которые в совокупности должны удовлетворять потребностям компаний.
Идея о симбиозе информационных технологий и бизнеса является актуальной и в настоящее время. Если посмотреть на стратегии развития многих отечественных корпораций, можно увидеть возвращение к этой идее: многие стратегии содержат концепцию совместной работы и ответственности ИТ-подразделений и бизнес-подразделений. В рамках такого подхода ИТ не делает что-то отдельно для бизнеса и бизнес не доказывает что-то ИТ — оба блока совместно работают на единый общий результат.
Примеры информационных систем
В качестве примеров информационных систем можно выделить хранилища данных, которые представляют собой системы для хранения больших объемов данных, обычно используемые для аналитики. Также примером являются ERP-системы — это системы управления ресурсами и процессами предприятий, таких как финансы, закупки, управление складскими запасами, управление персоналом и так далее.
Информационными системами могут являться некие экспертные системы, которые помогают специалистам принимать различные решения в той или иной ситуации. Следующим примером выступают поисковые системы, которые предоставляют релевантную информацию по запросу. К ним также относятся системы автоматизированного документооборота, упрощающие жизнь людям, которые работают с документами. Сюда входят создание документов, один из краеугольных вопросов согласования этих документов, хранение документов и различные перемещения документов.
Кроме того, примерами могут служить различные BI-системы (Business Intelligence), а также технологии OLAP (Online Analytical Processing), представляющие собой многофакторный анализ данных, различные средства агрегирования, сравнения показателей и так далее. Примерами информационных систем также являются цифровые сервисы и экосистемы, многие из которых хорошо знакомы. Примеров можно привести еще достаточное количество, чтобы понять, что такое информационная система.
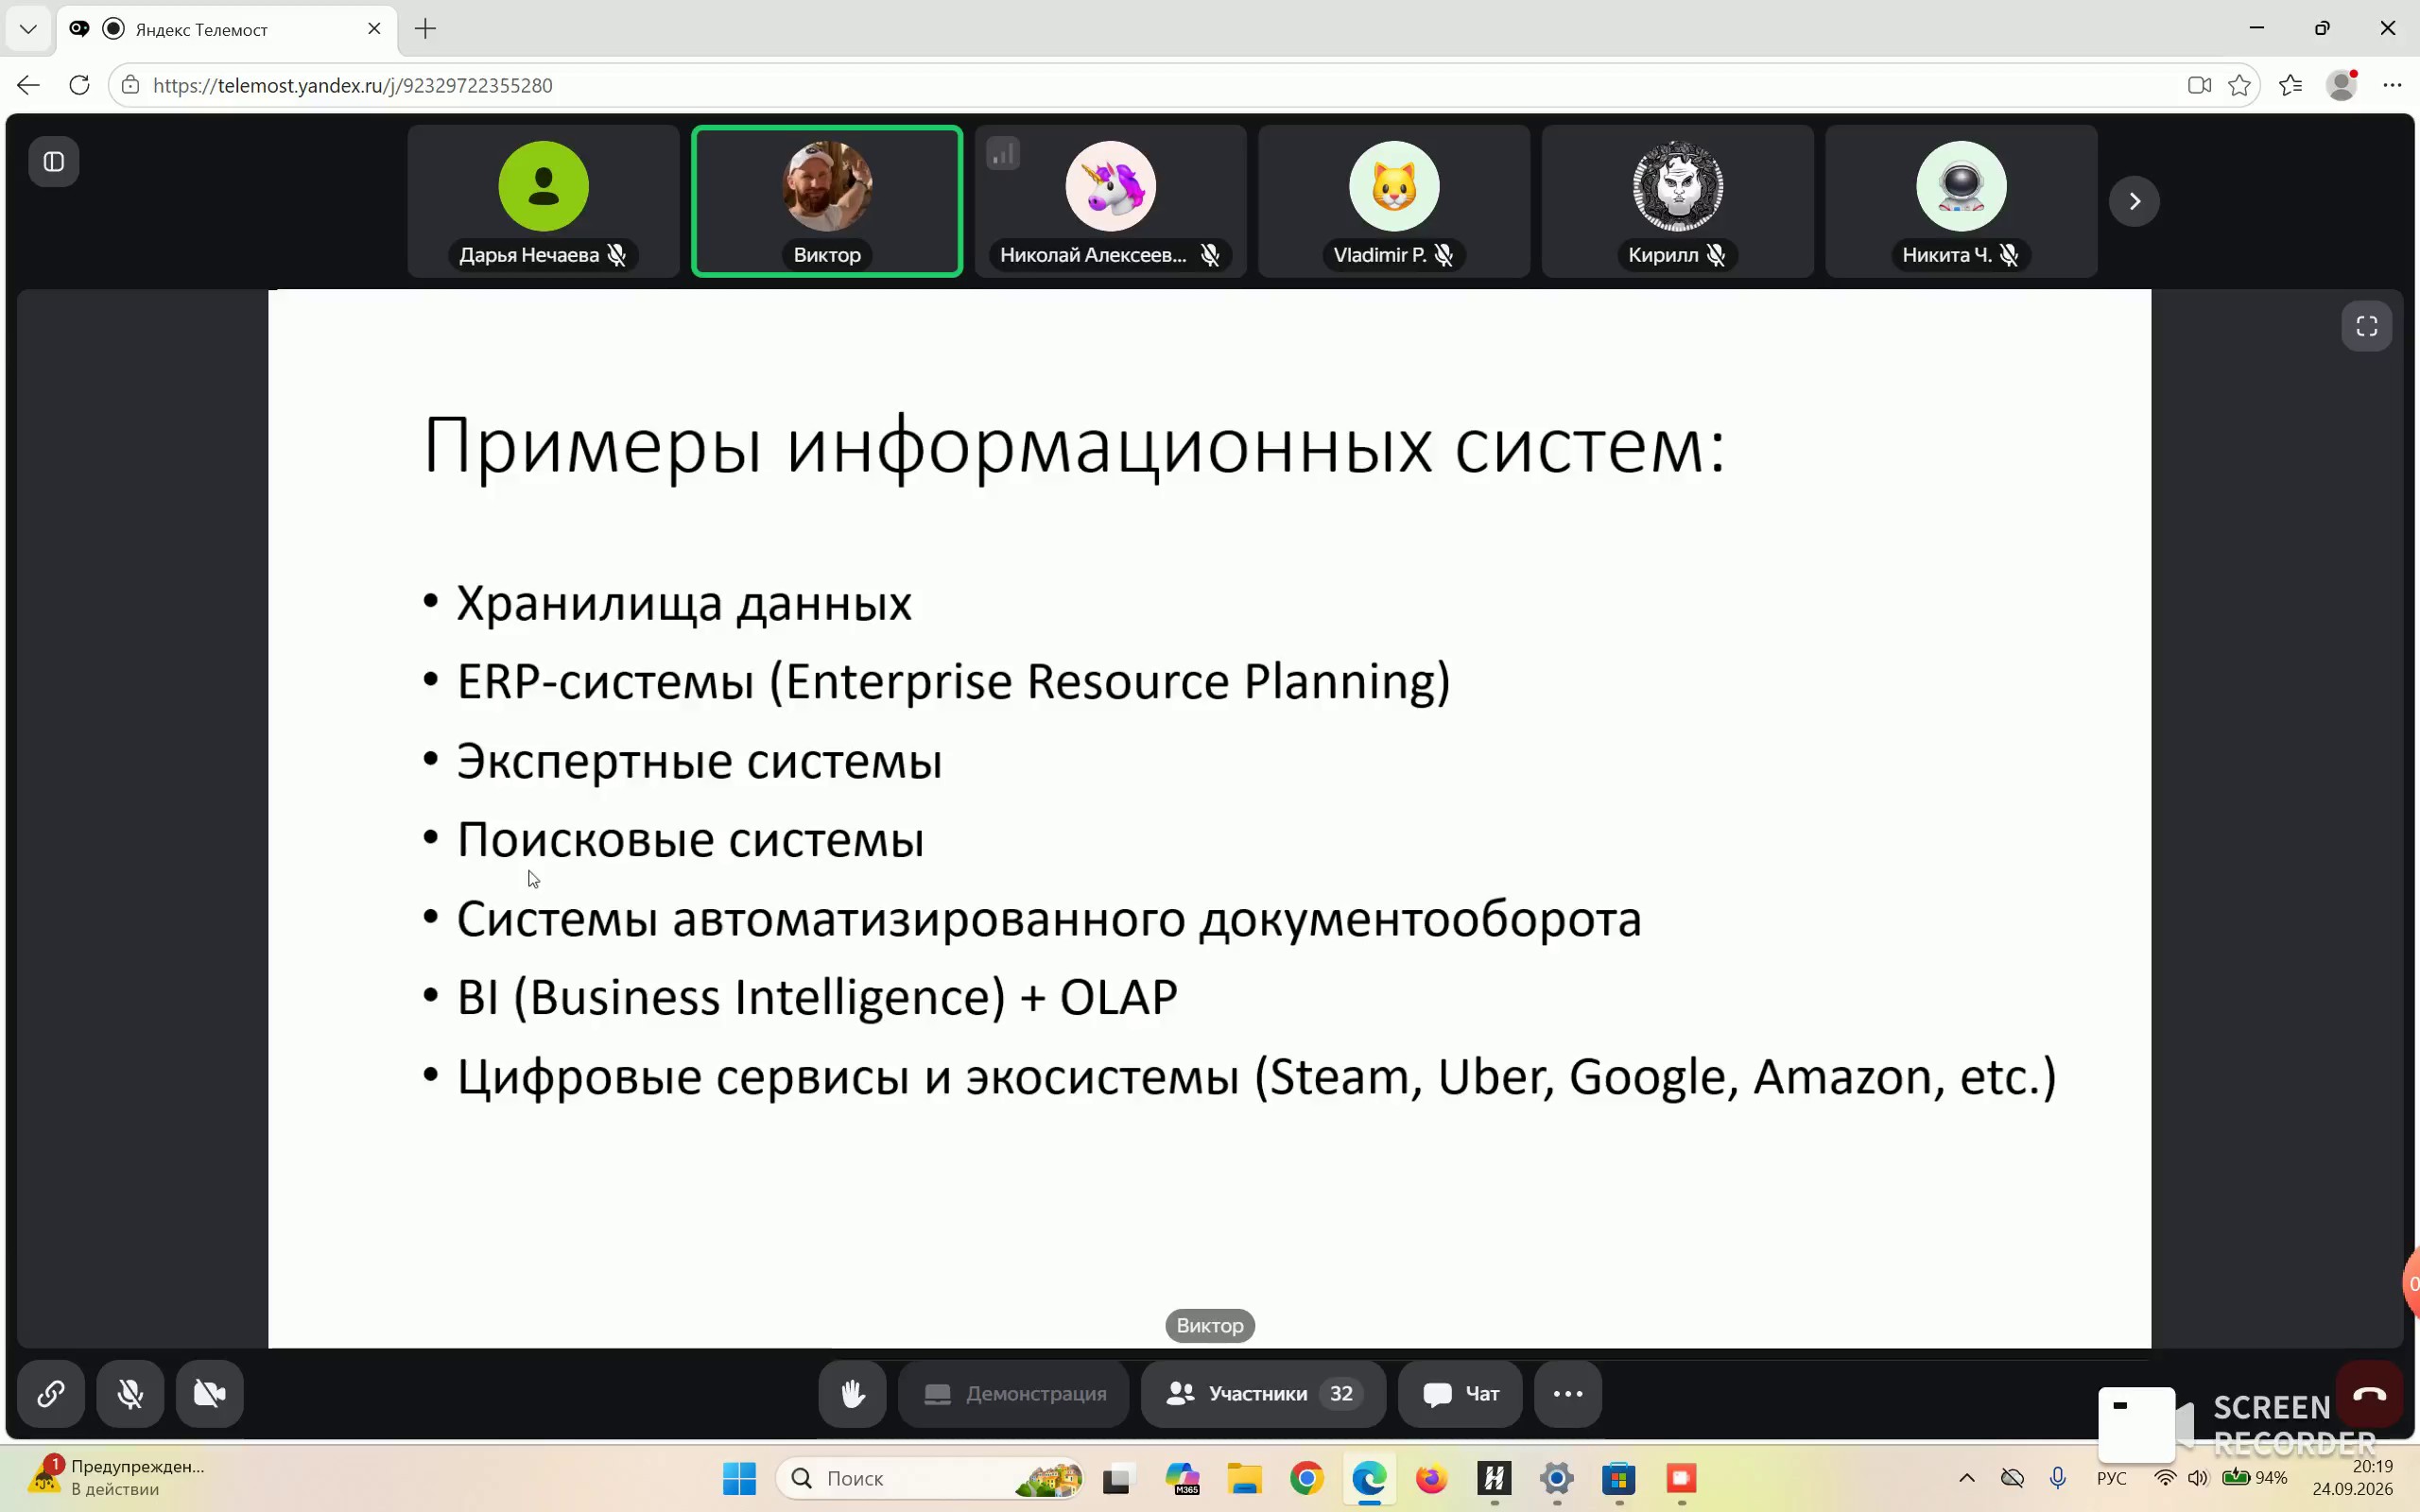
Эволюция вычислительной техники: 1950–1970-е годы
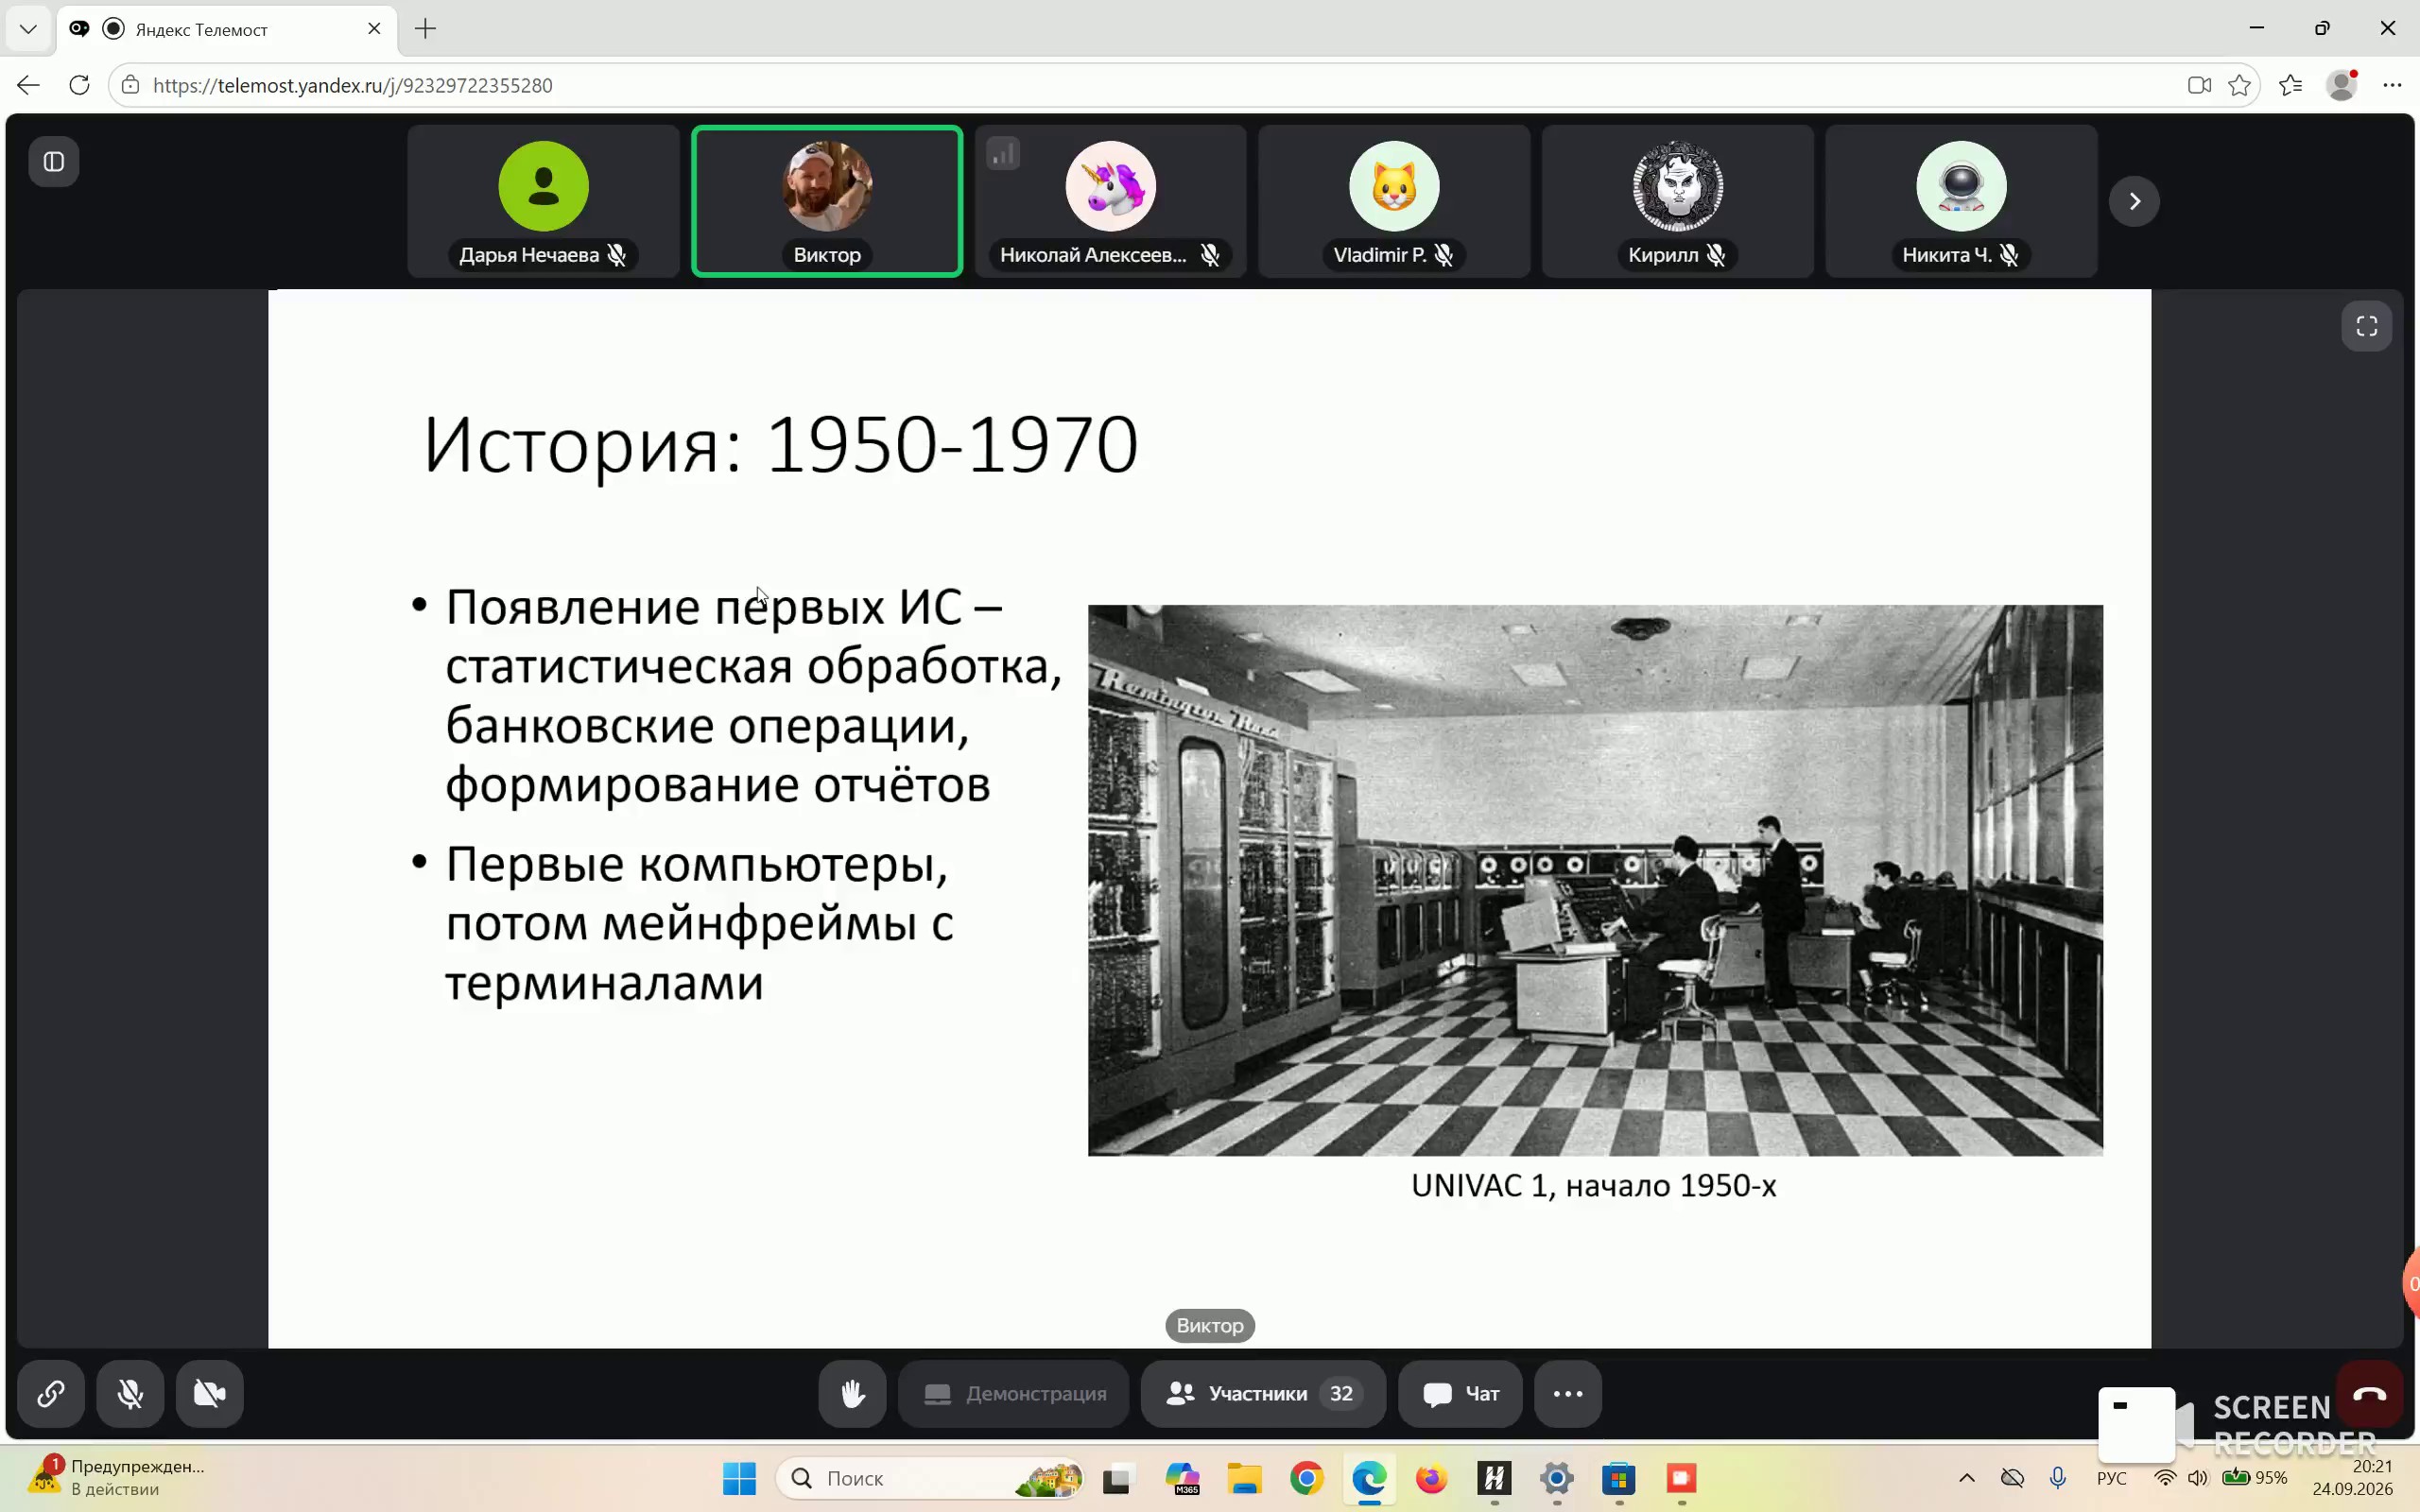
Эволюция вычислительной техники в период с 1950 по 1970-е годы связана с появлением первых информационных систем, которые служили интересам бизнеса и компаний. Основными задачами таких систем были различные статистические обработки данных, обработка финансовой информации, банковских операций, транзакций и тому подобное. Ничего не появлялось просто так: все создавалось для того, чтобы облегчить труд специалистов, но в конечном счете все это сводилось к прибыльности бизнеса, чтобы не люди выполняли все эти рутинные операции, а машины и компьютеры начали оптимизировать этот процесс. Это позволяло сократить штат сотрудников, например, вместо десяти человек требовалось три-четыре человека, что обеспечивало экономию, хотя и достигалось через достаточно большие инвестиционные вложения, которые в конечном счете окупились.
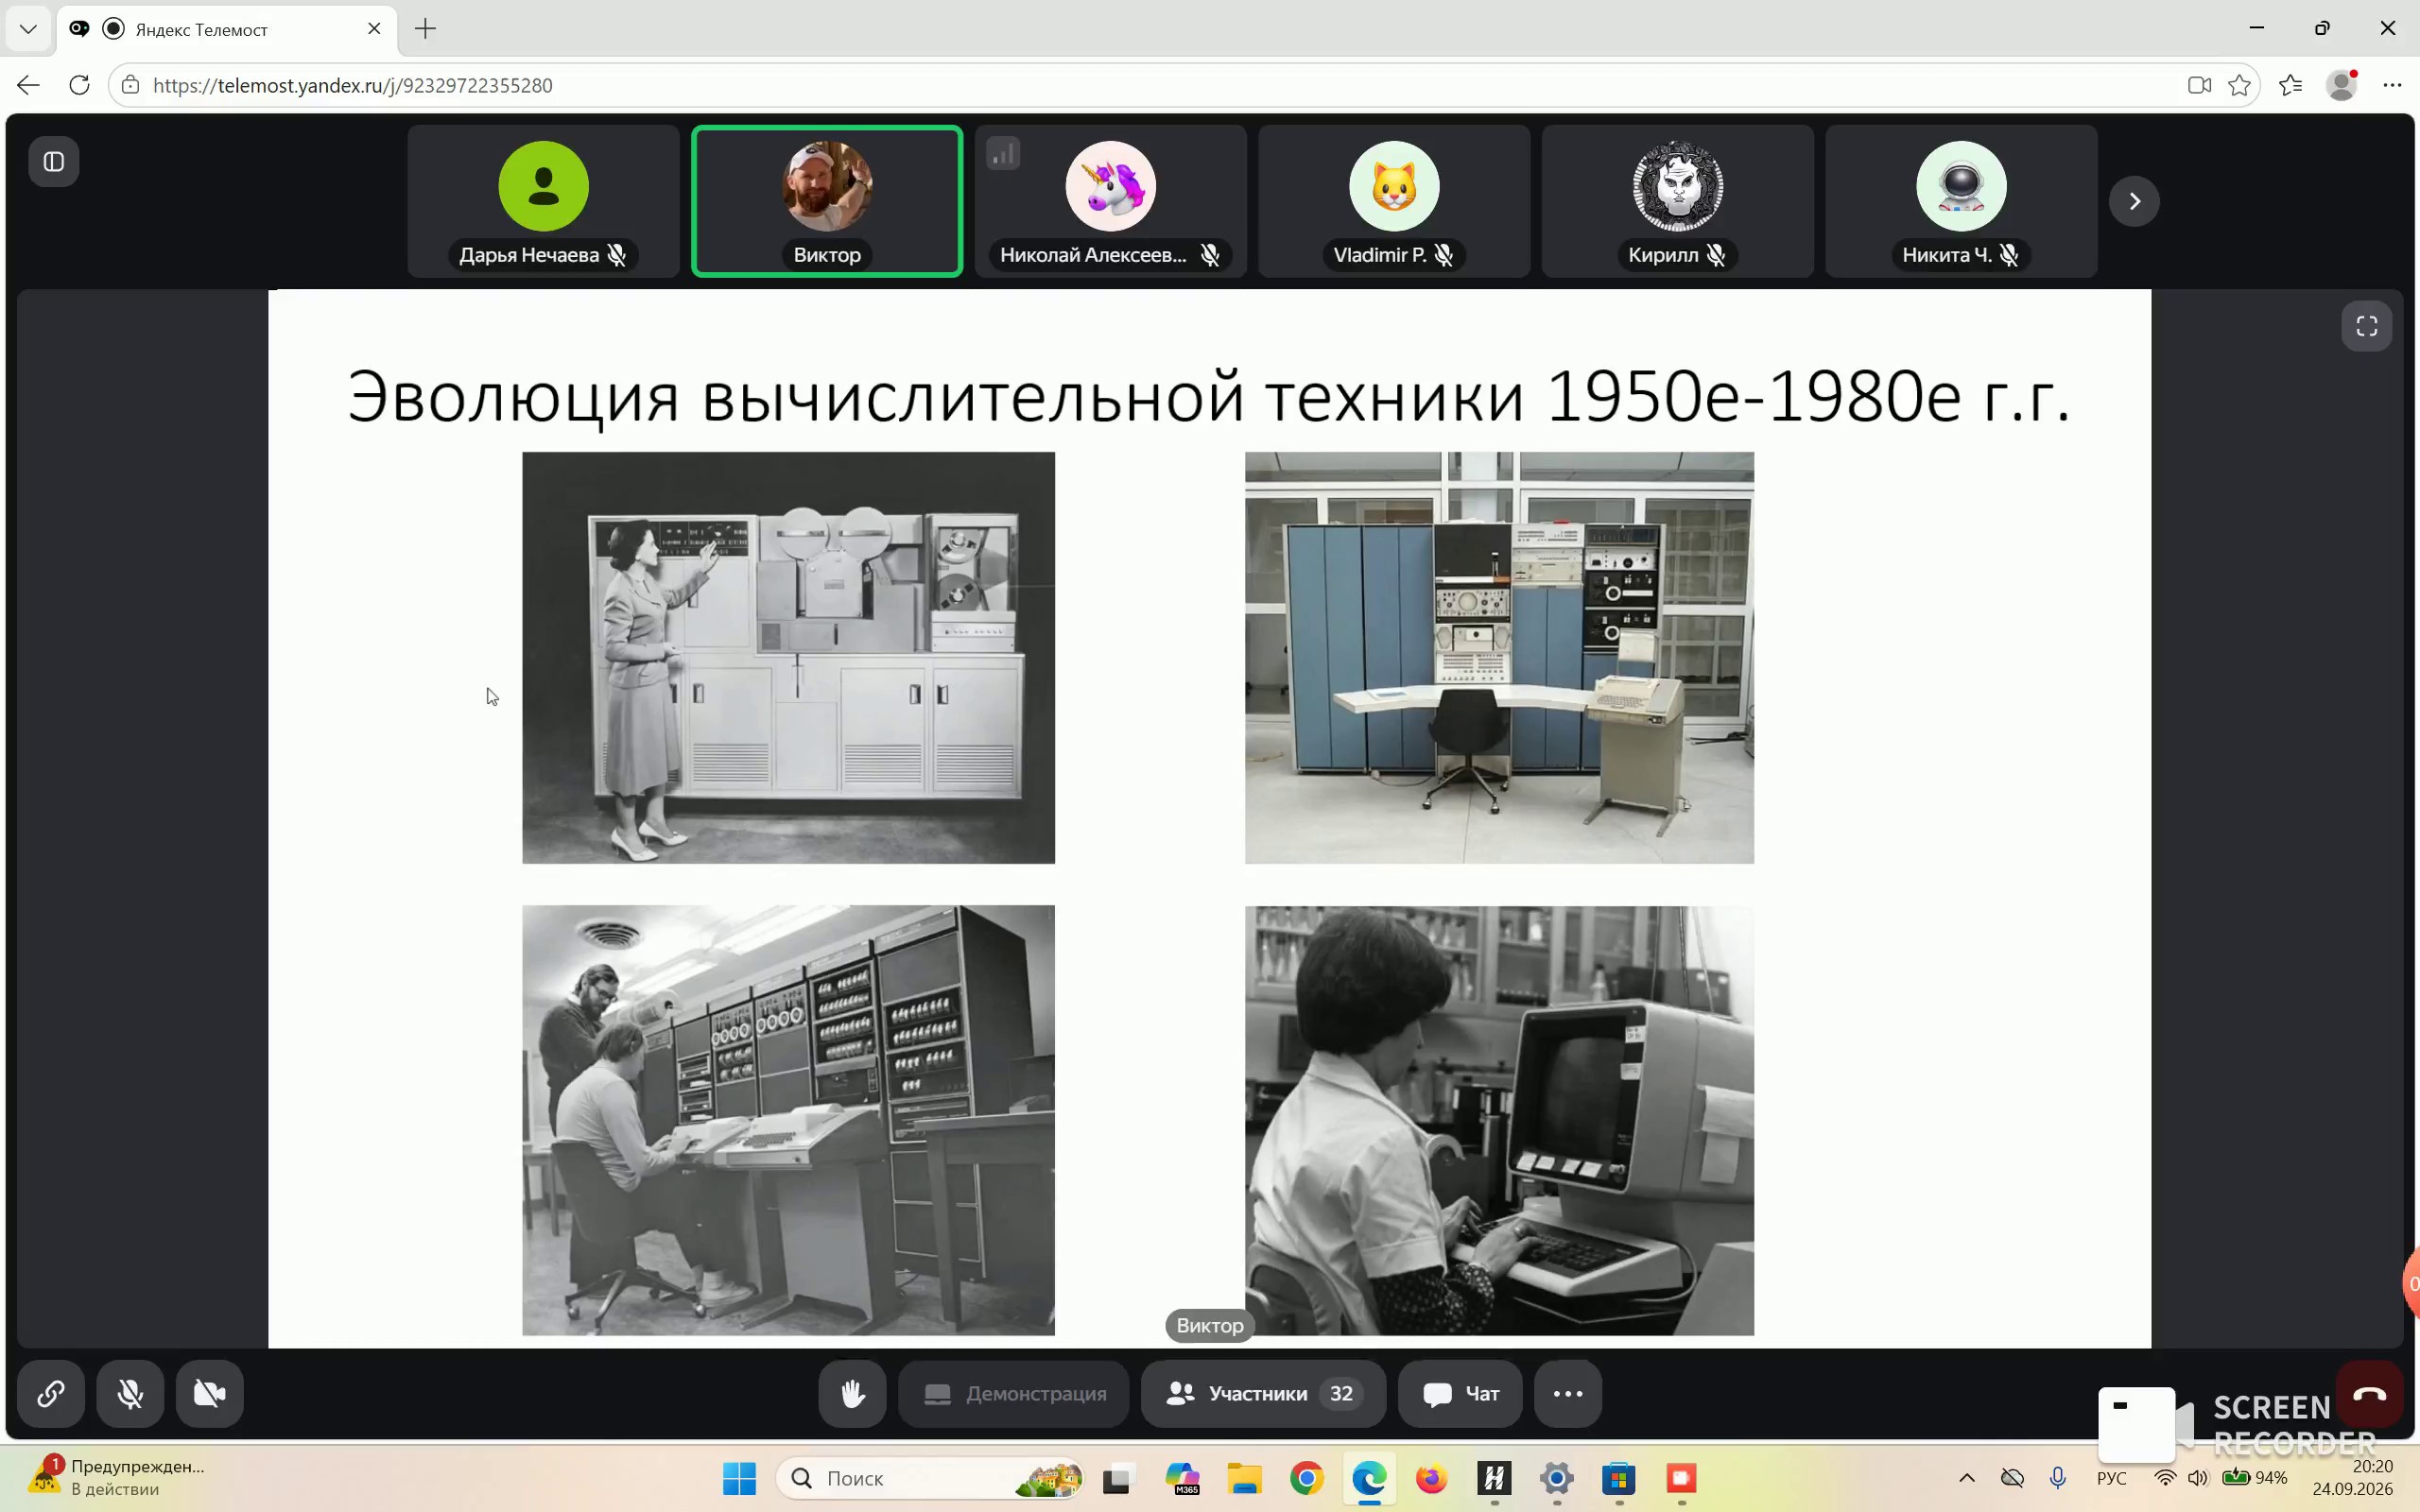
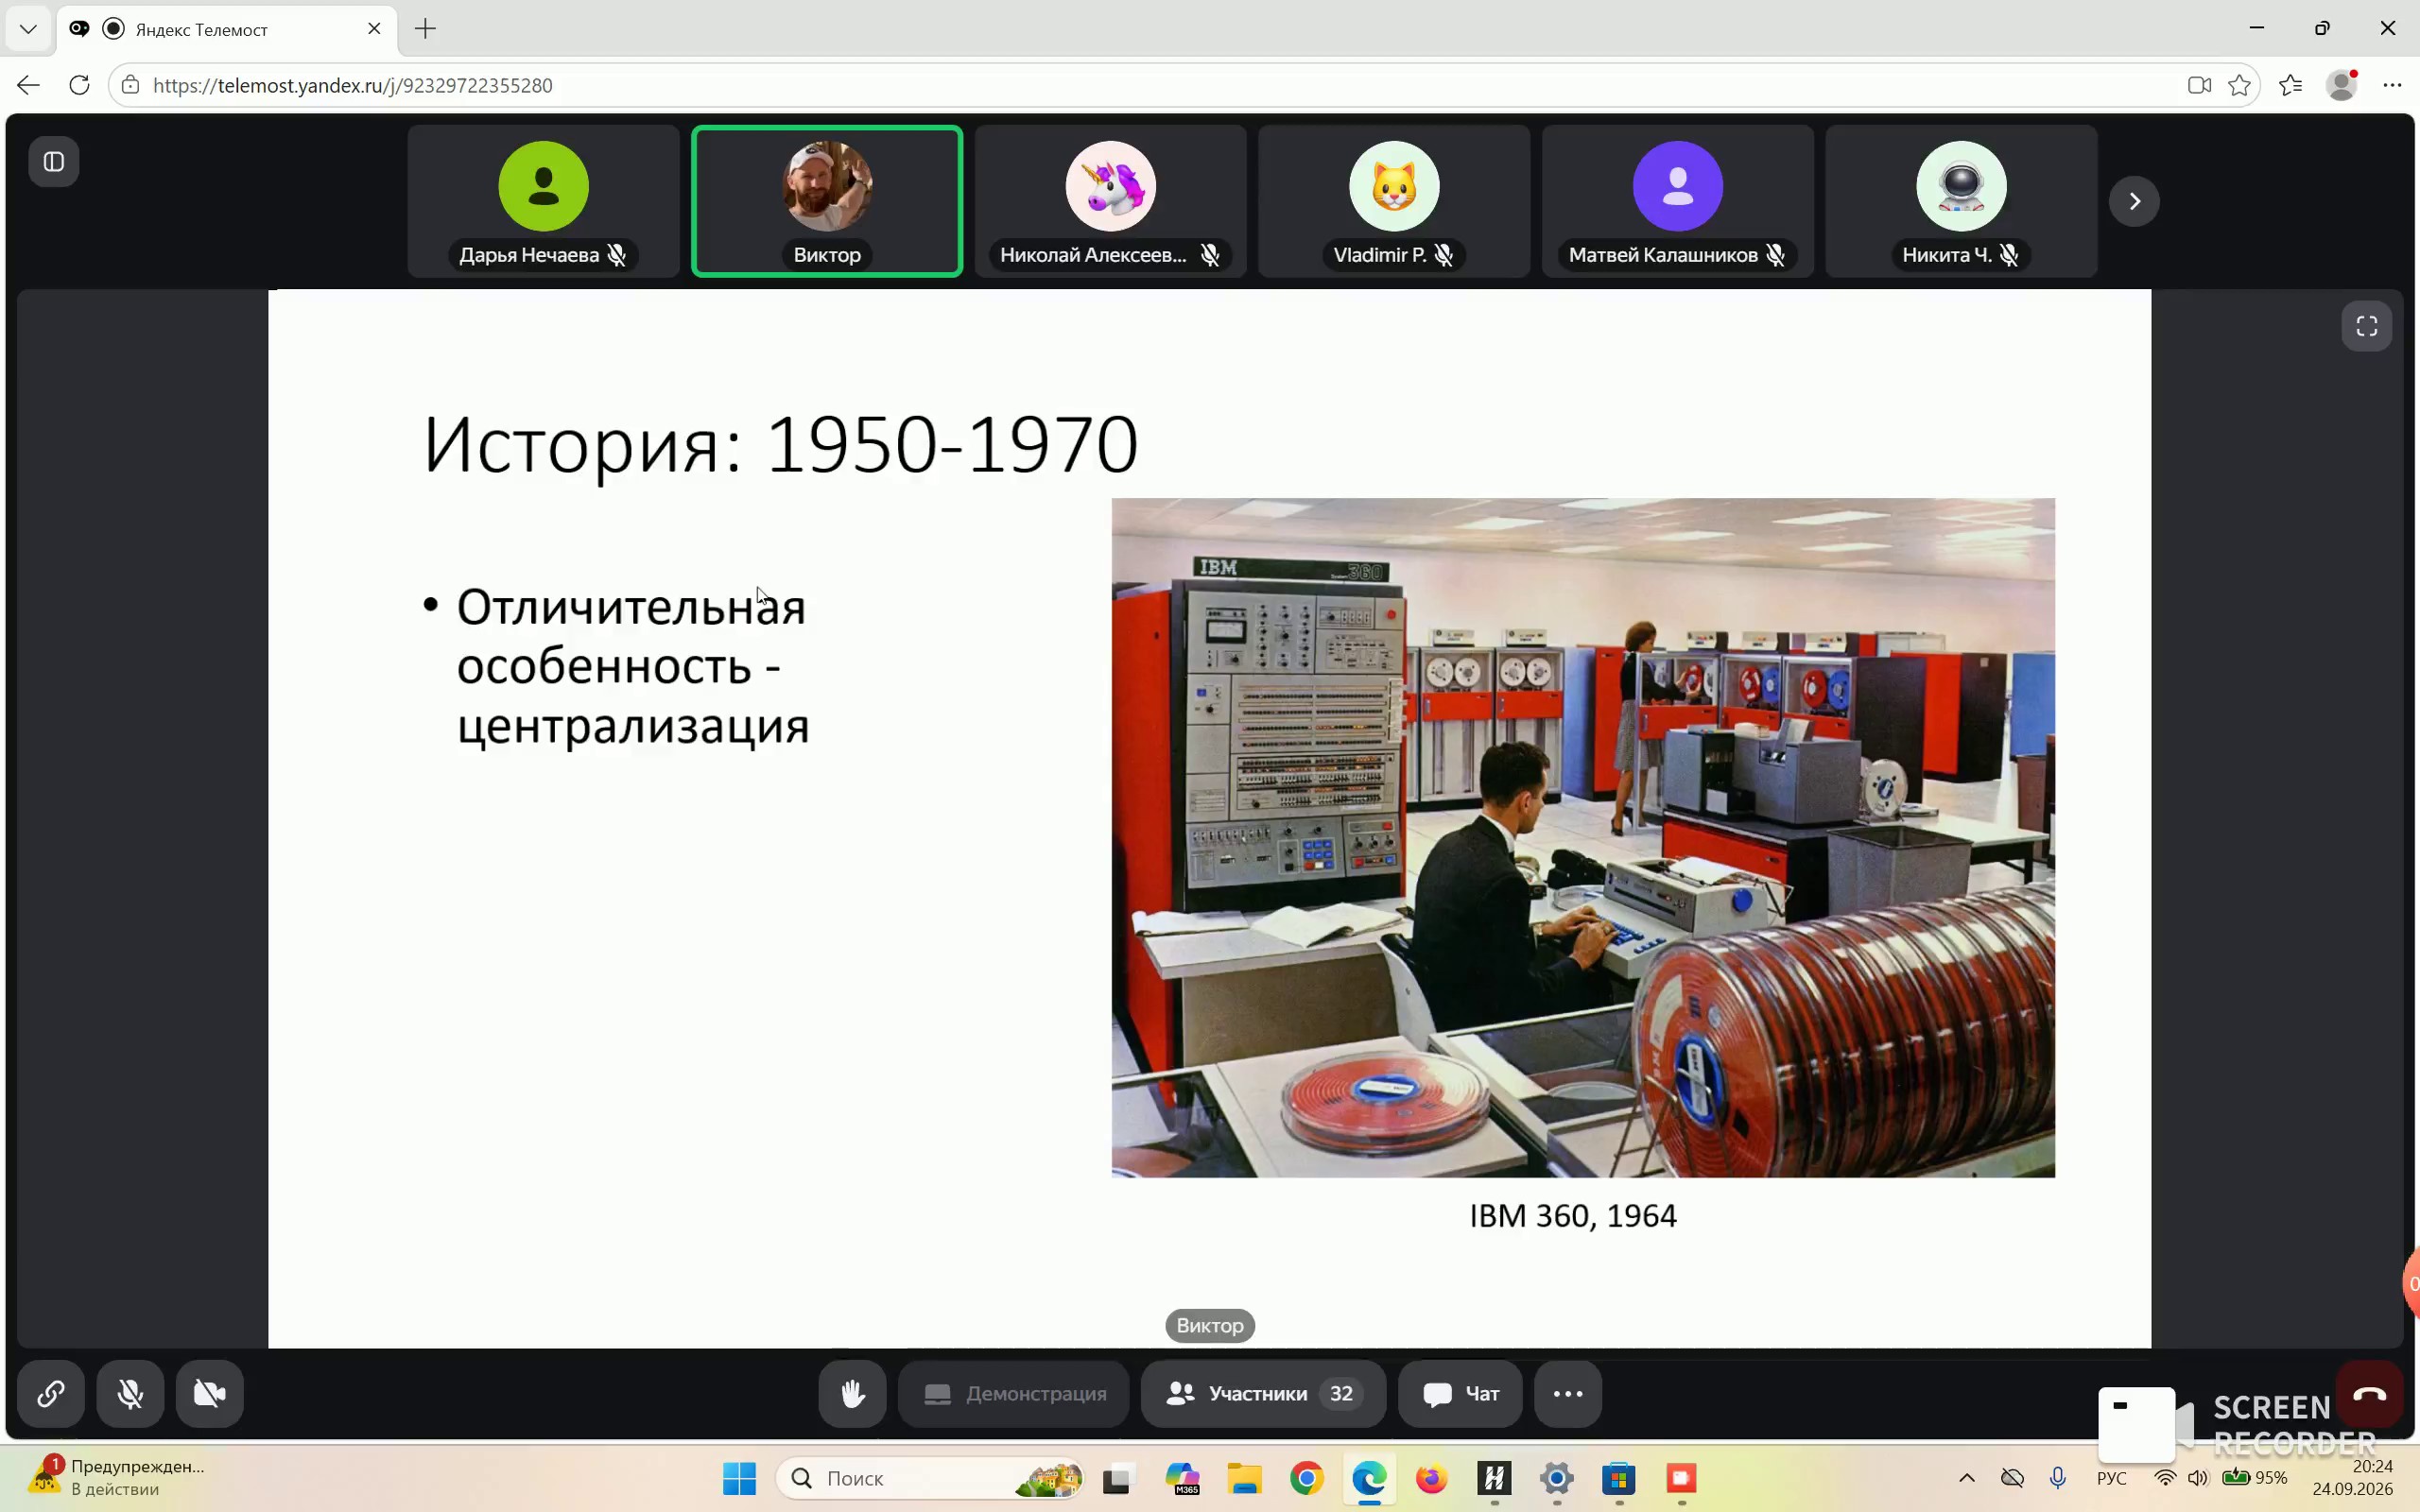
В этот период появляются первые компьютеры на мейнфреймах с терминалами — это централизованный компьютер, с которым могут работать несколько пользователей. То есть существовала одна центральная вычислительная система и несколько пользователей, которые могли с ней работать.
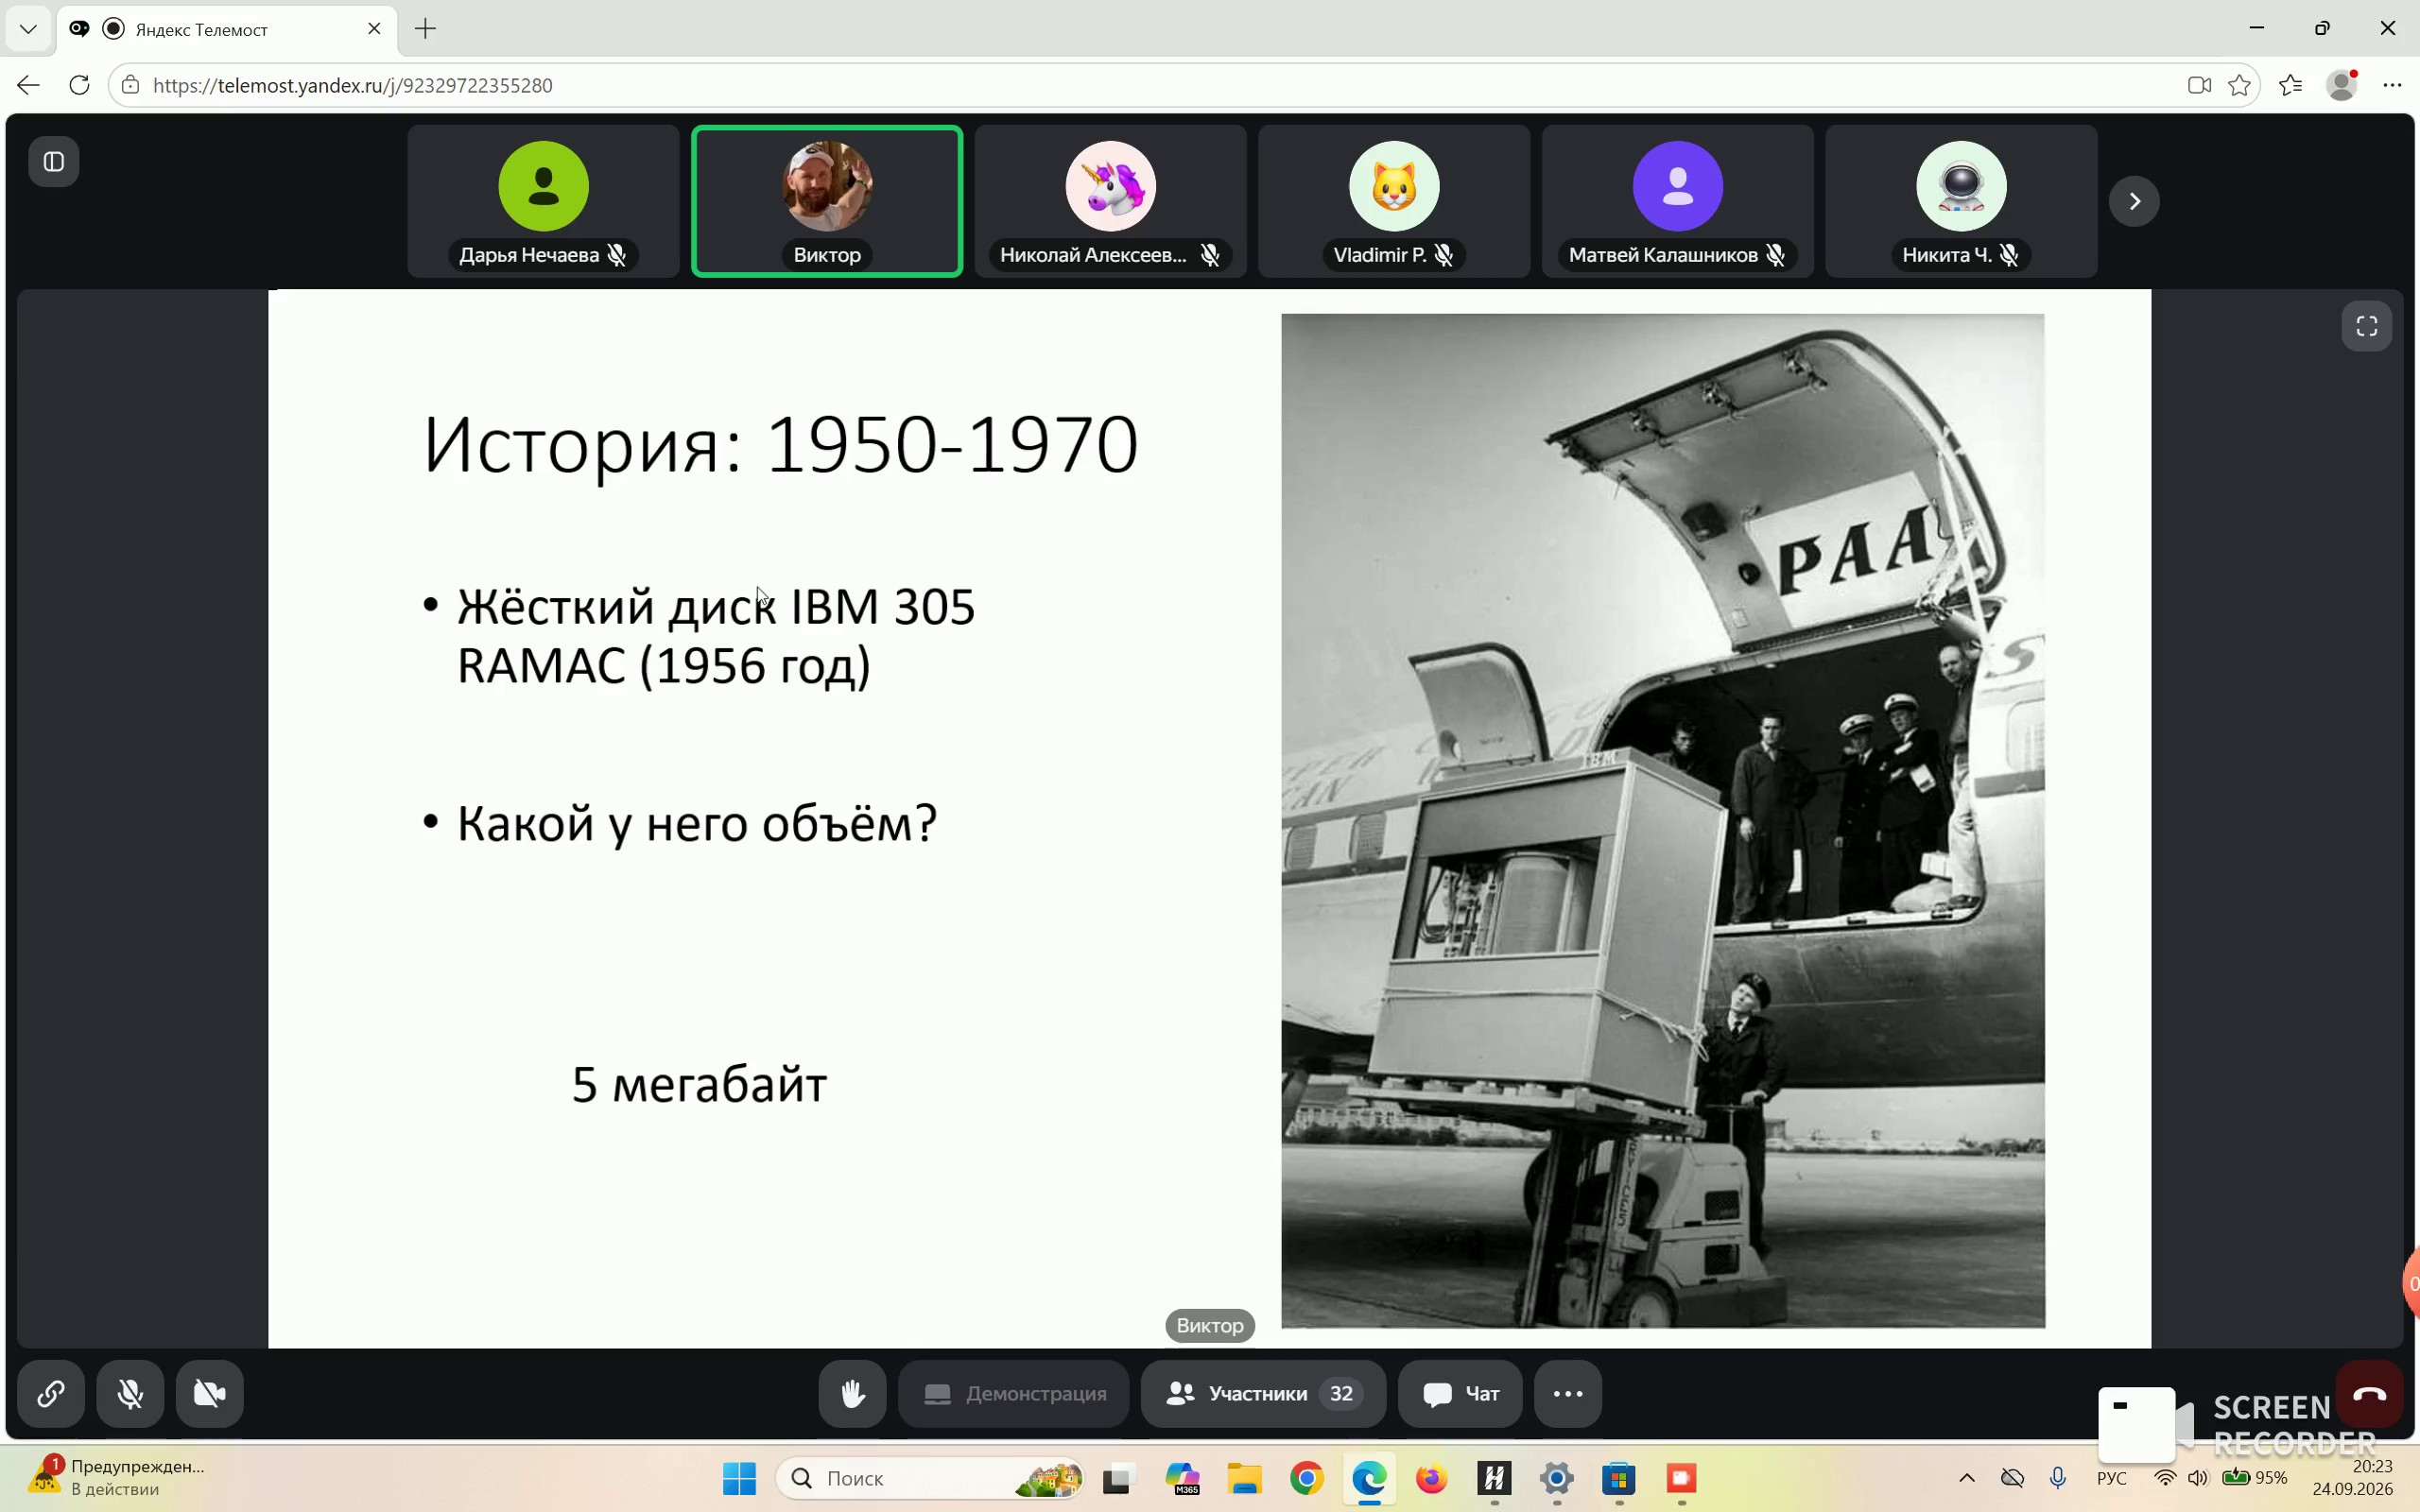
Значимым событием для периода 1950–1970-х годов стало появление жесткого диска от компании IBM в 1956 году.
Отступление от темы
Значит рынок на 1956 году такой вот вопрос какой у него был объем только считают как у него был объем предположение хотя килобайт 16 16 килобайт да я думаю что побольше по моему там было 4 мегабайта мегабайт но вы практически правильно ответили там там было не 4 было 5 мегабайты вот значит и соответственно > — Диалог со студентами об объеме первого жесткого диска IBM.
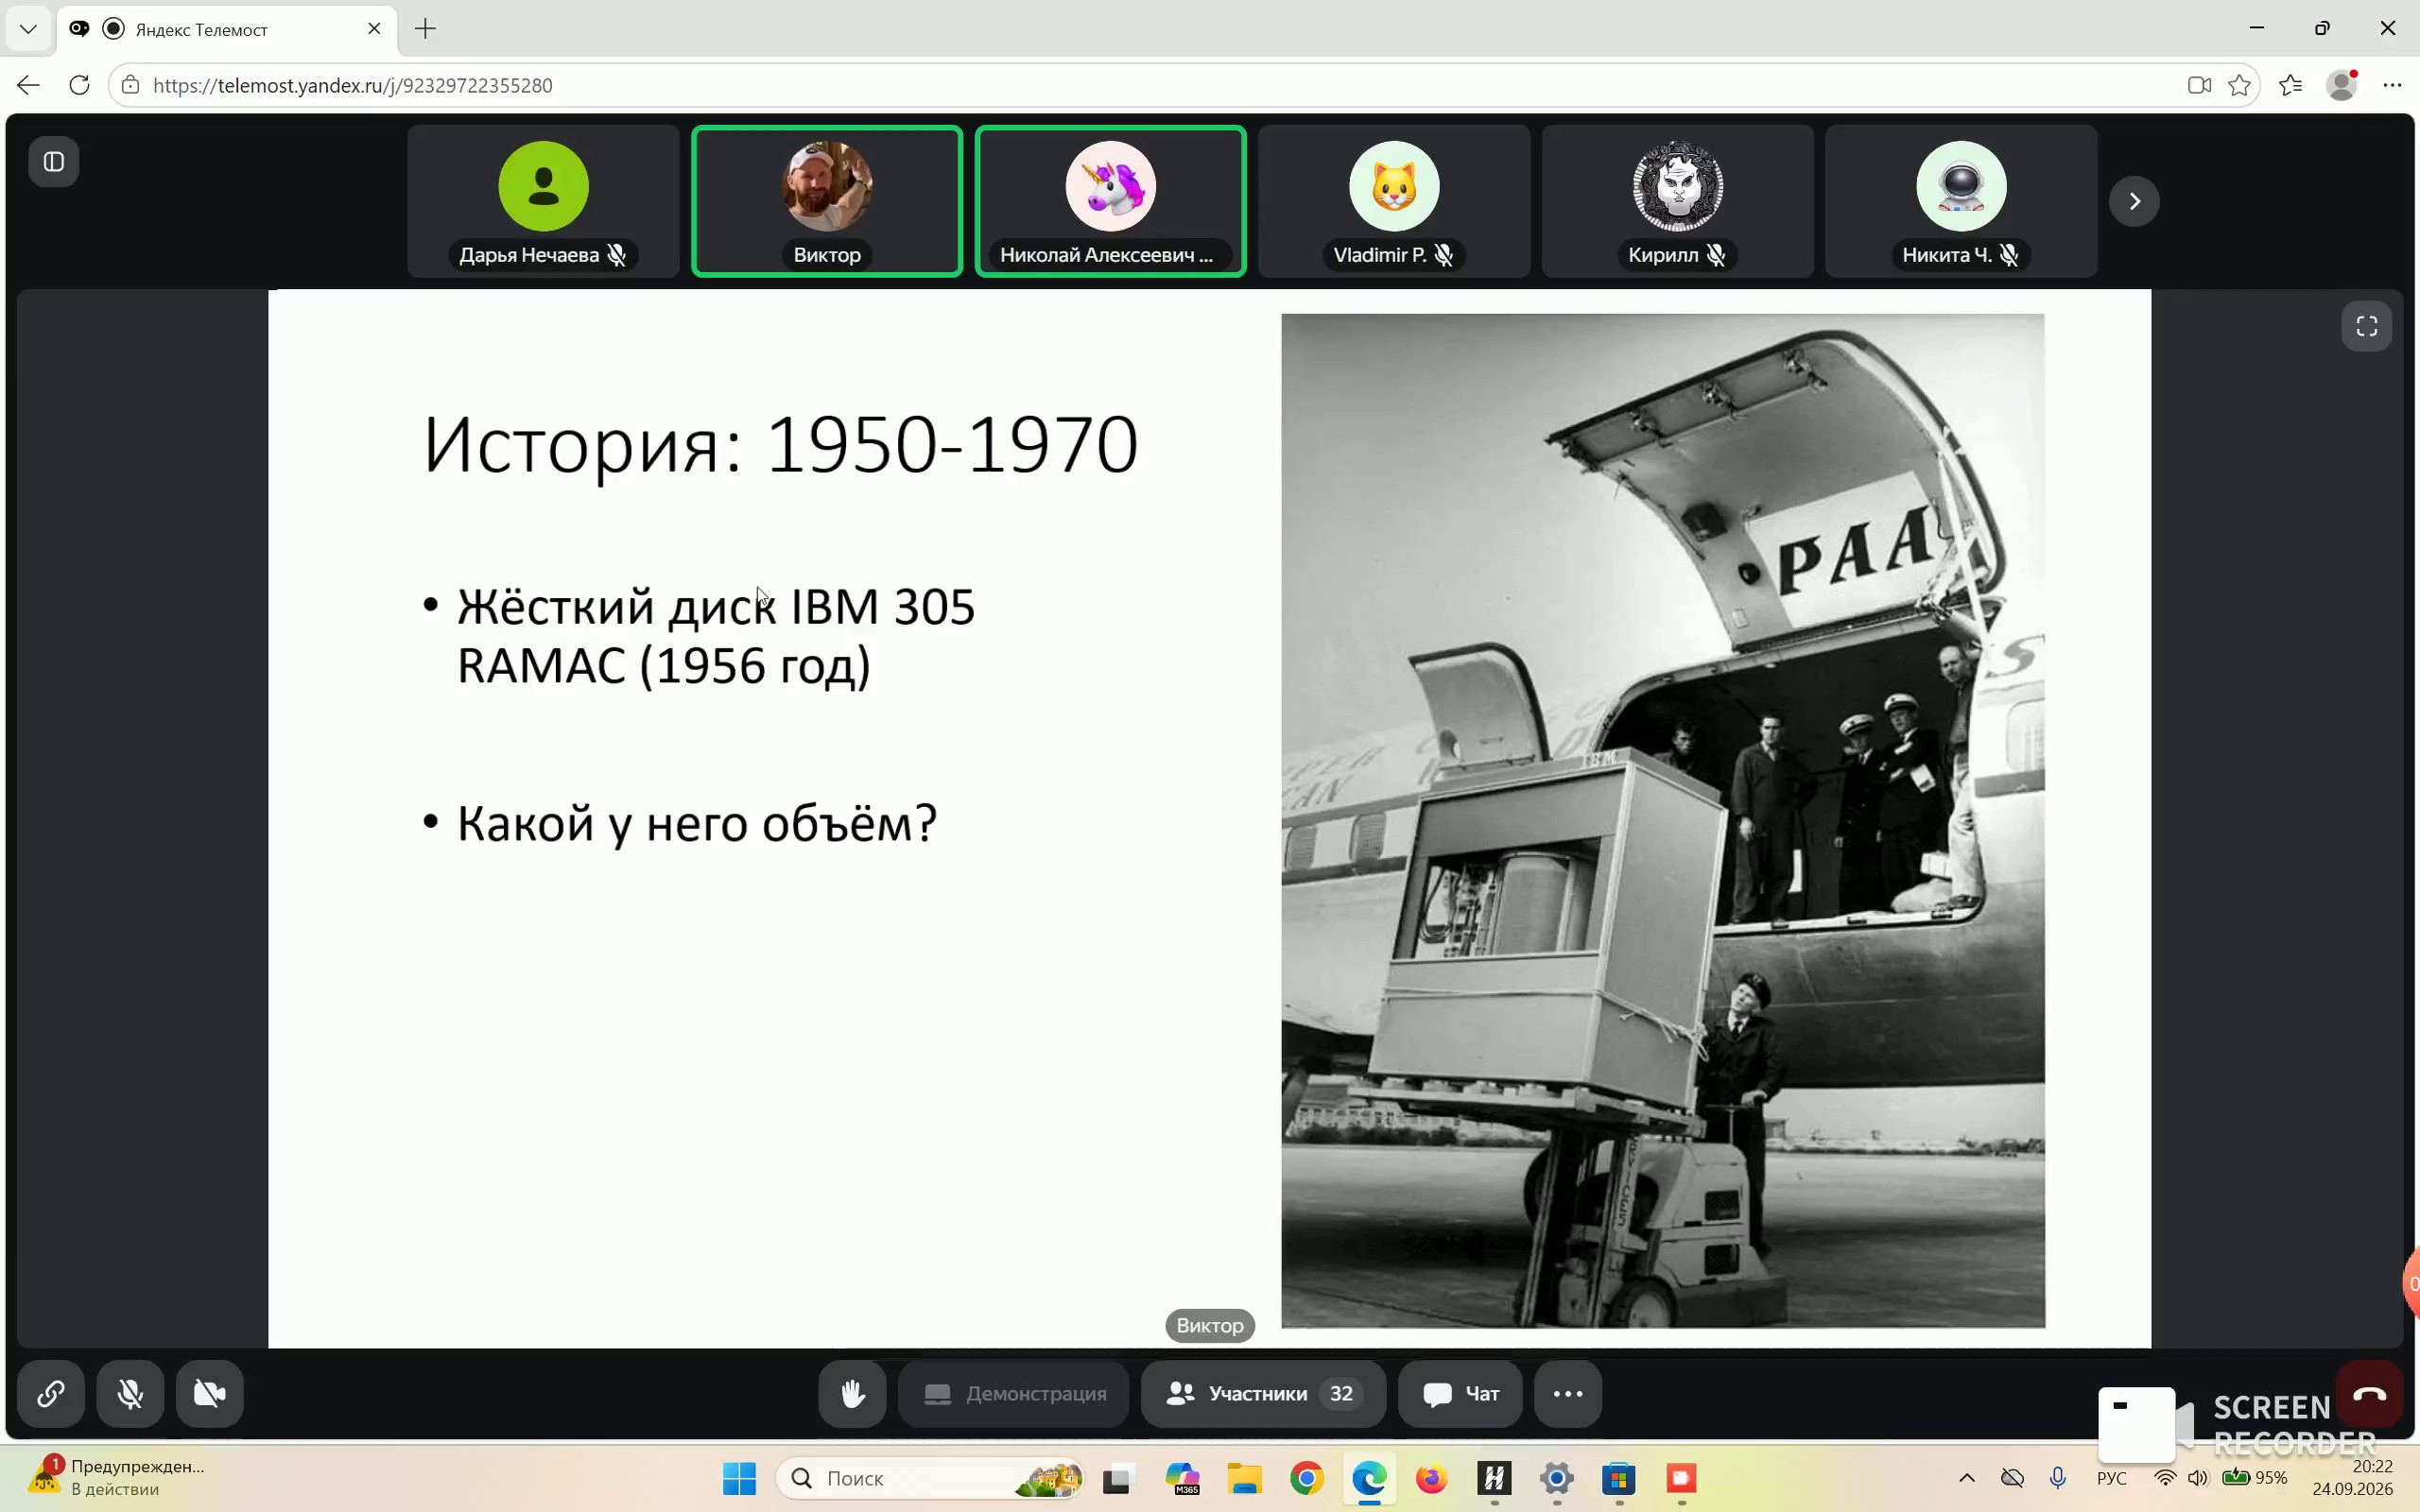
Этот объем считался очень большим на тот момент, достижением было то, что там находилось порядка 50 магнитных дисков. Весил этот накопитель около тонны и занимал шкаф размером с холодильник. Конечно же, сегодня какая-то фотография со смартфона может занимать гораздо больше памяти, чем весь этот накопитель, но на тот момент это считалось хорошим достижением и своего рода прорывом.
Если еще касаться истории 1950–1970-х годов, отличительной особенностью тех времен была склонность к централизации. Централизация подразумевала, что вычисления производились на одной центральной машине, данные тоже хранились на одной машине, а пользователи работали через терминалы. Все компоненты, о которых говорилось ранее — хранение, обработка и представление данных — были централизованными.
Развитие ЭВМ и появление персональных компьютеров (1970–2000 гг.)
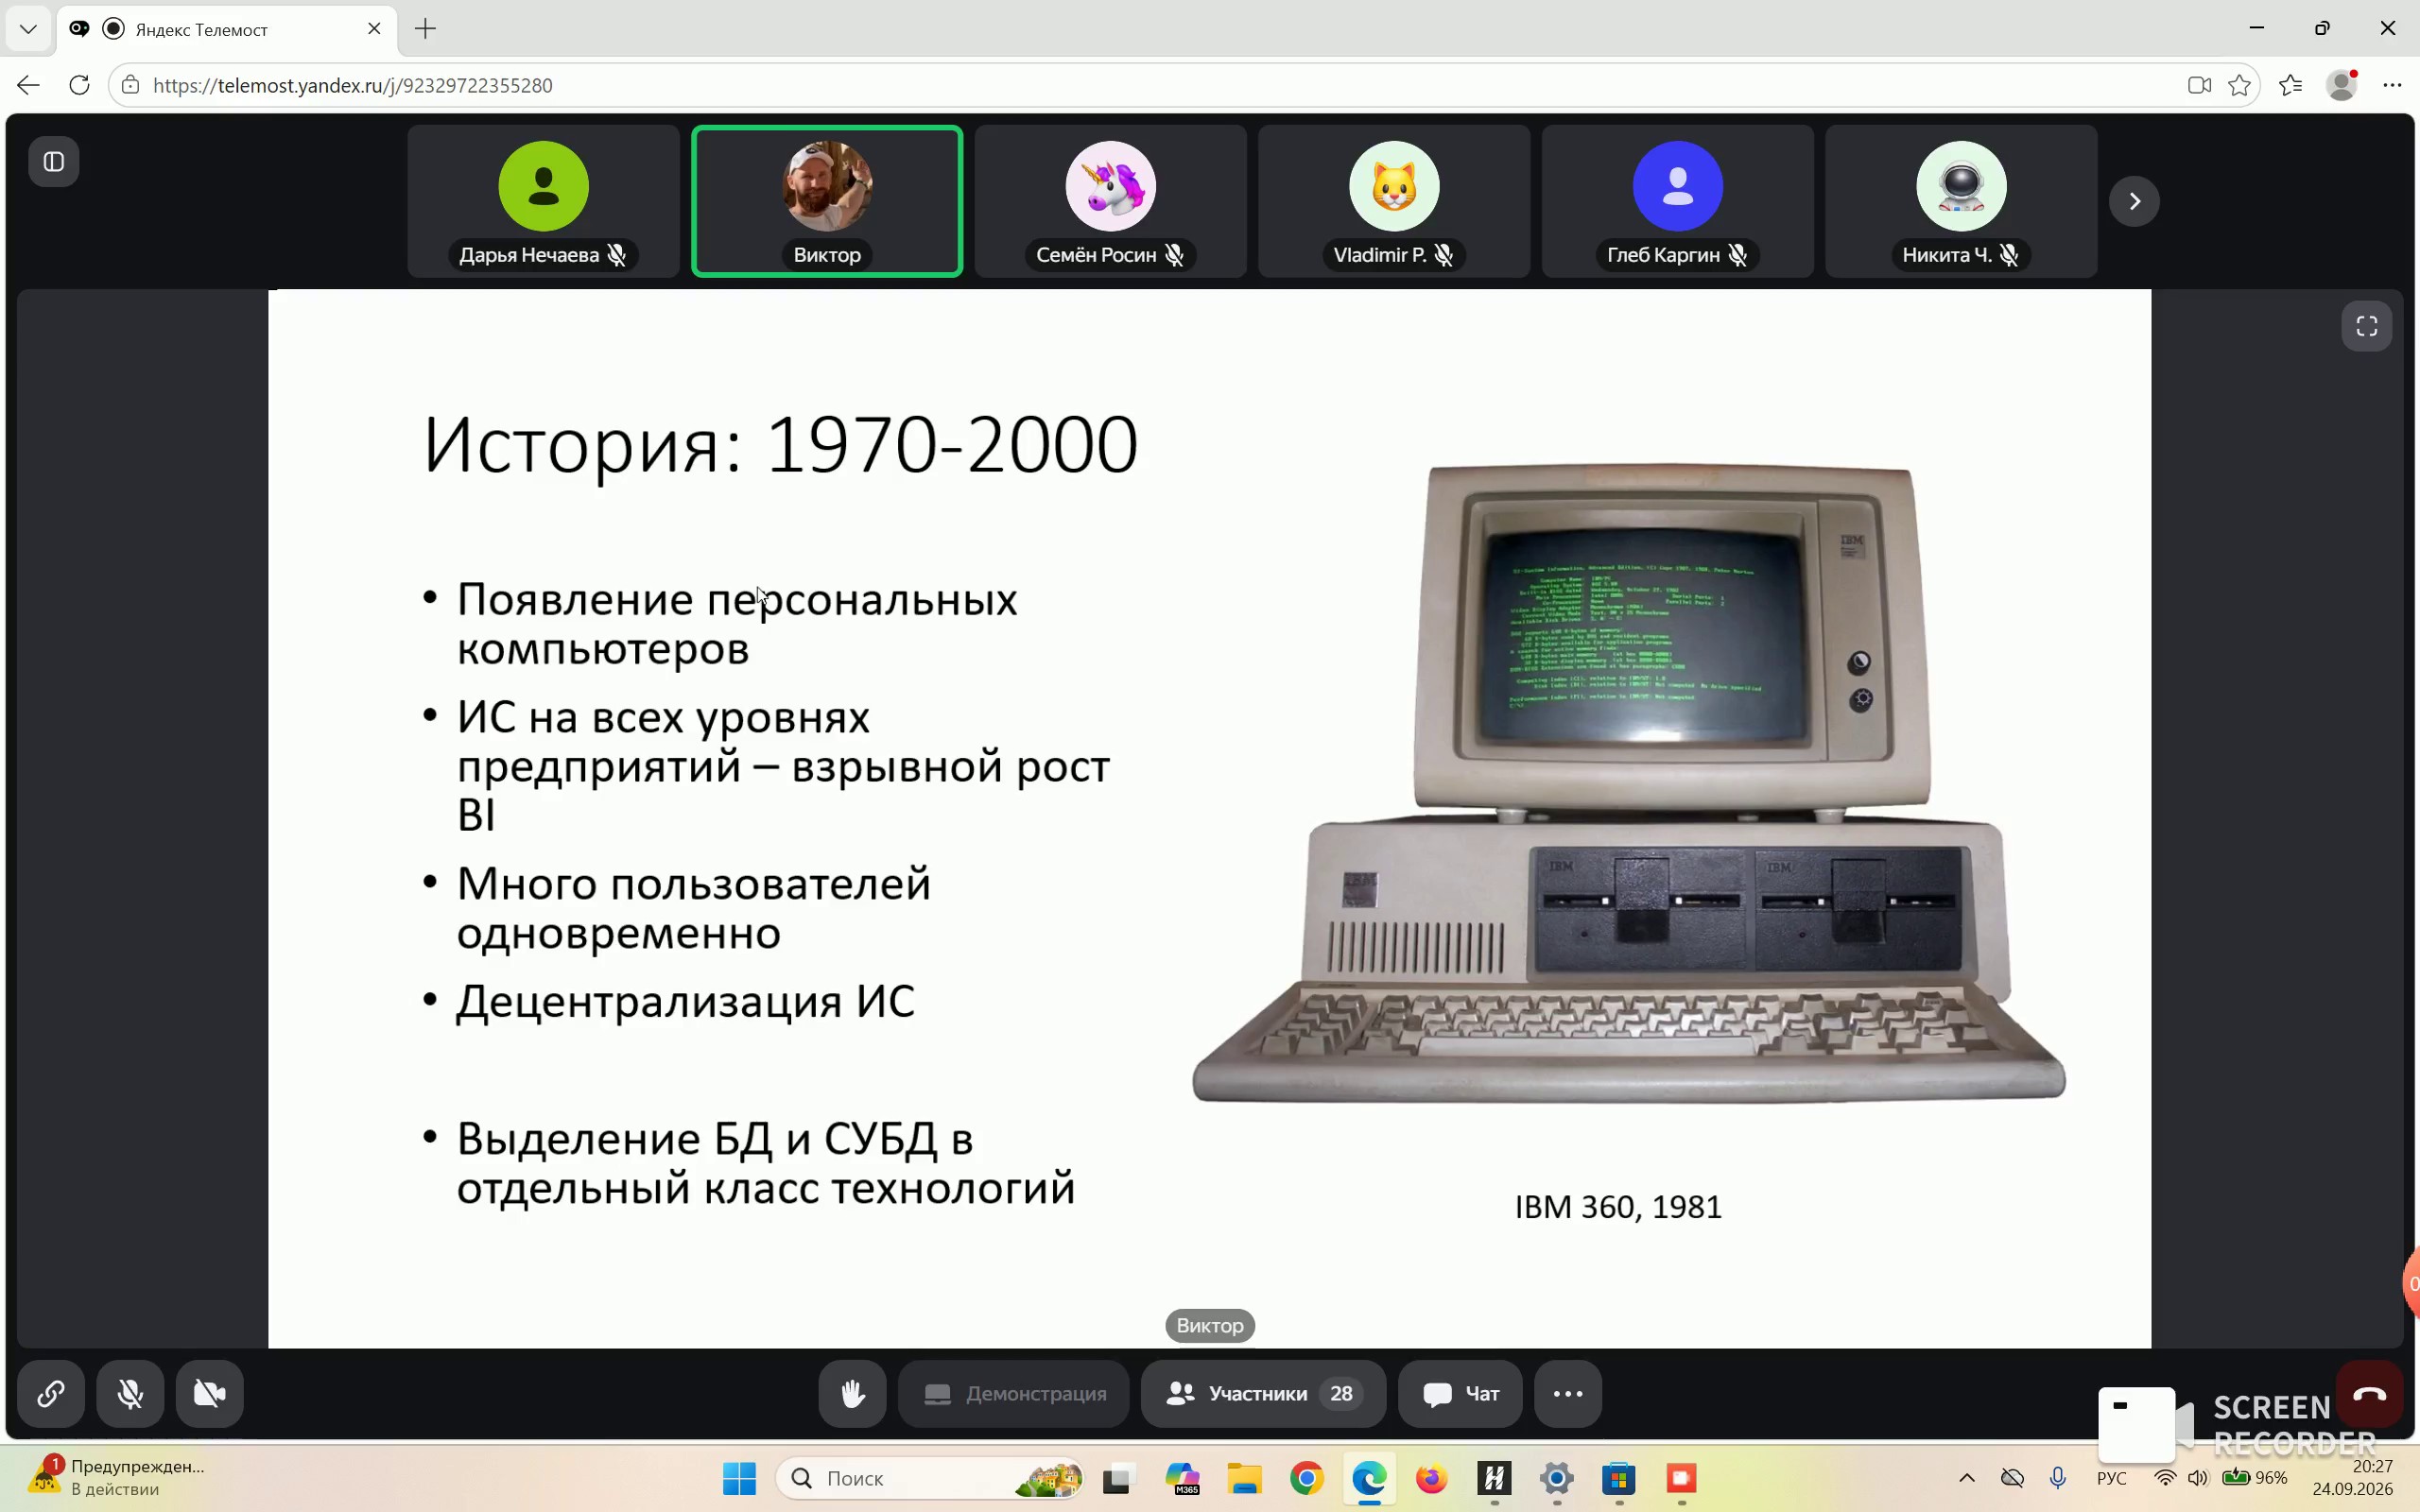
В период с 1970 по 2000 годы произошло важнейшее событие — появились персональные компьютеры, и их появление вызвало массовый интерес рядовых пользователей к компьютерной вычислительной технике. Это привело к тому, что у молодых людей, у детей и юношей, стали появляться компьютеры. Они росли, играли в игры, и им тоже хотелось делать что-то подобное. В общем, происходил такой массовый интерес к компьютерной вычислительной технике, который породил очень много различных маленьких ноу-хау. Когда много людей, одержимых какой-то одной идеей совершенствовать компьютерную технику, работают в одном направлении, естественно, у них не может что-то хорошее не получиться. Появление персональных компьютеров дало толчок инновационным идеям, как говорится, «снизу». То есть уже не какие-то ученые в области computer science где-то в лабораториях колдовали над компьютерами, но и простые умельцы как-то усовершенствовали компьютеры, привносили какие-то новшества.
Надо сказать, что на тот момент очень активно развивалась электроника, различные электронные устройства, радиодетали, появлялись транзисторы, полупроводники и прочие детали, и при желании компьютер можно было персонально собрать у себя в квартире своими руками, с помощью паяльника и [неясный фрагмент] по продвижению деталей. Лектор отмечает, что это очень сильное упрощение, но примерно суть была такая.
Появление персональных компьютеров вызвало взрывной рост развития компьютерной техники, и в том числе стали появляться информационные системы на предприятиях. Как указано на слайде, начался взрывной рост BI [возможная ошибка распознавания: возможно, имелось в виду ПК или IT, но сохранено оригинальное сокращение лектора]. Много пользователей стали работать одновременно, не мешая друг другу. Появление персональных компьютеров привело к тому, что информационная система, по сути, стала децентрализованной, то есть изменился сам подход, сам концепт взаимодействия с информационными системами. Ну и, конечно же, еще одно событие, важное для нашего курса, произошло — это выделение баз данных и систем управления.
Выделение СУБД и трехуровневая архитектура систем
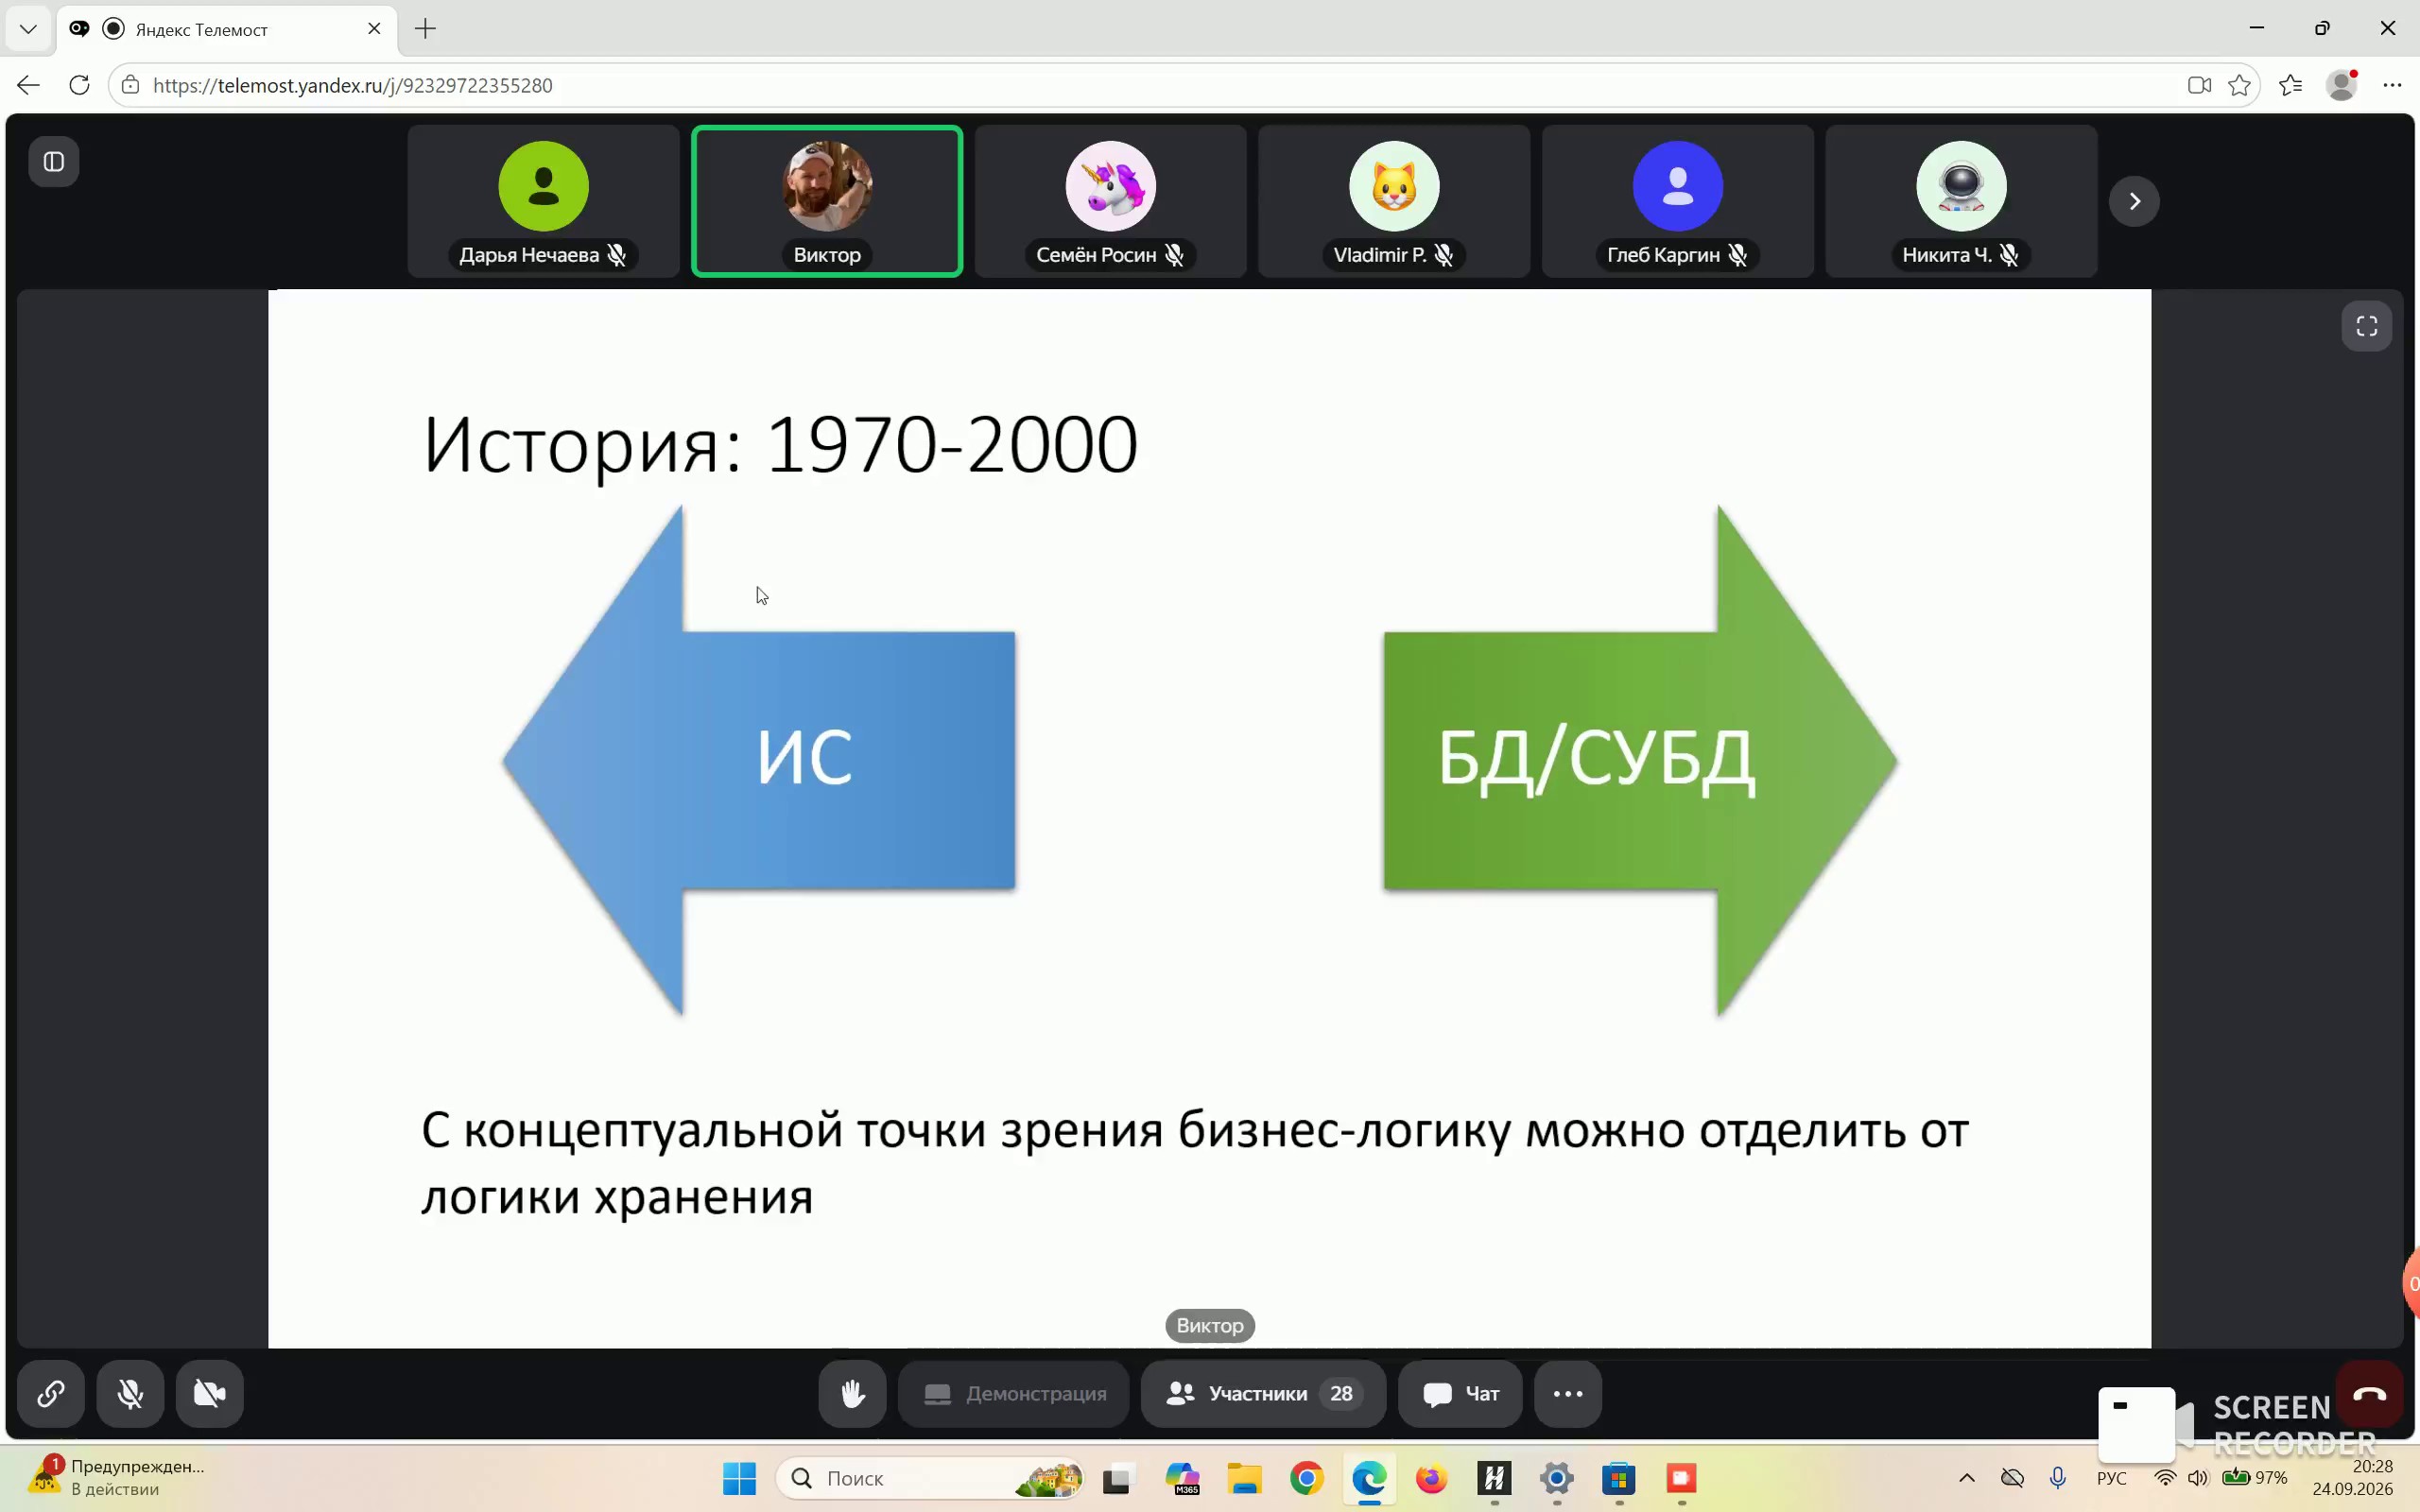
Выделение баз данных и системы управления базами данных в отдельный класс технологий является важным шагом, потому что в настоящее время информационная система, если ее представить комплексно, состоит из системы управления базами данных, какой-то бизнес-логики и слоя представления пользователям этой информации. Они стали жить, то есть система управления базами данных стала жить независимо от информационной системы — в достаточной степени независимо, потому что тогда это всё-таки были такие разнесенные логически по уровням, но очень жестко связанные физически вещи.
С концептуальной точки зрения бизнес-логику можно отделить от логики хранения. Это была такая революционная на тот момент идея, еще раз повторюсь. Сейчас для нас это разделение компонентов, когда слабая связанность компонентов, является само собой разумеющимся фактом, а тогда до этого нужно было еще додуматься. И, соответственно, появилась трехуровневая или трехзвенная архитектура: UI, бизнес-логика и хранилище данных. Собственно, вот такая идея в те годы появилась.
Основы баз данных и архитектура ANSI-SPARC
Определение базы данных
Что такое база данных? Это совокупность данных, хранимых в соответствии со схемой данных, манипулированием которыми выполняется в соответствии с правилами средств моделирования данных. Это определение из Википедии, и его можно рассказать на экзамене. При этом можно использовать и какое-то свое определение, которое будет рассказывать про базу данных и ни про что другое, это выбирайте, пожалуйста, сами, здесь приведено лишь одно из них.
С концептуальной точки зрения база данных представляет собой совокупность структурированной согласно определенной модели информации. О моделях мы чуть позже поговорим, и это может быть, например, модель некоторой предметной области, существующей в течение длительного времени.
Можно подойти к вопросу, что такое база данных, с технической точки зрения. Например, это файлы или область памяти определенного формата. То есть данные физически могут размещаться в файлах, могут размещаться на дисках, могут на страницах памяти, ну и, конечно же, могут еще и по-другому размещаться. Файл, в свою очередь, это именованная область внешней памяти. Что такое СУБД? [неясный фрагмент]
Понятие СУБД и ее отличие от БД
Если попытаться дать определение, что такое СУБД (система управления базами данных) по отношению к информационной системе или базе данных, то проще представить СУБД как некий контроль над более общим понятием баз данных. Это система, которая управляет тем, как у нас эти данные хранятся, отвечает за выполнение многих прав, в том числе за обеспечение консистентности данных, и соответственно эти данные нам по нашему запросу отдает или записывает обратно куда-нибудь, где эти данные хранятся. То есть это такая более объемная вещь по отношению к базам данных.
Если посмотреть на схему, то у нас есть некая Database, есть Database Management System (СУБД), а также есть пользователь, приложение и какое-то другое приложение. Одна система управления базами данных может вполне работать с несколькими пользователями и с несколькими источниками. Понятно, что здесь возникают вопросы конкурентности, с которыми мы обязательно познакомимся и подробно обсудим на дальнейших занятиях. Конечно же, приложения обычно не работают с файлами БД напрямую, они взаимодействуют через Database Management System, которая, в свою очередь, может работать через какую-нибудь ORM, например. Об этом мы тоже поговорим.
Если проводить разделение, то БД — это хранение данных, а система управления базами данных — это управление этой базой.
Сначала были базы данных, но не было СУБД. Во времена мейнфреймов в 50-70-е годы информация в БД хранилась в файлах. В принципе, никто особо не задумывался о структуре, потому что таких сложных задач не было, все было достаточно просто, линейно, и никаких проблем, связанных, например, с блокировками, не возникало. Формат файлов был специфичен для каждой программы. К чему это приводило? Это приводило к тому, что если мы изменяли формат файла, то нам нужно было переписать программу и сделать так, чтобы она работала с файлами нового формата, который мы вновь изобрели. Из-за этого возникала жесткая зависимость программ от данных, и структура файла фактически была захардкожена. Конечно, это не есть хорошо, и в тот момент возникла идея отделить хранение данных от их использования.
Физическая и логическая независимость данных
Отделить хранение данных от их использования приводит к идее физической независимости данных, которая является одной из основных в теории баз данных. Смена физического места хранения данных не оказывает влияние на пользователей. Но не только смена физического места хранения данных не должна оказывать влияние на пользователей, но еще и смена структуры хранения данных не должна тоже оказывать влияние на пользователей. То есть, меняем физическое место хранения, не замечаем этих изменений, меняем структуру хранения данных, тоже не замечаем этих изменений. Вот что такое, вот какие два тезиса скрываются за логической независимостью данных.
Логическая независимость данных значит, что изменение подсущности, точнее подсхемы одного пользователя не влияет на других пользователей, то есть пользователи могут работать с базой данных какой-то конкретно независимо друг от друга. Что такое подсхема? Подсхема — это некое представление базы данных для какого-то конкретного пользователя, ну, пусть даже приложения. То есть получается, он видит только те данные, которые ему нужно и видеть. Изменение этих данных никак не отражается на... если иное не сказано, если нам это не нужно, никак не отражается на данных другого пользователя.
Изменение концептуальной схемы, что это такое — тоже поговорим с вами, не влияет на пользователей, которых эти изменения не касаются. То есть, если у нас изменяется концептуальная схема для каких-то отдельных пользователей, то другие, значит... Ну, концептуальная схема — это вот, забегу вперед немножко скажу, логическая единая моделька всей нашей базы данных. Но, собственно, если мы там что-то меняем для какого-то пользователя, эти изменения не отражаются на других пользователей, они их не замечают. Трехуровневая архитектура ANSI-SPARC. Действительно, в
Трехуровневая архитектура ANSI/SPARC
Трехуровневая архитектура ANSI/SPARC представляет собой концепт уровней представления данных в СУБД, идея которого родилась в 70-х годах. Это не трехслойная архитектура, а именно уровни представления данных.
В рамках этой архитектуры выделяется экстернал (external) — представление конкретных пользователей от одного до $N$. Также выделяется концептуальная схема — логическая модель нашей базы данных. Следующий компонент — интернал-схема (internal), определяющая, как данные организованы уже внутри какой-то конкретной системы управления базами данных: файлы, организация страниц, индексы, способы доступа и прочее, то, что будет изучаться на курсе. Далее происходит спуск на физический уровень — то, как эти данные непосредственно хранятся в какой-то конкретной базе данных.
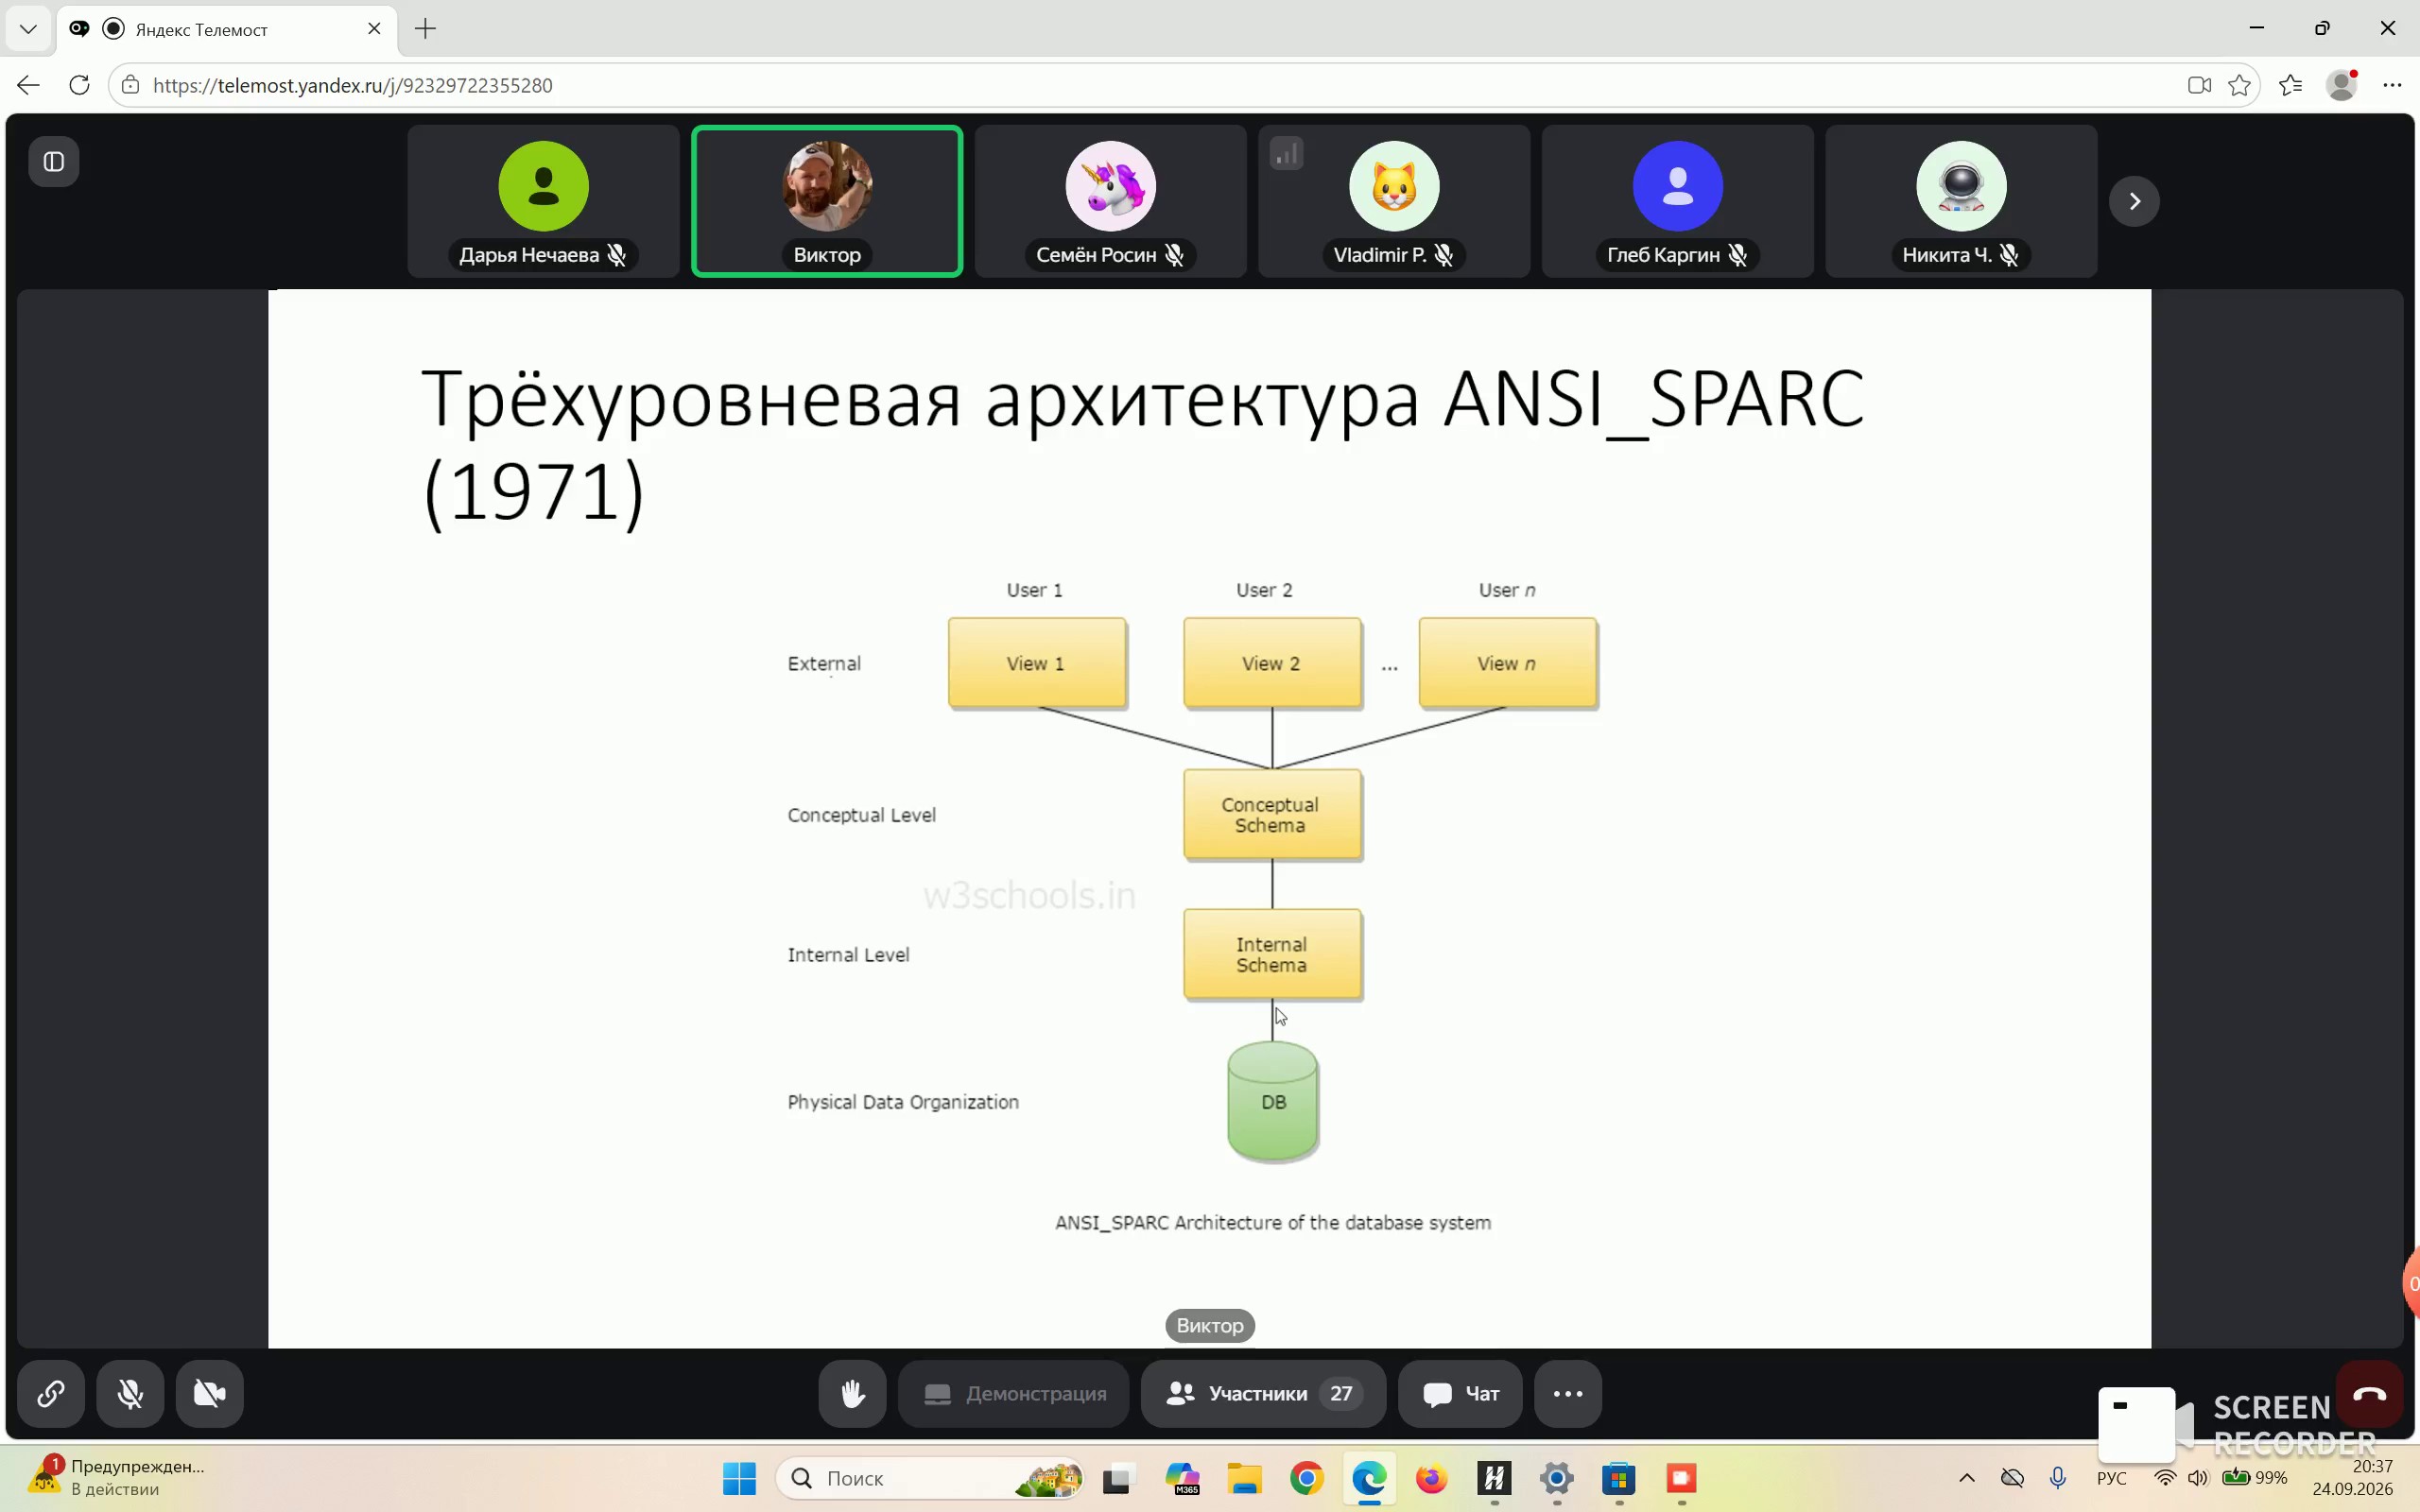
Более подробно архитектура ANSI/SPARC делится на несколько уровней. Внешний пользовательский уровень представления данных включает в себя внешнюю схему, которая хранит структуры данных, предоставляемые приложению. Это так называемая инфологическая модель данных. Если говорить по-простому, то инфологическая модель описывает некую предметную область, не привязываясь к какой-то конкретной СУБД. В рамках курса будет подробно рассматриваться инфологическая модель: сущности, отношения с сущностями, связи, атрибуты сущностей, различные бизнес-правила и виды отношений, такие как один к одному или один ко многим, которые составляют основу инфологической модели.
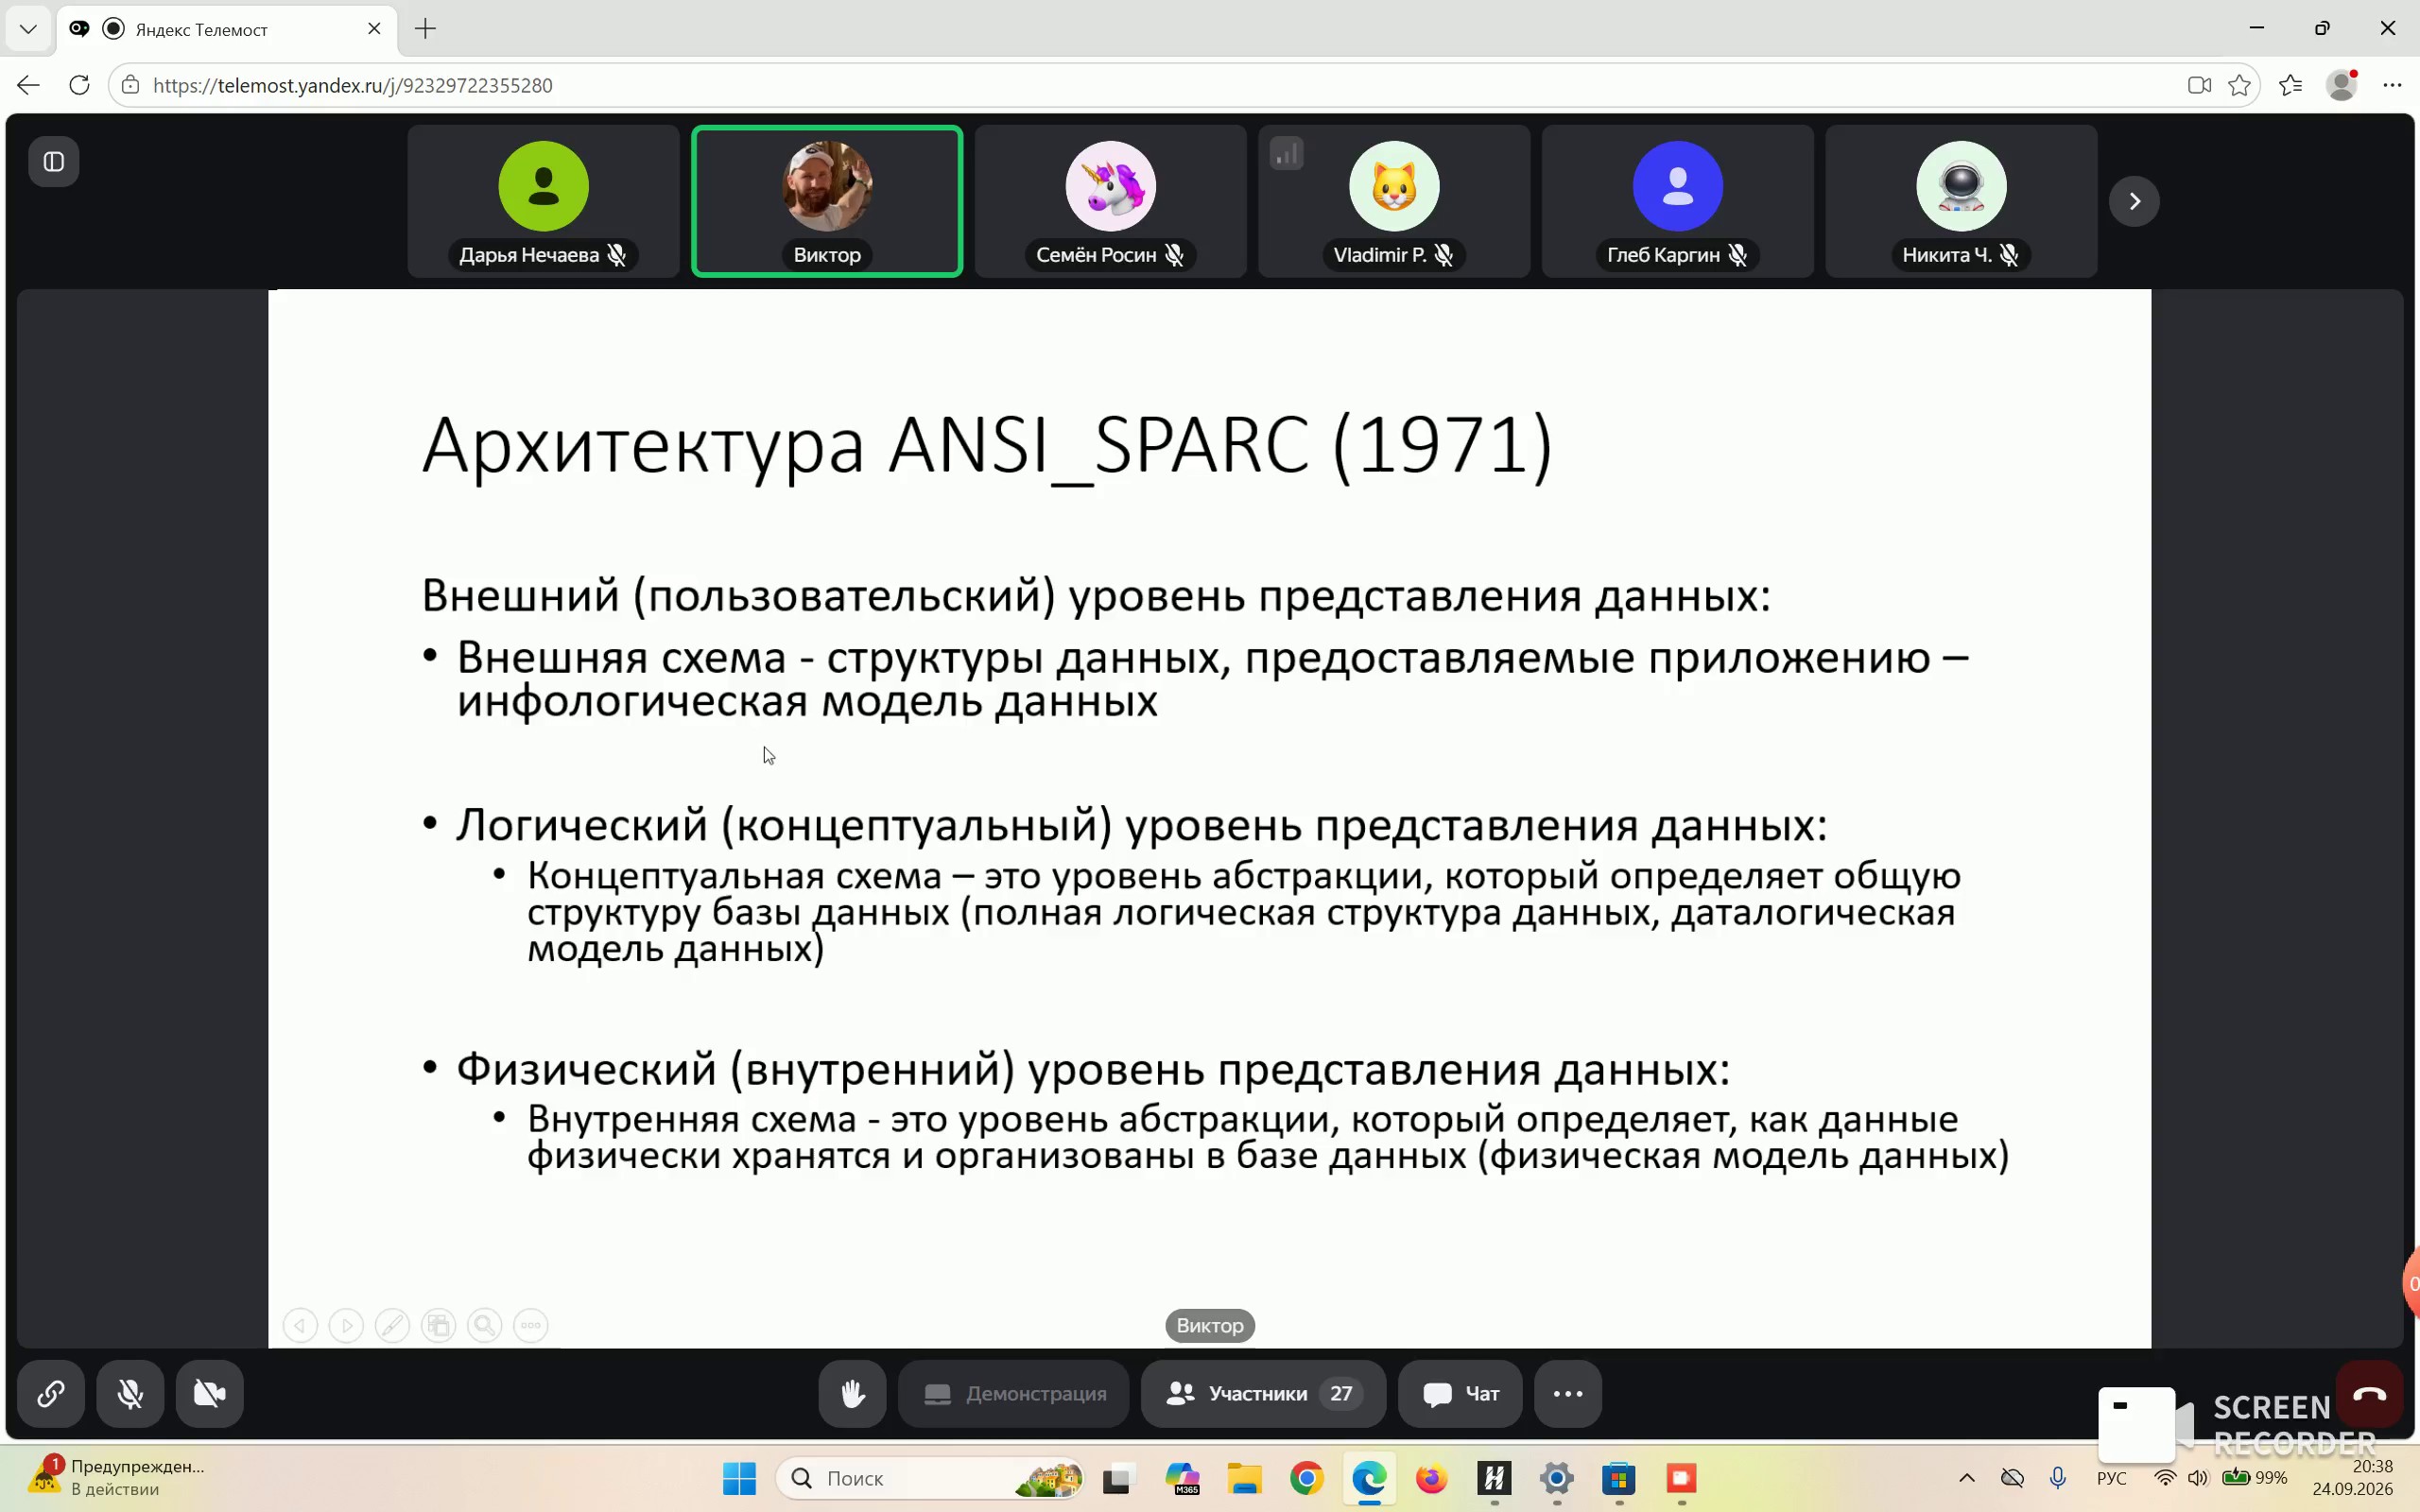
Далее идет логический или концептуальный уровень, или, как еще говорят, датологическая модель данных. Это уровень абстракции, который определяет общую структуру базы данных. Если говорить по-простому, здесь дается ответ на вопрос, как какая-то предметная область представлена в выбранной модели данных. Для примера: если создана инфологическая модель с сущностями и связями, то при выборе реляционной базы данных появляются таблицы, столбцы, первичные и внешние ключи, а также определенные соотношения между ними.
Завершает архитектуру физический внутренний уровень представления данных — уровень абстракции, определяющий, как данные физически хранятся и организованы в базе данных, то есть физическая модель данных.
Отступление от темы
если говорить о значит истории появления на субботы на вот так в 1974 году году появилась система вот может быть кто-то знает кто
История развития и эволюция СУБД
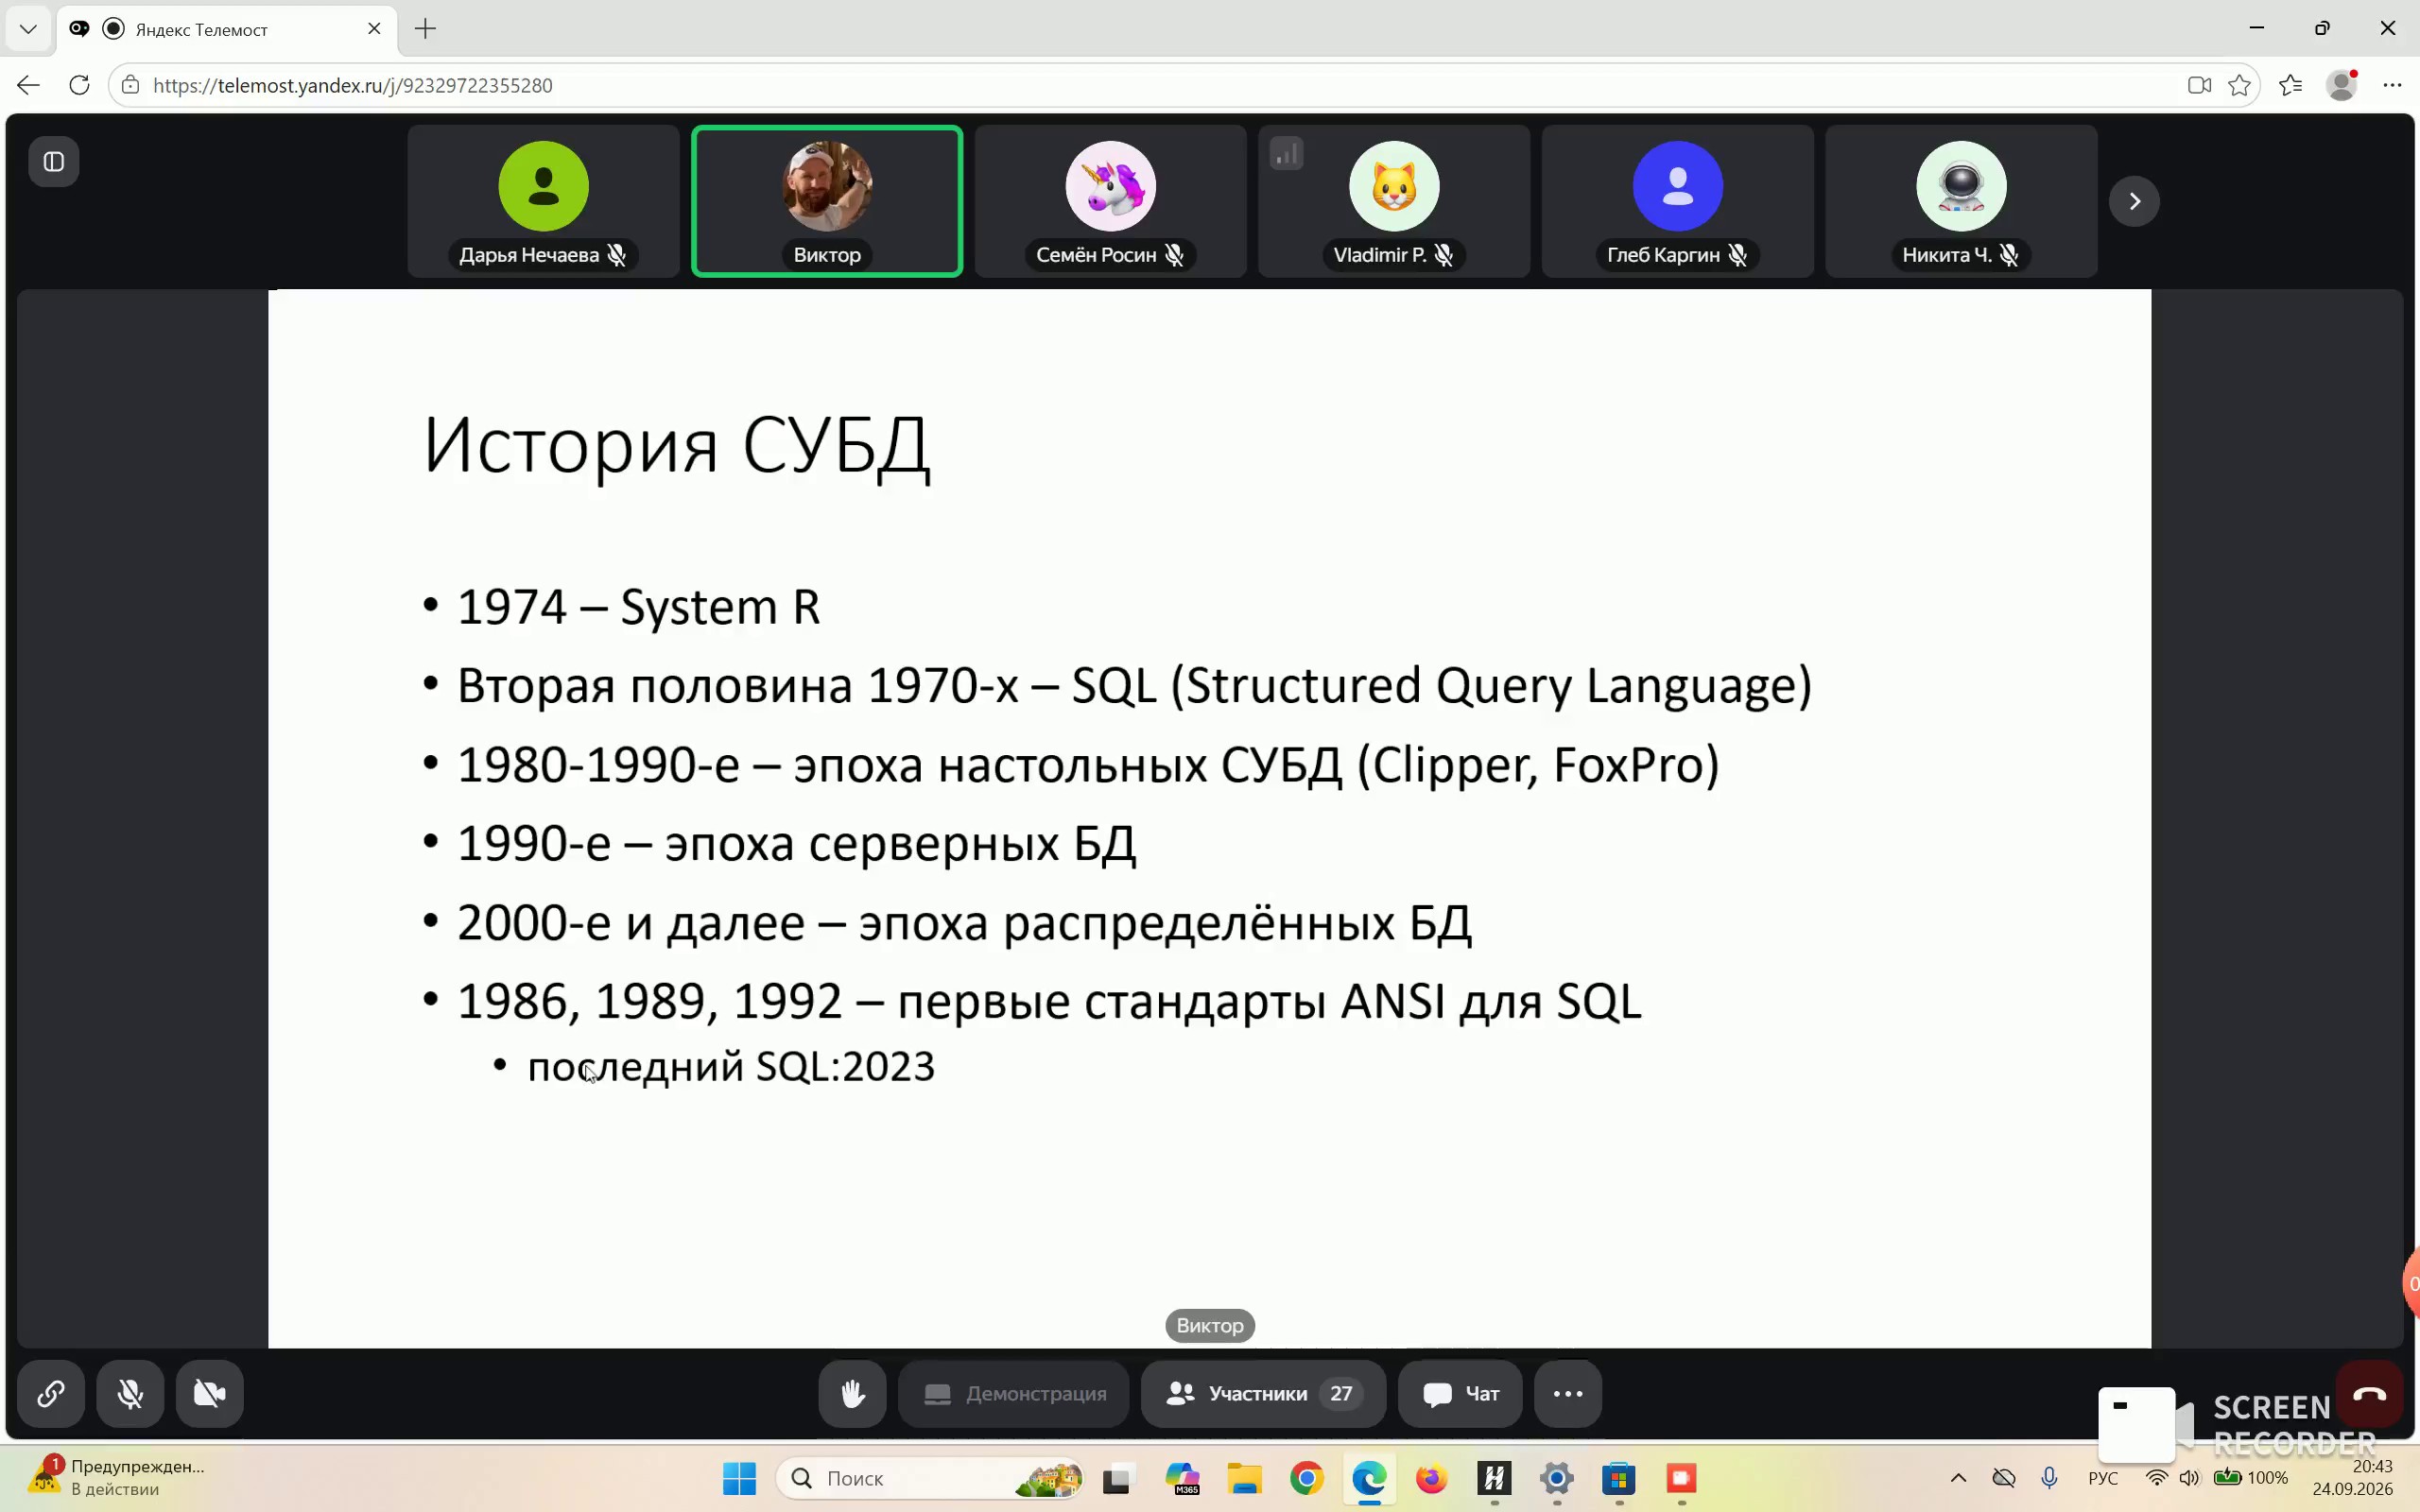
История развития СУБД и появление SQL
В 1974 году появилась система System R, которая стала прообразом современных баз данных. Принято считать, что именно от этой системы ведется отсчет развития систем управления базами данных. Во второй половине 70-х годов появился язык SQL — декларативный язык. В отличие от императивных языков и императивной парадигмы программирования, в декларативном языке мы лишь задаем то, что мы хотим получить, а то, как это произойдет и как будет сделано, отдается на откуп СУБД.
Отступление от темы
Значит истории появления на субботы на... вот так в 1974 году году появилась система вот может быть кто-то знает кто ее значит прародитель вместе честно вылетела из главы этой информации ну ладно, в общем...
В 80-е и 90-е годы наступила эпоха настольных СУБД, таких как Clipper и FoxPro, например. В 90-е годы стали появляться серверные базы данных, что, конечно же, связано с возникновением и развитием клиент-серверной архитектуры напрямую. 2000-е годы и далее — это уже эпоха распределенных баз данных.
Отступление от темы
Ну, я бы сюда Я добавил еще 2010-2020 годы. Это эпоха облачных СУБД. И добавил бы сюда еще один период. Это 20-30-е Это годы. бигдата. Это обработка данных с помощью технологии искусственного интеллекта. И эти пару периодов. Я вам на слайд добавлю. Почему я говорю добавлю? Потому что этот курс мне достался по наследству от Юрия Сартасова, который раньше его считал. И я еще не все слайды успел переработать, дополнить какую-то информацию, которую хотел бы. Поэтому говорю эту информацию на словах. Вот давайте перед отправкой я вам эту информацию на слайдик добавлю про периоды.
В 1986, 1989 и 1992 годах стали появляться первые стандарты ANSI для SQL. Последний на данный момент стандарт — SQL:2023.
Отступление от темы
Проверьте, пожалуйста, кто-нибудь загуглите, действующий вот этот стандарт или нет. потому что мы с ребятами проверяли в том году, был 23-й. Ничего не поменялось с тех пор. Кто быстренько сможет проверить? — 23-й. — 23-й, да? Ну, хорошо. Значит, вставляем эту информацию и принимаем ее за актуальную. Идем дальше.
Эволюция баз данных: от распределенных систем к NoSQL
В 2000-е годы родилась достаточно революционная идея по распределенному хранению и обработке данных, например, резервирование данных в географически удаленных центрах обработки данных. Это было связано в том числе с различными архитектурными аспектами, которые предписывали размещать данные как можно ближе к пользователю для того, чтобы вся эта информация быстрее доставлялась до пользователя, и он не испытывал задержек, связанных с передачей информации по сети, в том числе из-за ее далекого расположения.
Отступление от темы
что, говорите, не сейчас развиваются, но сейчас уже такой период зрелости этих технологий.
Стали появляться облачные информационные системы. Тогда это было действительно революционное изобретение, и в 2010–2020 годы облачные технологии очень бурно развивались, хотя сейчас они находятся в периоде зрелости.
В этот период стали появляться NoSQL-базы данных, то есть нереляционные системы управления базами данных. Прежде всего это было связано с развитием технологий Big Data, появлением большого количества разреженных данных — тех данных, которые содержали неопределенные различные значения или вообще этих значений не было. То есть мы не могли их обрабатывать обычным привычным способом и не могли построить реляционные модели отношений. Конечно, появление NoSQL баз данных связано не только с этим, а об аспектах их появления, конкретных базах данных и том, чем они отличаются друг от друга, мы поговорим ближе к концу курса.
Причины развития баз данных и современная статистика
Причины развития технологий баз данных
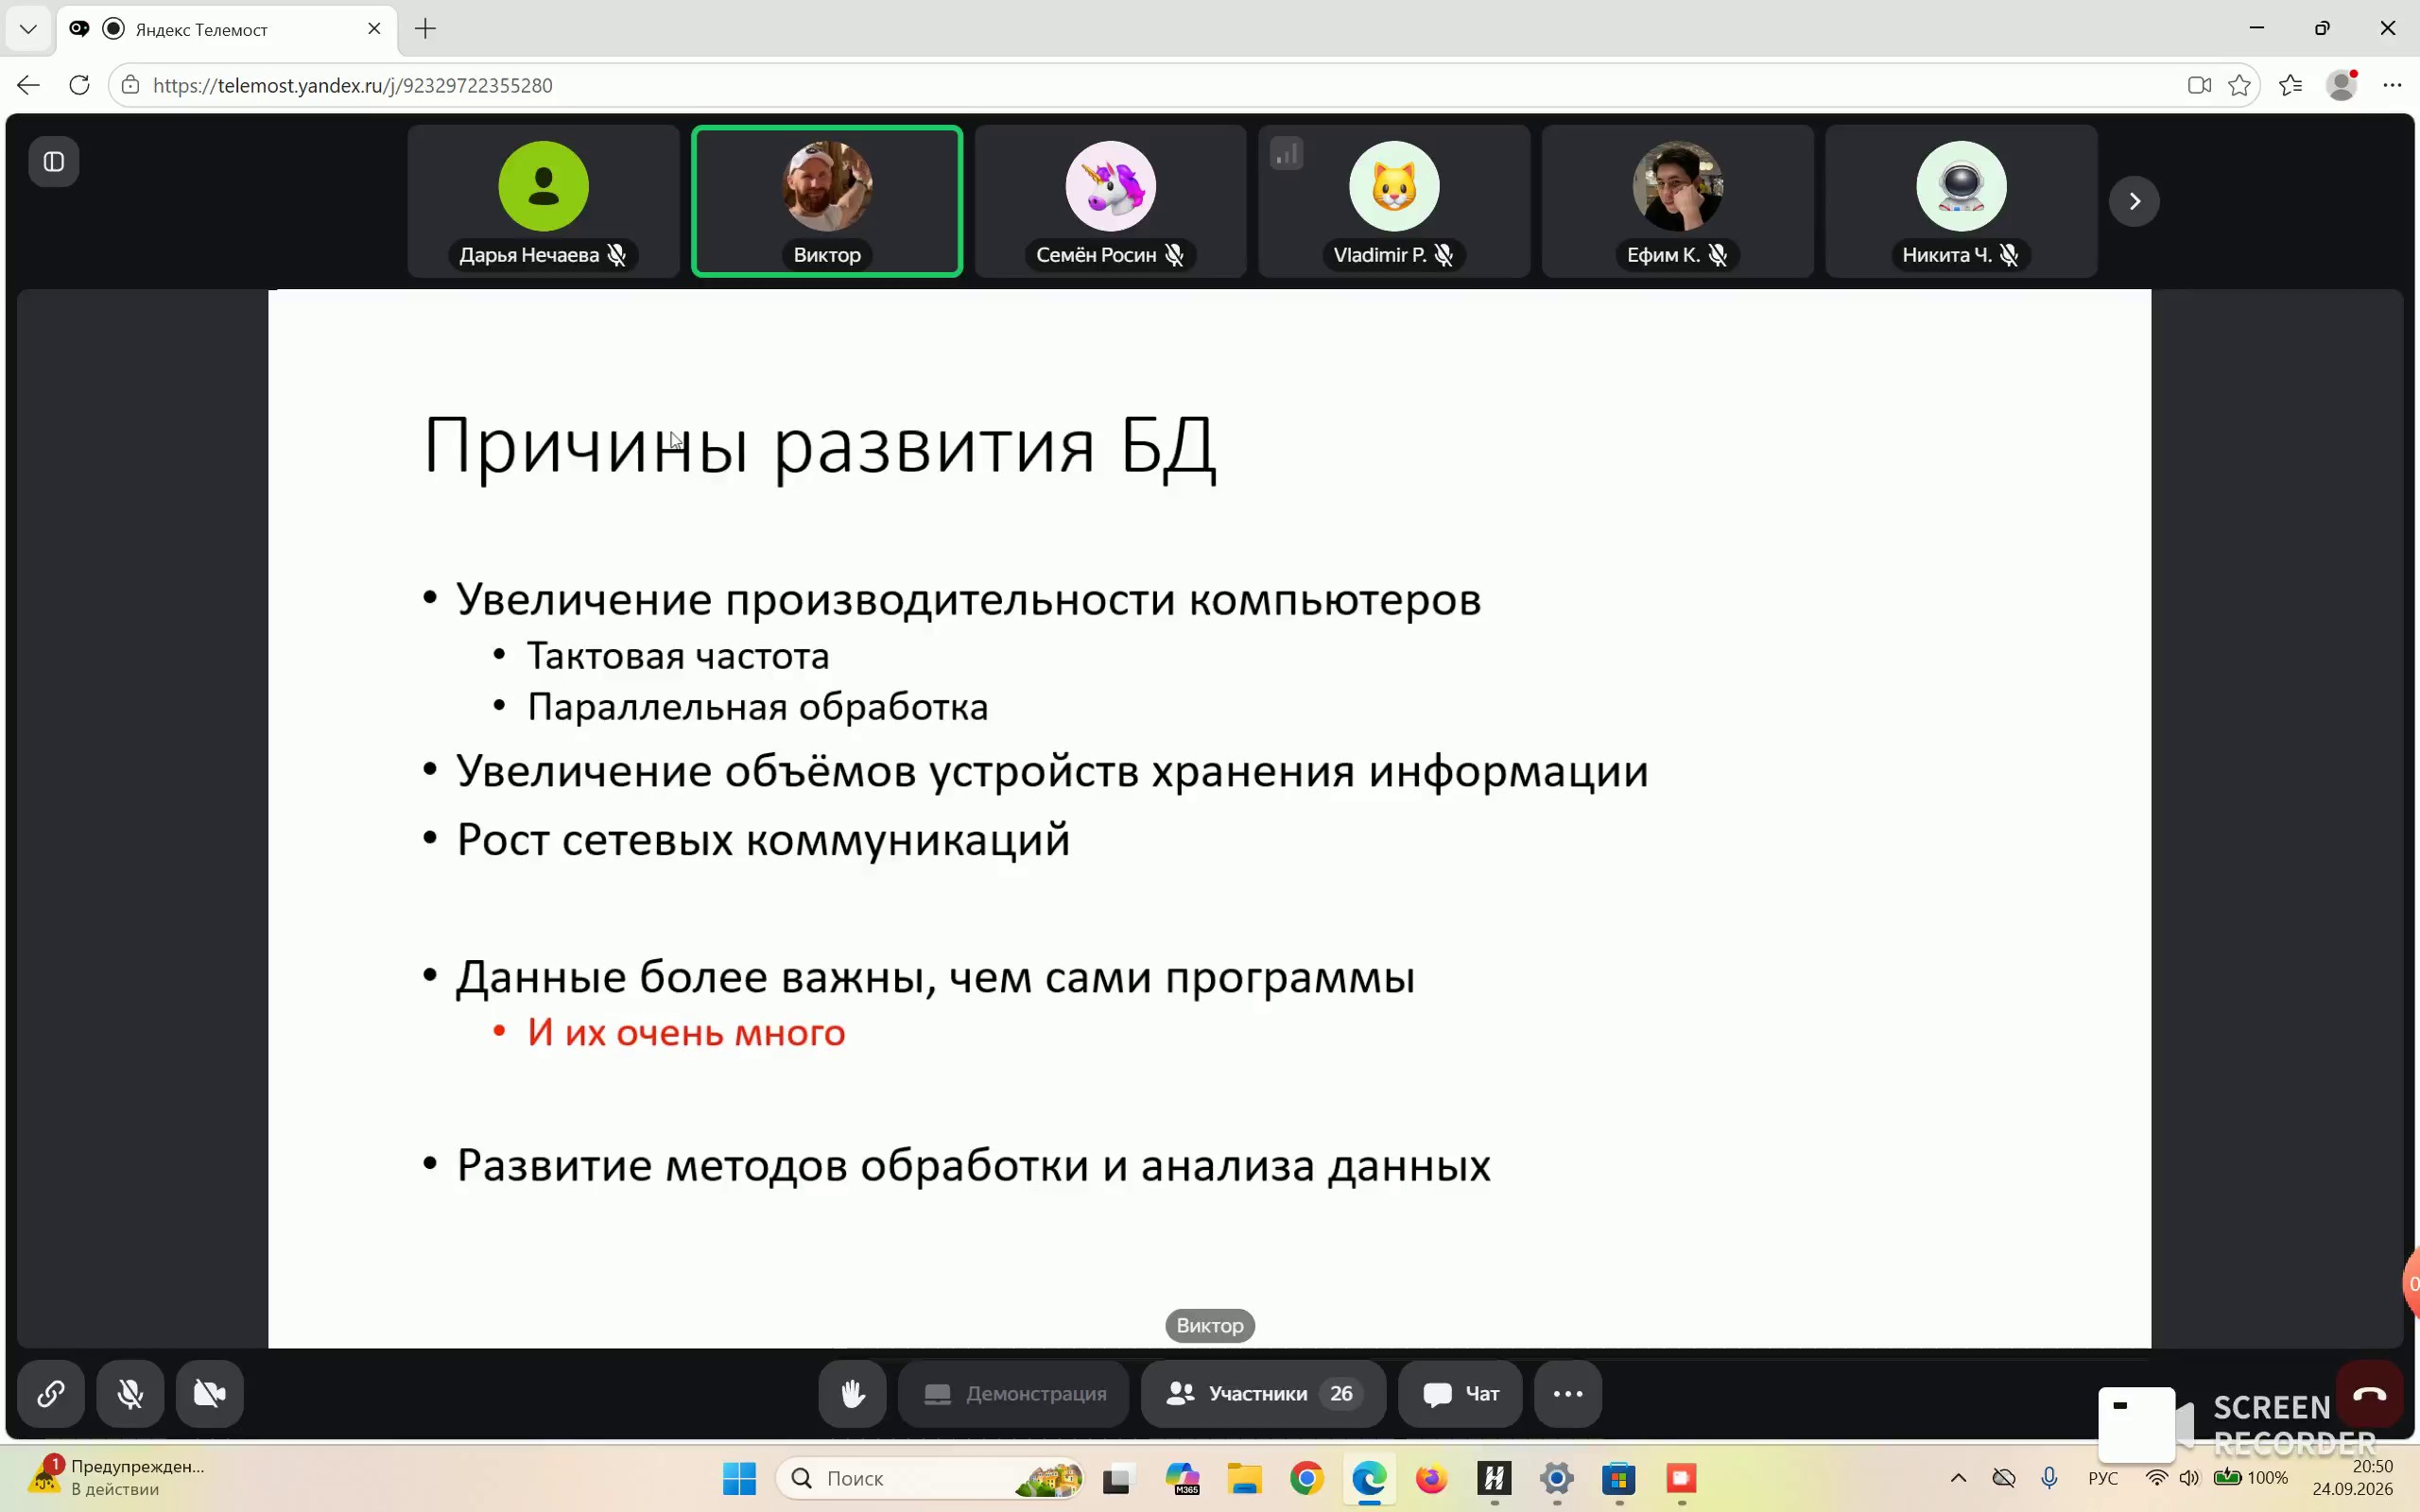
Прежде всего, причиной развития технологий баз данных стало увеличение производительности компьютеров. Стала увеличиваться тактовая частота, появились идеи параллельной обработки данных, и базы данных должны были идти в ногу с этими более быстрыми обработчиками.
Также увеличился объем устройств хранения информации. От достаточно примитивных хранилищ на жестком диске мы пришли к современным устройствам хранения информации, на порядки превышающим несчастные пять мегабайт, что тоже послужило одной из причин развития баз данных.
Рост сетевых коммуникаций, персональные компьютеры и интернет привели к тому, что люди стали больше общаться по сети друг с другом. Сейчас мы даже не представляем, как жили раньше, звоня кому-то по обычным стационарным телефонам, и конечно же, всё это привело к развитию баз данных.
Данные стали более важны, чем сами программы, и их очень много. Мы привыкли смотреть на приложение как на нечто самодостаточное, но на самом деле в современную эпоху приложение — это всего лишь некий обработчик данных, обработчик информации и некий удобный для пользователя интерфейс. Задача любой программы — обрабатывать данные и соответствующим образом в удобном формате предоставлять их пользователю, поэтому тезис о том, что данные стали более важны, чем сами программы, имеет ключевое значение.
Ещё одной из причин развития технологий баз данных является развитие методов обработки и анализа данных.
Отступление от темы
Ну, давайте подумаем, а какие еще, например, пару причин могли послужить причинами развития баз данных. Как вы считаете, что еще могло быть причиной развития баз данных помимо приведенных здесь? [...] Ладно, подумайте об этом на досуге, вот что еще могло послужить причинами развития технологий баз данных вот помимо причин приведенных здесь, ну и если попадется вопрос на экзамене, будет что интересное рассказать. Статистика
Статистика объемов данных и Big Data
Отступление от темы
на экзамене будет что интересное рассказать.
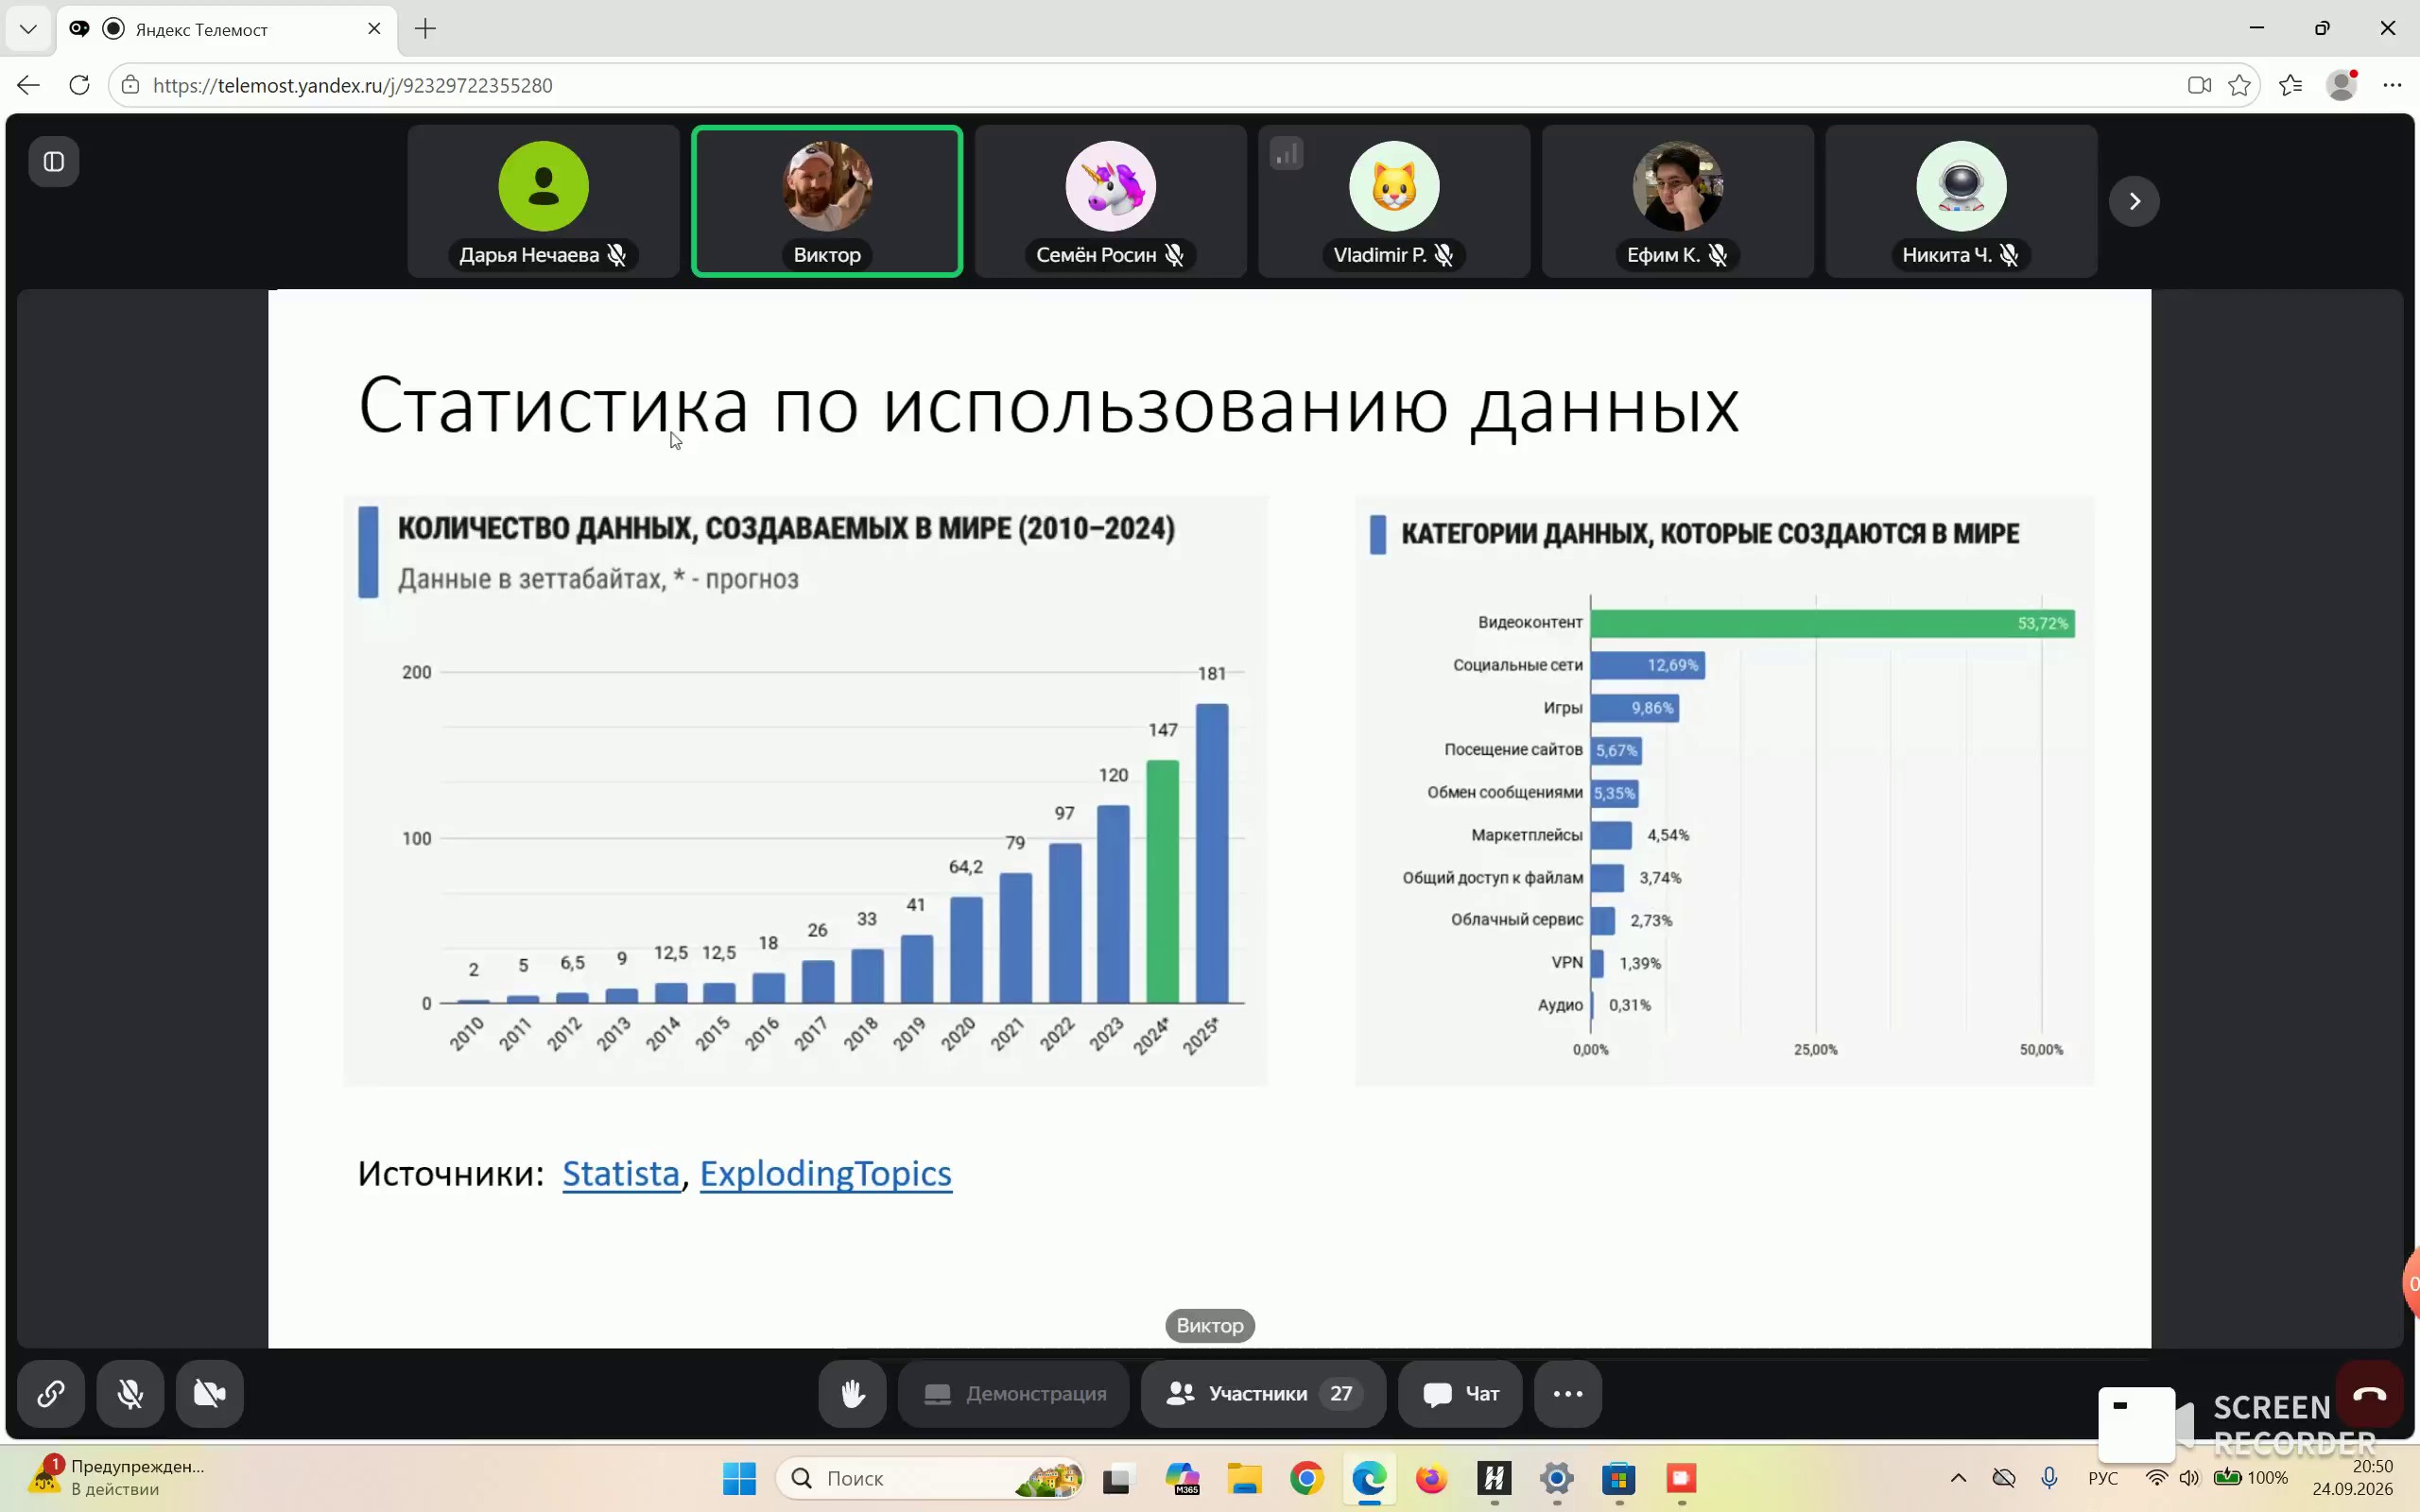
Статистика по использованию данных интересна прежде всего тем, что количество данных, создаваемых в мире, неуклонно растет. Данные на 2025 год приведены на диаграмме, но если брать какой-нибудь 2026 год, то этих данных будет, наверное, раза в два больше, чем прогнозно в 2025 году.
Отступление от темы
Кому интересно, тоже проверьте эту информацию.
Интересно посмотреть на категории данных, которые создаются в мире. Больше всего создается видеоконтента — это половина всех создаваемых в мире данных. Далее идут соцсети, игры, посещение сайтов и прочие вещи, которые приведены на данной диаграммке. То есть видеоконтента создается, получается, больше всего.
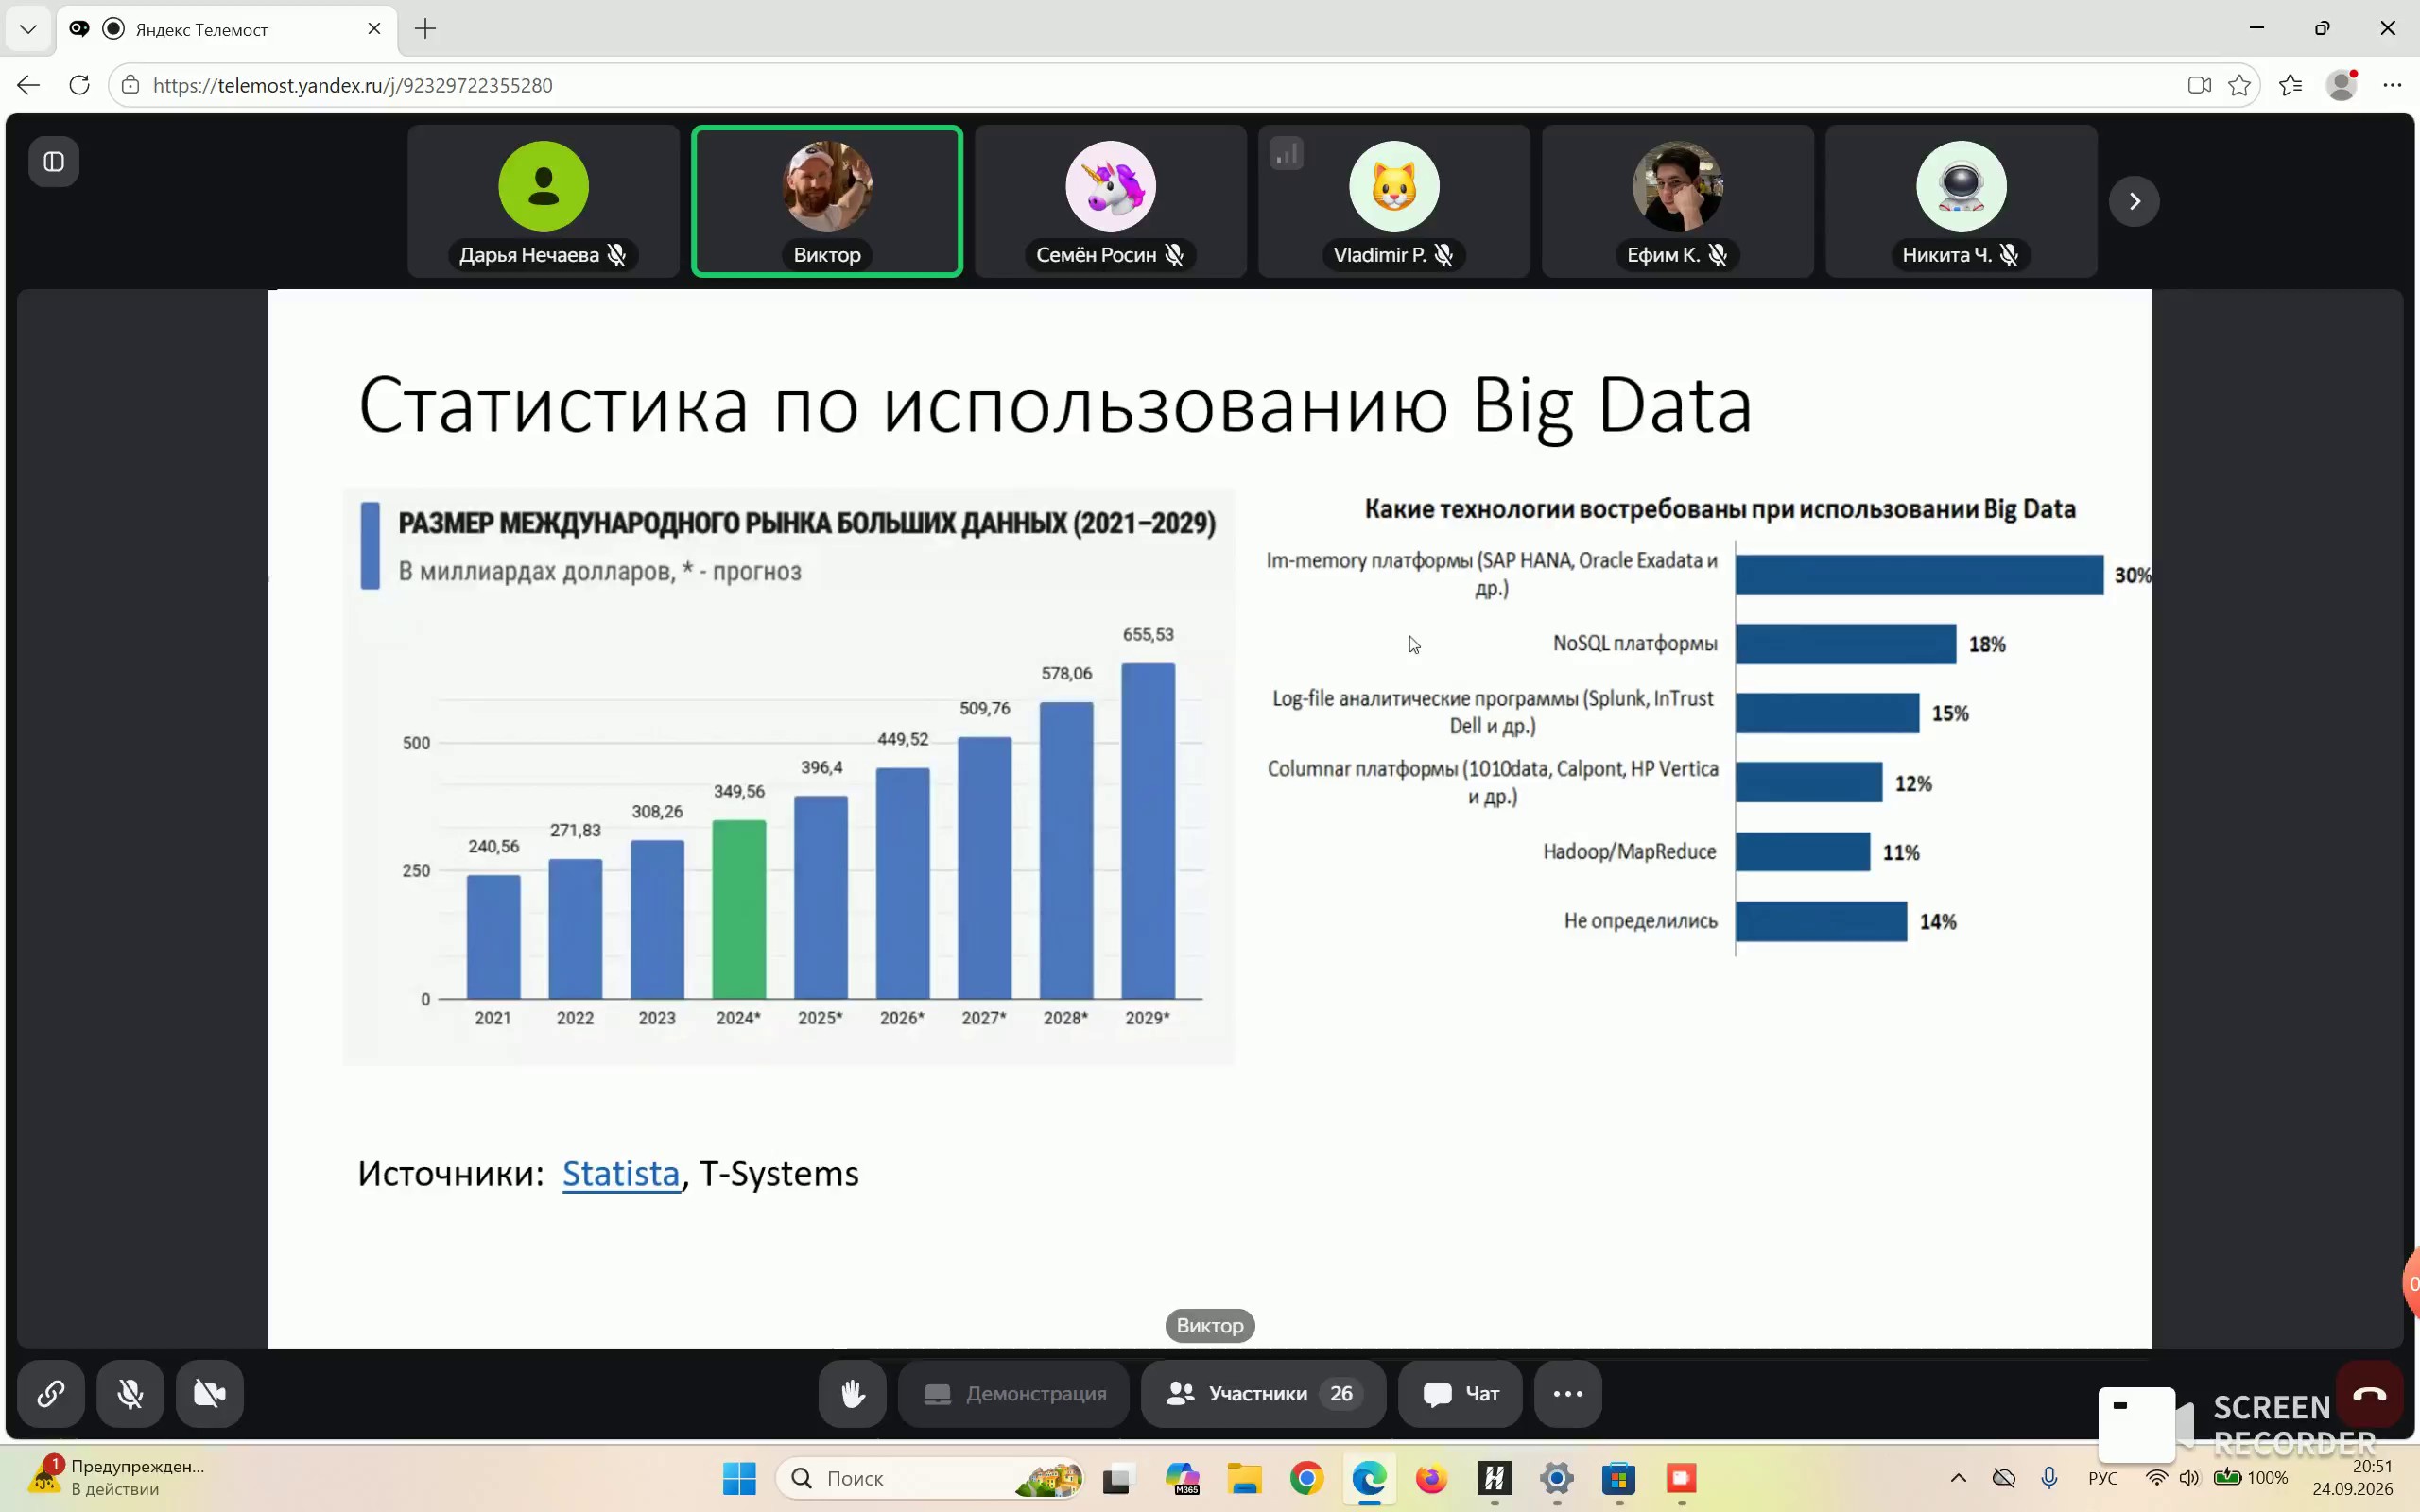
Что касается статистики по использованию Big Data, размер международного рынка больших данных в миллиардах долларов выглядит так, как на диаграммке слева, причем здесь есть как статистические данные, так и прогнозные.
Отступление от темы
Ребята, очень интересно, на самом деле, сверять вот эти вот прогнозы с реальностью, поэтому, ну, не поленитесь, загляните в интернет, Проверьте эти данные, насколько прогноз совпал с реальностью. Или с помощью LLM какой-нибудь тоже можно это сделать. В общем, поизучайте, последуйте этот вопрос.
Какие технологии востребованы при использовании Big Data? Прежде всего, мы видим здесь, что при использовании Big Data востребованы технологии, которые наиболее отвечают самому концепту бигдата. Мы говорили про NoSQL, и я приводил вам один из примеров. На самом деле технологии используются тоже в обработке Big Data, об этом мы поговорим в конце нашего курса. Там у нас будет пара лекций, как минимум одна, сколько успеем, посвященных непосредственно технологиям Big Data и различным нюансам, связанным с применением этих технологий.
Архитектура систем обработки данных
На данном слайде приведена одна из архитектур решений в области обработки данных. Цель этого слайда — показать, что от тех примитивных идей, когда у нас, собственно, были UI, бизнес-логика и непосредственно БД, мы уже давным-давно ушли. Современное проектирование баз данных — это достаточно архитектурно непростой процесс, который включает в себя много компонентов в зависимости от нашей задачи.
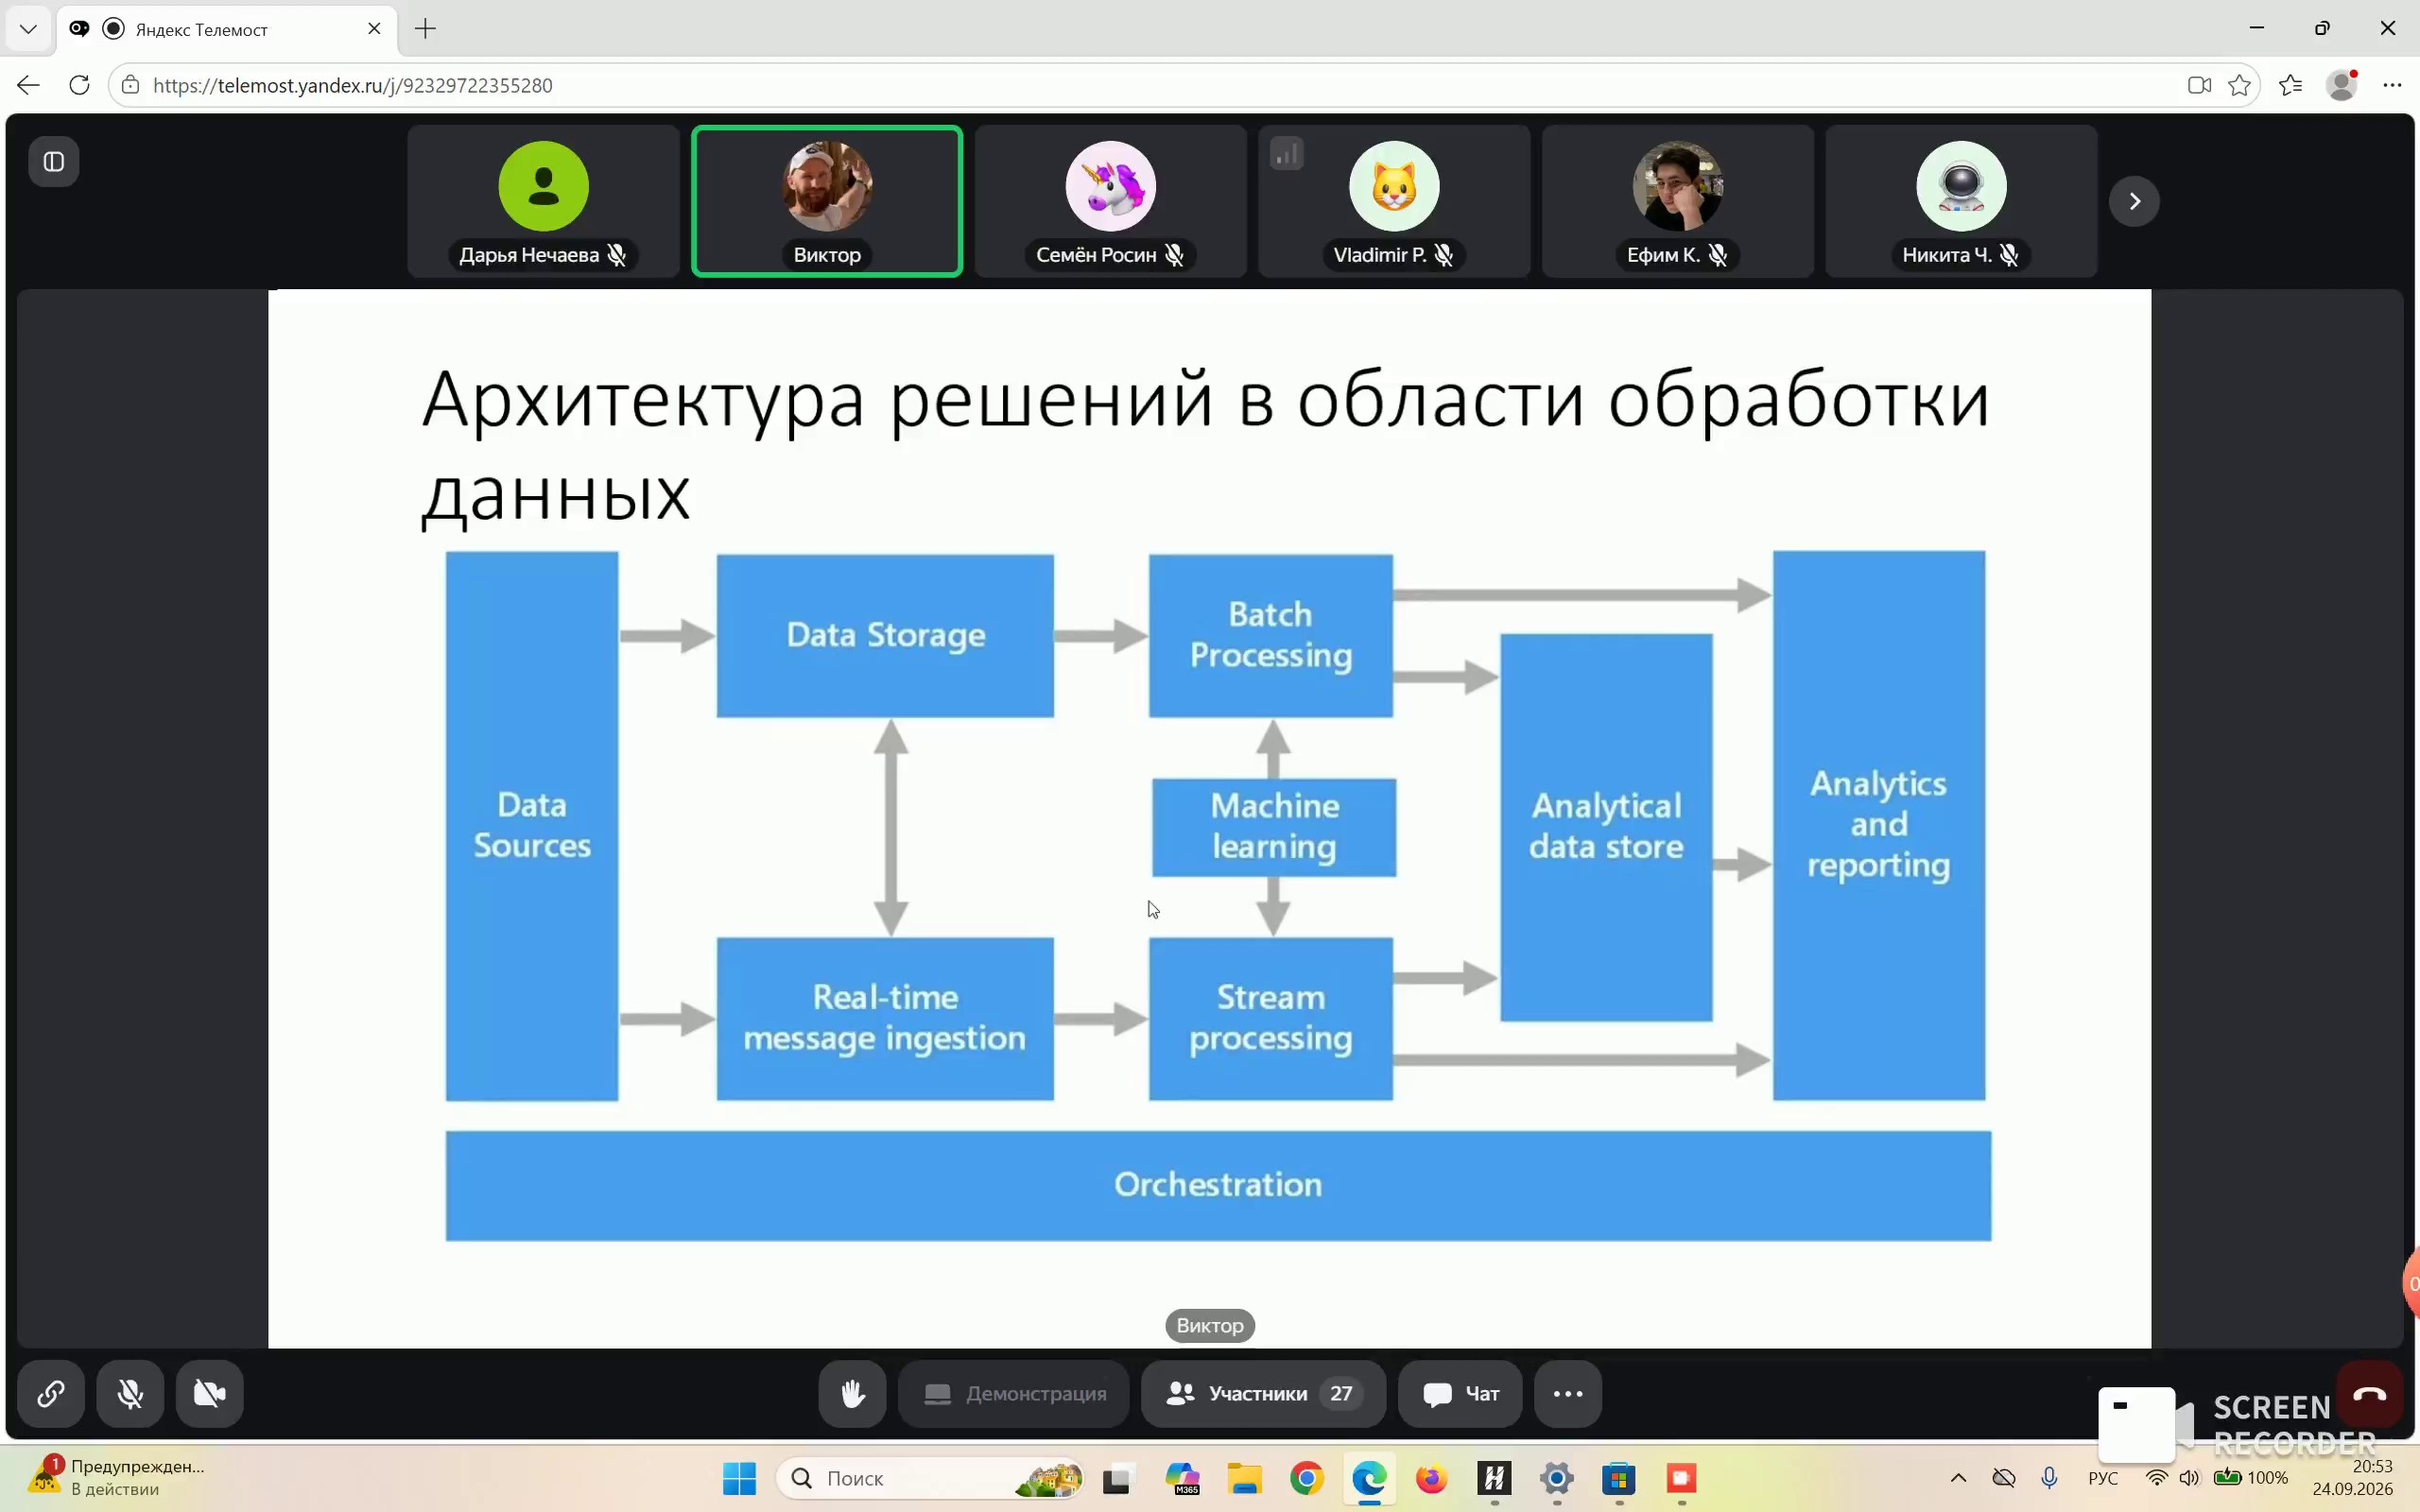
В зависимости от задачи мы выбираем тот или иной путь: будь то batch processing, то есть обработка какого-то пакета, или stream processing, когда мы обрабатываем какие-то стримы в real-time.
Отступление от темы
Я читаю на факультете математики и компьютерных наук курс об архитектуре и проектировании информационных систем. И там мы с ребятами достаточно подробно разбираем вот эти аспекты, связанные с архитектурой решений, в том числе в области обработки данных, big data. А вот поскольку у нас курс достаточно такой базовый и моя задача рассказать вам об основах, сильно я этими вещами вас грузить не буду.
Мы посмотрим несколько архитектур в исследовательских целях для того, чтобы вы поняли, от чего что зависит при каких-то различных ситуациях, как всё дело оркестрируется, каким дата-студио [возможная ошибка распознавания: дата-стак / дата-студио] он может быть. Если наша цель — оптимизация не под транзакции, а под аналитику, поговорим об озерах данных. Но какие-то интересные вещи я в любом случае обязательно расскажу, это тоже будет в нашем курсе — основные игроки на рынке.
Основные СУБД на рынке и история SQLite
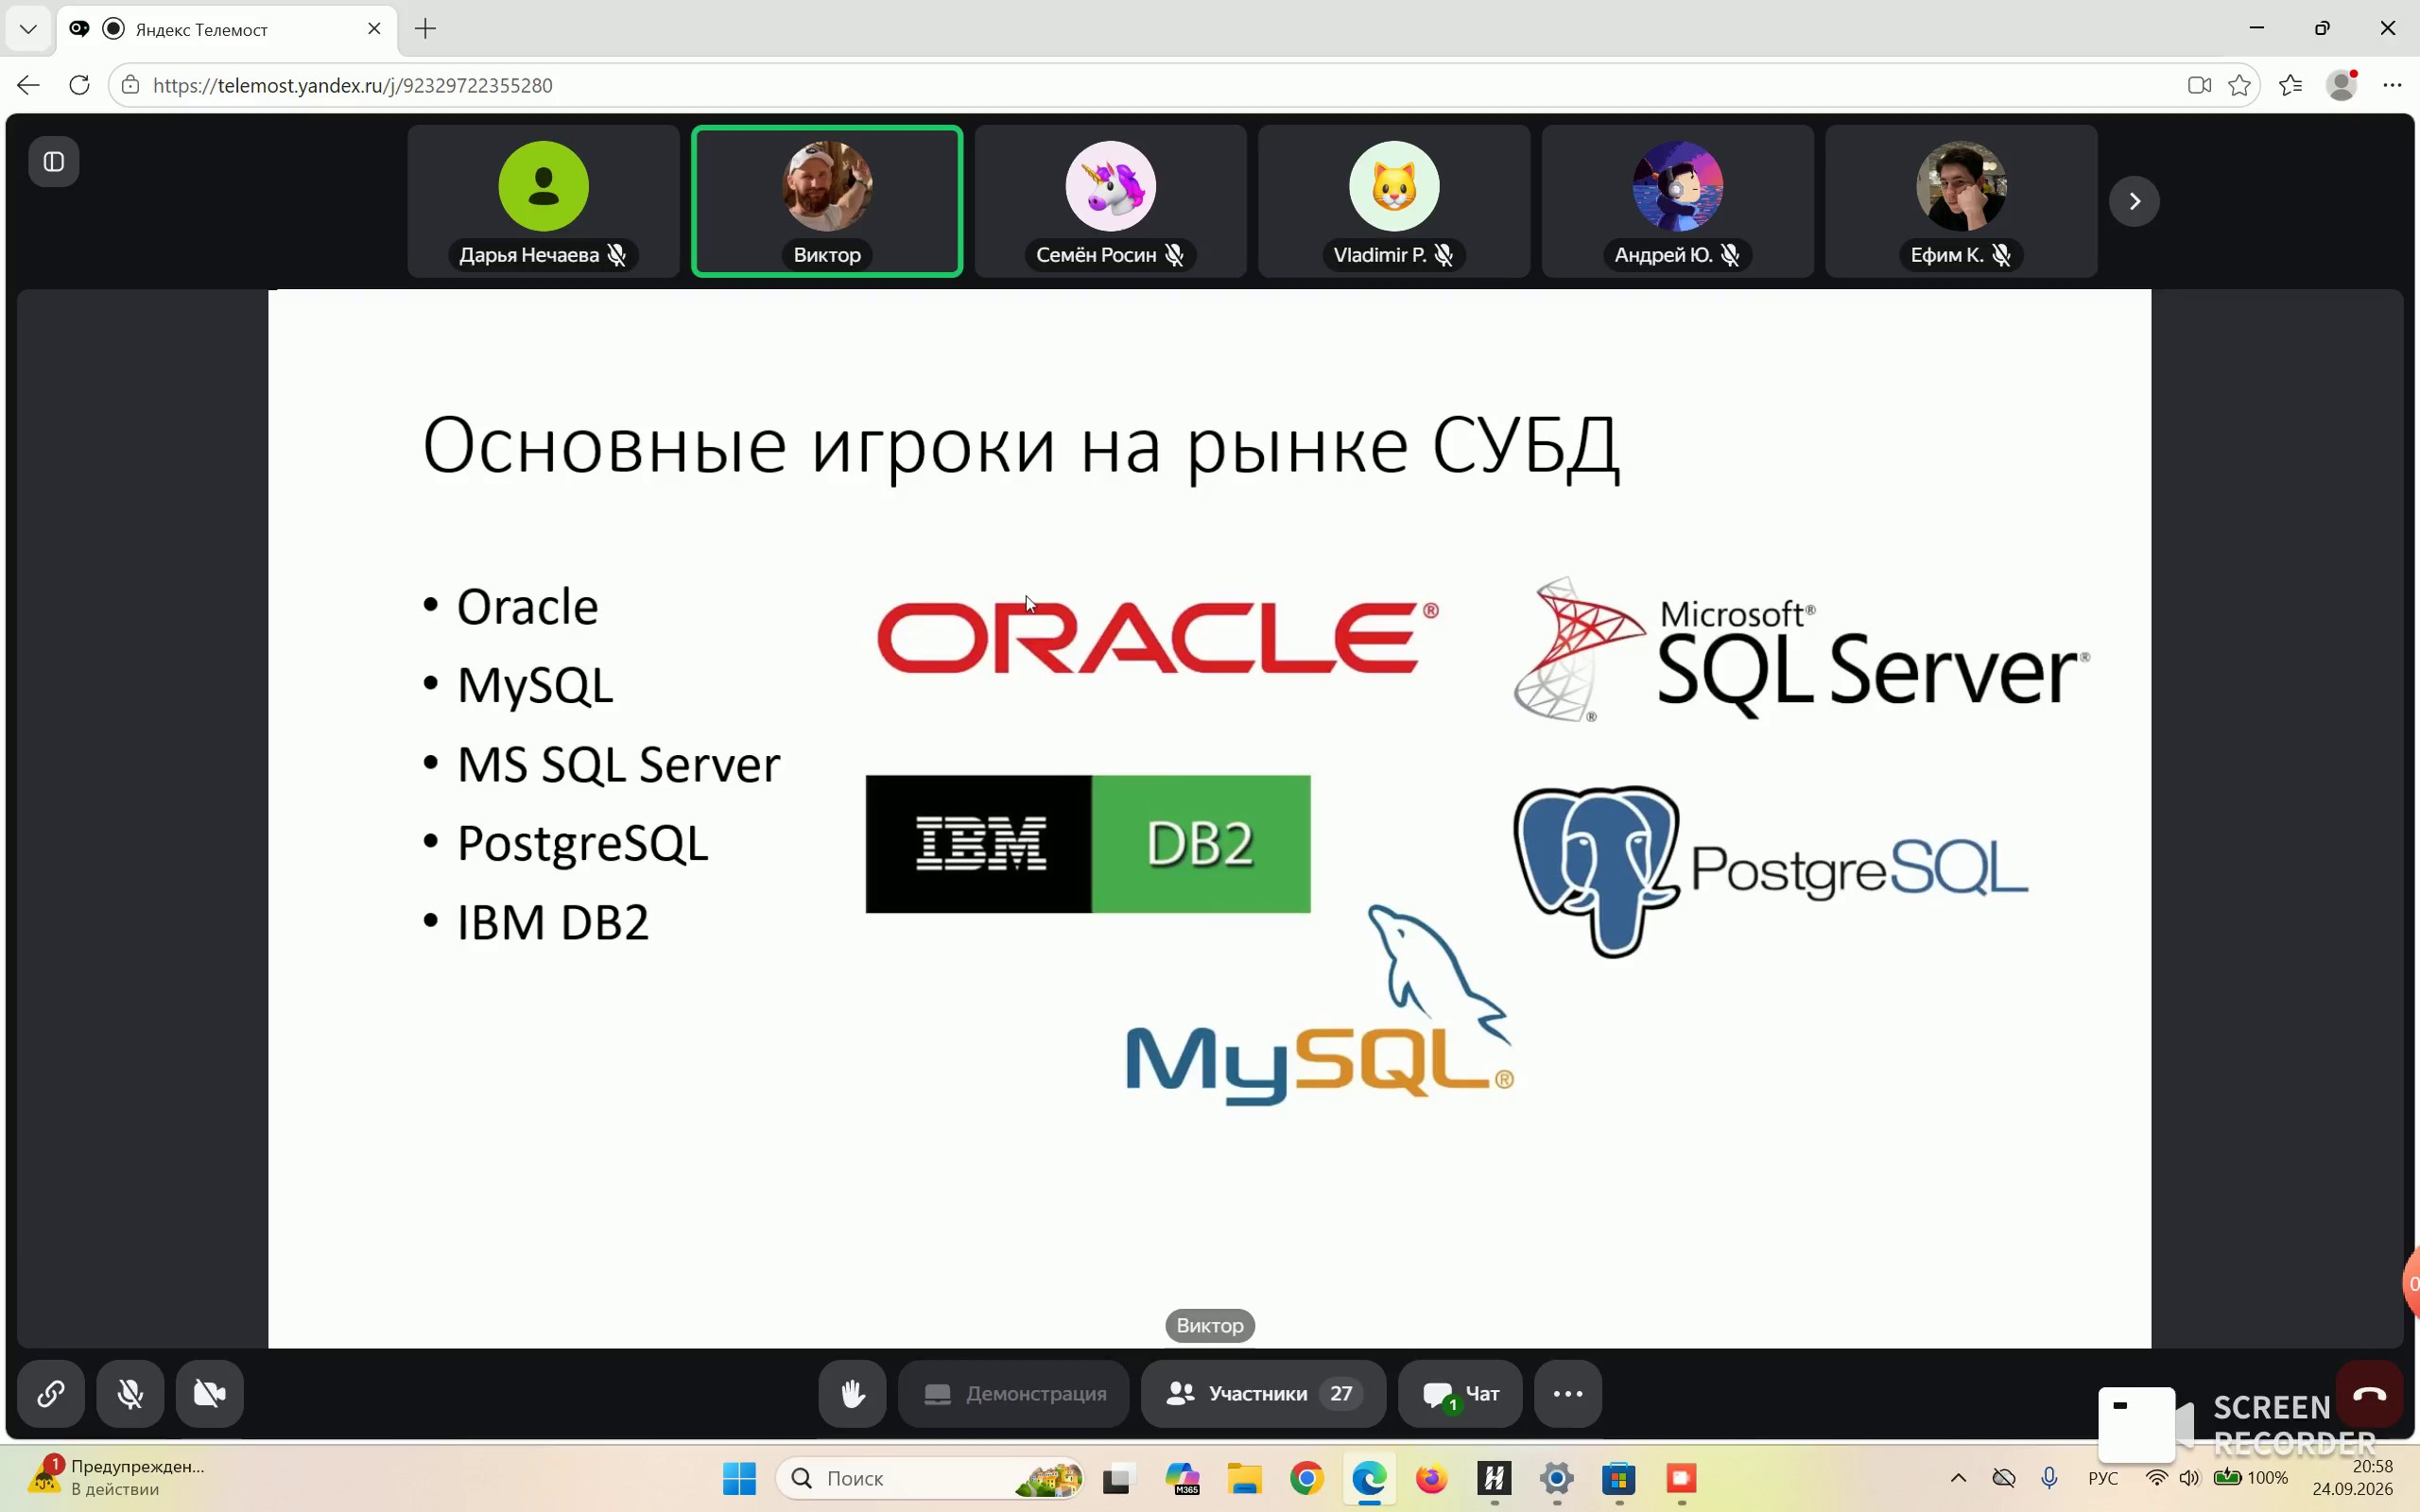
Основные игроки на рынке систем управления базами данных приведены на данном слайде, среди них выделяются Oracle, Microsoft SQL Server, PostgreSQL и SQLite. Рынок не статичен, выходят новые технологии различных компаний, и какие-то пропорции доле рынка меняются.
Отступление от темы
Лектор проводит интерактив со студентами, задавая вопрос о том, у кого находится пальма первенства и кто занимает больше всего долей рынка, выслушивает варианты от аудитории (предположения про Oracle и IBM), после чего продолжает лекцию.
На самом деле SQLite — это вообще отдельная интересная история. Если кто не знает, SQLite — это свободная система управления базами данных, которая встроена в том числе в Python. Она разрабатывалась, если памяти не изменяет, тремя энтузиастами, которых профинансировали, и до сих пор в команде SQLite всего три человека с момента возникновения концепции.
Отступление от темы
Лектор предлагает желающим ознакомиться с историей создания технологии: «Если кому интересно, я могу скинуть статью про вот этих вот ребят, как они запилили вот эту интересную легковесную базу данных. Там достаточно такая интересная история связанная с тем, как вообще происходило. Я лично вот люблю такие истории почитать, потому что всегда интересно, как люди доходили до тех или иных идей, а тем более, когда эти идеи воплощались в продукты, в том числе в какие-то достаточно интересные успешные продукты».
Функции СУБД и роли специалистов в сфере баз данных
Функции СУБД и слои архитектуры ИС
Отступление от темы
Что-то у меня такое впечатление, что где-то этот слайд мы уже видели, но здесь мы его видели действительно в начале презентации, но здесь уже раскрываются вот эти аспекты.
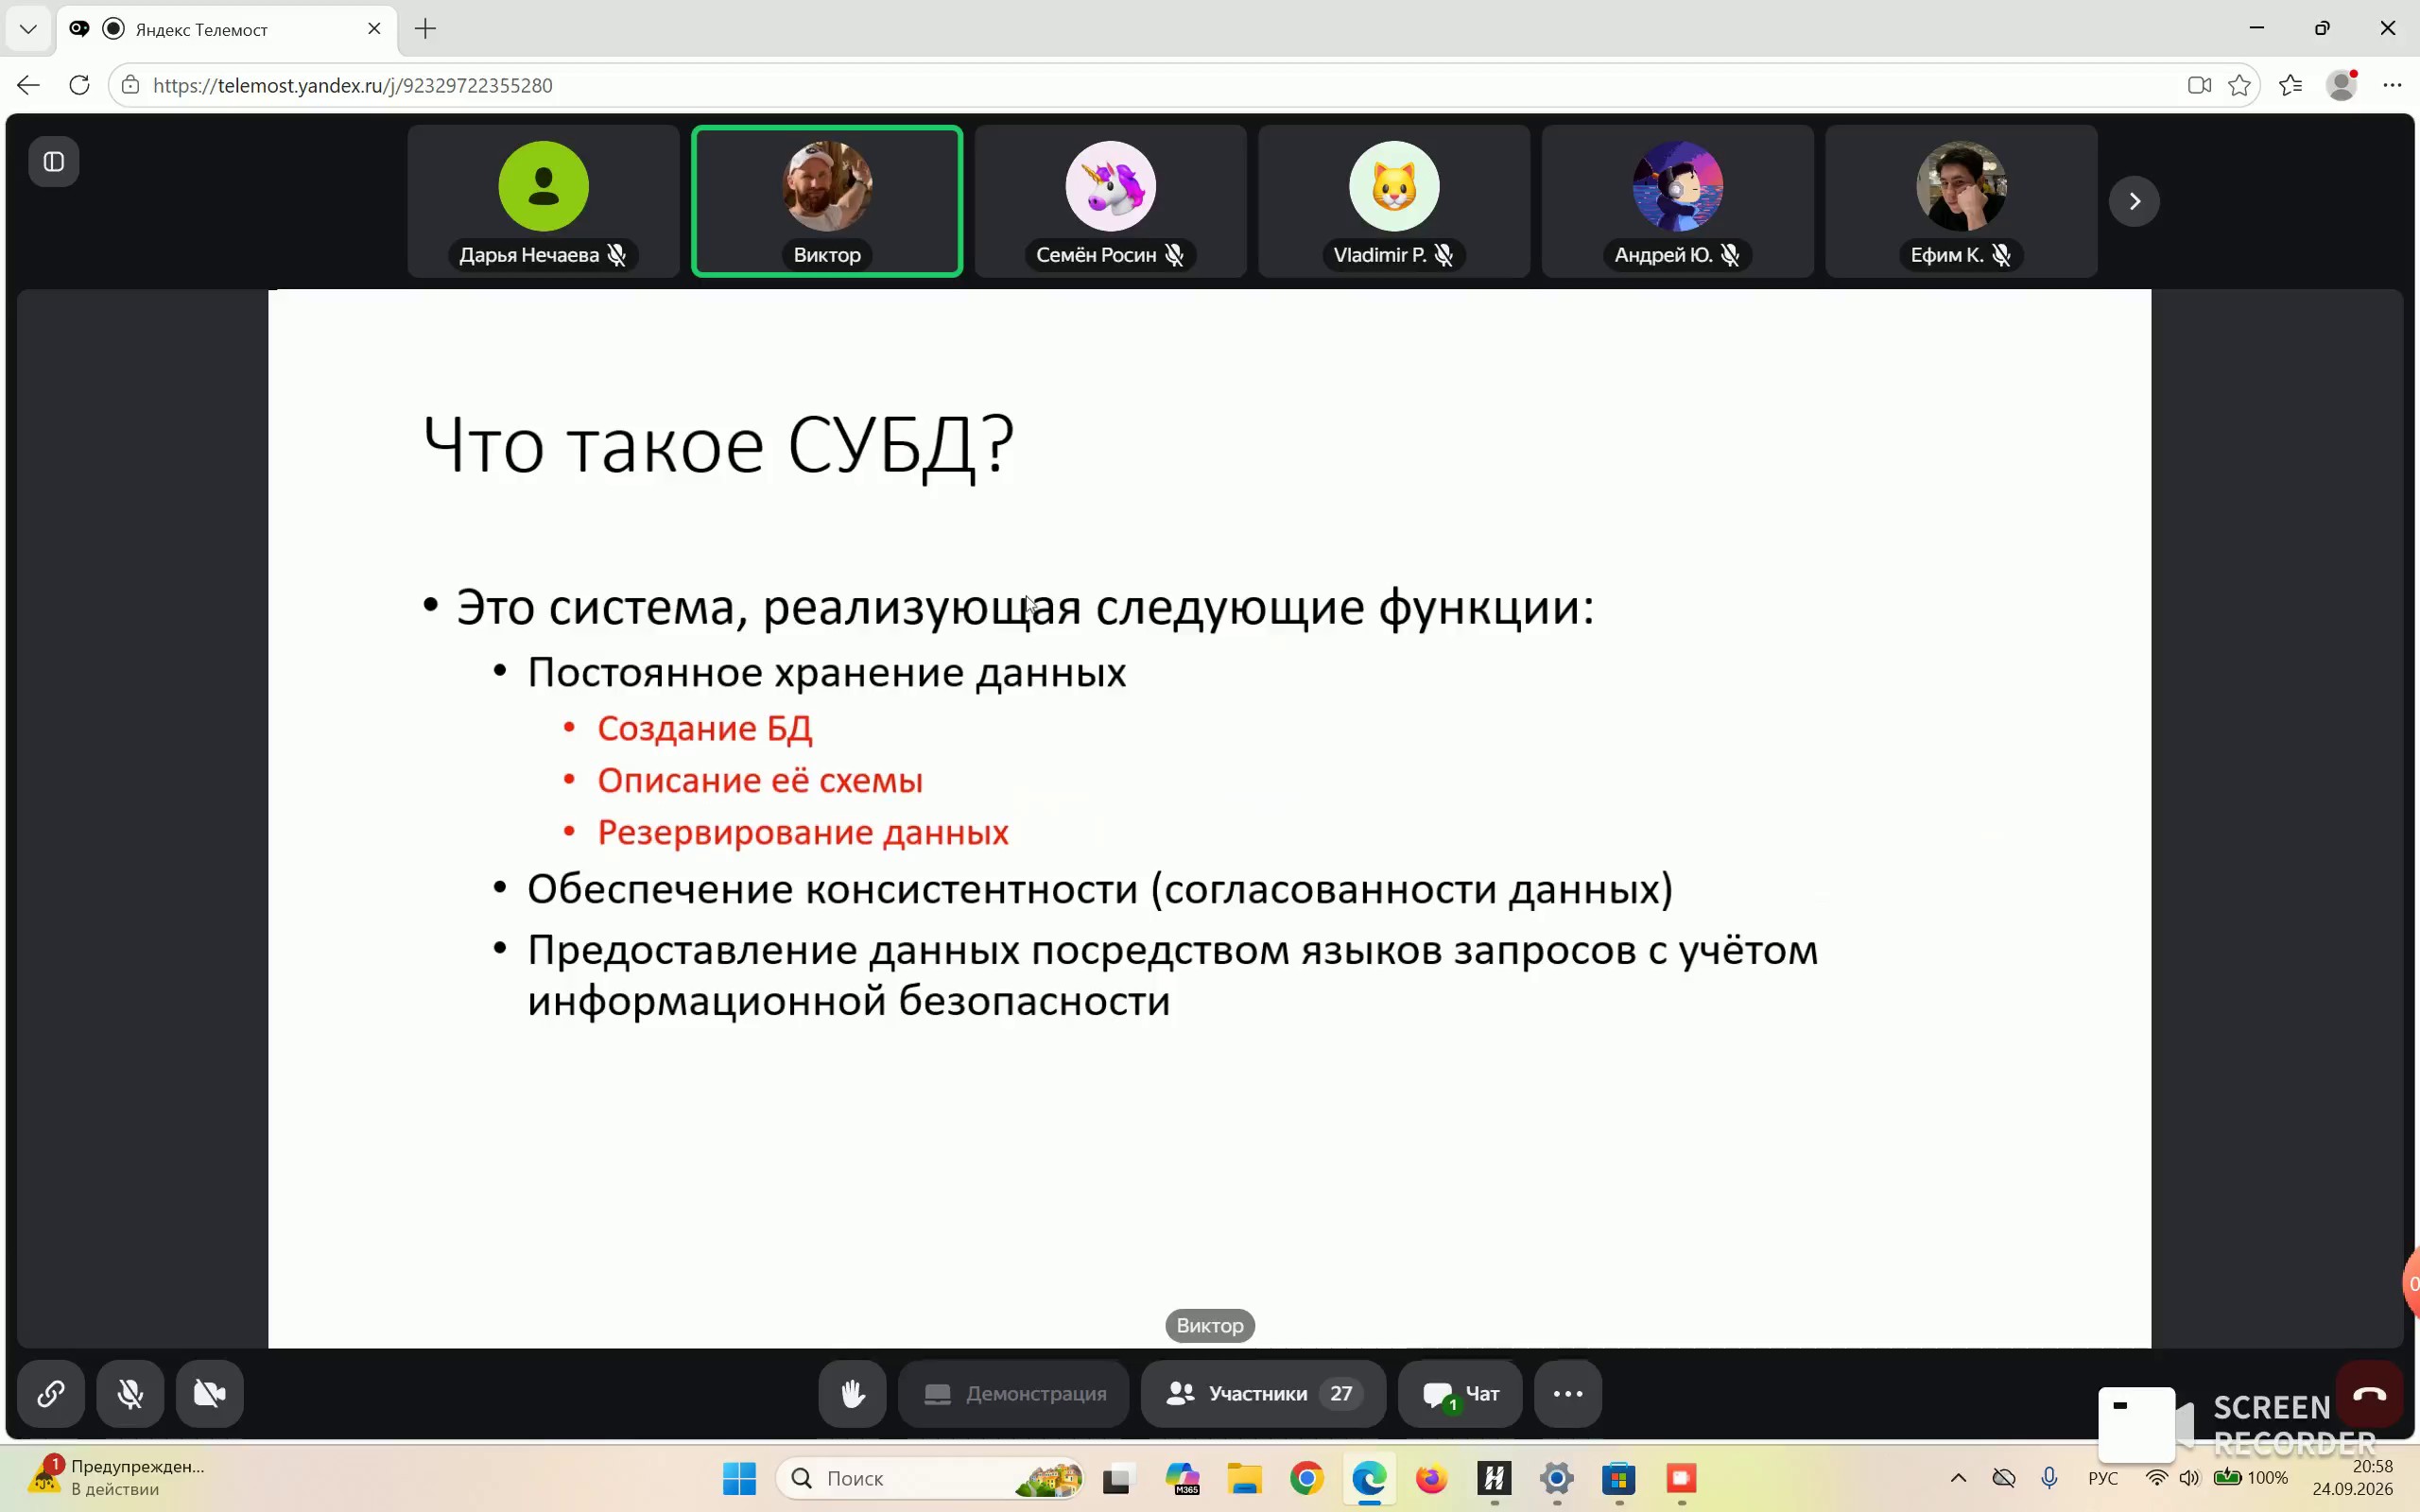
Система управления базами данных представляет собой систему, реализующую следующие функции. Во-первых, это постоянное хранение данных, куда входит создание базы данных, описание ее схемы, резервирование данных, обеспечение консистентности (включая ограничения целостности данных). Во-вторых, это предоставление данных посредством языков запроса с учетом информационной безопасности, что включает в себя обработку запросов на языках высокого уровня, одновременный, он же конкурентный, многопользовательский доступ, и, конечно же, вопросы масштабирования. Кроме того, сюда можно добавить возможность реализации бизнес-логики в задачах обработки данных.
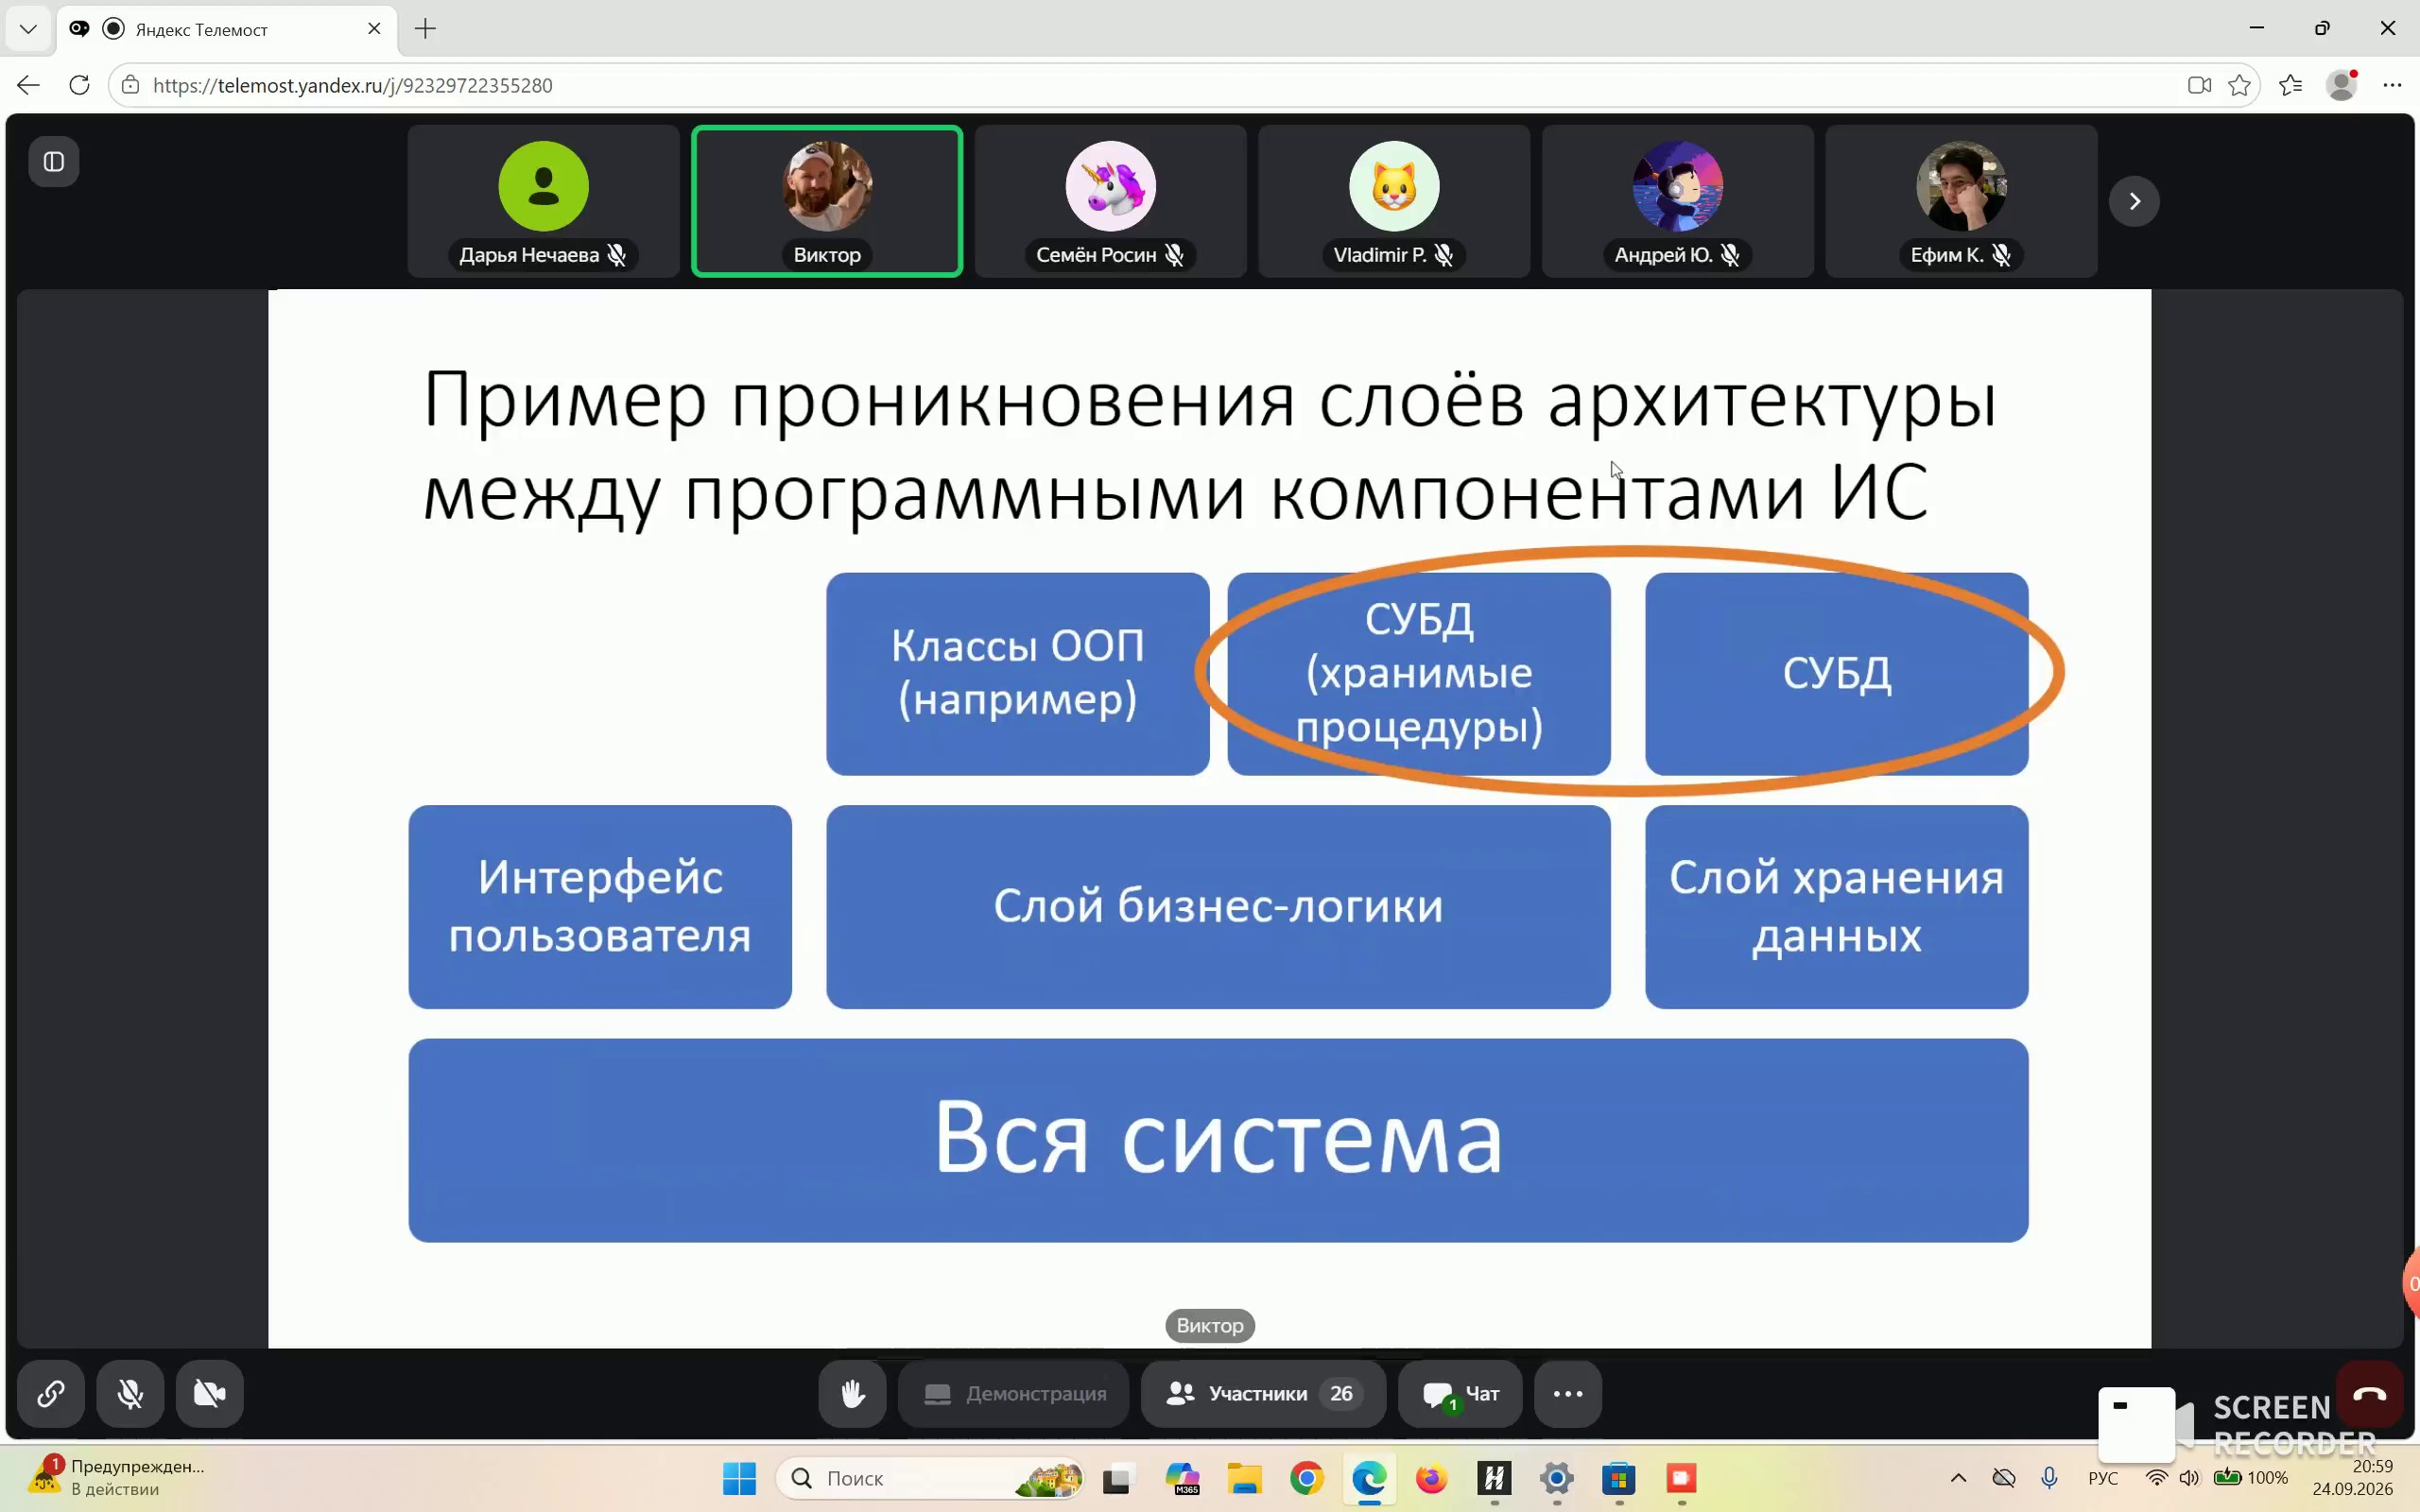
Далее рассматривается пример проникновения слоев архитектуры между программными компонентами информационной системы. Здесь представлены стандартные слои, такие как интерфейс пользователя, слой бизнес-логики и слой хранения данных. Если мы переходим на более низкий уровень, например, у нас здесь появляются классы объектно-ориентированного программирования. Например, из СУБД мы можем выделить отдельный компонент в виде хранимых процедур. Идея заключается в том, что в зависимости от уровня нашего исследования и уровня нашей детализации мы можем рассматривать различные компоненты информационной системы более компактно либо более детализировано и выделять те компоненты, которые интересуют нас для каких-то архитектурных изысканий.
Роли и профессии в сфере баз данных
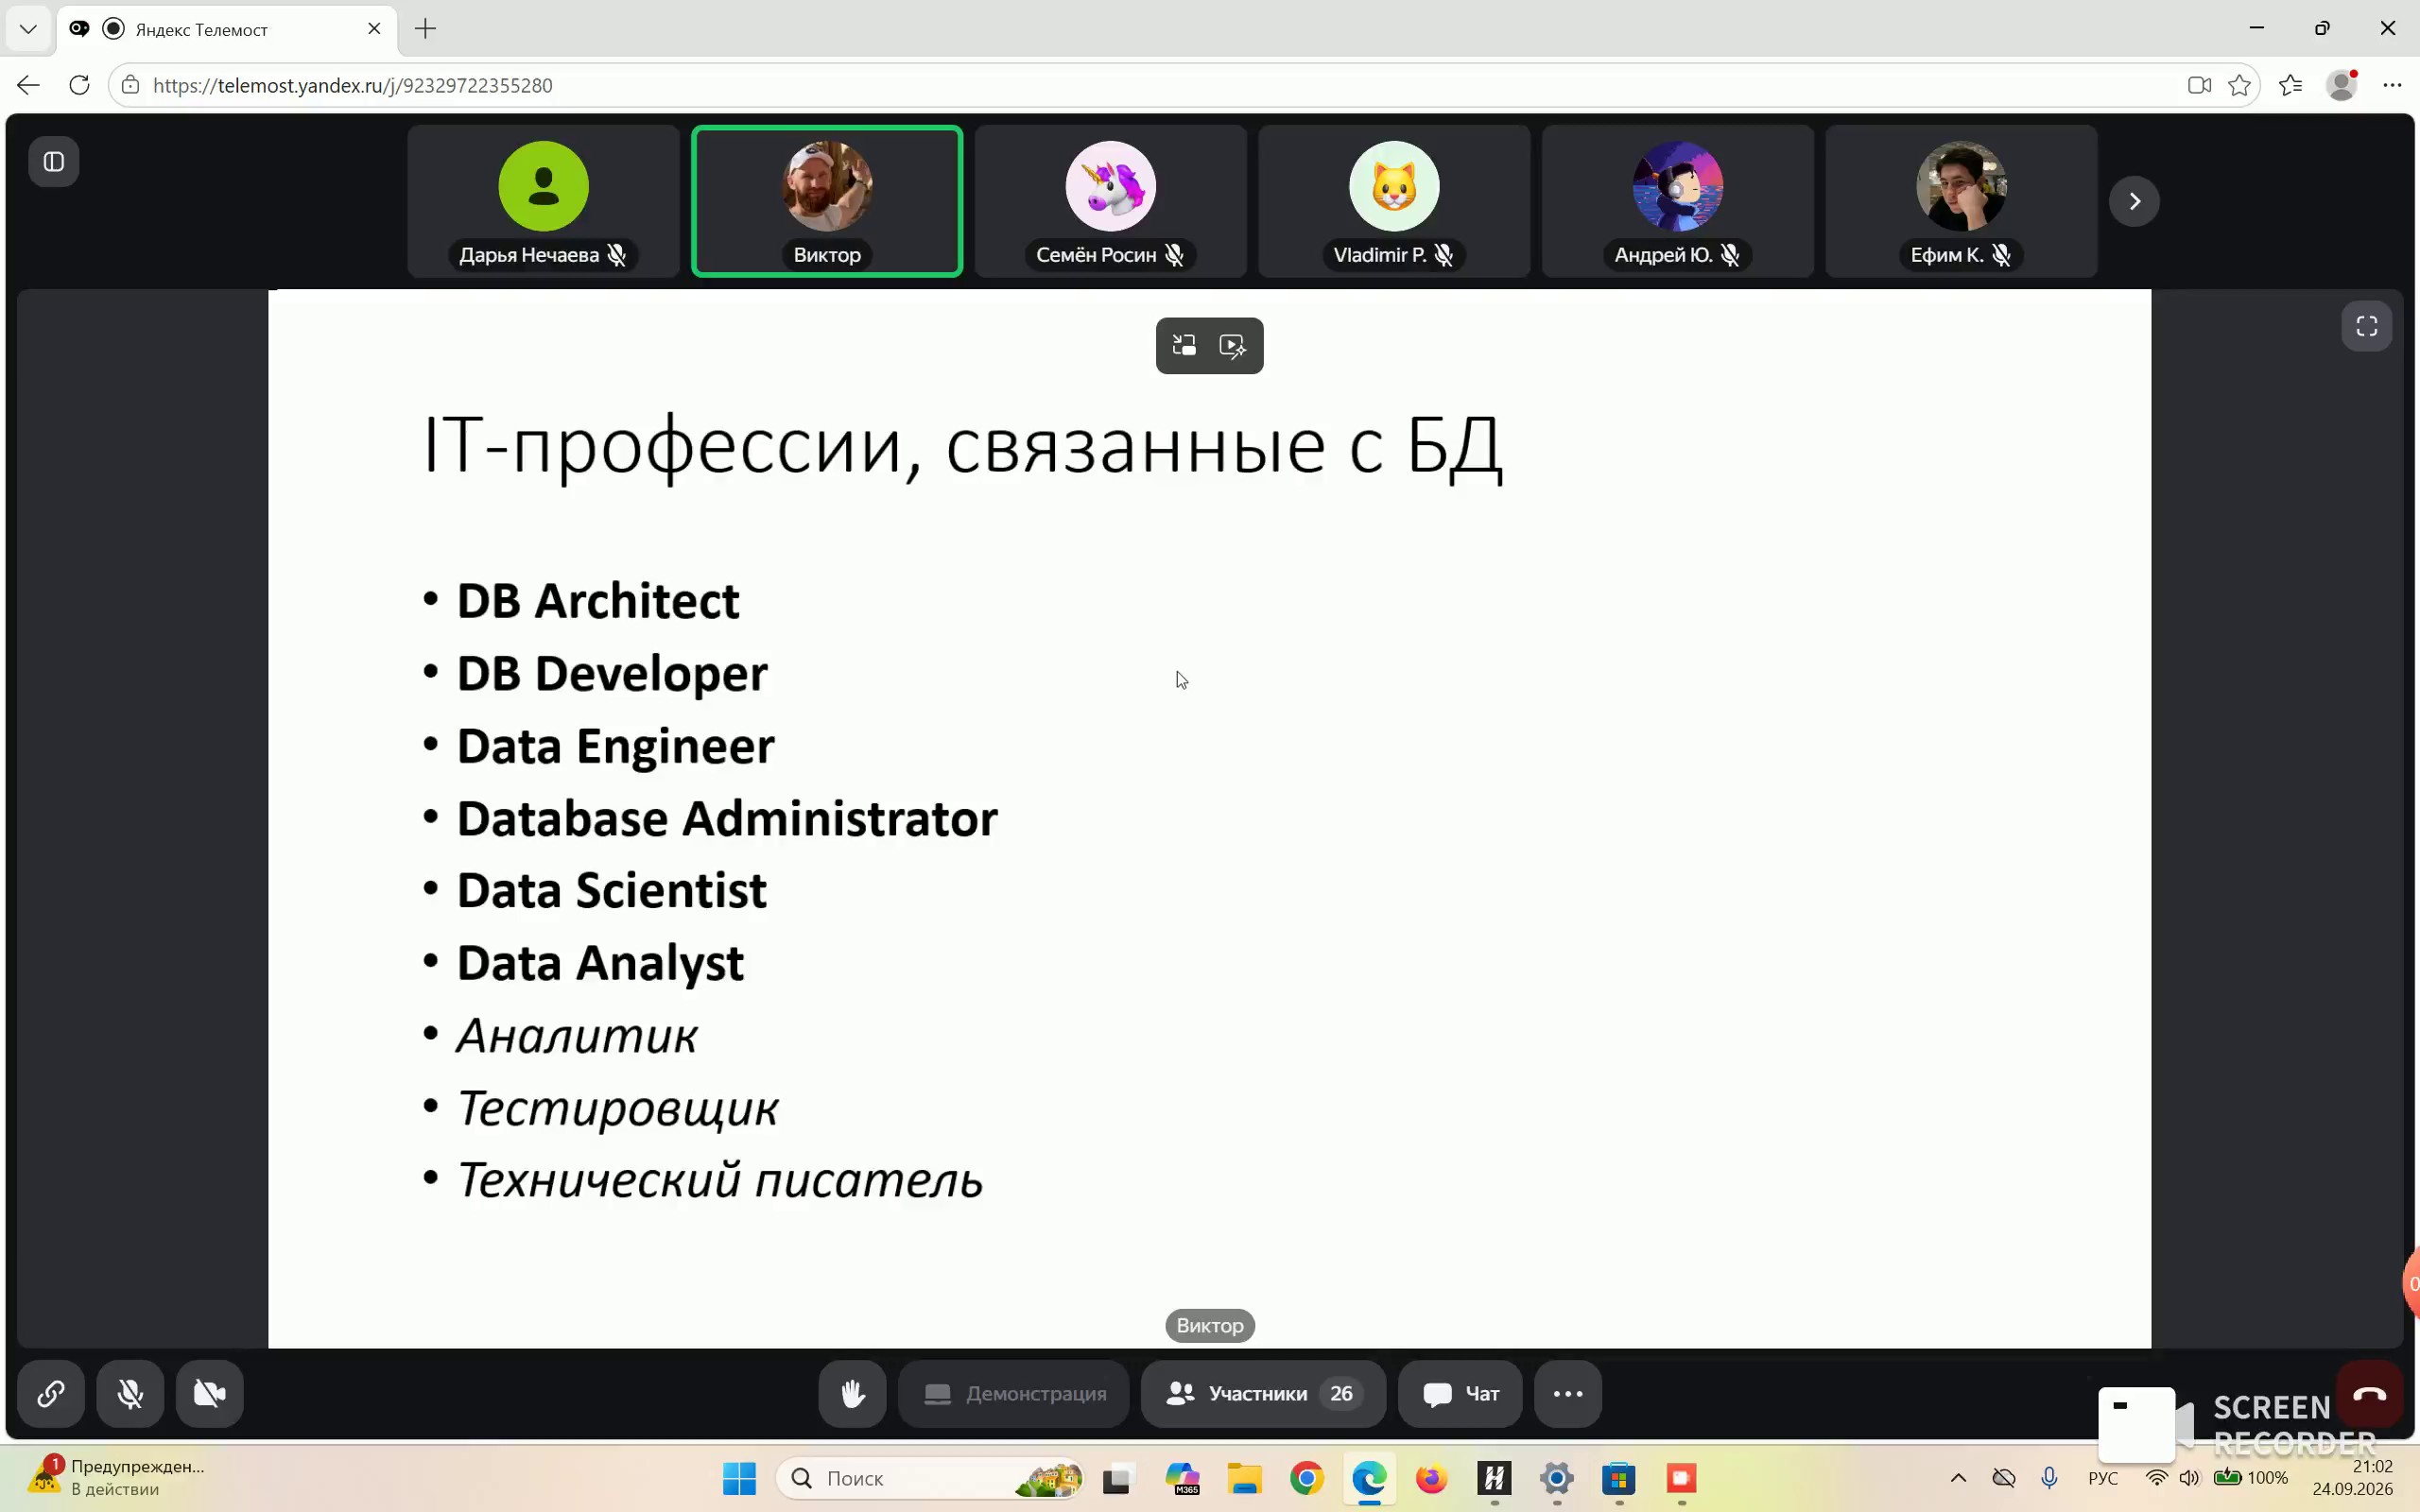
Здесь вкратце приведены профессии, связанные с базами данных. Область работы с базами данных сейчас совсем не та, что она была даже 10 лет назад, и тем более 20 лет назад. Если 20 и даже 10 лет назад один человек вполне мог быть и датабейст-архитектором, и разработчиком баз данных, и дата-инженером, и прочее, то сейчас идет достаточно четкое разделение этих ролей, связанных с работой с базами данных. Как правило, в больших компаниях эти роли достаточно четко выражены, и действительно это разные люди. Если брать компании поменьше, то там до сих пор один человек может быть и архитектором БД, и администратором БД, и отвечать за все аспекты, связанные с работой с базами данных. Обязательно может быть какая-то небольшая или даже большая компания, но это вполне может быть какая-то команда в большой компании, которая разрабатывает, например, не очень сложную информационную систему, и в этой не очень сложной информационной системе просто негде развернуться всем этим многочисленным ролям. Так или иначе, все эти роли важны, каждая роль отвечает за свой аспект, связанный с работами с базами данных, и для каждой роли найдется свое место в каком-то большом амбициозном проекте.
Работа проектировщика баз данных связана с разработкой инфологической модели данных, описанием предметной области, выраженной на языке, понятном для людей, связанных с базами данных, возможно, вместе с системным аналитиком. Сперва идет неформальное описание на основе требований с использованием любых доступных средств, а затем — формализованная модель, например, ER-модель, о которой пойдет речь на следующем занятии.
Что касается работы аналитика данных, здесь возникают такие вопросы, как валидация данных, обработка данных, подготовка отчетов, дата-майнинг (извлечение нетривиальной информации в ходе обработки больших данных). Это примеры, которые были приведены на слайдах для людей, которые занимаются вопросами, связанными с базами данных.
Отступление от темы
Я предлагаю сегодня, ребята, провести...
Завершение лекции и организационные вопросы
Отступление от темы
Я предлагаю сегодня, ребята, провести вот это занятие в укороченном формате. Завтра мы поговорим более детально об инфологической модели ну и о других моделях, которые я озвучивал сегодня. Постараемся начать завтра в 19:30, надеюсь, никаких проблем сегодня с подключением не произойдет. Есть ли какие-то ко мне вопросы? Если вопросов нет или, может быть, они потом появятся, всегда можно мне написать. А так, желаю вам хорошего вечера до следующего занятия. Пока-пока. До свидания. До свидания. Спасибо за лекцию. До свидания.